Créer un cluster GPU Kubernetes ne consiste pas simplement à attacher des GPU à quelques nœuds de travail. Pour l’entraînement et l’inférence IA, Kubernetes doit exposer les accélérateurs de manière sécurisée, placer les tâches sur les bons nœuds, mettre en file d’attente une capacité rare, maintenir les jeux de données et les poids des modèles suffisamment près du calcul, et indiquer aux opérateurs pourquoi une exécution coûteuse a échoué.
La règle pratique : créez le plus petit cluster GPU Kubernetes qui valide la charge de travail, puis ne l’étendez qu’après que l’ordonnanceur, les pilotes, le réseau, le stockage, l’observabilité et le modèle de coûts ont passé les tests d’acceptation. Un cluster qui ne peut pas expliquer le temps d’attente en file, l’utilisation des GPU, le temps de restauration des points de contrôle et les causes des échecs n’est pas encore une infrastructure de production.
Ce guide présente l’architecture et le modèle d’exploitation d’un cluster GPU Kubernetes utilisé pour l’entraînement et l’inférence IA. Il couvre la conception des nœuds, l’exposition des GPU, la mise en file d’attente, les API de charges de travail, l’observabilité, un schéma de cluster GPU Kubernetes pratique, les outils de gestion et les questions à poser aux fournisseurs avant de louer ou de réserver de la capacité.
Si le produit a uniquement besoin de sorties de modèle, comparez d’abord une API de modèle ou une solution d’inférence gérée. Si vous avez besoin de poids personnalisés, d’un contrôle du placement, d’un service privé, d’entraînement distribué ou de la maîtrise de benchmarks reproductibles, un cluster GPU Kubernetes peut constituer le bon plan de contrôle.
Réponse rapide sur les clusters GPU Kubernetes
Un cluster GPU Kubernetes de production comporte six couches :
| Couche | Ce qu’elle gère | Ce qu’il faut vérifier avant la production |
|---|---|---|
| Nœuds GPU | Modèle de GPU, mémoire GPU, CPU/RAM, NVMe local, cartes réseau, images de nœud, pilotes, environnement d’exécution de conteneurs | La configuration du nœud correspond à la charge de travail d’entraînement ou d’inférence, et pas seulement à la référence GPU annoncée. |
| Exposition des GPU | Plugin de périphérique, GPU Operator, Dynamic Resource Allocation, politique MIG ou de partage | Les pods demandent des accélérateurs de façon prévisible et ne peuvent pas consommer accidentellement les mauvais périphériques. |
| Planification et files d’attente | Ordonnanceur Kubernetes, Kueue, Volcano, Ray, Kubeflow, opérateurs personnalisés | Les tâches attendent équitablement, la politique de préemption est explicite et les équipes peuvent expliquer le temps d’attente en file. |
| Réseau et stockage | NVLink/NVSwitch au sein des nœuds, InfiniBand/RoCE/EFA ou Ethernet entre les nœuds, stockage objet, système de fichiers partagé, chemin des points de contrôle | Les tâches distribuées passent à l’échelle et récupèrent sans affamer les GPU. |
| Observabilité | DCGM, Prometheus, journaux, événements, traces, métriques de file d’attente, étiquettes de coûts | Les opérateurs peuvent voir l’utilisation, la mémoire, la puissance, les échecs, le propriétaire et les dépenses par charge de travail. |
| Sécurité et gouvernance | RBAC, espaces de noms, quotas, politique d’images, secrets, politique réseau, journaux d’audit | L’accès multi-locataire est contrôlé avant que le cluster ne devienne une infrastructure partagée. |
La question de conception clé n’est pas « Kubernetes peut-il exécuter des GPU ? » Il le peut, avec le bon plugin de périphérique et la bonne configuration des nœuds. La question plus difficile est de savoir si votre cluster GPU Kubernetes d’infrastructure IA peut maintenir les GPU utiles avec de vraies données, de vrais utilisateurs, de vraies défaillances et de vraies contraintes budgétaires.
Schéma de cluster GPU Kubernetes
Utilisez ce schéma de cluster GPU Kubernetes comme modèle de revue avant de choisir des outils :
                 développeurs / CI / notebooks / trafic API
                                  |
                                  v
        +--------------------------------------------------+
        | plan de contrôle Kubernetes                      |
        | serveur API, ordonnanceur, RBAC, admission, secrets|
        +--------------------------------------------------+
                                  |
                 +----------------+----------------+
                 |                                 |
                 v                                 v
        +------------------+              +------------------+
        | couche de file   |              | modules de        |
        | Kueue / Volcano  |              | plateforme        |
        | quotas, cohortes,|              | GPU Operator,     |
        | variantes de     |              | plugin de         |
        | ressources       |              | périphérique,     |
        |                  |              | exportateur DCGM  |
        +------------------+              +------------------+
                 |                                 |
                 +----------------+----------------+
                                  |
                                  v
        +--------------------------------------------------+
        | pools de nœuds de travail GPU                   |
        | H100/H200/B200/A100/L40S/etc., CPU, RAM, NVMe,  |
        | cartes réseau, CUDA/runtime, étiquettes,         |
        | taints, topologie                                |
        +--------------------------------------------------+
                 |                 |                 |
                 v                 v                 v
        tâches d’entraînement services d’inférence    tâches par lots
        PyTorch/JAX         vLLM/SGLang/Triton       Ray/Kubeflow
                 \                 |                 /
                  \                |                /
                   v               v               v
        +--------------------------------------------------+
        | chemin réseau et données                         |
        | fabric haut débit, stockage objet, système de    |
        | fichiers partagé, cache de modèles, points de    |
        | contrôle, journaux, métriques, sauvegardes       |
        +--------------------------------------------------+
Ce schéma est volontairement simple. Une véritable architecture de cluster GPU Kubernetes ajoutera des équilibreurs de charge, des registres privés, des frontières de maillage de services, la gestion des identités et des accès (IAM), des magasins d’artefacts, le suivi des expériences et des exports de facturation. Le rôle du schéma est d’imposer une conversation : quelle couche est responsable de chaque mode de défaillance ?
Étape 1 : déterminer si Kubernetes est le bon plan de contrôle GPU
Kubernetes est un excellent choix lorsque votre plateforme d’IA a besoin de déploiements natifs des conteneurs, d’automatisation pilotée par API, d’espaces de noms mutualisés, de points de terminaison de service, de contrôles de politique et d’une intégration avec l’observabilité cloud-native existante.
Il convient généralement pour :
- Les services d’inférence en ligne qui nécessitent des déploiements progressifs, des limites d’autoscaling, du routage et des vérifications de l’état des services.
- Les charges de travail d’inférence par lots ou d’embeddings exécutées sous forme de Jobs, de charges de travail Ray ou d’opérateurs personnalisés.
- Les charges de travail de fine-tuning et d’entraînement pour lesquelles les équipes veulent une infrastructure partagée plutôt que des machines GPU individuelles.
- Les plateformes mixtes dans lesquelles les notebooks, les tâches d’entraînement, le serving de modèles et les services de support partagent le même modèle d’exploitation.
- Les équipes qui exploitent déjà Kubernetes et peuvent étendre leurs systèmes existants d’identité, de CI/CD, de registre, de journalisation et de politiques.
Kubernetes peut être un mauvais premier choix lorsque l’équipe a seulement besoin d’un accès occasionnel pour la recherche, de tâches ponctuelles par lots de type HPC ou d’un entraînement simple piloté par SSH. Dans ces cas, Slurm, un service d’entraînement géré, un environnement de notebooks hébergé ou la location directe de GPU peuvent produire un travail utile plus rapidement.
Avant de construire un cluster GPU Kubernetes, définissez la frontière de la charge de travail :
| Question | Pourquoi c’est important |
|---|---|
| La charge de travail concerne-t-elle l’entraînement, l’inférence par lots, l’inférence en ligne, les notebooks ou une combinaison ? | La réponse modifie les exigences en matière d’ordonnancement, de stockage, de réseau et de disponibilité. |
| La tâche a-t-elle besoin d’un GPU complet, d’une tranche MIG ou d’un accès partagé dans le temps ? | Le partage des GPU modifie l’isolation, la comptabilisation et la prévisibilité des performances. |
| La charge de travail s’exécute-t-elle sur un seul nœud ou sur plusieurs nœuds ? | L’entraînement multi-nœuds exige des tests de réseau et de placement, et pas uniquement la disponibilité des GPU. |
| Quelle est la taille des jeux de données, des checkpoints et des poids de modèles ? | Le déplacement des données peut dominer le coût des GPU. |
| Quel est le dénominateur métier ? | Utilisez une exécution d’entraînement terminée, une sortie d’inférence acceptée, une tâche de génération de médias ou une requête client, et non les seules heures-GPU brutes. |
Pour une conception système plus large, reliez ce plan d’implémentation à votre analyse de l’architecture de cluster GPU : le calcul, le réseau, le stockage et le plan de contrôle doivent être conçus ensemble.
Étape 2 : concevoir les pools de nœuds GPU autour des profils de charge de travail
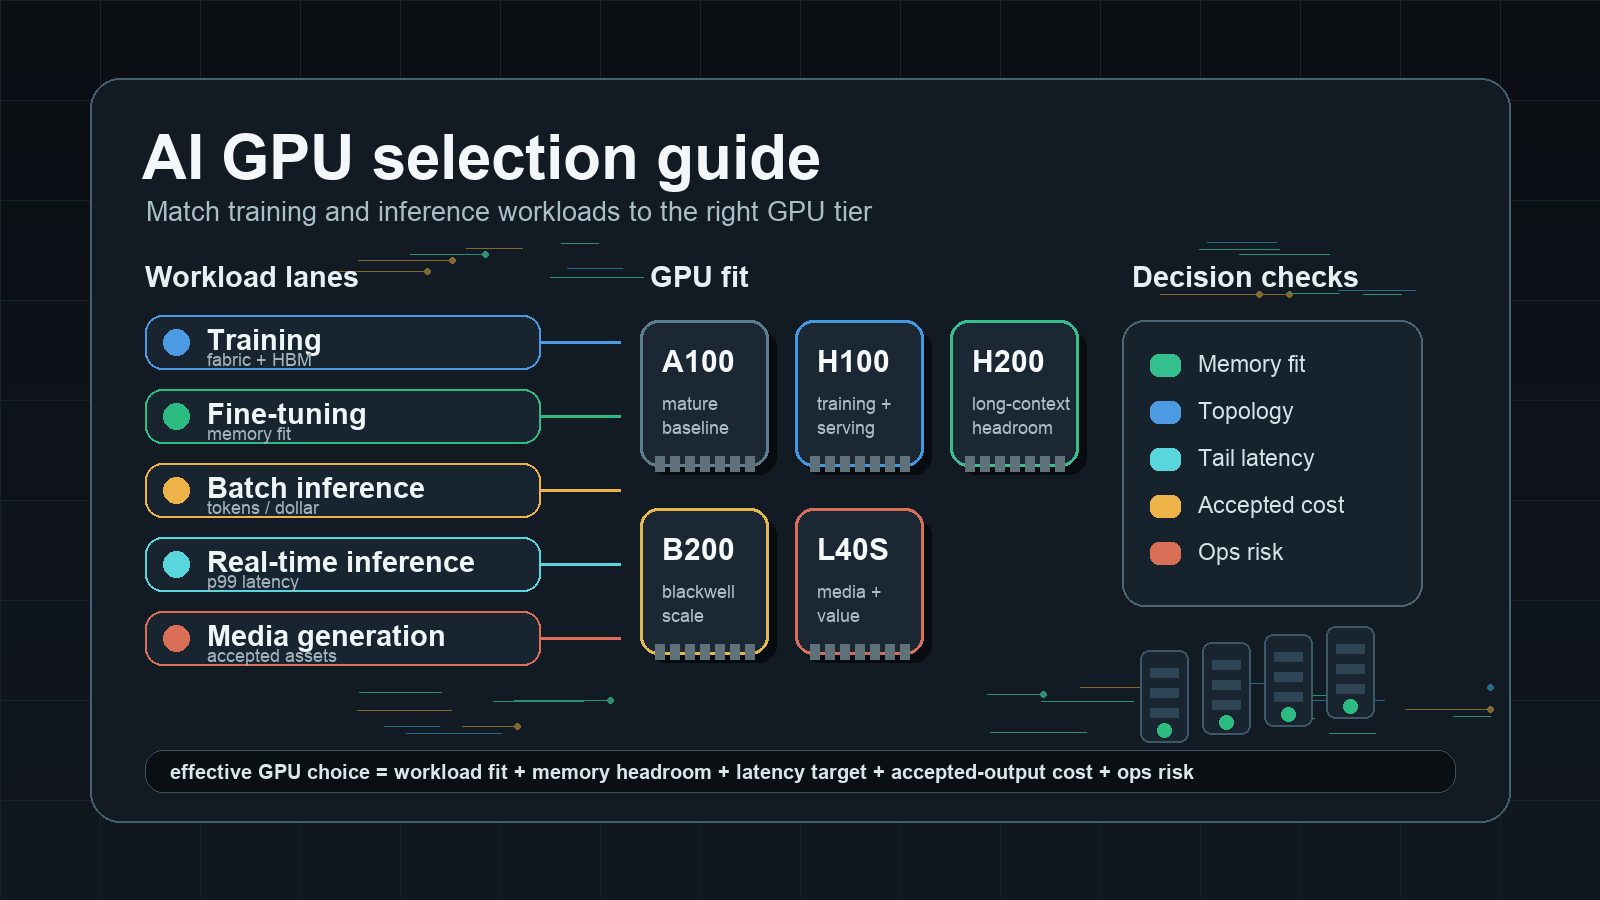
Un cluster GPU Kubernetes doit disposer de pools de nœuds délibérément conçus, et non d’un mélange aléatoire de machines accélératrices.
Pour chaque pool de nœuds, spécifiez :
- Le modèle de GPU et la taille de mémoire.
- Le nombre de GPU par nœud.
- Les détails de topologie PCIe, SXM, NVLink, NVSwitch ou autres, le cas échéant.
- Le modèle de CPU, le nombre de CPU, la RAM et la disposition NUMA.
- La taille et le débit du NVMe local.
- Le nombre de cartes réseau, leur débit et le type de fabric.
- L’image du système d’exploitation, le noyau, le pilote, CUDA, le runtime de conteneur et le processus de correctifs.
- Les labels Kubernetes, les taints, les tolerations et les labels de topologie.
- Si les charges de travail utilisent des GPU complets, MIG, le time-slicing ou un autre mode de partage.
Séparez les besoins d’entraînement et d’inférence, sauf s’il existe une solide raison de les fusionner. L’entraînement peut surtout dépendre des performances d’all-reduce, de la bande passante des checkpoints et de l’ordonnancement groupé. L’inférence en ligne peut davantage dépendre du temps de démarrage à froid, de la localité du cache de modèles, de la latence de queue et de la sûreté des déploiements progressifs.
Un modèle de nommage utile pour les pools de nœuds est :
gpu-pool:
  accelerator: h100-80gb
  topology: 8gpu-sxm-nvlink
  fabric: infiniband
  workload: distributed-training
  sharing: full-gpu
Ces labels ne sont pas de la simple documentation. Ils deviennent des sélecteurs d’ordonnancement, des dimensions de quotas, des étiquettes de coût et du contexte de débogage.
Étape 3 : exposer les GPU avec le bon mécanisme Kubernetes
Kubernetes ordonnance les GPU via des mécanismes de ressources spécialisés. La base courante est un plugin de périphérique fourni par le fournisseur, qui annonce les ressources GPU au kubelet afin que les pods puissent les demander comme ressources étendues. Kubernetes documente le modèle de demande et les contraintes de sélection des nœuds dans son guide d’ordonnancement des GPU. Le plugin de périphérique Kubernetes de NVIDIA est la voie standard pour les GPU NVIDIA, et le NVIDIA GPU Operator regroupe plusieurs composants opérationnels, notamment la gestion des pilotes et du runtime, le déploiement du plugin de périphérique, la gestion de MIG et la télémétrie GPU.
Pour de nombreuses équipes, le premier chemin vers la production est :
node image + kernel prerequisites
  -> NVIDIA driver and container runtime
  -> NVIDIA GPU Operator
  -> Kubernetes device plugin
  -> DCGM exporter metrics
  -> workload namespaces and quotas
L’allocation dynamique des ressources Kubernetes est également importante pour les équipes qui évaluent un modèle d’allocation des périphériques plus riche. La DRA est conçue autour des demandes de ressources et des classes de périphériques, ce qui peut être utile lorsque de simples demandes de ressources étendues n’expriment pas suffisamment les exigences de placement ou propres aux périphériques. Considérez-la comme un choix de plateforme délibéré : le pilote, la version de Kubernetes, l’API de charge de travail et la stratégie d’observabilité doivent tous être testés ensemble.
La décision pratique est la suivante :
| Besoin | Mécanisme Kubernetes à évaluer |
|---|---|
| Planification de base de pods utilisant un GPU entier | Plugin de périphérique et ressources étendues de type nvidia.com/gpu. |
| Gestion du cycle de vie des GPU NVIDIA | NVIDIA GPU Operator. |
| Télémétrie GPU | Exportateur DCGM avec Prometheus/Grafana ou votre pile d’observabilité. |
| Demandes de périphériques plus expressives | Allocation dynamique des ressources Kubernetes. |
| Partitionnement des GPU | MIG lorsqu’il est pris en charge, avec des limites explicites concernant l’isolation et les performances. |
| Accès de développement partagé dans le temps | Découpage temporel ou politique de plateforme, uniquement après avoir clarifié les règles d’isolation et de quotas. |
Ne cachez pas cette couche aux équipes applicatives. Elles doivent savoir si un pod reçoit un accélérateur entier, une tranche MIG ou un périphérique partagé dans le temps, car les hypothèses en matière de performances et de débogage changent.
Étape 4 : ajoutez une couche de file d’attente avant que les équipes ne se disputent les GPU
Le planificateur Kubernetes par défaut ne constitue pas à lui seul une file d’attente IA multi-locataire complète. Les équipes IA ont généralement besoin de l’admission des charges de travail, d’un partage équitable, de quotas, d’une politique de préemption et d’une visibilité sur les raisons pour lesquelles les tâches attendent.
Kueue est le projet natif Kubernetes à évaluer lorsque la mise en file d’attente des traitements par lots et des charges de travail IA/ML est importante. Ses concepts fondamentaux incluent les charges de travail, les files d’attente locales, les files d’attente de cluster, les cohortes et les variantes de ressources. Cela permet aux équipes de plateforme de modéliser des pools de GPU rares et de décider quelles tâches sont admises lorsque les ressources sont disponibles.
Volcano est une autre option de planification par lots Kubernetes pour les charges de travail IA, big data et de type HPC. Son planificateur gang utilise une condition minimale de pods « tout ou rien », utile à évaluer pour les tâches distribuées qui gaspilleraient autrement des GPU partiellement alloués en attendant leurs homologues.
Pour une infrastructure IA de cluster GPU Kubernetes, définissez par écrit la politique de file d’attente :
| Politique | Décision à prendre |
|---|---|
| Admission | Quelles tâches peuvent entrer dans la file d’attente et quelles métadonnées sont requises ? |
| Partage équitable | Comment les GPU sont-ils répartis entre les équipes, les projets ou les environnements ? |
| Priorité | Quelles tâches d’inférence de production ou d’entraînement critiques pour un lancement peuvent passer devant dans la file d’attente ? |
| Préemption | Les tâches peuvent-elles être évincées et comment les points de contrôle sont-ils exigés avant l’éviction ? |
| Variantes de ressources | Quels pools de GPU sont interchangeables et lesquels ne le sont pas ? |
| Remplissage | Des tâches plus petites peuvent-elles s’exécuter pendant qu’une grande exécution distribuée attend ? |
| Visibilité | Les utilisateurs peuvent-ils voir leur position dans la file d’attente et les motifs de refus sans solliciter les ingénieurs de plateforme ? |
La politique de file d’attente est un mécanisme de contrôle des coûts. Sans elle, l’équipe la plus bruyante peut consommer la capacité la plus coûteuse tandis que les petites tâches attendent ou sont déplacées vers une infrastructure parallèle non gérée.
Étape 5 : choisissez des API de charges de travail pour l’entraînement et l’inférence
Un cluster GPU Kubernetes est particulièrement utile lorsque les équipes applicatives peuvent soumettre des charges de travail sans rédiger à chaque fois des spécifications de pods de bas niveau.
Pour l’entraînement, évaluez :
- Les Jobs Kubernetes natifs pour les exécutions simples sur un seul nœud.
- Kubeflow Trainer pour les workflows d’entraînement distribué sur plusieurs frameworks.
- Ray et KubeRay pour Python distribué, l’inférence par lots et les modèles de serving.
- L’intégration de Volcano ou Kueue lorsqu’une planification gang ou une admission via file d’attente est nécessaire.
- Des opérateurs personnalisés uniquement lorsque la plateforme dispose de modèles internes stables que les outils génériques ne couvrent pas.
Pour l’inférence, évaluez :
- Deployments ou StatefulSets pour les services simples.
- Des conteneurs de serving vLLM, SGLang, Triton ou TensorRT-LLM selon le modèle et les objectifs de performances.
- KServe ou une autre couche de serving de modèles lorsque les équipes ont besoin d’abstractions de cycle de vie des modèles.
- Des règles de mise à l’échelle horizontale et verticale basées sur la profondeur de la file d’attente, la latence, la mémoire GPU et le mix de requêtes.
- Des pools de nœuds distincts pour le trafic de production sensible à la latence et les charges de travail par lots.
Au départ, gardez l’API de charge de travail simple. Un modèle Job clair avec des libellés, des demandes de ressources, des montages de stockage et l’exportation des journaux vaut mieux qu’une plateforme complexe que personne ne peut déboguer.
Étape 6 : validez le chemin réseau et stockage
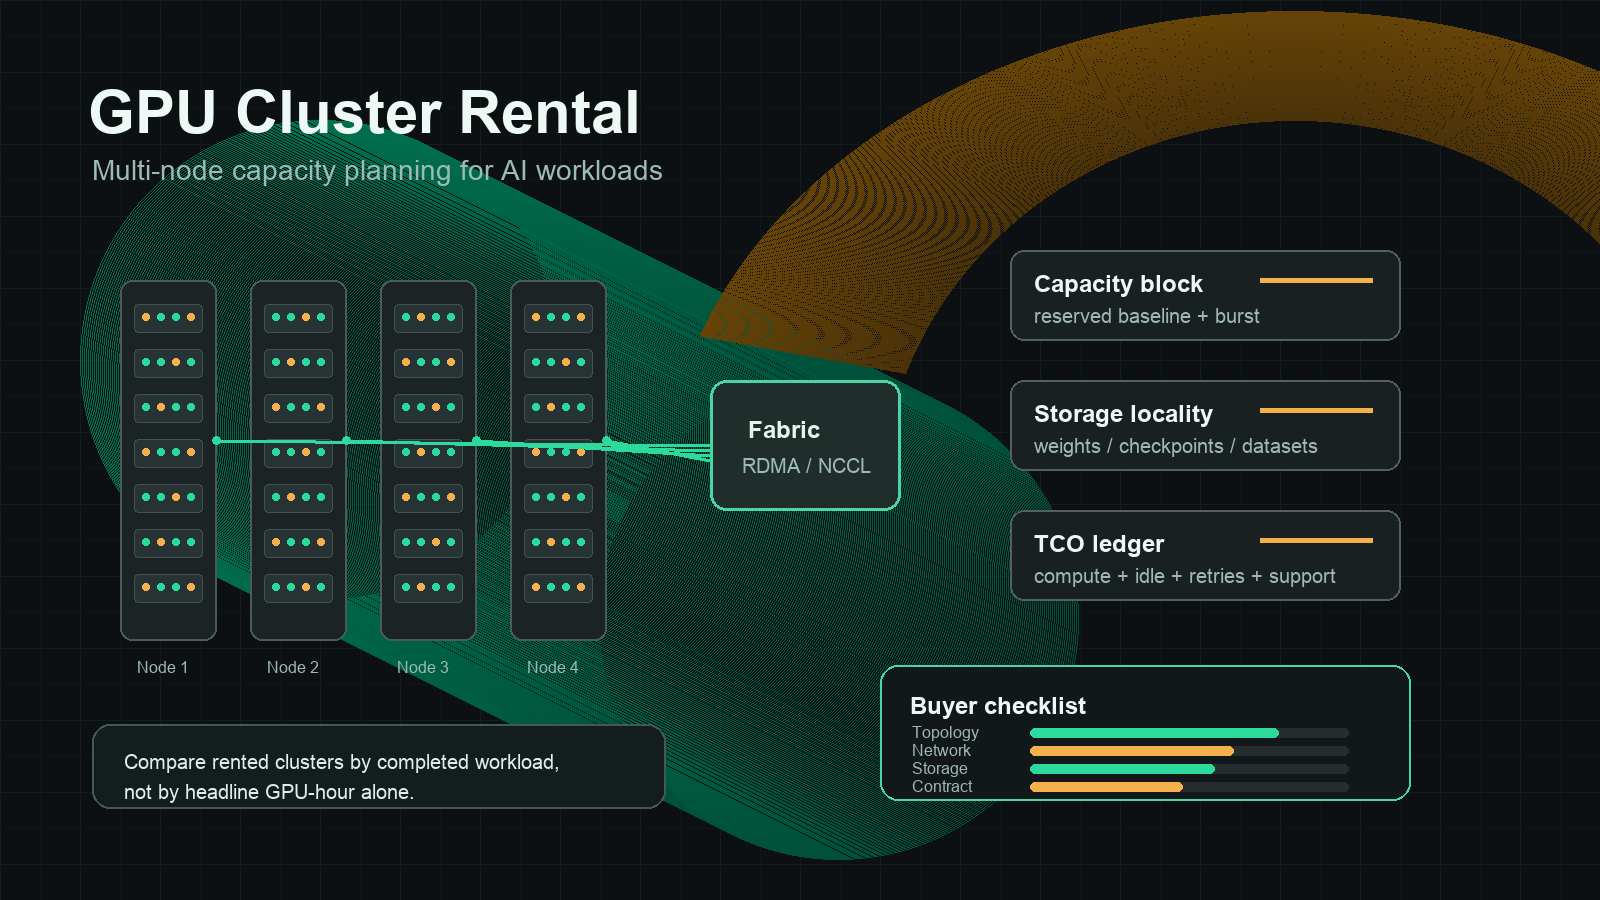
La différence entre une démonstration fonctionnelle et une infrastructure IA de cluster GPU Kubernetes de production apparaît souvent lors des tests réseau et de stockage.
Pour l’entraînement distribué, validez :
- Le placement inter-nœuds.
- Le comportement all-reduce de NCCL sur chaque nœud prévu.
- Les erreurs de fabric, les retransmissions, la congestion et les variations d’un nœud à l’autre.
- Les versions du pilote, de CUDA, de NCCL et de l’image de conteneur.
- Les performances après l’installation de l’image de conteneur de production, et pas uniquement avec une image de benchmark propre.
Pour le stockage, validez :
- Temps de préparation du jeu de données.
- Téléchargement des poids du modèle et préchauffage du cache.
- Fréquence et durée d’écriture des points de contrôle.
- Temps de restauration après la défaillance d’un nœud ou d’un pod.
- Comportement du système de fichiers partagé lors de l’exécution simultanée de plusieurs tâches.
- Région du stockage d’objets, trafic sortant et règles de cycle de vie.
Un test d’acceptation minimal ressemble à ceci :
1. Soumettez une tâche d’entraînement en file d’attente avec le conteneur de production.
2. Récupérez l’échantillon réel du jeu de données et les poids du modèle de base.
3. Exécutez un benchmark de communication multinœud si la charge de travail est distribuée.
4. Entraînez ou affinez le modèle pendant une durée fixe.
5. Écrivez un point de contrôle, supprimez un pod et restaurez à partir du point de contrôle.
6. Exportez les libellés GPU, réseau, stockage, file d’attente et coût.
7. Comparez le travail utile à la référence du modèle/de l’API ou de la location de GPU.
Ce test doit être exécuté avant les réservations de longue durée ou les engagements financiers élevés. Il est moins coûteux de découvrir une interconnexion insuffisante ou un chemin de point de contrôle lent lors d’un benchmark que pendant une fenêtre de lancement.
Outils de gestion de clusters GPU Kubernetes
L’expression kubernetes gpu cluster management tools couvre plusieurs tâches distinctes. N’achetez ni n’installez d’outils avant d’avoir identifié la tâche qu’ils doivent accomplir.
| Besoin de gestion | Outils ou projets à évaluer | À quoi ressemble une bonne solution |
|---|---|---|
| Cycle de vie des GPU | NVIDIA GPU Operator, device plugin, automatisation des images de nœuds | Les pilotes, l’environnement d’exécution, l’exposition des périphériques et la télémétrie sont reproductibles sur tous les nœuds. |
| Mise en file d’attente | Kueue, Volcano, modèles de soumission de tâches Ray | Les utilisateurs voient clairement les états admis, en attente, en cours d’exécution, échoué et terminé. |
| Flux de travail d’entraînement | Kubeflow Training Operator, Ray, Jobs natifs | Les tâches distribuées sont reproductibles et ne nécessitent pas de YAML de pod sur mesure à chaque fois. |
| Service d’inférence | vLLM, SGLang, Triton, KServe, Deployments | Les déploiements, contrôles d’état, latence et comportement du cache de modèles sont visibles. |
| Observabilité | Exportateur DCGM, Prometheus, Grafana, journaux, traces, événements Kubernetes | Les métriques GPU sont reliées aux libellés de tâche, d’équipe, de modèle et de coût. |
| Politique | RBAC, ResourceQuota, LimitRange, contrôles d’admission, politique d’image, politique réseau | L’accès mutualisé est restreint sans bloquer le développement normal. |
| Répartition des coûts | Libellés d’espace de noms, libellés de charge de travail, export d’utilisation, tableau de bord de facturation | La finance peut attribuer les dépenses à l’équipe, à l’environnement, au modèle et au résultat accepté. |
Évitez une plateforme qui ne rapporte que les heures GPU allouées. Une gestion utile indique pourquoi les GPU étaient inactifs, quelles tâches échouées ont consommé de la capacité et si les sorties d’inférence ou les jalons d’entraînement justifiaient les dépenses.
Questions sur les clusters GPU Kubernetes CoreWeave
Certaines équipes recherchent un coreweave kubernetes gpu cluster parce qu’elles souhaitent un accès natif Kubernetes à la capacité GPU cloud plutôt qu’à des machines virtuelles génériques. Considérez cette requête modifiée par le fournisseur comme une invitation à la diligence raisonnable : pour CoreWeave ou tout fournisseur de cloud GPU similaire, vérifiez le modèle exact d’accès Kubernetes, les contrôles des pools de nœuds, la compatibilité des opérateurs, les exports de quotas et le périmètre du support avant d’engager des charges de travail de production.
Appliquez la même diligence raisonnable à tout fournisseur :
| Question | Pourquoi c’est important |
|---|---|
| Quels SKU de GPU et quels types de nœuds sont réellement disponibles dans la région demandée ? | L’inventaire marketing et la capacité allouable ne sont pas la même chose. |
| Les nœuds sont-ils homogènes au sein de la réservation ou du pool ? | Des nœuds hétérogènes peuvent invalider les hypothèses de performance. |
| Quelle interconnexion est utilisée entre les nœuds GPU ? | L’entraînement multinœud dépend du placement et du comportement du réseau. |
| Qui est responsable des mises à niveau des pilotes, de CUDA et de Kubernetes ? | Les limites de responsabilité des mises à niveau affectent les interruptions et la reproductibilité. |
| Pouvez-vous exécuter GPU Operator, Kueue, Volcano, Ray ou les opérateurs requis ? | Kubernetes géré requiert tout de même une compatibilité de plateforme. |
| Comment les quotas, les exports d’utilisation et les libellés sont-ils exposés ? | Les équipes finance et plateforme ont besoin d’une attribution des coûts. |
| Quel est le parcours de support lors d’échecs d’exécutions distribuées ? | Vous avez besoin des journaux, de l’identité des nœuds et d’une procédure d’escalade avant la production. |
| Quelle est la procédure de sortie pour les données, les poids de modèles et les points de contrôle ? | Le coût de migration fait partie de la décision d’architecture. |
Kubernetes proposé par un fournisseur n’élimine pas le besoin de tests d’acceptation. Il modifie les couches que vous exploitez directement et celles que vous vérifiez à partir d’éléments de preuve du niveau de service.
Liste de contrôle de sécurité et de mutualisation
Les clusters GPU deviennent souvent rapidement une infrastructure partagée. La sécurité doit être conçue avant que la deuxième équipe commence à utiliser le cluster.
Contrôles minimaux :
- Un espace de noms par équipe, environnement ou périmètre de charge de travail.
- RBAC lié à votre fournisseur d’identité.
- ResourceQuota et LimitRange pour les GPU, les CPU, la mémoire et le stockage.
- Politique explicite pour les pods privilégiés, les montages hôte, le réseau hôte et l’accès aux périphériques.
- Gestion et rotation des secrets.
- Politique de registre d’images privé, signature, analyse ou contrôles d’admission.
- Politique réseau pour le trafic sortant, l’accès aux jeux de données et les périmètres de service.
- Journaux d’audit pour la soumission de tâches, l’accès aux secrets, l’utilisation des images et les actions administratives.
- Règles de nettoyage des données pour le NVMe local, les volumes temporaires, les points de contrôle, les journaux et les tâches en échec.
Si le cluster traite des données client ou des poids de modèle propriétaires, considérez les nœuds workers comme une infrastructure sensible. Un pod ayant accès aux GPU peut également avoir accès à des données de grande valeur, à des artefacts de modèle et à des identifiants.
Observabilité et modèle de coûts
Un cluster GPU Kubernetes de production nécessite simultanément trois perspectives :
- Vue plateforme : état de santé des nœuds, état de santé des GPU, réseau, stockage, état des files d’attente, événements Kubernetes.
- Vue charge de travail : propriétaire de la tâche, image, modèle, jeu de données, environnement d’exécution, nombre de nouvelles tentatives, motif de sortie, qualité de sortie.
- Vue financière : temps GPU alloué, temps GPU utile, temps d’inactivité, coût des tâches en échec, coût par unité acceptée.
Suivez au minimum :
- Utilisation du GPU, mémoire GPU, puissance, température et événements d’erreur.
- Étiquettes de pod, de tâche, d’espace de noms, de pool de nœuds, de modèle et d’équipe.
- Temps d’attente en file et motif d’admission.
- Débit d’entraînement, durée des points de contrôle et temps de restauration.
- Latence d’inférence, débit, taille de lot, taux de succès du cache et taux d’erreur.
- Débit du stockage et durée de transfert vers le stockage d’objets.
- Pannes de nœuds, évictions, préemptions et nouvelles tentatives.
Normalisez ensuite le coût :
effective_kubernetes_gpu_cluster_cost =
  (compute + network + storage + support + idle + failed_runs + operations)
  / accepted_workload_units
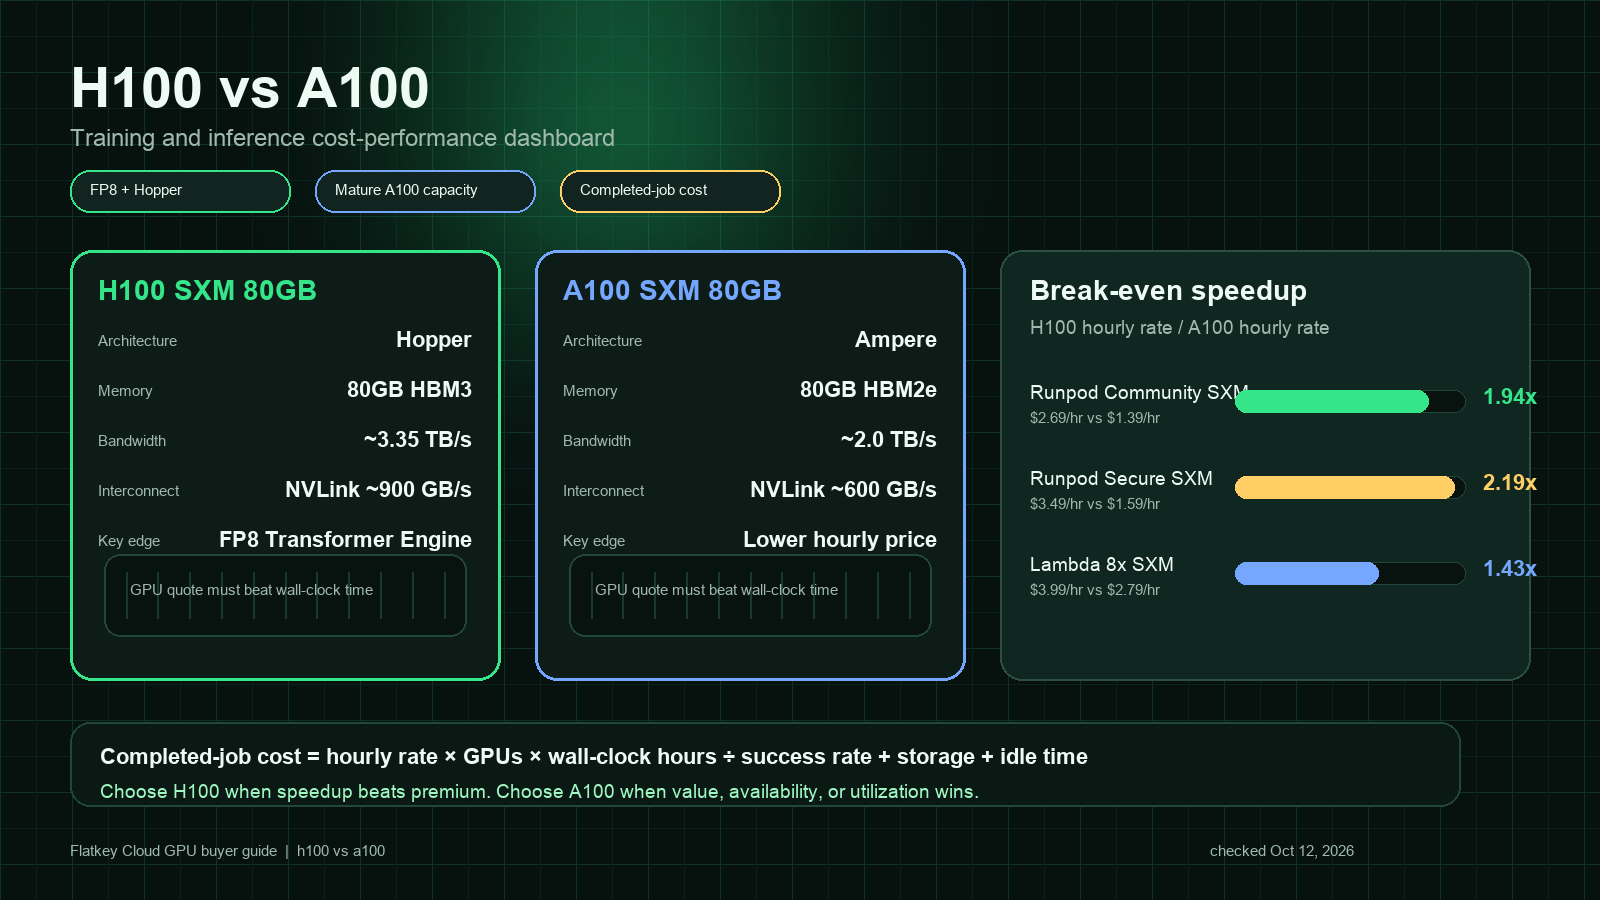
Le dénominateur doit correspondre à l’activité : exécutions d’entraînement terminées, sorties de modèle acceptées, tâches de génération de médias, lots d’indexation ou requêtes client. Pour une analyse plus approfondie des coûts, utilisez la feuille de calcul de TCO de cluster GPU et comparez avec GPU cloud vs API de modèle avant d’étendre le cluster.
Liste de contrôle de mise en œuvre
Utilisez ceci comme ordre de construction pour la première tranche de production :
| Phase | Livrable | Condition de validation |
|---|---|---|
| Résumé de la charge de travail | Spécification de charge de travail d’une page | L’équipe s’accorde sur le modèle, le framework, les données, l’échelle, le SLA et le dénominateur de coût. |
| Pool de nœuds | Spécification et étiquettes des nœuds GPU | La configuration des nœuds, la topologie, le pilote, l’environnement d’exécution et la politique de mise à niveau sont documentés. |
| Exposition des GPU | Plugin de périphériques ou GPU Operator installé | Les pods peuvent demander des GPU et les métriques DCGM sont visibles. |
| Mise en file d’attente | Kueue, Volcano ou politique d’ordonnancement documentée | Les utilisateurs peuvent soumettre des tâches et voir l’état de la file/d’admission. |
| Stockage | Chemins des jeux de données, du cache de modèles, des points de contrôle et des journaux | Le test de restauration réussit après une panne forcée de pod ou de nœud. |
| Réseau | Test de la fabric et test du trafic de production | Le benchmark distribué ou le chemin d’inférence atteint le seuil de la charge de travail. |
| Sécurité | RBAC, espaces de noms, quotas, secrets, politique d’images | Une nouvelle équipe peut être intégrée sans accès cluster-admin. |
| Observabilité | Tableaux de bord et export des usages | Les opérateurs peuvent répondre à qui a utilisé quels GPU et pourquoi les tâches ont échoué. |
| Acceptation | Exécution de charge de travail de bout en bout | La sortie utile dépasse ou justifie la référence du modèle/de l’API ou de la location. |
Ne passez pas de 8 GPU à 80 GPU tant que cette liste de contrôle n’est pas devenue banale. C’est l’objectif : une soumission de tâches reproductible, un placement prévisible, une récupération connue en cas d’échec, un coût visible et des responsabilités claires.
Erreurs courantes
- Acheter de la capacité GPU avant d’avoir validé le mouvement des données et la récupération des points de contrôle.
- Traiter le plugin de périphériques comme l’ensemble de la plateforme.
- Mélanger l’entraînement et l’inférence de production dans le même pool de nœuds sans règles de priorité ni d’isolation.
- Autoriser chaque équipe à rédiger des spécifications de pod uniques sans étiquettes communes.
- Suivre le temps GPU alloué, mais pas le travail utile.
- Reporter la politique de file d’attente jusqu’à ce que le cluster soit déjà surchargé.
- Supposer que Kubernetes managé implique une infrastructure d’IA managée.
- Exécuter des benchmarks sur une image propre et la production sur une image différente.
- Oublier une stratégie de sortie pour les jeux de données, les poids, les points de contrôle et les journaux.
Ces erreurs sont coûteuses, car elles consomment du temps GPU rare sans produire de travail accepté.
FAQ
Qu’est-ce qu’un cluster GPU Kubernetes ?
Un cluster GPU Kubernetes est un cluster Kubernetes doté de nœuds workers compatibles GPU, dont l’exposition des périphériques, la politique d’ordonnancement, le stockage, le réseau et l’observabilité sont configurés afin que les pods et les tâches puissent utiliser des accélérateurs pour l’entraînement, l’inférence, le traitement par lots ou les charges de travail de recherche.
Ai-je besoin de NVIDIA GPU Operator ?
Pas toujours, mais de nombreuses plateformes Kubernetes GPU basées sur NVIDIA l’évaluent, car il regroupe le pilote, l’environnement d’exécution, le plugin de périphériques, MIG et les composants de télémétrie dans un flux de travail géré par opérateur. Certains fournisseurs managés prennent en charge une partie de cette pile pour vous ; vérifiez donc la frontière de responsabilité avant de l’installer vous-même.
Kueue est-il nécessaire pour un cluster GPU Kubernetes ?
Kueue n’est pas nécessaire pour chaque cluster, mais il vaut la peine d’être évalué lorsque la capacité GPU limitée est partagée entre des équipes ou des tâches d’IA par lots. Sans couche de mise en file d’attente, les utilisateurs ont souvent peu de visibilité sur les raisons pour lesquelles les tâches attendent ou les quotas sont refusés.
Kubernetes peut-il exécuter un entraînement multi-nœuds ?
Oui, mais l’entraînement multi-nœuds exige plus que la planification des GPU. Vous avez besoin du placement, de la validation du réseau à haut débit, de conteneurs compatibles, de points de contrôle et, souvent, d’un comportement de mise en file d’attente ou de planification groupée. Testez le pool de nœuds exact et l’image de production avant d’engager une capacité importante.
L’inférence et l’entraînement doivent-ils partager le même cluster GPU ?
C’est possible, mais uniquement avec des pools de nœuds, des règles de priorité, des quotas et une isolation clairement définis. L’inférence en production présente généralement des exigences de latence et de disponibilité qui entrent en conflit avec les grandes tâches d’entraînement. Commencez par les séparer, sauf si vous pouvez prouver l’efficacité de la politique partagée sous charge.
Quand devrais-je utiliser une API de modèle plutôt qu’un cluster GPU Kubernetes ?
Utilisez d’abord une API de modèle lorsque vous avez uniquement besoin des sorties du modèle, que votre combinaison de modèles change fréquemment, que l’utilisation est faible ou que votre équipe n’est pas prête à exploiter les pilotes GPU, les files d’attente, le stockage, la surveillance et la gestion des incidents. Créez un cluster lorsque le contrôle, la confidentialité, les poids personnalisés ou l’économie de vos charges de travail justifient la charge d’exploitation.
Références officielles
- Kubernetes : planifier des GPU
- Kubernetes : plugins de périphériques
- Kubernetes : allocation dynamique des ressources
- Kubernetes : affectation de Pods aux nœuds
- NVIDIA GPU Operator
- NVIDIA : installer GPU Operator
- NVIDIA : installer DCGM Exporter
- Concepts Kueue
- Planification groupée Volcano
- Présentation de Kubeflow Trainer
Conclusion
Un cluster GPU Kubernetes mérite d’être créé lorsque Kubernetes offre à votre infrastructure d’IA un meilleur contrôle du placement, de la reproductibilité, de la sécurité, de l’observabilité et des coûts que des machines GPU ad hoc ou des API gérées. Commencez avec une charge de travail limitée, validez le pool de nœuds, exposez les GPU proprement, ajoutez la mise en file d’attente avant que la contention ne commence et mesurez la production utile plutôt que la simple allocation de GPU.
Lorsque le cluster ne peut pas surpasser une location de GPU plus simple ou une approche par modèle/API en matière de travail accepté, ne l’étendez pas. Lorsqu’il le peut, Kubernetes devient le plan de contrôle qui transforme des accélérateurs limités en une plateforme d’IA partagée.