
Blog flatkey.ai
Analyses, notes produit et guides d'implémentation pour les équipes qui construisent avec des API d'IA.
Architecture des passerelles IA
Derniers articles dans Architecture des passerelles IA.
Lire la suiteMigration des URL de base et des SDK
Derniers articles dans Migration des URL de base et des SDK.
Lire la suiteCoûts, facturation et exploitation
Derniers articles dans Coûts, facturation et exploitation.
Lire la suiteContrôles d’entreprise et confiance
Derniers articles dans Contrôles d’entreprise et confiance.
Lire la suiteComparatifs de passerelles
Derniers articles dans Comparatifs de passerelles.
Lire la suiteGuides des modèles et des modalités
Derniers articles dans Guides des modèles et des modalités.
Lire la suiteFiabilité et routage
Derniers articles dans Fiabilité et routage.
Lire la suiteIntégrations d’outils
Derniers articles dans Intégrations d’outils.
Lire la suite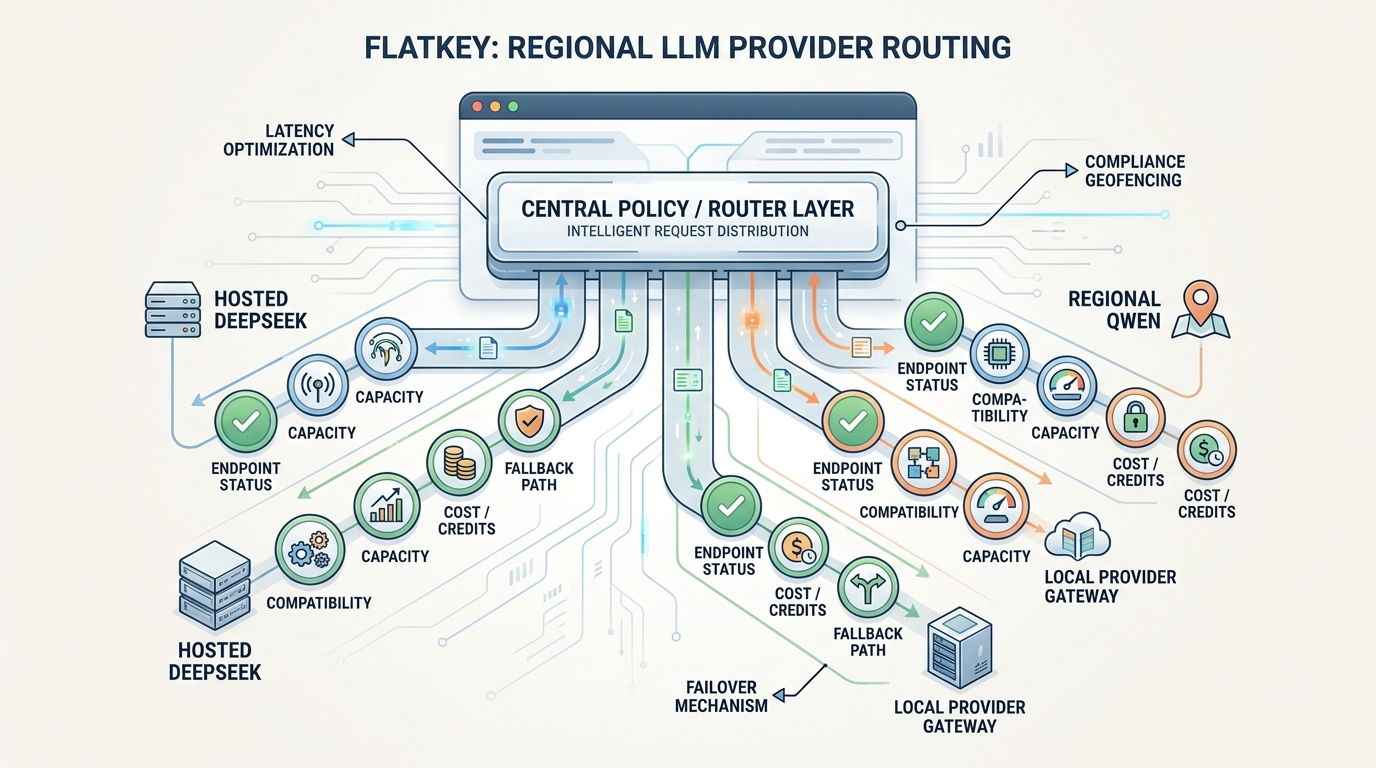
Routage régional des fournisseurs de LLM : quand DeepSeek, Qwen et les fournisseurs locaux nécessitent des vérifications séparées
Un framework pratique de vérification des fournisseurs pour router les passerelles LLM DeepSeek, Qwen et locales avec des contrôles de région, compatibilité, capacité, coût et repli.
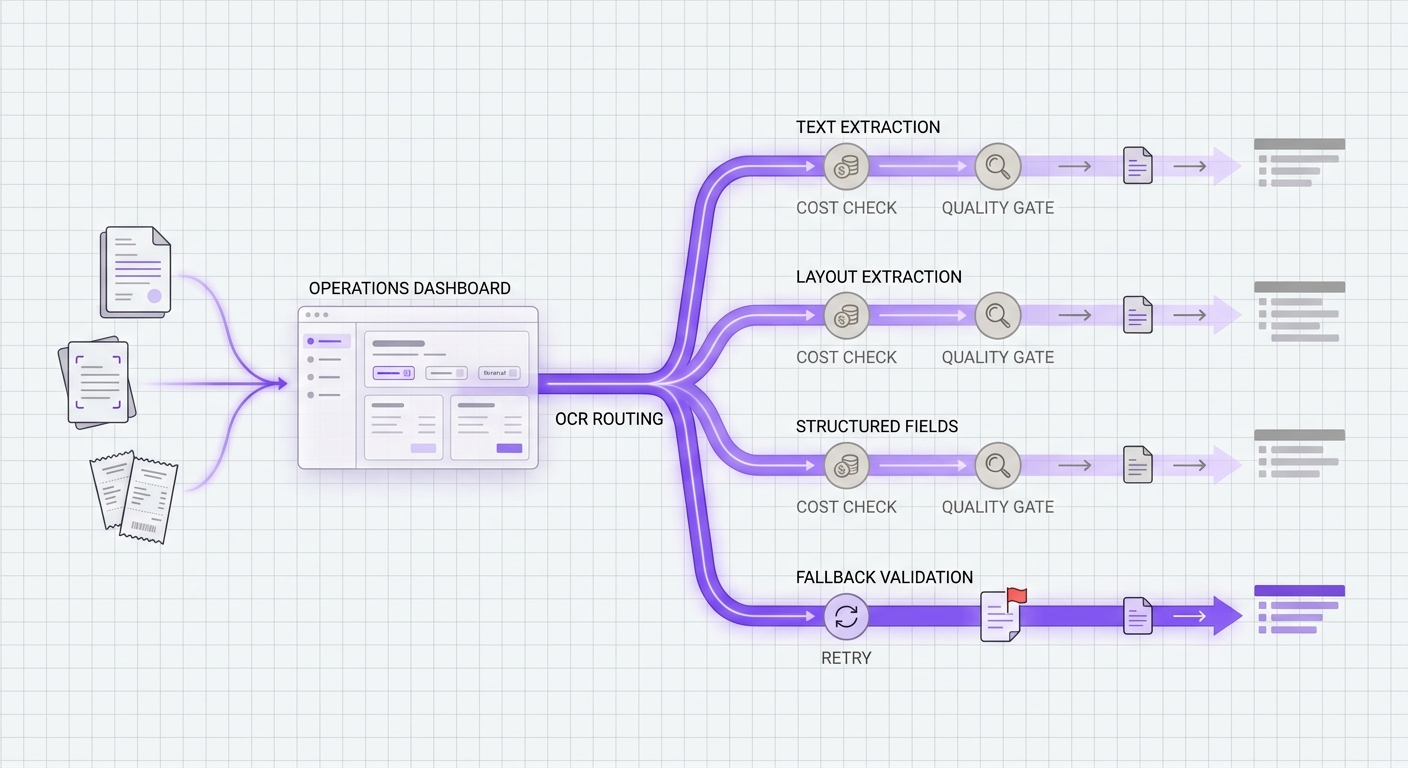
Routage des modèles OCR : comment équilibrer le coût d’extraction de texte, la qualité et les vérifications de repli
Utilisez ce cadre de routage des modèles OCR pour comparer le coût de l’API OCR, la qualité d’extraction et les contraintes de repli avant de standardiser le trafic d’IA documentaire.
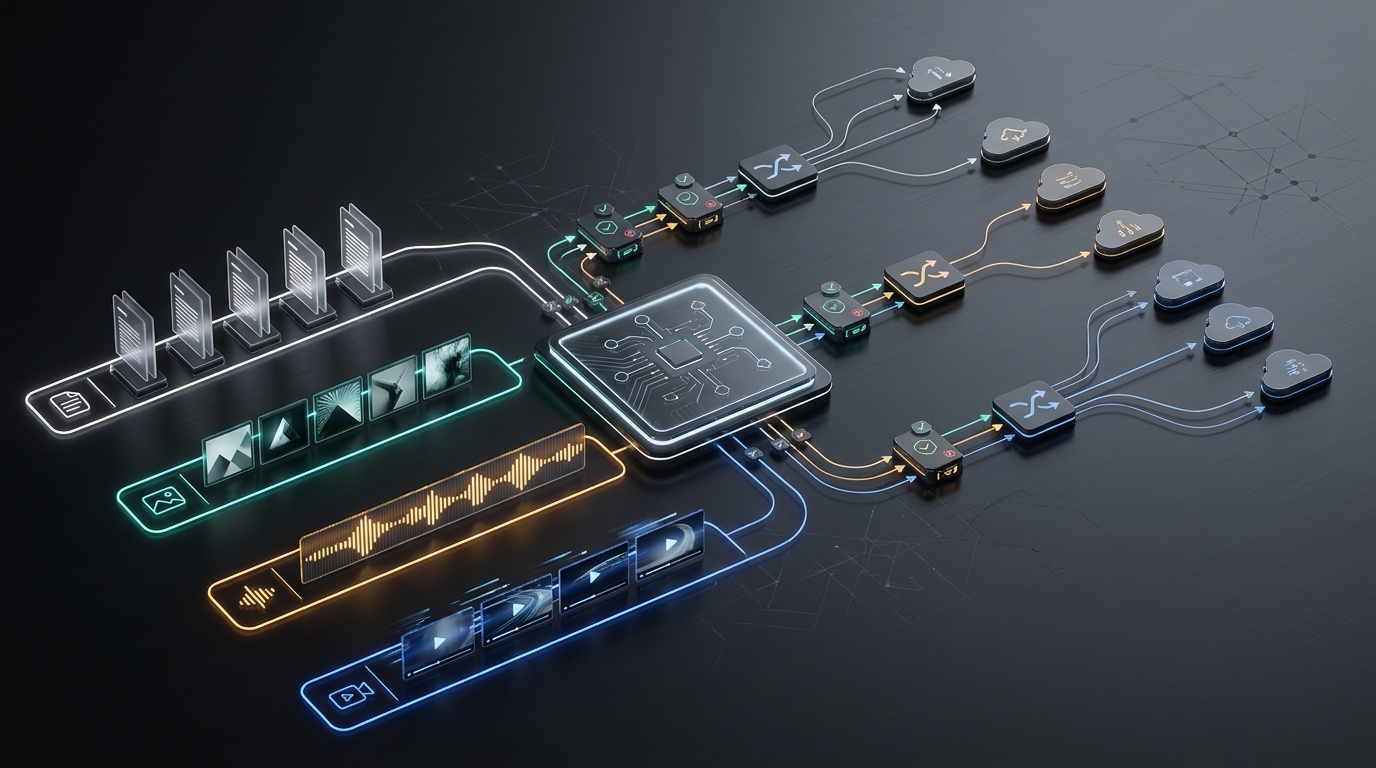
Routage de secours pour les API LLM : routage d’agents multimodaux pour le texte, l’image, l’audio et la vidéo
Un guide pratique de routage de secours pour les agents d’IA multimodaux qui gèrent des workflows API de texte, d’image, d’audio et de vidéo.
Tarifs de l’API Kimi (octobre 2026) : coûts de Kimi K3, K2.7 Code et K2.6, et configuration de l’API K3
Tarifs officiels de l’API Kimi pour K3, K2.7 Code et K2.6 en octobre 2026, avec remises sur le cache et les traitements par lots, frais de recherche web, paliers de recharge, exemples de budgets mensuels et code K3 prêt à copier-coller.
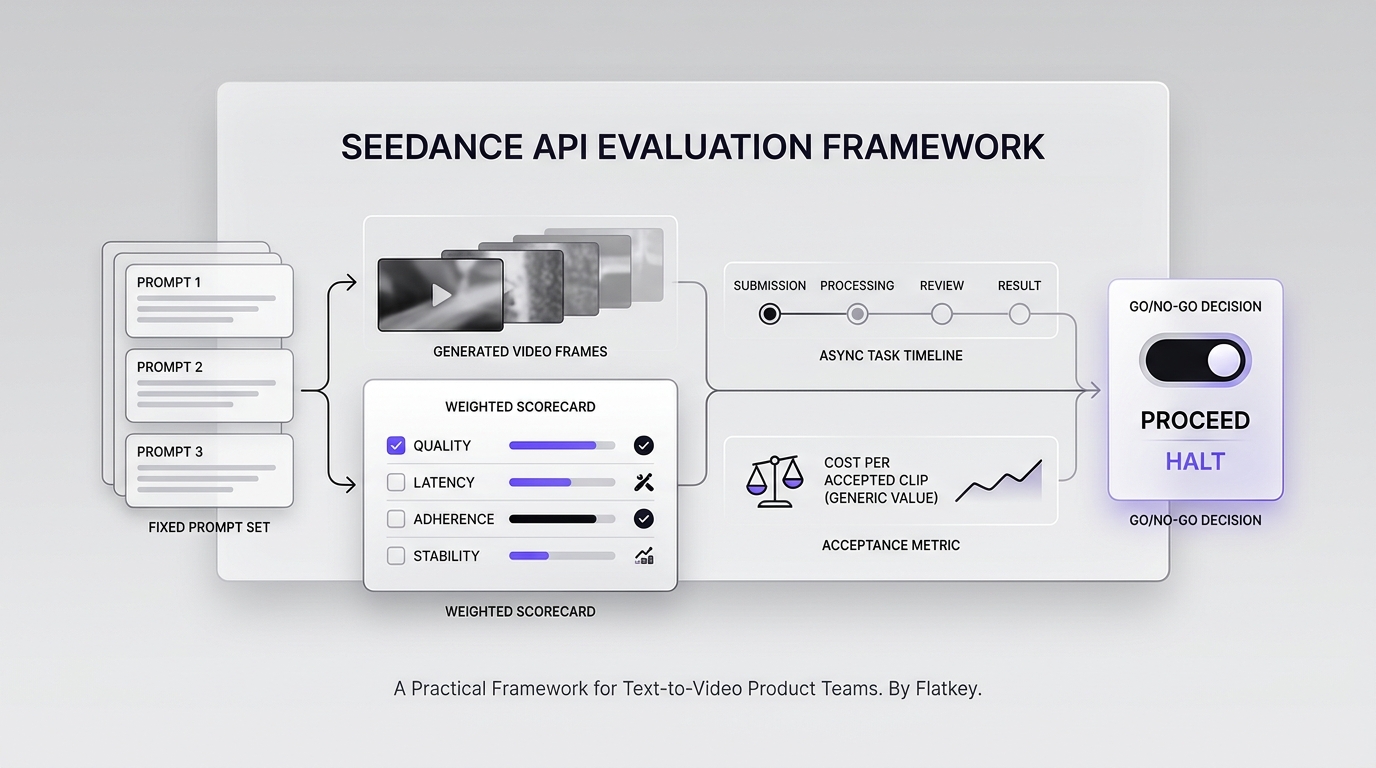
Cadre d’évaluation de l’API Seedance pour les équipes produit texte-vers-vidéo
Un cadre reproductible pour évaluer la qualité, la fiabilité, l’expérience utilisateur, la sécurité et le coût de l’API Seedance avant le déploiement d’un produit texte-vers-vidéo.
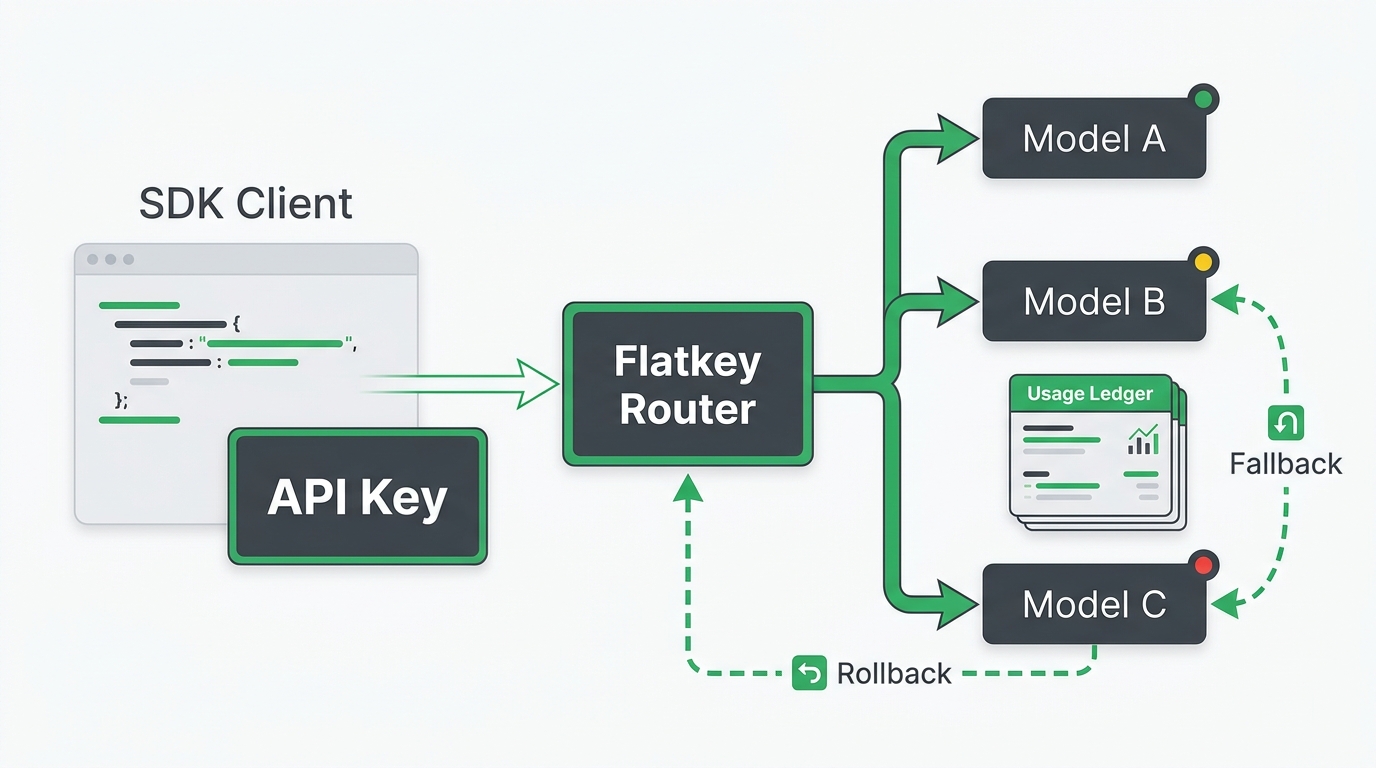
Comment utiliser une alternative à l’API OpenAI en 2026
Découvrez comment tester une alternative à l’API OpenAI avec une migration reversible de base_url, des smoke tests, des règles de repli, des journaux d’utilisation et des métriques de déploiement.
Les métriques d’API LLM qui comptent vraiment
Une grille d’évaluation pratique pour mesurer la fiabilité, la latence, le coût, les relances, les solutions de repli, l’efficacité du contexte et l’auditabilité d’une API LLM.
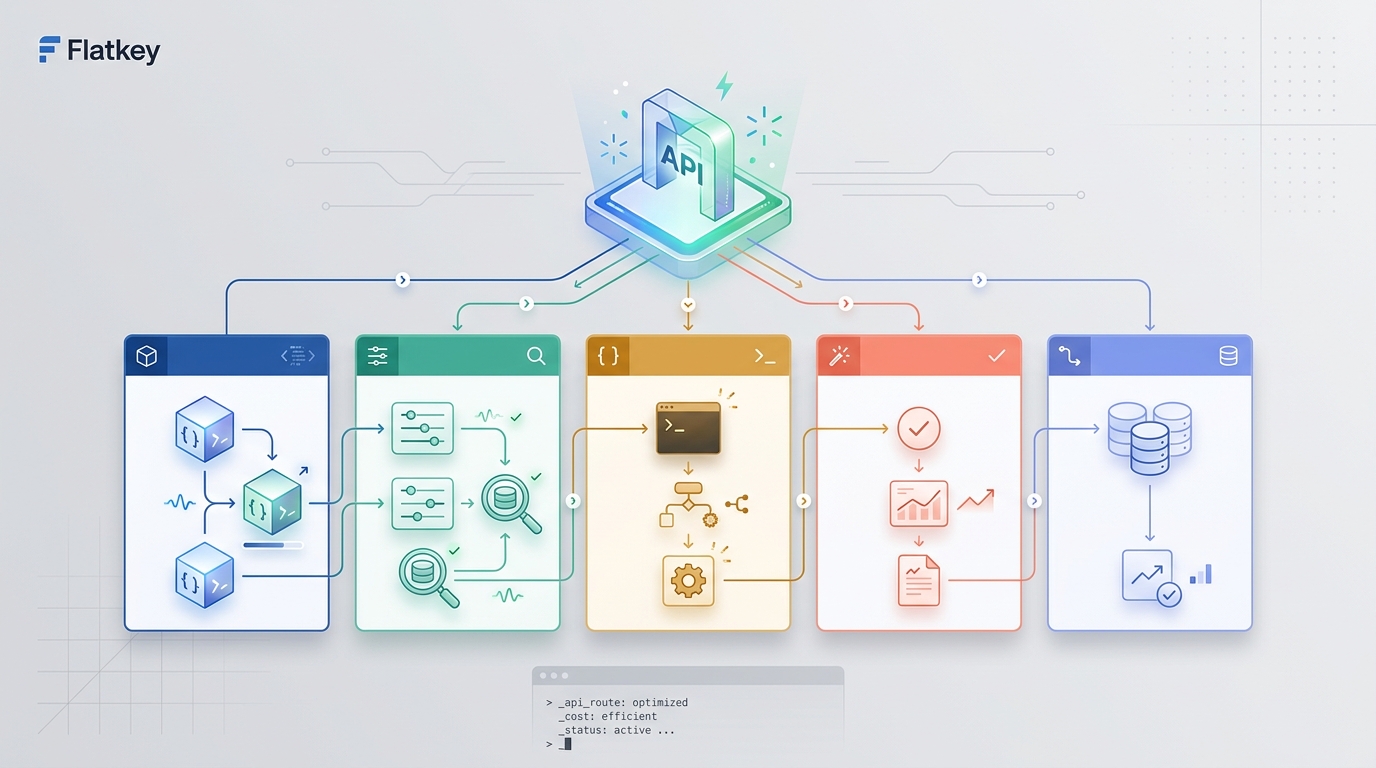
Cas d’usage des API d’IA par étape du funnel : guide pratique pour les équipes
Cartographiez les cas d’usage des API d’IA selon la notoriété, l’évaluation, l’activation, la conversion, la rétention et les opérations avec des workflows et des indicateurs pratiques.
API de génération d’images : guide pratique pour les équipes
Un workflow pratique d’API de génération d’images pour les équipes qui choisissent les routes de modèle, les prompts, les contrôles de coût, la gestion de la sécurité, les files de relecture et les journaux d’utilisation.
Comment utiliser une API IA unifiée en 2026
Un workflow pratique pour 2026 afin de mettre en place une API IA unifiée avec une seule clé, une seule base URL compatible OpenAI, la vérification de l’utilisation, des contrôles de bascule et des métriques de déploiement.
Les métriques d’API de routage IA qui comptent vraiment
Un tableau de bord pratique pour les opérateurs afin de mesurer si une API de routage IA améliore la fiabilité, la qualité des bascules, la latence, les coûts et l’observabilité.
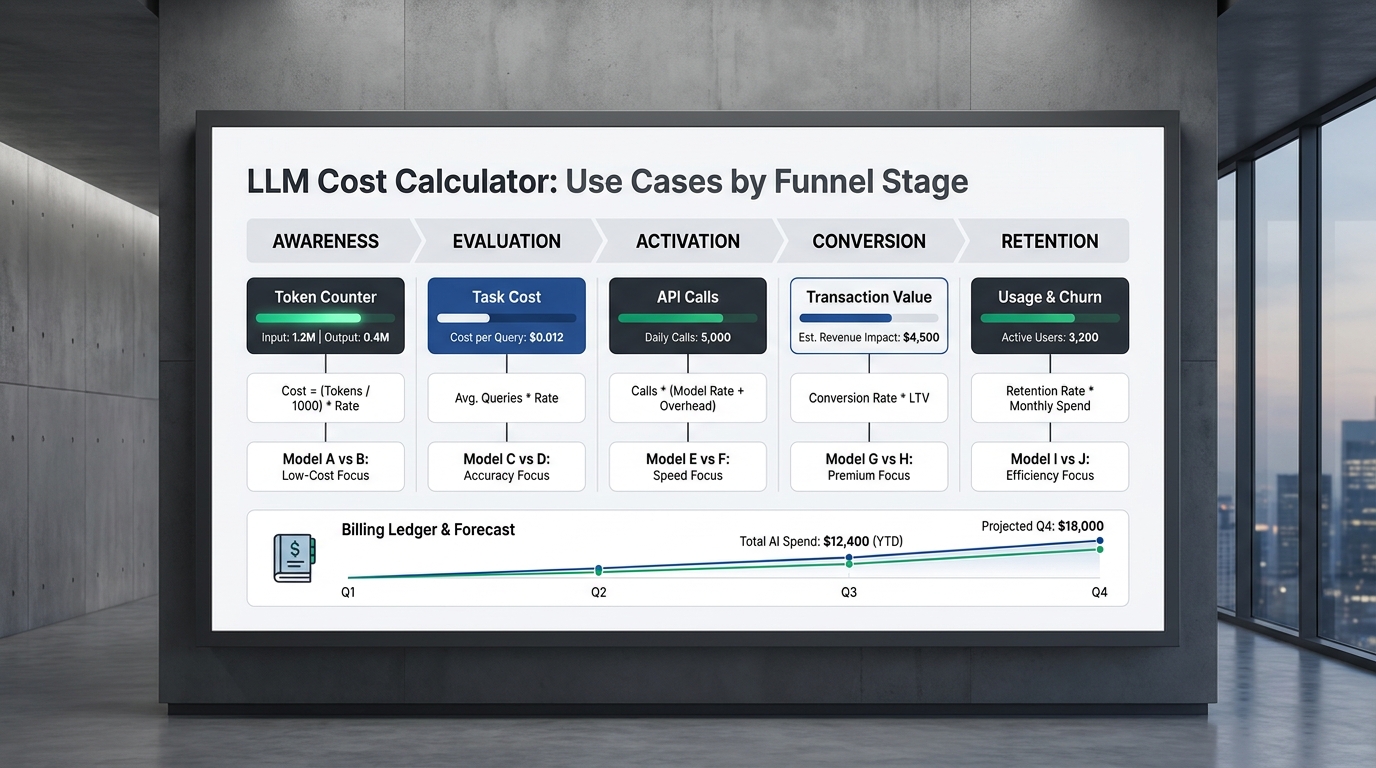
Cas d’usage d’un calculateur de coût LLM par étape du funnel
Découvrez quelle métrique du calculateur de coût LLM correspond à chaque étape du funnel, du chiffrage approximatif des opportunités au coût par tâche acceptée, en passant par les budgets d’activation, les contrôles de marge et les alertes de dérive de rétention.
Tarification des agents IA et statistiques sur les coûts des LLM à connaître en 2026
Un tour d’horizon sourcé de la tarification des agents IA et des statistiques sur les coûts des LLM pour 2026, avec les dépenses des entreprises, l’adoption, le ROI et l’économie des tokens.
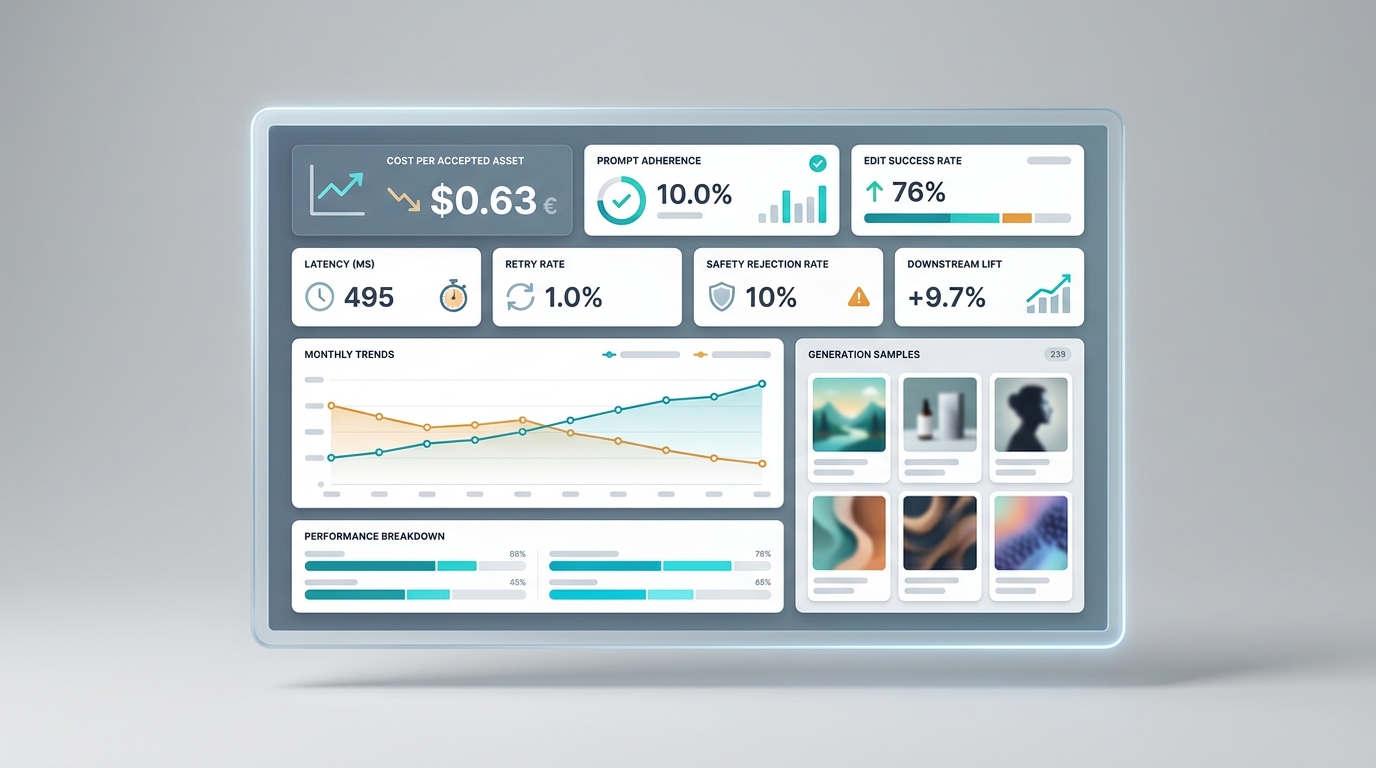
Les métriques d’API de génération d’images qui comptent vraiment
Utilisez des métriques pratiques pour une API de génération d’images, comme le coût par image acceptée, le respect du prompt, le taux de réussite des modifications, la latence, le taux de retry et l’impact business.
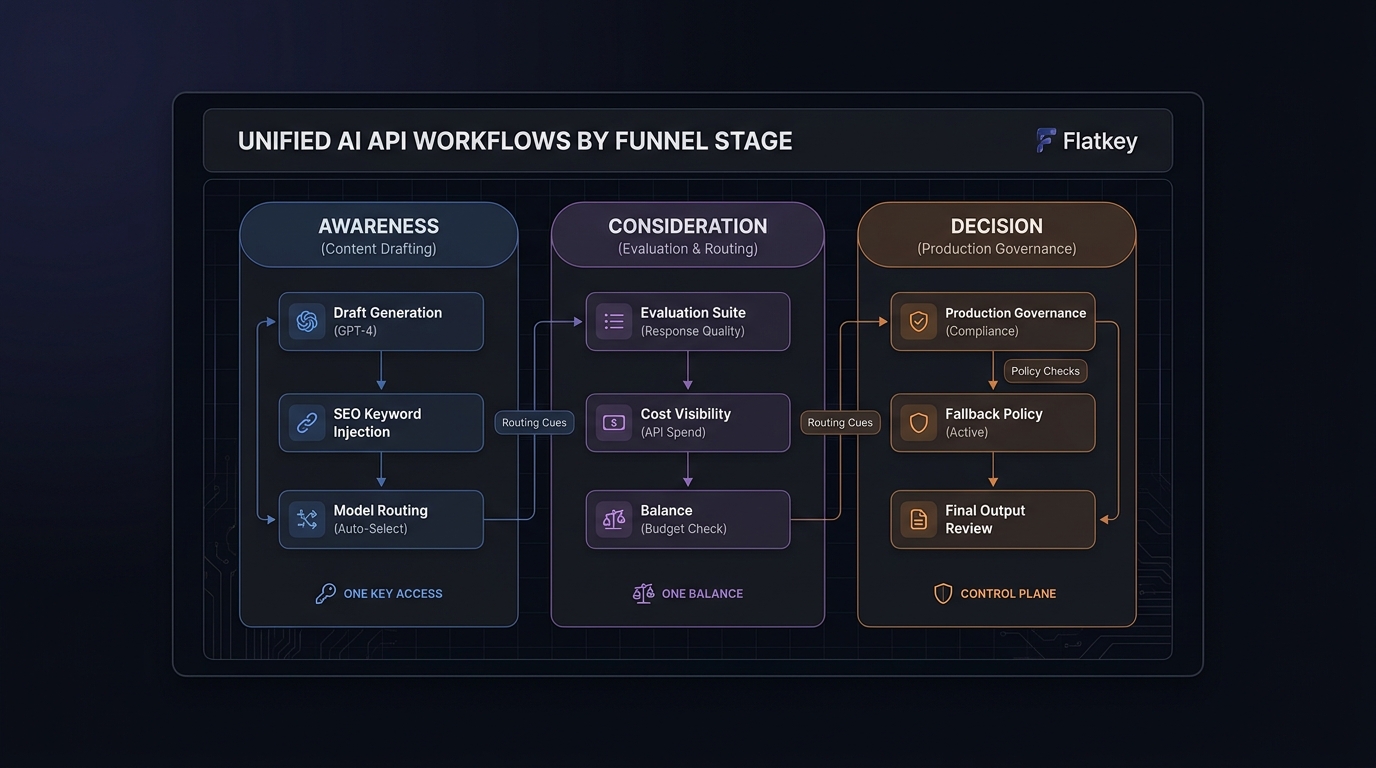
Cas d’usage de l’API IA unifiée par étape du funnel
Cartographiez les cas d’usage de l’API IA unifiée aux étapes de sensibilisation, de considération et de décision, et choisissez le bon workflow pour le contenu, l’évaluation et le déploiement.
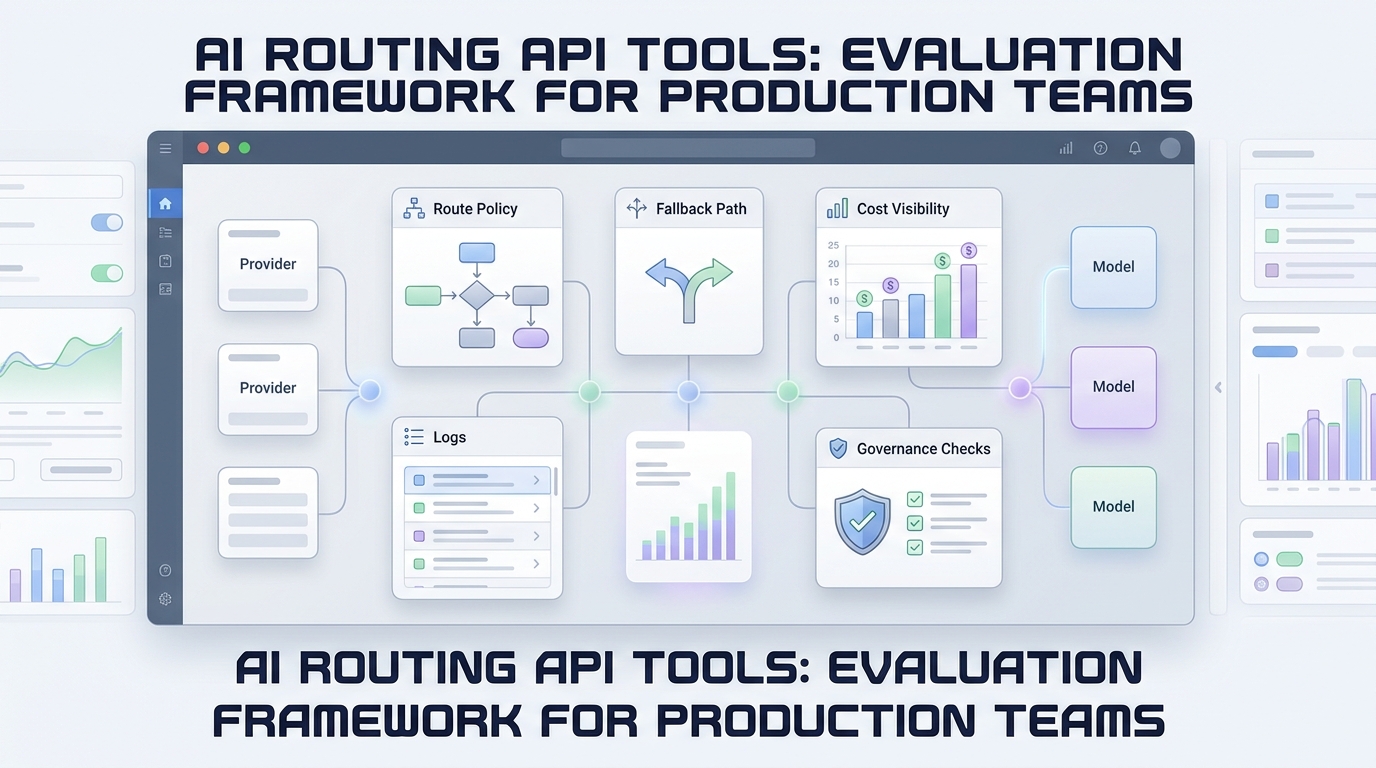
Outils d’API de routage IA : cadre d’évaluation pour les équipes de production
Un cadre d’évaluation pratique pour choisir des outils d’API de routage IA capables de gérer le trafic de production, le contrôle des dépenses et la gouvernance du routage.
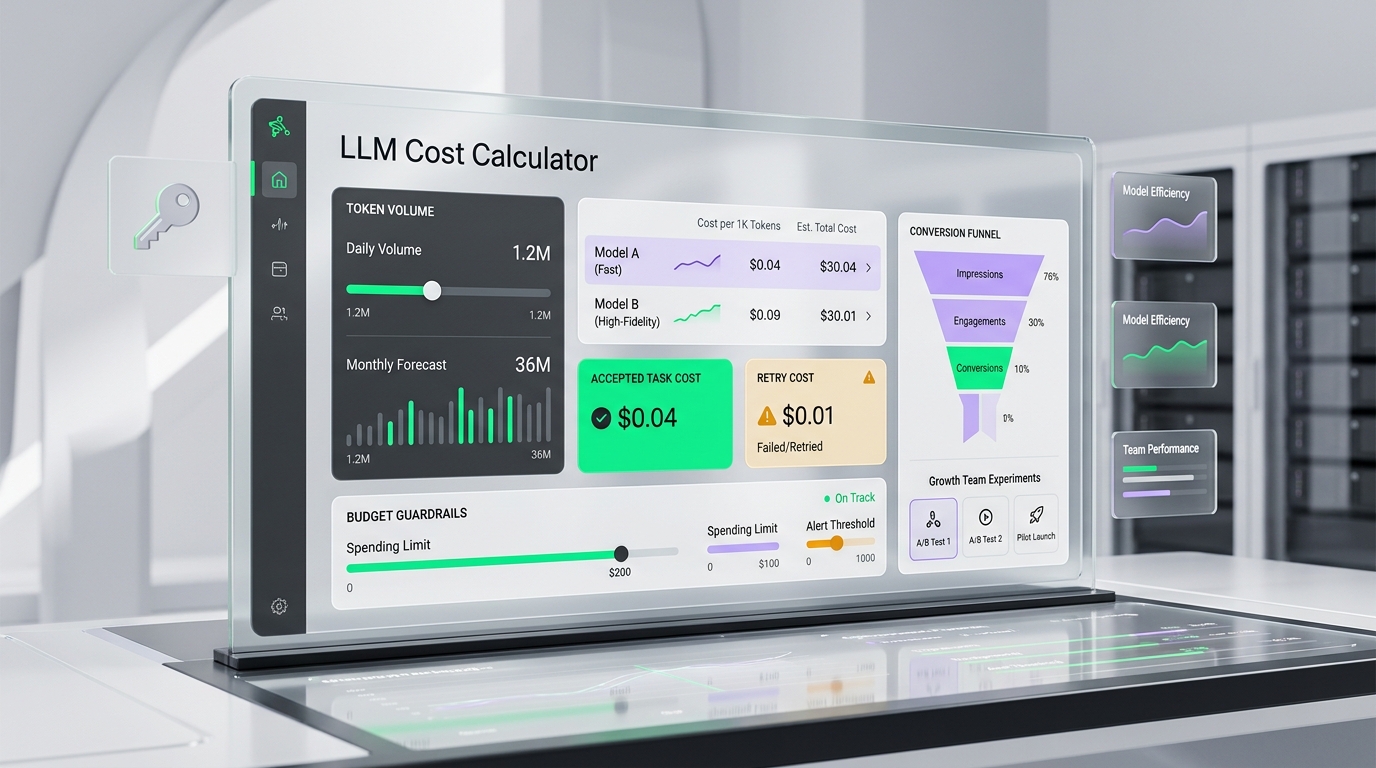
Calculateur de coût LLM pour les équipes growth : un workflow pratique
Découvrez comment créer un calculateur de coût LLM qui suit le coût par tâche acceptée, compare les modèles de manière équitable et maintient les expériences des équipes growth dans le budget.
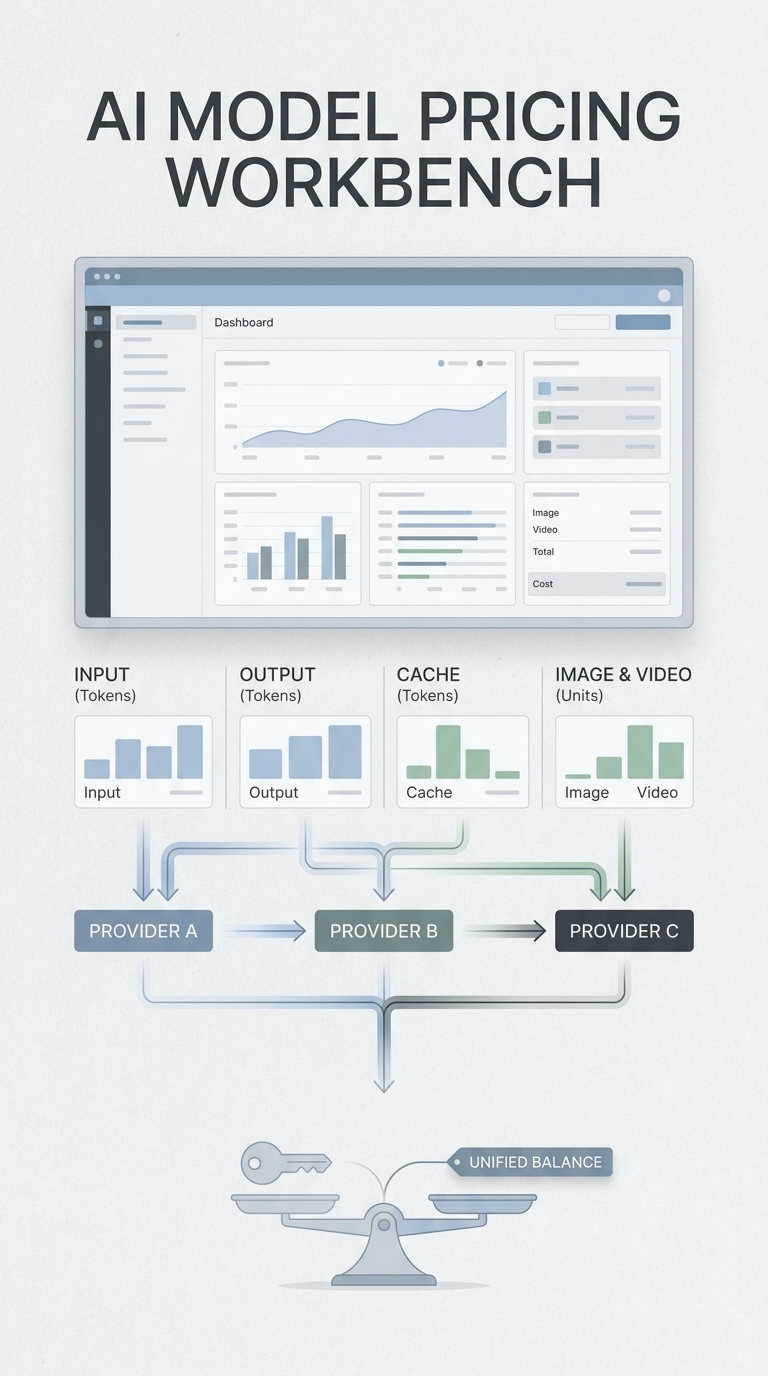
Qu’est-ce que la tarification des modèles d’IA et quand est-ce important ?
Découvrez comment fonctionne la tarification des modèles d’IA, ce qui influence réellement le coût, et quand une passerelle aide les équipes à comparer les charges de travail en tokens, images et vidéos.
Construisez plus vite avec une seule passerelle IA.
Utilisez flatkey.ai pour gérer modèles, clés, facturation et observabilité depuis une plateforme API.
Commencer