
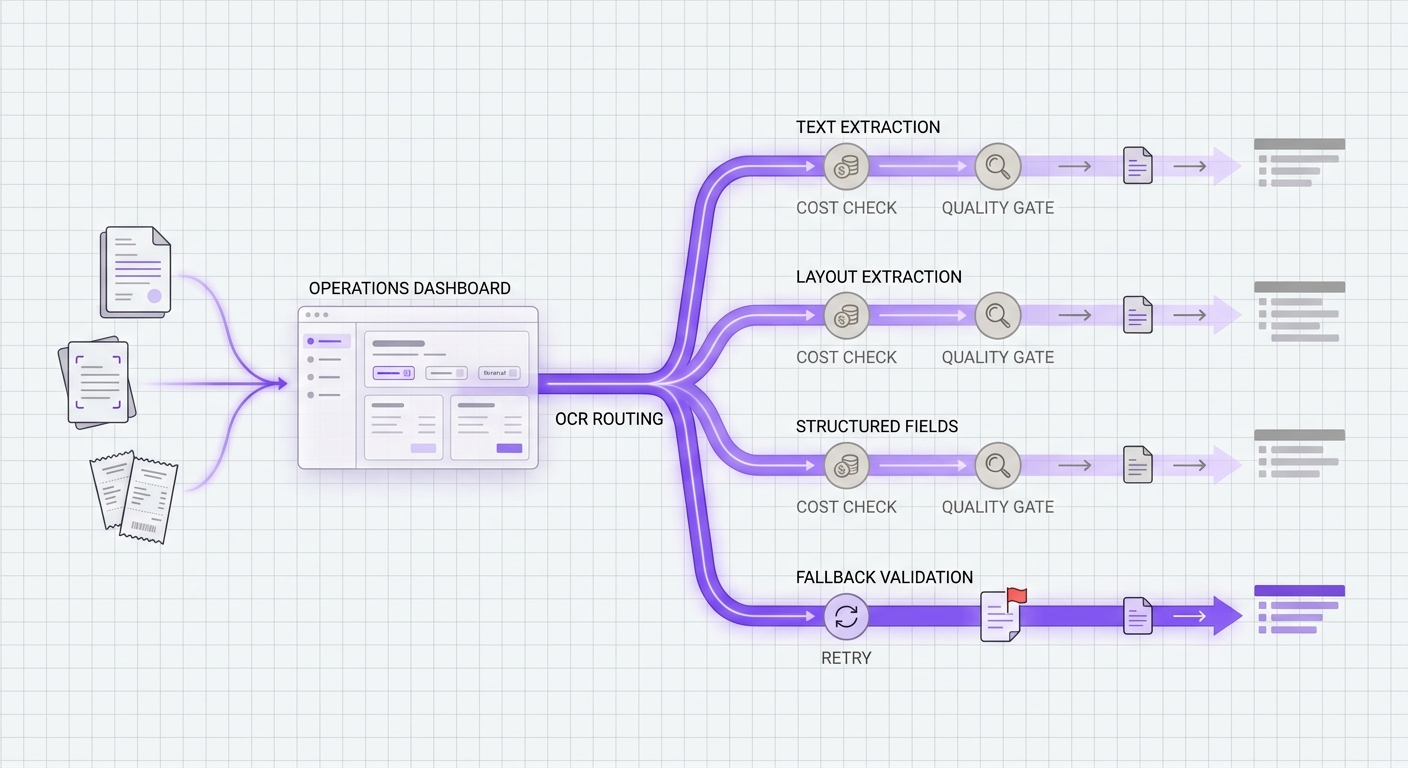
Si vous envisagez le routage des modèles OCR, la partie risquée n’est pas de trouver un modèle OCR capable de lire du texte à partir d’un scan. La partie risquée consiste à décider quel chemin doit gérer les images simples, quel chemin doit gérer les PDF multipages, quel chemin doit extraire des champs structurés, et quel repli est autorisé à traiter la même classe de documents lorsque le premier chemin échoue.
C’est pourquoi le routage des modèles OCR doit commencer par la politique de charge de travail, et non par un classement des fournisseurs. Un chemin OCR texte peu coûteux peut être le mauvais choix pour les factures. Un extracteur structuré de haute qualité peut être un gaspillage pour de gros volumes de texte archivés. Un repli peut sembler fiable jusqu’au moment où il supprime silencieusement des tableaux, dépasse les limites de pages ou double le coût d’une tempête de tentatives.
Ce guide propose aux équipes média, produit et ingénierie une manière pratique d’équilibrer le coût d’extraction de texte, la qualité et les vérifications de repli avant de standardiser le trafic documentaire. Il considère le routage de l’API OCR IA et le routage des modèles d’IA documentaire comme des décisions d’exploitation, et non comme des exercices ponctuels de benchmark.
La réponse rapide
La politique de routage des modèles OCR la plus sûre sépare les tâches documentaires en quatre classes :
| Classe de route | À utiliser pour | Décision principale | Règle de repli |
|---|---|---|---|
| OCR de texte brut | Captures d’écran, notes numérisées, texte simple dans des images, archives recherchables | Coût le plus bas approuvé par page acceptée | Repli uniquement vers une autre route qui préserve l’exhaustivité du texte et la couverture linguistique |
| OCR sensible à la mise en page | PDF, reçus, rapports, catalogues, exports de diapositives | Ordre de lecture, tableaux, paragraphes et qualité des fragments en aval | Repli uniquement lorsque la qualité de la mise en page reste acceptable |
| Extraction structurée | Factures, formulaires fiscaux, contrats, pièces d’identité, sinistres, demandes | Exactitude des champs et stabilité du schéma | Repli uniquement vers une route capable de renvoyer les mêmes champs requis |
| Documents restreints | Fichiers réglementés ou sensibles sur le plan contractuel | Traitement des données, conservation, région et validation du fournisseur | Repli uniquement au sein du même ensemble de fournisseurs approuvés |
C’est le cœur du routage des modèles OCR : choisir la route qui correspond au document et à la forme de sortie, puis n’autoriser le repli que lorsque la solution de secours peut satisfaire les mêmes exigences de coût, de qualité et de contrôle.
Pourquoi le coût d’extraction de texte est facile à mal interpréter
Le coût d’une API OCR est rarement un chiffre simple et unique. Les fournisseurs peuvent tarifer différemment l’OCR de base, l’analyse de la mise en page, les formulaires, les tableaux, les requêtes, l’extraction personnalisée ou le traitement par lot. Certaines pages sont facturées à la page. Certains flux de travail coûtent davantage lorsque la même page nécessite des champs structurés. Certaines limites font basculer le trafic d’un appel synchrone vers une tâche asynchrone.
Avant de comparer les routes OCR, normalisez chaque candidat à la même unité opérationnelle :
| Métrique | Pourquoi elle doit figurer dans la table de routage |
|---|---|
| Coût par page acceptée | Le prix brut par page ne suffit pas si un itinéraire génère davantage de sorties rejetées ou de nouvelles tentatives. |
| Coût par document structuré accepté | Les factures et les formulaires doivent être mesurés par le contenu de champs exploitable, pas seulement par le texte OCR. |
| Limites synchrones par page/fichier | Un itinéraire qui ne peut pas accepter la forme du fichier n’est pas un repli valide. |
| Limites des tâches asynchrones | Les gros PDF et les lots d’archives nécessitent un routage conscient de la file d’attente. |
| Palier de fonctionnalités | Les formulaires, tableaux, requêtes, signatures et la mise en page peuvent modifier le prix effectif. |
| Comportement des quotas et du throttling | Un itinéraire bon marché à faible volume peut échouer sous charge de lot. |
Les pages de tarification officielles montrent pourquoi la normalisation des unités est importante. La tarification d’Amazon Textract liste des API et fonctionnalités distinctes pour Detect Document Text, Analyze Document, Analyze Expense, Analyze ID et Analyze Lending. Ses exemples montrent Detect Document Text à 0,0015 $ par page pour le premier million de pages dans US West (Oregon), tandis qu’un exemple d’Analyze Document pour les formulaires et les tableaux combine 0,015 $ par page de tableau et 0,05 $ par page de formulaire. La tarification de Google Document AI liste Enterprise Document OCR, OCR add-ons, Layout Parser, Custom Extractor et Form Parser comme surfaces tarifées distinctes. Azure Document Intelligence indique que la facturation est calculée mensuellement en fonction du type de modèle et des pages analysées, et sa page sur les limites du service relie le comportement de routage à la taille du fichier, au nombre de pages et aux limites de transactions par seconde.
La leçon pour le routage des modèles OCR est simple : ne comparez pas les prix affichés des fournisseurs tant que la charge de travail, la forme de sortie, l’unité de facturation et la politique de reprise n’ont pas été normalisées.
Construisez la table de routage avant de benchmarker les modèles
Les équipes exécutent souvent quelques documents de test à travers plusieurs modèles OCR et choisissent celui qui « semble le meilleur ». Cela peut fonctionner pour une démonstration, mais ne produit pas une politique de routage durable.
Construisez d’abord la table de routage. Pour le routage de modèles d’IA documentaire, cette table est le contrat qui empêche l’OCR simple, l’extraction de mise en page et l’extraction structurée de se fondre dans un seul itinéraire par défaut. Si vous suivez déjà la qualité du routage dans une passerelle, associez cette table à un tableau de bord de métriques d’API de routage IA :
| Charge de travail | Exemple d’entrée | Résultat attendu | Comportement par défaut de l’itinéraire | Condition de rejet |
|---|---|---|---|---|
| OCR d’archive consultable | PDF numérisés, captures d’écran, rapports anciens | Texte brut avec ordre de lecture acceptable | Itinéraire approuvé au coût le plus bas | Pages manquantes, langue incorrecte, ordre cassé |
| Ingestion de reçus ou de factures | Reçus, factures, documents de paiement | Champs, totaux, dates, lignes d’articles | Itinéraire d’extraction structurée | Champ requis manquant ou faible confiance |
| Compréhension de catalogues ou de rapports | Catalogues de produits, rapports denses, présentations | Texte et tableaux sensibles à la mise en page | Itinéraire de mise en page avec vérifications des tableaux | Tableaux fusionnés, colonnes perdues, ordre des sections cassé |
| Examen d’identité ou de demande | Pièces d’identité, demandes, formulaires d’intégration | Champs spécifiques plus piste d’audit | Itinéraire restreint approuvé | Fournisseur non autorisé, rétention inconnue, champ non conforme |
| Migration par lots | PDF volumineux ou archives d’images | Couverture complète des pages | Itinéraire asynchrone avec marge de capacité par page | Travail trop volumineux, limitation du débit, achèvement partiel |
Une fois ce tableau en place, l’évaluation des modèles devient plus utile. Vous ne demandez plus « Quel modèle OCR est le meilleur ? » Vous demandez « Quel itinéraire est acceptable pour cette classe exacte de document, à ce coût et avec ce risque de repli ? » C’est la différence pratique entre une démo et un routage d’API OCR IA capable de résister au trafic de production.
Les garde-fous de qualité doivent correspondre au résultat, pas à la démo
La qualité OCR nécessite des garde-fous différents selon les charges de travail.
Pour l’OCR en texte brut, mesurez :
- La couverture des pages.
- L’exhaustivité des caractères et des mots.
- L’ordre de lecture.
- La tolérance à la langue et à l’écriture manuscrite.
- La part des pages nécessitant une revue humaine.
Pour l’OCR sensible à la mise en page, mesurez :
- Le regroupement des paragraphes.
- La hiérarchie des titres.
- Les limites des tableaux.
- L’ordre des colonnes.
- Si la qualité de la recherche en aval, de la récupération ou de l’interface de revue s’améliore.
Pour l’extraction structurée, mesurez :
- La précision des champs obligatoires.
- Le rappel des champs obligatoires.
- La stabilité de normalisation des dates, montants, noms et identifiants.
- Le calibrage de la confiance.
- La compatibilité du schéma entre les itinéraires principaux et de repli.
C’est là que de nombreux projets de routage de modèles OCR échouent. Un repli qui renvoie du texte brut n’est pas équivalent à un extracteur de factures structurées. Un itinéraire qui conserve la plupart des mots mais perd les limites des tableaux peut encore casser les workflows de récupération ou de revue. Un modèle à haute précision qui ne peut pas traiter le même nombre de pages n’est pas un repli sûr pour des PDF par lots.
Les vérifications de repli sont une exigence produit
Le repli ne doit pas signifier « essayer un autre fournisseur OCR ». Il doit signifier « essayer un autre itinéraire approuvé capable de satisfaire le même contrat de charge de travail ».
Utilisez cette liste de contrôle avant qu’un itinéraire puisse devenir un repli :
| Vérification de repli | Condition de validation |
|---|---|
| Même classe de document | Le repli accepte le même type de fichier, le même nombre de pages et la même taille. |
| Même contrat de sortie | Le repli renvoie le même texte requis, la même mise en page ou les mêmes champs. |
| Mêmes contrôles de données | Le repli respecte les mêmes règles de conservation, de région et de contrat client. |
| Même observabilité | Le repli journalise l’itinéraire, le coût, la latence, les erreurs, la confiance et le motif de rejet. |
| Coût de nouvelle tentative borné | Les budgets de nouvelle tentative et de repli sont plafonnés par tâche, locataire et lot. |
| Parcours de révision manuelle | Les échecs non équivalents vont en révision au lieu d’une dégradation silencieuse. |
Amazon Textract est un exemple utile de la raison pour laquelle l’éligibilité au repli doit inclure les limites du document : ses limites de document indiquent que les opérations synchrones PDF et TIFF sont limitées à une page, tandis que les opérations asynchrones PDF et TIFF autorisent jusqu’à 3 000 pages. Les limites du service Azure Document Intelligence documentent une limite par défaut de 15 TPS sur les transactions d’analyse du niveau Standard, une taille maximale de document de 500 Mo et une limite d’analyse de 2 000 pages. Les quotas Google Document AI documentent les quotas de processeur, les limites de requêtes en ligne et les quotas de pages par minute pour les versions de processeur génératives.
Ces contraintes ne sont pas des cas limites. Elles déterminent si un repli est valide.
Un arbre de décision pratique pour le routage des modèles OCR
Utilisez cet arbre de décision lorsqu’une nouvelle tâche de document entre dans le pipeline :
- Classez le document avant d’appeler une route OCR.
- Déterminez si la sortie doit être du texte brut, une mise en page ou des champs structurés.
- Excluez les routes qui échouent aux exigences de conservation, de région, de contrat, de type de fichier, de nombre de pages ou de quota.
- Estimez le coût par sortie acceptée, pas seulement le coût par page brute.
- Exécutez la route principale.
- Appliquez des seuils de qualité spécifiques à la charge de travail.
- Ne réessayez que pour les erreurs transitoires ou les échecs idempotents sûrs.
- N’utilisez un repli qu’au sein de la même classe de route.
- Envoyez les échecs non équivalents vers une révision ou une file de lot.
- Journalisez la décision de routage, le coût, la confiance, le motif du repli et l’état final accepté/rejeté.
Voici la politique de routage sous une forme compacte :
document_job:
  classify:
    inputs: [file_type, page_count, document_type, customer_tier, data_region]
  exclude:
    - route_not_approved_for_data_policy
    - route_page_limit_below_job_size
    - route_missing_required_output_contract
  choose_primary:
    optimize_for: cost_per_accepted_output
    guardrails: [quality_gate, latency_budget, quota_headroom]
  fallback:
    allowed_only_when:
      - transient_error
      - same_route_class
      - same_output_contract
      - retry_budget_remaining
    otherwise: manual_review
  observe:
    log: [route, model, cost, latency, confidence, error_class, fallback_reason]
La politique compte plus que la liste des modèles. De nouveaux modèles OCR peuvent être ajoutés plus tard sans réécrire le flux de travail documentaire.
Où Flatkey s’insère dans le routage des modèles OCR
Flatkey est utile dans le routage des modèles OCR lorsque l’équipe souhaite une couche opérationnelle unique pour l’accès aux modèles, la visibilité des dépenses et la revue des routes, au lieu de disperser des clés de fournisseurs entre agents, jobs et services. Si votre équipe connecte encore des comptes fournisseurs directement, commencez par le flux de travail d’API IA unifiée, puis alignez les règles de repli spécifiques à l’OCR sur le playbook de stratégie de repli des modèles.
Le site public actuel de Flatkey positionne le produit autour d’une clé, d’un équilibre unique, de l’utilisation des modèles et des outils, de la facturation des appels réussis, d’un registre partagé et d’un répertoire de modèles public avec la disponibilité en temps réel, les tarifs, la prise en charge des endpoints et des pages de détail des modèles. Pour les workflows OCR, cela fait du gateway une couche de contrôle particulièrement pertinente : valider les routes multimodales ou capables de traiter des documents disponibles, définir quels workloads peuvent les utiliser, et examiner au même endroit les coûts et les échecs au niveau des routes.
Ne considérez pas un catalogue de gateway comme un substitut à votre propre test de qualité OCR. Voyez-le comme l’endroit où les routes approuvées, les données d’utilisation, la politique de repli et les contrôles de coûts deviennent plus faciles à gérer. Quand vous êtes prêt à comparer l’économie des routes, utilisez la tarification Flatkey actuelle plutôt que d’anciens noms de modèles tirés de notes d’implémentation obsolètes.
Liste de contrôle de lancement
Avant de mettre le routage des modèles OCR en production, vérifiez les éléments suivants :
- Chaque classe de document a une route par défaut et une classe de repli autorisée.
- Chaque route a un coût normalisé par page acceptée ou par document structuré accepté.
- Chaque workflow structuré dispose de gardes de qualité au niveau des champs.
- Les limites de pages en mode synchrone et asynchrone sont testées avec de vrais fichiers, et non supposées à partir d’exemples.
- Le comportement des quotas et du throttling est représenté dans les tests de charge.
- Les documents restreints ne peuvent utiliser que des routes approuvées.
- Les jobs échoués enregistrent pourquoi le repli a eu lieu et si la sortie a été acceptée.
- La finance peut tracer les dépenses par route, workload, tenant et raison de repli.
- Le produit dispose d’un chemin de revue manuelle pour les échecs non équivalents.
Le routage des modèles OCR fonctionne quand son exploitation est sans surprise : le travail peu coûteux reste peu coûteux, le travail structuré reçoit le bon modèle, et le repli ne modifie jamais le contrat du document sans que cela soit remarqué.
FAQ
Qu’est-ce que le routage des modèles OCR ?
Le routage des modèles OCR est la couche de politique qui envoie chaque job de document vers une route OCR ou document AI en fonction du type de document, de la sortie requise, du coût, des exigences de qualité et des contraintes de repli.
Comment les équipes doivent-elles comparer le coût des API OCR ?
Comparez le coût de l’API OCR en fonction de la sortie acceptée. Pour l’OCR simple, il s’agit généralement du coût par page acceptée. Pour les factures, formulaires, contrats et pièces d’identité, il s’agit généralement du coût par document structuré accepté après les tentatives de reprise et les rejets de revue.
Quand le repli devient-il risqué pour l’OCR ?
Le repli devient risqué lorsque la route de secours ne peut pas accepter la même forme de fichier, le même nombre de pages, la même politique de données ou le même contrat de sortie. Une route OCR de texte brut n’est pas un repli sûr pour un workflow qui exige des champs de facture structurés.
Un seul modèle OCR doit-il traiter tous les types de documents ?
En général non. L’OCR simple, l’extraction de mise en page, l’extraction structurée, les PDF en grands lots et les documents restreints ont des exigences différentes en matière de coût, de qualité et de contrôle.
Comment Flatkey aide-t-il au routage des modèles OCR ?
Flatkey peut aider les équipes à gérer le routage des modèles OCR grâce à une clé, un équilibre, des vérifications de disponibilité des modèles, une visibilité sur l’utilisation et une revue au niveau des routes. Les équipes doivent tout de même exécuter leurs propres tests de qualité des documents avant que le trafic de production ne soit déplacé.


