
Blog flatkey.ai
Analyses, notes produit et guides d'implémentation pour les équipes qui construisent avec des API d'IA.
Architecture des passerelles IA
Derniers articles dans Architecture des passerelles IA.
Lire la suiteMigration des URL de base et des SDK
Derniers articles dans Migration des URL de base et des SDK.
Lire la suiteCoûts, facturation et exploitation
Derniers articles dans Coûts, facturation et exploitation.
Lire la suiteContrôles d’entreprise et confiance
Derniers articles dans Contrôles d’entreprise et confiance.
Lire la suiteComparatifs de passerelles
Derniers articles dans Comparatifs de passerelles.
Lire la suiteGuides des modèles et des modalités
Derniers articles dans Guides des modèles et des modalités.
Lire la suiteFiabilité et routage
Derniers articles dans Fiabilité et routage.
Lire la suiteIntégrations d’outils
Derniers articles dans Intégrations d’outils.
Lire la suite
Notes de console internes
Notes internes
API proxy CLI : accès, tarification, intégration et guide de production
Découvrez le fonctionnement d’une API proxy CLI, l’accès et les coûts de CLIProxyAPI, comment la tester en toute sécurité et quand une passerelle gérée convient à la production.

API de génération vidéo par IA : accès, tarification, intégration et guide de production
Guide pratique pour choisir, tarifer, intégrer et exploiter une API de génération vidéo par IA avec des tâches asynchrones et des contrôles de coûts mesurables.

Inférence IA : architecture, performances et guide de déploiement cloud
Inférence IA : comment un modèle entraîné transforme de nouvelles entrées en réponses prêtes pour la production, avec les métriques clés et les étapes de déploiement sur GPU cloud.

Audit de sécurité IA : plan de test pratique, liste des preuves à recueillir et modèle de rapport pour les applications LLM
Un audit de sécurité IA vérifie le comportement réel de votre application LLM, au-delà des déclarations d’un fournisseur. Ce guide propose un modèle de périmètre, 12 tests associés aux risques OWASP avec entrées, contrôles attendus, preuves et corrections, un banc de test sûr, des critères de gravité et un modèle de rapport.
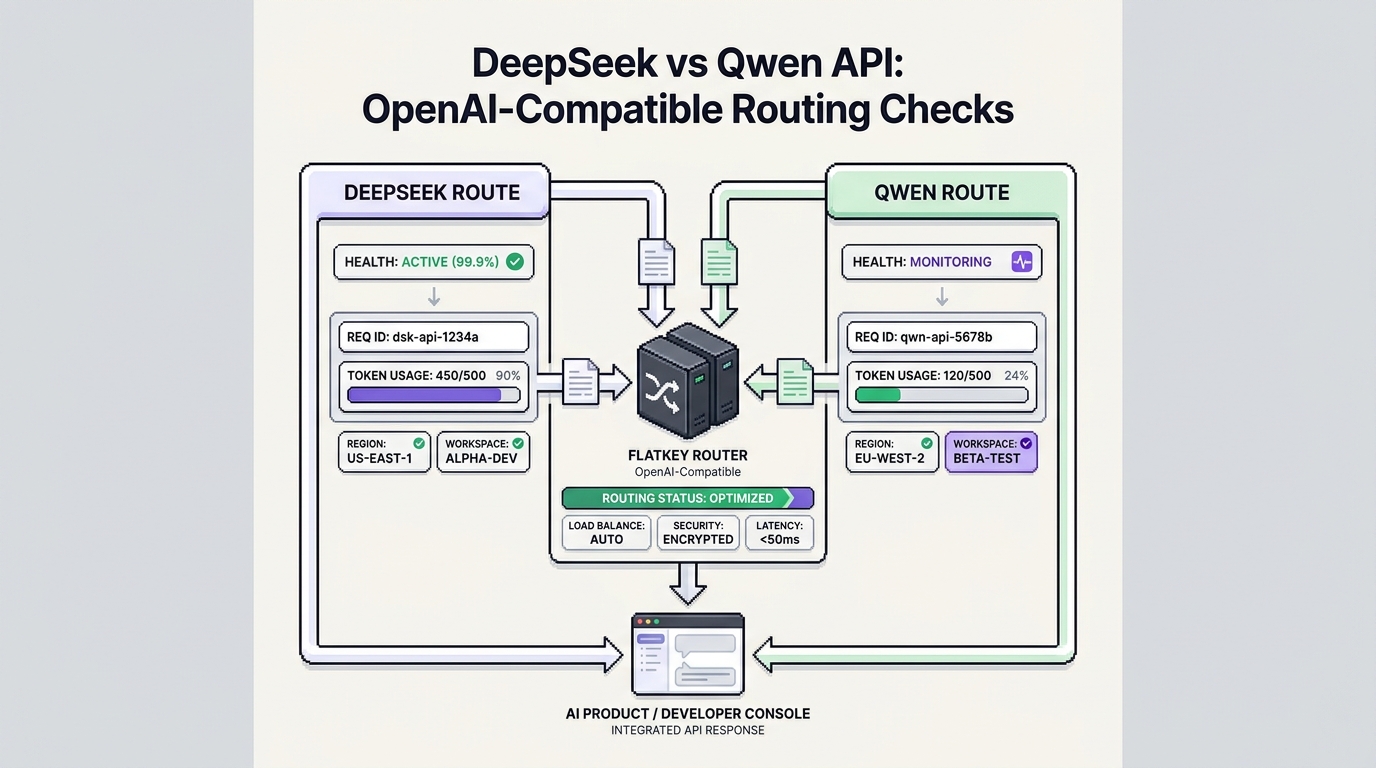
Grok vs Gemini (octobre 2026) : quelle IA choisir ?
Choisissez Gemini pour le meilleur rapport qualité-prix, l'intégration Google, les outils vidéo et une API à 1M de tokens de contexte ; choisissez Grok si vous vivez sur X, voulez des posts X en temps réel ou payeriez de toute façon X Premium. Comparatif des offres, des tâches et des API, prix au 25 octobre 2026.

Peut-on exécuter Kimi K3 en local ? Guide matériel, GGUF et vLLM (2026)
Kimi K3 peut tourner en local, mais le plus petit GGUF 1 bit demande environ 610 Go de RAM plus VRAM. Exigences matérielles précises, commandes llama.cpp et vLLM, conditions de licence et comparaison des coûts avec les GPU louées et les API.

Premiers pas avec l’API Flatkey cette semaine
Notes d’intégration de Northline Analytics
Erreurs courantes de LiteLLM : délais d’attente, alertes de budget et échecs de fournisseurs
Guide pratique de dépannage LiteLLM pour les délais d’attente, les contrôles et alertes de budget, la configuration des modèles, les échecs de fournisseurs, les nouvelles tentatives et les solutions de repli.
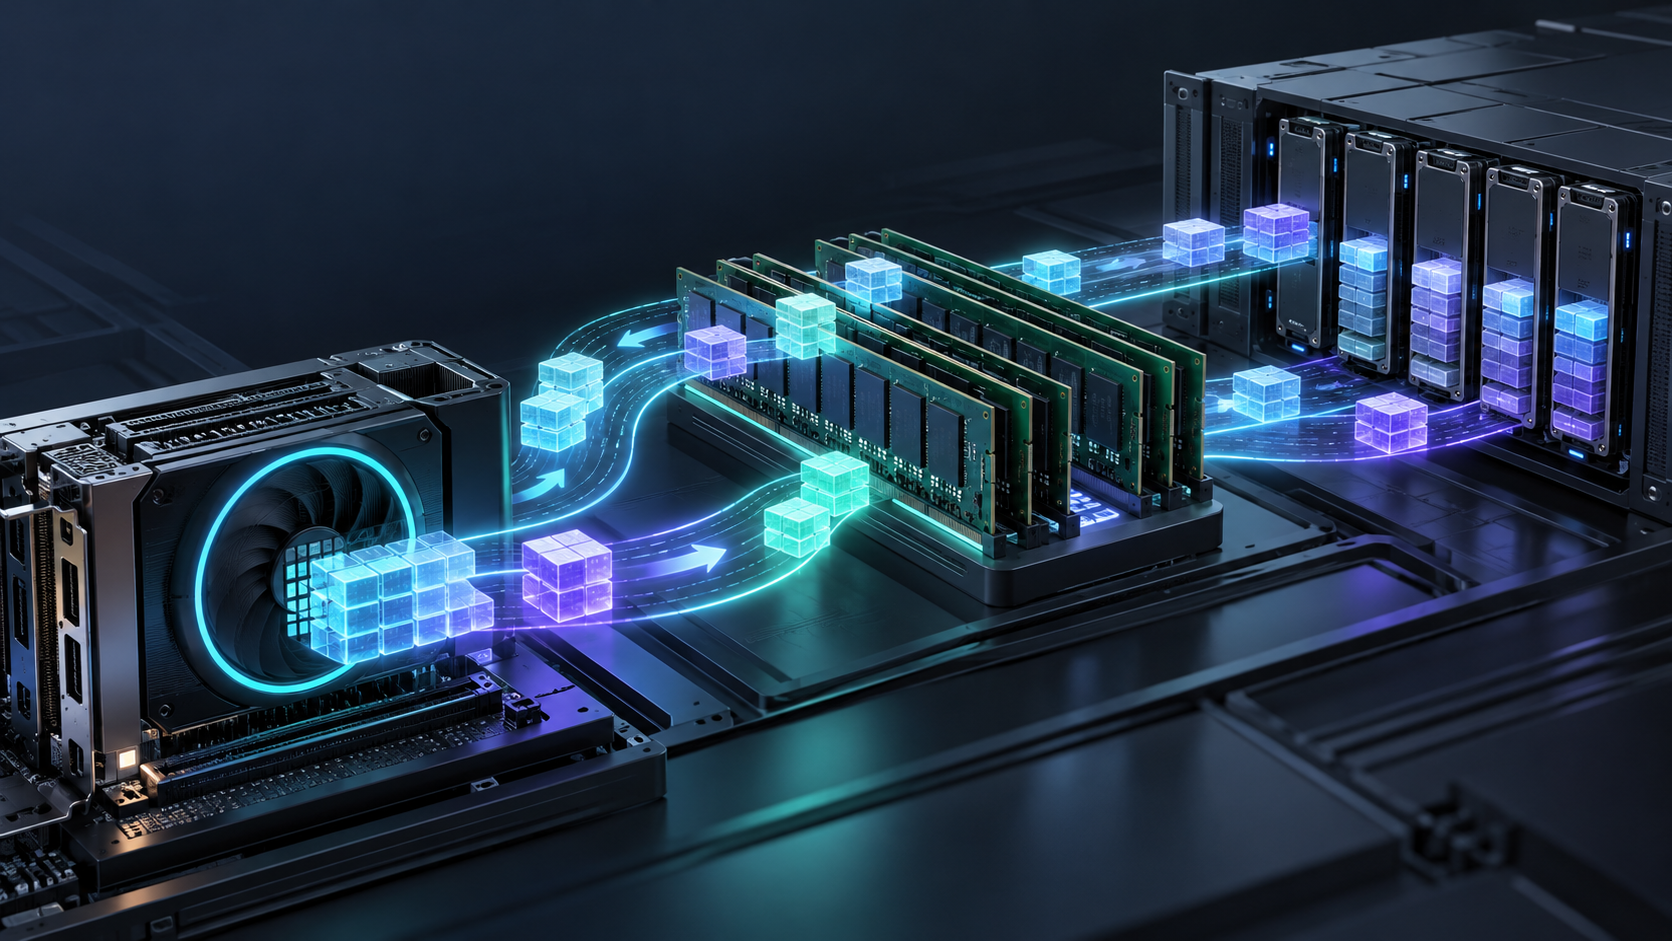
Déportation et hiérarchisation du cache KV pour l’inférence de LLM à long contexte
Guide de déportation et de hiérarchisation du cache KV pour l’inférence de LLM à long contexte avec vLLM et TensorRT-LLM.
Créer un cluster GPU Kubernetes pour l’entraînement et l’inférence IA
Guide pratique pour créer un cluster GPU Kubernetes dédié à l’entraînement et à l’inférence IA : pools de nœuds GPU, plugins de périphériques, GPU Operator, mise en file d’attente, stockage, observabilité, sécurité, contrôle des coûts et évaluation des fournisseurs.
Kimi K3 vs GPT 5.6 Sol : tarifs, contexte et API à tester
Une comparaison vérifiée à la source de Kimi K3, GPT-5.6 Sol et GPT-5.6 Terra pour les développeurs choisissant une API de production.
Prix du GPU H200 : tarification, facteurs de coût et guide d’achat
Comparez les coûts des cartes H200 NVL, des serveurs et de la location cloud, ainsi que les éléments du TCO à considérer avant d’acheter ou de réserver de la capacité.

GPU H200 : architecture, performances et guide de déploiement cloud
Guide pratique du H200 pour choisir un format, dimensionner la mémoire et le réseau, déployer dans le cloud et valider la latence, le débit, l’état de santé et le coût par tâche achevée.
Prix du GPU H100 : tarifs, facteurs de coût et guide d’achat
Guide des prix du GPU H100 pour comparer une offre PCIe à 32 200 $, des instantanés de location cloud, les formats et le TCO d’un devis sur site.

Serveur GPU : guide de l’architecture, des performances et du déploiement cloud
Choisissez et déployez un serveur GPU cloud grâce à un cadre axé sur les charges de travail, les tests de performances et la préparation à la production.
Genspark AI Agent Builder API Custom : accès, tarifs, intégration et guide de production
Guide pratique sur l’accès à Genspark Custom Agent, les tarifs, les connecteurs et l’architecture de production adaptée lorsqu’une API documentée est nécessaire pour votre application.
API LLM gratuite : limites, coûts et compromis de production
Guide pratique des offres gratuites d’API LLM : crédits, limites de débit, coûts d’exploitation cachés et contrôles à ajouter avant que les utilisateurs ne dépendent d’une route.
Construisez plus vite avec une seule passerelle IA.
Utilisez flatkey.ai pour gérer modèles, clés, facturation et observabilité depuis une plateforme API.
Commencer