Prix du GPU H100 : tarifs, facteurs de coût et guide d’achat
Dernière vérification : 22 octobre 2026.
Le prix d’un GPU H100 ne se résume pas à un seul chiffre. Une annonce pour une carte, une instance cloud à huit GPU et un serveur prêt pour la production répondent à trois questions d’achat différentes. Si un devis n’indique pas le format, le nombre de GPU, le modèle de facturation, l’emplacement et l’infrastructure incluse, il n’est pas encore comparable.
Comme point de référence daté, une annonce de marketplace pour une carte H100 PCIe de 80 Go commençait à 32 200 $ lors de la vérification. Les exemples de cloud public allaient d’un tarif affiché de 2,89 $ par heure pour un pod H100 PCIe à 3,99 $ par heure pour un pod H100 SXM, tandis qu’AWS affichait un Capacity Block P5 à un H100 à 5,97 $ par heure-accélérateur. Il s’agit d’exemples, et non d’un prix de vente conseillé ou d’un tarif universel : la disponibilité, la région, l’engagement, le bundle CPU/RAM, le stockage, le support et la configuration H100 exacte modifient tous la facture.
Ce guide montre comment transformer un devis H100 en décision plutôt qu’en prix d’appel trompeur.
Prix du GPU H100 : la réponse rapide
Utilisez l’unité correspondant à ce que vous achetez réellement :
| Ce dont vous évaluez le prix | Référence publique datée | Ce que le chiffre signifie et ne signifie pas |
|---|---|---|
| Une carte H100 PCIe de 80 Go | À partir de 32 200 $ | Un prix de départ sur une marketplace pour une carte, et non un prix de vente conseillé NVIDIA ni un serveur complet. |
| Un pod cloud H100 PCIe | 2,89 $/heure | Un exemple de tarif public pour un pod ; vérifiez le niveau de service cloud, la région, le stockage et le bundle CPU/RAM au moment du paiement. |
| Un pod cloud H100 SXM | 3,99 $/heure | Un exemple de tarif public pour un pod dans un format différent et avec une configuration hôte groupée différente. |
| AWS P5.4xlarge Capacity Block | 5,97 $/heure-accélérateur | Un produit à capacité planifiée avec un H100 ; il ne s’agit pas d’une location de carte unique comparable à l’identique. |
| Google Cloud A3 High | 88,49 $/heure d’instance pour 8 H100 | Environ 11,06 $ par heure-GPU après division par huit, mais le SKU inclut une grande machine à huit GPU plutôt que huit cartes indépendantes. |
L’annonce de matériel provient de la page marketplace H100 PCIe 80 Go de GPU Vendors. Les tarifs des pods proviennent de la page de tarification publique de Runpod, mise à jour le 8 octobre 2026. Le chiffre AWS provient du tableau de prix EC2 Capacity Blocks for ML ; l’exemple Google provient du tableau de tarification des VM optimisées pour les accélérateurs. Revérifiez chaque source avant approbation ou achat.
À retenir : utilisez le prix du GPU H100 pour présélectionner les options, mais utilisez un budget de charge de travail pour décider.
Identifiez d’abord le H100 faisant l’objet du devis
L’appellation « H100 » masque des choix qui affectent sensiblement à la fois les capacités et le coût.
| Configuration | Éléments à vérifier avant de comparer les prix | Pourquoi cela modifie la décision |
|---|---|---|
| H100 PCIe | 80 Go de mémoire, CPU/RAM hôte, flux d’air du châssis, nombre de GPU, réseau | Cette option peut convenir pour un seul GPU ou un déploiement à plus petite échelle, mais l’hôte et le réseau doivent tout de même être inclus dans le total. |
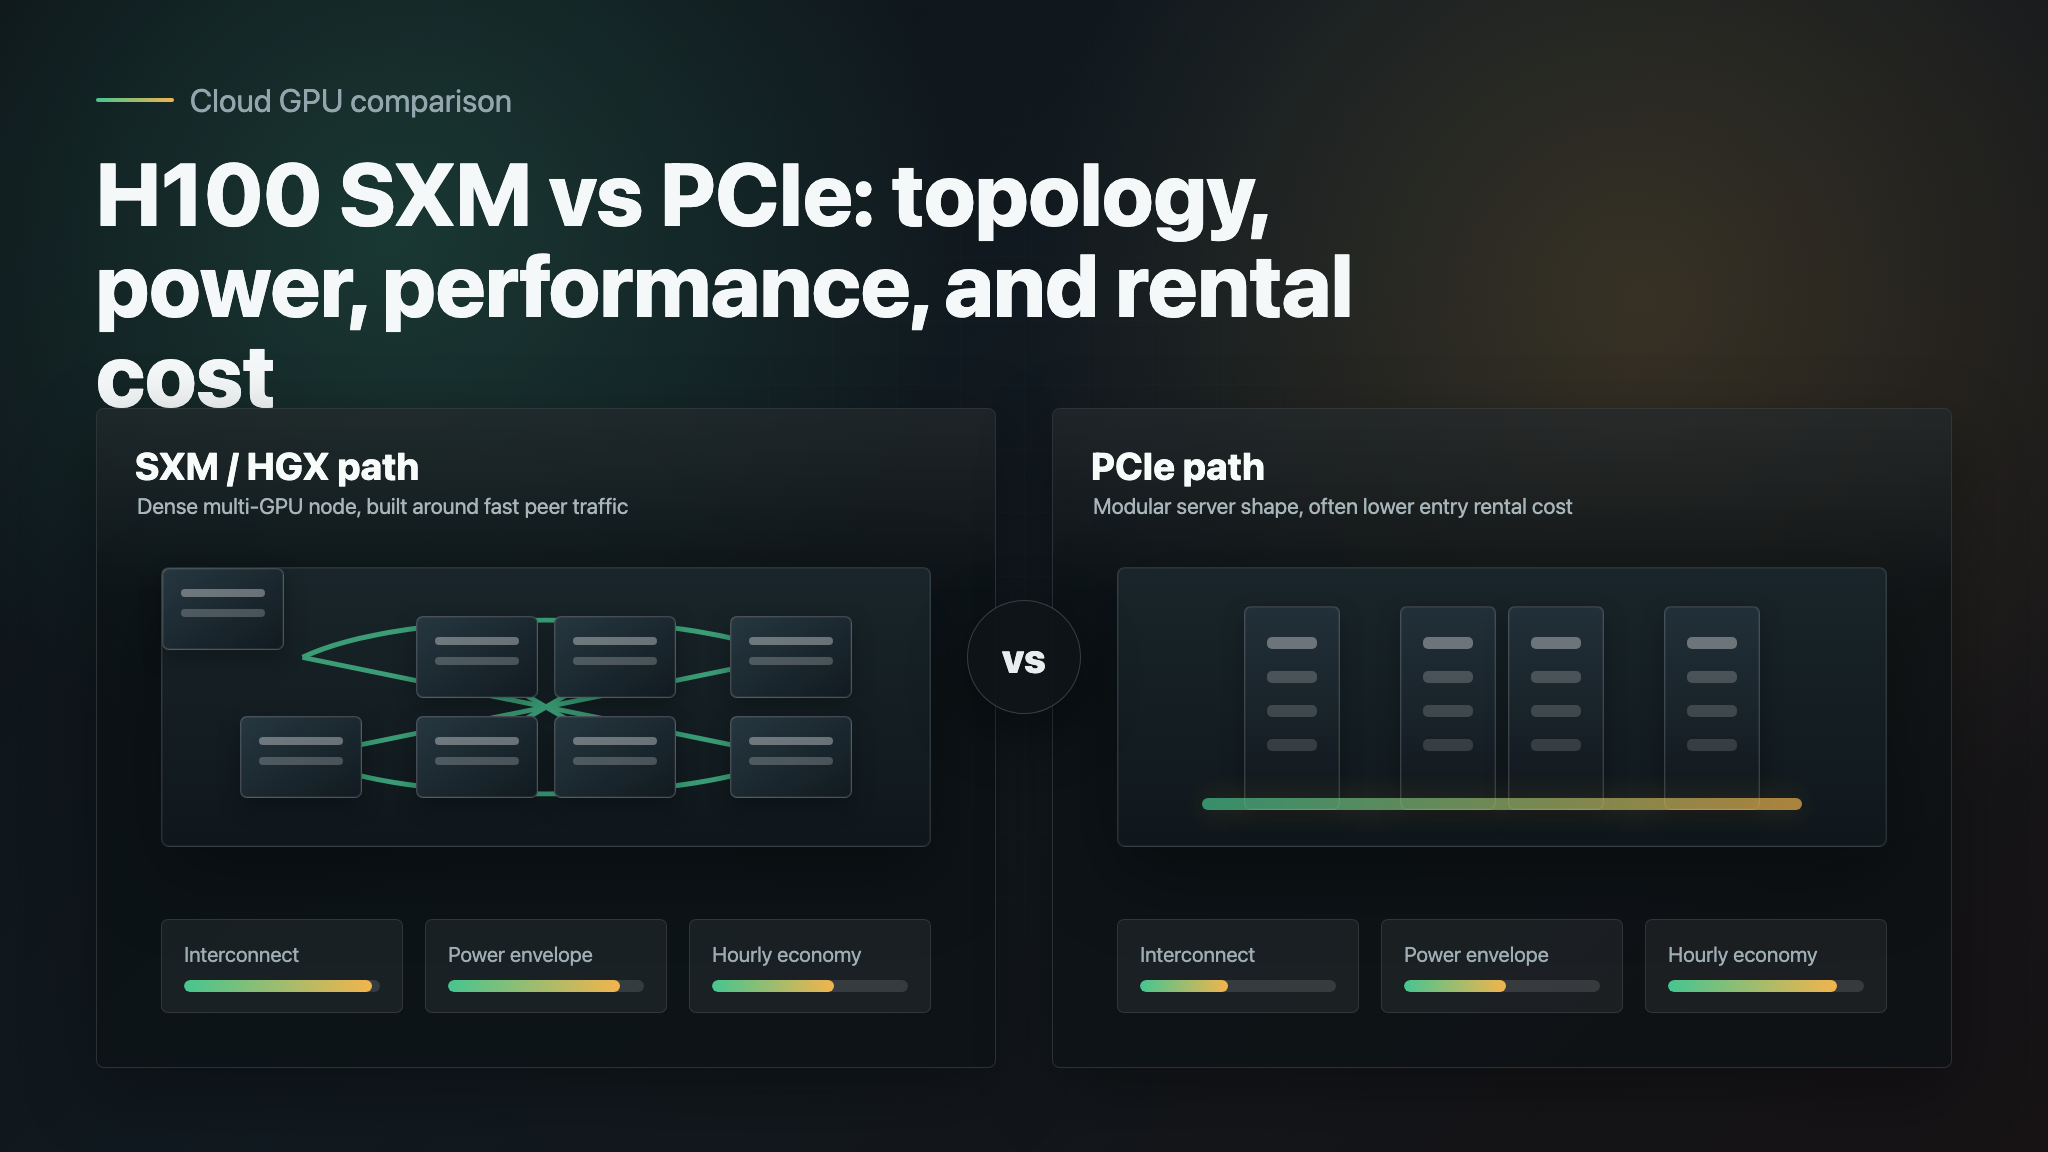
| H100 SXM | 80 Go de mémoire, plateforme de type HGX/DGX, topologie de fabric, alimentation et refroidissement | Le SXM est plus étroitement lié à une plateforme serveur haute densité et à une fabric multi-GPU ; ne comparez pas son prix équivalent à une carte au PCIe seul. |
| H100 NVL | SKU exact de carte/paire/serveur, mémoire utilisable, interconnexion, hôte inclus | Les libellés des marketplaces varient. Confirmez ce qui constitue un « GPU » facturable et si l’annonce concerne une carte, une paire ou une configuration serveur. |
| Nœud à 4 ou 8 GPU | Nombre de GPU, topologie NVLink/NVSwitch, NIC, stockage local, conditions de réservation | Le nœud est souvent l’unité d’approvisionnement réelle pour l’entraînement distribué, et non un accélérateur individuel. |
La fiche technique H100 de NVIDIA indique 80 Go pour les versions SXM et PCIe, avec une bande passante mémoire, une enveloppe de puissance, une interconnexion et des options de serveur différentes. Elle spécifie 3 To/s et jusqu’à 700 W pour la version SXM, contre 2 To/s et 350 W pour la version PCIe ; c’est pourquoi le prix du GPU H100 doit toujours inclure le format et la plateforme dans la même ligne de devis. Consultez la fiche technique NVIDIA H100 en même temps que le devis au lieu de considérer « H100 80 Go » comme une spécification complète.
Pour une présentation plus approfondie de l’architecture et du déploiement, consultez notre guide du GPU NVIDIA H100. Si le choix se fait réellement entre générations, comparez la charge de travail et le coût par sortie acceptée dans H100 vs. A100 ou dans le guide des prix du GPU H200 avant de considérer qu’un tarif horaire inférieur est avantageux.
Pourquoi le même prix de GPU H100 peut entraîner des factures mensuelles très différentes
Un tarif horaire ne couvre que la ligne relative à l’accélérateur. Un plan mensuel exploitable doit inclure l’ensemble du chemin de livraison :
Coût de la charge de travail cloud
= tarif de l’accélérateur ou de l’instance × heures planifiées
+ stockage attaché
+ transfert de données / sortie de données
+ processeur, RAM et réseau non inclus dans le tarif
+ frais de support, de plateforme et de logiciels
+ marge pour temps d’inactivité, nouvelles tentatives et échecs de tâches
Google Cloud sépare explicitement les considérations relatives aux GPU, aux types de machines, au stockage et au réseau dans sa documentation sur la tarification des GPU. C’est un rappel utile qu’il ne faut pas multiplier un tarif GPU par 730 et appeler le résultat un budget de production.
Par exemple, 730 heures réservées aux deux références de tarifs publics de pods ci-dessus représenteraient environ 2 110 $ par mois pour l’exemple PCIe à 2,89 $/heure et 2 913 $ par mois pour l’exemple SXM à 3,99 $/heure, avant tout coût en dehors de la configuration de pod affichée. Ces chiffres sont des illustrations de budgétisation, et non des devis.
Le prix du GPU H100 varie également selon le modèle de facturation :
- À la demande convient bien au développement de courte durée, à l’évaluation et à une utilisation incertaine. Vous payez pour la flexibilité.
- La capacité Spot ou interruptible peut réduire le tarif affiché, mais une tâche d’entraînement nécessite une logique de création de points de contrôle et de redémarrage. Un prix bas n’est pas économique si une interruption fait perdre une journée de travail.
- La capacité réservée ou les blocs de capacité échangent la flexibilité contre un engagement d’approvisionnement limité dans le temps. Le tableau P5 d’AWS est un exemple de produit à comparer comme un achat de capacité planifiée, et non simplement comme une heure-GPU.
- La capacité cloud dédiée ou sous contrat peut inclure un profil de support, de disponibilité ou de réseau différent de celui d’un pod en libre-service. Comparez le périmètre du contrat, et pas seulement le modèle de GPU.
Notre guide des prix de location de GPU explique plus en détail la distinction entre à la demande, Spot et réservé. Pour les postes de coût qui ont tendance à apparaître après la validation d’un prototype, utilisez le guide des coûts cachés du cloud GPU comme liste de contrôle avant approbation.
Acheter un H100 : calculez le TCO global, pas le prix de la carte
L’achat peut avoir du sens pour des charges de travail durables et prévisibles, mais une annonce de carte n’est que le début. Utilisez ce modèle de propriété :
Coût mensuel de la capacité détenue
= (coût d’acquisition global − valeur résiduelle attendue) ÷ mois d’amortissement
+ alimentation et refroidissement
+ baie ou colocation
+ réseau et stockage
+ garantie, pièces de rechange et support
+ opérations de plateforme et temps d’astreinte
+ réserve pour indisponibilité / utilisation
Le coût d’acquisition global doit inclure la configuration exacte de l’accélérateur, le serveur compatible ou la plateforme HGX, les processeurs, la mémoire, les NIC, le stockage, la distribution électrique, l’expédition, les taxes, l’installation et le support. Pour les systèmes SXM, demander uniquement un devis pour une carte risque particulièrement d’omettre les composants qui rendent la configuration déployable.
Voici la bonne manière d’interpréter la référence PCIe à 32 200 $ :
- Il s’agit d’un prix de départ sur une place de marché pour une seule carte, et non d’un prix d’achat validé pour votre organisation.
- Par rapport à l’illustration de location à 2,89 $/heure, 32 200 $ équivalent à environ 11 142 heures-GPU, soit environ 15,3 mois à 730 heures réservées par mois.
- Ce calcul n’est pas une recommandation d’achat. Il exclut le serveur, l’alimentation, le refroidissement, le réseau, le support, le financement et le risque d’utilisation. À 50 % d’utilisation, le temps calendaire nécessaire pour consommer ces 11 142 heures double.
C’est pourquoi un prix du GPU H100 apparemment avantageux échoue souvent à une véritable analyse du seuil de rentabilité. Calculez d’abord le coût du travail terminé et accepté, et pas seulement le coût d’une heure d’accélérateur allouée.
Une feuille de calcul H100 à copier
Utilisez-la avant de demander des devis ou d’approuver un engagement cloud.
| Question | À consigner | Pourquoi c’est important |
|---|---|---|
| Quel est le SKU exact ? | PCIe, SXM, NVL ; mémoire ; nombre de GPU ; état neuf/reconditionné | Évite qu’une comparaison carte/serveur/paire se fasse passer pour une comparaison de prix. |
| De quoi la charge de travail a-t-elle besoin ? | VRAM maximale, nombre de GPU, interconnexion, objectif de débit/latence, persistance | Empêche qu’un prix du GPU H100 inférieur ne vous oriente vers une configuration inutilisable. |
| Quel sera son taux d’utilisation ? | Heures-GPU planifiées/mois et utilisation attendue | Détermine si la flexibilité ou la capacité détenue a une chance de l’emporter. |
| Qu’est-ce qui est inclus ? | vCPU, RAM, disque local, stockage persistant, NIC, sortie de données, support, SLA | Révèle les frais qui n’apparaissent pas dans le tarif de l’accélérateur. |
| Que se passe-t-il en cas d’interruption ? | Intervalle de point de contrôle, temps de restauration, coût des nouvelles tentatives, capacité de repli | Permet de comparer la tarification Spot à une capacité fiable. |
| Quelle est la métrique métier ? | Tâches acceptées, jetons, images, étapes d’entraînement ou expériences terminées | Vous permet d’optimiser le coût par résultat utile plutôt que le coût par heure. |
| Quelle est la solution de repli ? | GPU alternatif, autre région, API gérée ou politique de file d’attente | Réduit le coût des pénuries de capacité et des lancements échoués. |
La liste de contrôle pour comparer les devis
Demandez à chaque fournisseur de répondre à ces questions par écrit :
- Le devis concerne-t-il une carte PCIe, un module SXM, une configuration NVL, un serveur complet ou une allocation de cluster ?
- Combien de H100 sont inclus, et quelle interconnexion les relie ?
- Quels éléments de processeur, RAM, stockage, réseau, alimentation et support sont inclus ?
- Le tarif est-il à la demande, au comptant, réservé, planifié, prépayé ou correspond-il à un bloc de capacité ?
- Quelle région ou quelle installation s’applique, et la capacité est-elle réellement disponible pour la période demandée ?
- Quels frais restent en dehors du devis : stockage, transfert sortant, licences, configuration, taxes ou support ?
- Quelle est la politique d’annulation, d’interruption, de remplacement et de prise en charge du matériel ?
- Quel test de charge de travail exécuterez-vous pour comparer le coût par résultat accepté ?
Quand la location, la réservation, l’achat ou l’utilisation d’une API est le meilleur choix
Choisissez d’abord le modèle d’exploitation ; le prix du GPU H100 sera alors beaucoup plus facile à évaluer.
| Situation | Commencez généralement par | Pourquoi |
|---|---|---|
| Prototype, expérience de réglage fin ou demande incertaine | Location à la demande | Accès rapide et aucun engagement en capital ; mesurez l’utilisation et le temps d’inactivité. |
| Travail par lots tolérant aux pannes avec une forte utilisation de points de contrôle | Capacité spot / interruptible | Peut être économique lorsqu’un redémarrage est peu coûteux et que la perte de capacité est anticipée. |
| Fenêtre d’entraînement prévisible avec une échéance stricte | Capacité réservée ou bloc de capacité | Vous payez une garantie de durée et de disponibilité, ainsi que la puissance de calcul. |
| Utilisation soutenue et élevée avec une équipe plateforme expérimentée | Acheter ou colocaliser après un modèle de TCO complet | La propriété peut n’être viable qu’une fois les installations, le support et l’utilisation justifiables. |
| Le cas d’utilisation produit ne nécessite pas d’exécuter des poids personnalisés | Référence d’API de modèle | Comparez avec une approche par API avant d’acquérir du matériel ; la frontière opérationnelle peut compter davantage que le prix du GPU H100. |
Si le choix final se fait entre l’inférence auto-hébergée et une interface de modèle gérée, utilisez notre guide GPU cloud vs. model API pour structurer la comparaison. Une API d’IA unifiée peut également simplifier le test d’une référence gérée sur plusieurs modèles avant de vous engager dans une voie d’approvisionnement matériel.
Questions fréquentes sur le prix du H100
Combien coûte l’achat d’un GPU H100 ?
Il n’existe pas de prix public conseillé universel du H100 à utiliser pour les achats. Le prix du GPU H100 dépend du format, du vendeur, du support, du volume, de l’emplacement et du fait que le devis porte sur une carte ou un système complet. Dans l’instantané de ce guide du 22 octobre 2026, une place de marché proposait une carte H100 PCIe 80 GB à partir de 32 200 $. Considérez ce montant comme une référence datée, puis demandez un devis fournisseur détaillé.
Combien coûte la location d’un H100 par heure ?
Les tarifs publics peuvent varier considérablement selon le fournisseur et le produit. Runpod affichait le H100 PCIe à 2,89 $/heure et le H100 SXM à 3,99 $/heure sur sa page tarifaire, tandis qu’AWS affichait 5,97 $ par heure d’accélérateur pour son Capacity Block P5.4xlarge à un H100. Chacun correspond à un modèle de fourniture différent ; ne les classez donc pas uniquement selon le chiffre.
Un H100 SXM est-il plus cher qu’un H100 PCIe ?
Il apparaît souvent dans une plateforme plus coûteuse, car les exigences en matière de matériel, d’alimentation, de refroidissement et de fabric diffèrent. Comparez la configuration hôte exacte et le résultat du travail terminé. La vraie question est de savoir si la plateforme SXM améliore suffisamment votre charge de travail pour réduire le coût par tâche acceptée, et non si son prix de GPU H100 est inférieur dans une feuille de calcul.
Quand l’achat devient-il plus avantageux que la location ?
Uniquement lorsque votre coût total de capacité détenue est inférieur à celui d’une option cloud comparable, avec une utilisation réaliste. Incluez le serveur, le réseau, l’alimentation, le refroidissement, le support, la réserve pour les indisponibilités et le coût d’exploitation de la plateforme. Un calcul de seuil de rentabilité portant uniquement sur la carte est un outil de présélection, pas une décision.
Rendez le prochain devis H100 comparable
Le prix du GPU H100 ne devient utile que lorsqu’il est associé à une configuration et à une charge de travail précises. Commencez par le format du GPU, normalisez l’unité de temps, ajoutez chaque poste d’infrastructure et calculez le coût par résultat finalisé. Comparez ensuite la flexibilité, le risque de capacité et la charge opérationnelle, et pas seulement le prix d’une carte ou un tarif horaire.
Avant de vous engager, exécutez une charge de travail représentative sur les deux ou trois options viables. Ce petit test coûte généralement moins cher que de découvrir plus tard que le prix du GPU H100 le plus bas était associé au mauvais format, à un budget serveur incomplet ou à une référence cloud que votre charge de travail ne pouvait pas réellement utiliser.
Sources
- Fiche technique du GPU NVIDIA H100 Tensor Core
- Tarification du GPU Cloud Runpod
- Tarification des AWS EC2 Capacity Blocks pour le ML
- Tarification des VM optimisées pour accélérateurs Google Cloud
- Documentation sur la tarification des GPU Google Cloud
- Annonce de place de marché GPU Vendors pour le H100 PCIe 80 GB