Giải mã suy đoán cho suy luận LLM: Tăng thông lượng và đánh đổi
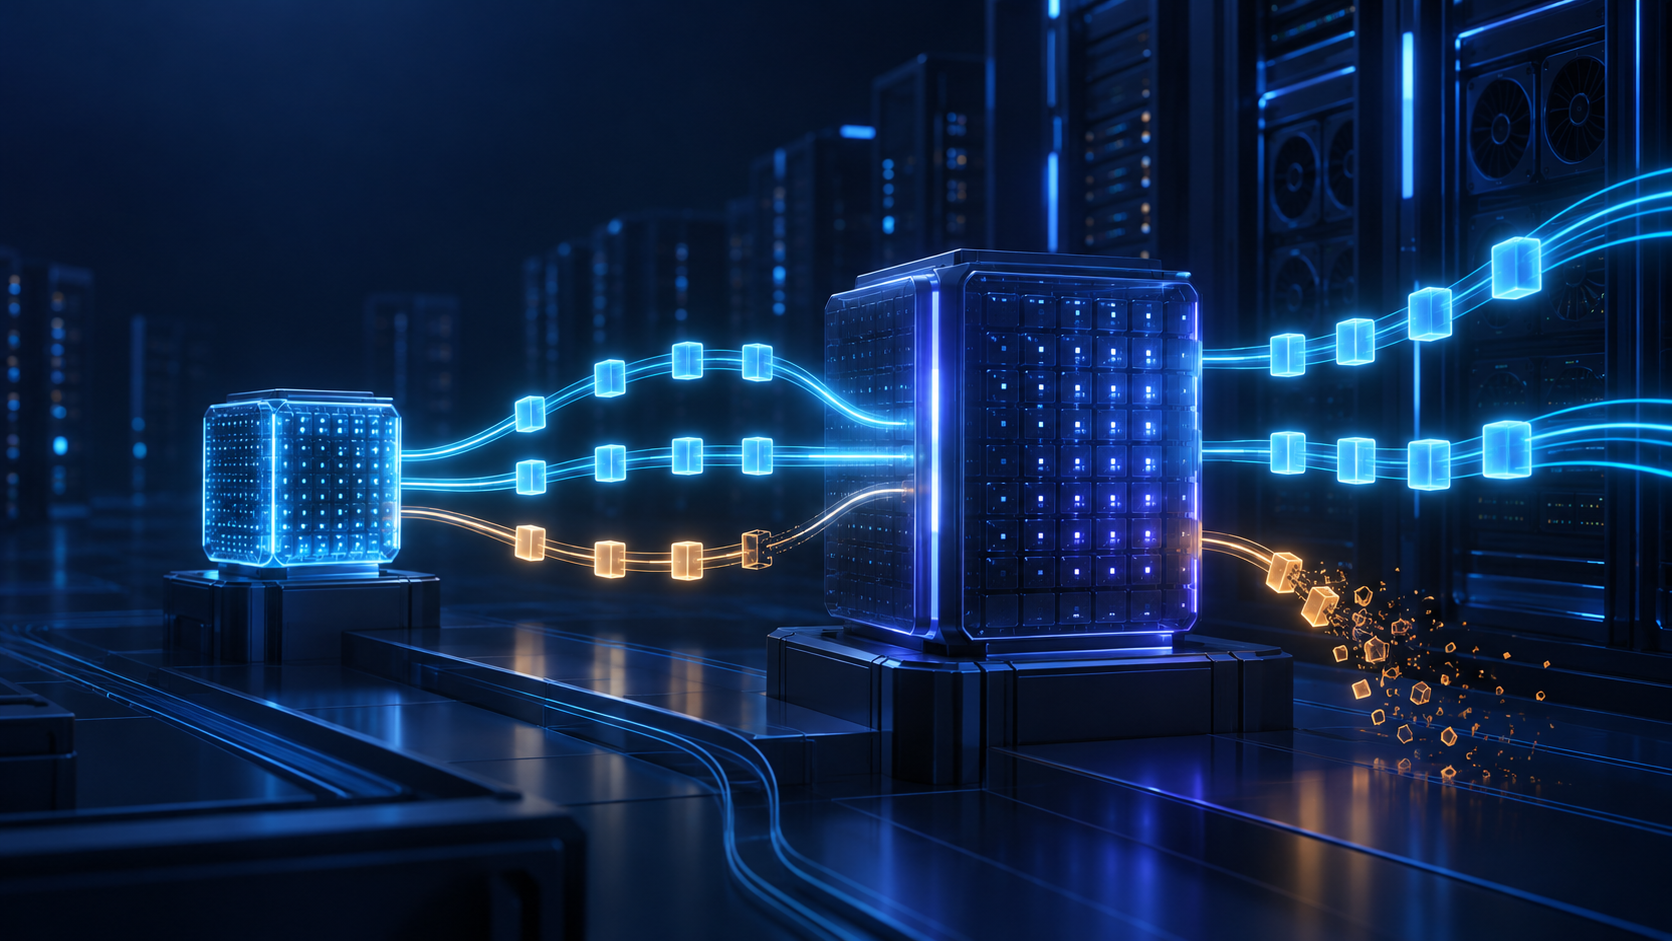
Phục vụ LLM giải mã suy đoán có thể giảm thời gian chờ token tiếp theo—mà không yêu cầu mô hình đích phải trở thành một mô hình khác. Thay vì để mô hình đích lớn chỉ tạo một token cho mỗi bước giải mã, một mô hình đề xuất chi phí thấp hơn sẽ phác thảo một đoạn tiếp diễn ngắn. Mô hình đích xác minh đoạn tiếp diễn đó song song, chốt tiền tố được chấp nhận và tiếp tục từ điểm bất đồng đầu tiên.
Nghe có vẻ như một bộ tăng tốc phổ quát. Nhưng không phải vậy. Kết quả phụ thuộc vào chất lượng bản nháp, tổ hợp yêu cầu, xử lý theo lô, thiết lập lấy mẫu, dư địa bộ nhớ GPU và liệu khối lượng công việc của bạn có thực sự bị giới hạn bởi giai đoạn giải mã hay không. Hướng dẫn này giải thích những gì diễn ra bên trong, cách EAGLE và Medusa thay đổi thiết kế, cũng như cách quyết định liệu giải mã suy đoán có phù hợp với ngăn xếp phục vụ của bạn hay không.
Quy tắc thực tế: hãy xem giải mã suy đoán là một tối ưu hóa phục vụ cần được đo lường—không phải một thiết lập tăng tốc trên lý thuyết. Chỉ duy trì nó khi nó cải thiện mục tiêu độ trễ hoặc thông lượng token đầu ra quan trọng đối với lưu lượng thực tế của bạn mà không làm giảm khả năng đồng thời hoặc độ tin cậy.
Suy luận LLM bằng giải mã suy đoán là gì?
Sinh tự hồi quy là tuần tự: token t + 1 phụ thuộc vào các token đứng trước nó. Vì vậy, bộ giải mã thông thường chờ một mô hình đích lớn chạy một lần cho mỗi token được sinh. Giải mã suy đoán thay đổi lịch biểu, chứ không thay đổi phân phối đích: một cơ chế bản nháp nhỏ hơn hoặc chuyên biệt dự đoán một số token ứng viên; mô hình đích chấm điểm hoặc xác minh đồng thời các vị trí ứng viên; hệ thống chấp nhận tiền tố khớp và quay về phương án dự phòng tại vị trí bị từ chối đầu tiên.
Bài báo gốc về giải mã suy đoán mô tả đây là cách thu được các mẫu chính xác từ mô hình đích trong khi đánh giá song song nhiều vị trí ứng viên. Kết quả 2–3× được báo cáo là kết quả benchmark cho thiết lập T5 của bài báo, không phải lời hứa cho mọi mô hình hoặc dịch vụ. Đọc bài báo gốc.
Sơ đồ suy luận LLM bằng giải mã suy đoán
request + current context
            |
            v
  draft mechanism proposes:  [A] [B] [C] [D]
            |
            v
  target model verifies all proposed positions in one pass
            |
            +-- accepts [A] [B] [C] -> commit that prefix (and possibly one extra target token)
            |
            +-- rejects at [C] -> commit [A] [B], sample/correct at [C], then repeat
Phần công việc được tiết kiệm không phải là bản thân việc tính toán bản nháp. Lợi ích tiềm năng đến từ việc thay thế nhiều vòng giải mã mô hình đích nối tiếp bằng một lượt xác minh của mô hình đích. Nếu đề xuất thường xuyên sai, mô hình đích vẫn phải khôi phục thường xuyên và mức cải thiện sẽ giảm.
Chỉ số quan trọng: số token được chấp nhận trên mỗi lần xác minh của mô hình đích
Tín hiệu sức khỏe hữu ích nhất là số token được đề xuất vượt qua xác minh. Các nhóm thường gọi đây là tỷ lệ chấp nhận hoặc độ dài được chấp nhận. Hãy theo dõi cả hai:
| Chỉ số | Ý nghĩa cho biết | Vì sao có thể gây hiểu lầm khi xem riêng lẻ |
|---|---|---|
| Tỷ lệ chấp nhận | Tỷ phần token được đề xuất mà mô hình đích chấp nhận | Không bao gồm chi phí bản nháp hoặc chi phí xác minh của mô hình đích. |
| Độ dài được chấp nhận trung bình | Số token bản nháp đã cam kết nhận được trong mỗi vòng | Giá trị trung bình có thể che khuất các yêu cầu đuôi dài và những chế độ lấy mẫu khác nhau. |
| Độ trễ giữa các token (ITL) | Thời gian giữa các token được stream | Đây thường là chỉ số giải mã người dùng nhìn thấy. |
| Tổng token đầu ra/giây | Năng lực phục vụ hữu ích trên các yêu cầu đồng thời | Chỉ số này có thể cải thiện trong khi người dùng tương tác với QPS thấp hầu như không nhận được lợi ích, hoặc ngược lại. |
| Bộ nhớ GPU và số lượng yêu cầu đang hoạt động | Liệu bộ đề xuất có lấn át KV cache hoặc khả năng đồng thời hay không | Một yêu cầu đơn nhanh hơn có thể là cấu hình tệ hơn ở cấp độ toàn cụm. |
Để thử nghiệm A/B công bằng, hãy giữ nguyên phiên bản mô hình, tokenizer, lượng tử hóa, độ dài đầu ra tối đa, hỗn hợp prompt, tham số lấy mẫu, phần cứng và chính sách đồng thời. So sánh độ trễ đầu cuối, thời gian đến token đầu tiên, ITL p50/p95, token đầu ra/giây và tỷ lệ lỗi. Một con số “token/giây” đơn lẻ không kèm hình dạng tải là chưa đủ để chọn cấu hình.
Giải mã suy đoán hữu ích ở đâu — và không hữu ích ở đâu
Phục vụ LLM bằng giải mã suy đoán thường hấp dẫn nhất khi giải mã bị giới hạn bởi bộ nhớ và mỗi yêu cầu có độ dài sinh đủ lớn để các vòng xác minh lặp lại tạo khác biệt. Hướng dẫn vLLM hiện tại đặc biệt xem đây là cách giảm độ trễ giữa các token cho khối lượng công việc bị giới hạn bởi bộ nhớ, ở QPS trung bình đến thấp, đồng thời lưu ý rằng lợi ích thực tế phụ thuộc vào họ mô hình, lưu lượng, phần cứng và thiết lập lấy mẫu. Xem hướng dẫn giải mã suy đoán của vLLM.
Phương pháp này kém thuyết phục hơn trong các trường hợp sau:
- Prefill chiếm ưu thế trong yêu cầu. Prompt dài với câu trả lời ngắn dành phần lớn thời gian để nạp ngữ cảnh. Bản nháp thay đổi công việc giải mã, chứ không phải công việc prefill prompt vốn đã chi phối độ trễ đầu cuối.
- Mức chấp nhận thấp. Giải mã sáng tạo, mô hình bản nháp không phù hợp hoặc cấu hình tạo ra các phần tiếp diễn ứng viên yếu có thể dẫn đến các lần xác minh thất bại lặp lại.
- Máy chủ của bạn đã bão hòa theo batch. Ở mức đồng thời cao, GPU đích có thể đã được bộ lập lịch thông thường khai thác hiệu quả. Việc thêm một drafter có thể tiêu thụ bộ nhớ hoặc năng lực tính toán vốn có thể phục vụ nhiều yêu cầu hơn.
- Dung lượng dự phòng của KV cache bị hạn chế. Mô hình bản nháp bổ sung hoặc trạng thái của bộ đề xuất có thể làm giảm số lượng chuỗi đang hoạt động trước khi bắt đầu eviction hoặc xếp hàng. Hãy xem yêu cầu bộ nhớ GPU cho LLM trước khi diễn giải mức tăng tốc của một yêu cầu đơn lẻ thành lợi ích cho toàn cụm.
- Mô hình đích không tương thích với bộ đề xuất đã chọn. Các phương pháp dựa trên mô hình cần artifact, tokenization và hỗ trợ phục vụ tương thích; đừng bao giờ giả định một mô hình nhỏ là mô hình bản nháp hợp lệ chỉ vì nó rẻ hơn.
Do đó, câu hỏi đúng không phải là “Giải mã suy đoán có thể làm mô hình này nhanh hơn không?” mà là “Nó cải thiện ràng buộc ở cấp độ dịch vụ nào dưới phân phối lưu lượng của chúng ta?”
Mô hình bản nháp, EAGLE và Medusa: ba cách đề xuất token
Mô hình bản nháp riêng biệt
Thiết kế cổ điển ghép một mô hình bản nháp nhanh với một mô hình đích lớn hơn. Bản nháp đề xuất k token; mô hình đích xác minh chúng. Về mặt khái niệm, cách này có thể đơn giản, nhưng nó bổ sung thêm một artifact mô hình, dấu chân bộ nhớ, công việc tương thích và một bề mặt vận hành cần lập phiên bản và giám sát.
Hãy dùng khi bạn có bộ đề xuất độ trễ thấp, tương thích đã được chứng minh và đủ năng lực GPU để duy trì khả năng đồng thời của dịch vụ mô hình đích. Hãy bắt đầu với một tập nhỏ các độ dài suy đoán — thay vì giả định đề xuất sâu hơn luôn tốt hơn.
Giải mã suy đoán LLM EAGLE
EAGLE là một phương pháp dựa trên mô hình, tạo bản nháp ở cấp độ đặc trưng thay vì chỉ sử dụng đường đề xuất mô hình token nhỏ thông thường. Bài báo mô tả việc điều kiện hóa dự đoán đặc trưng của nó bằng chuỗi token đi trước một bước để giải quyết bất định ở cấp độ đặc trưng. Trong các thiết lập được thử nghiệm của bài báo, phương pháp này báo cáo độ trễ và thông lượng cải thiện trong khi vẫn bảo toàn phân phối văn bản được sinh; đó là bằng chứng hữu ích về tiềm năng của phương pháp, không phải dự báo năng lực cho một mô hình hoặc cụm GPU khác. Đọc bài báo EAGLE.
Đối với người vận hành, hàm ý rất rõ ràng: EAGLE có thể hấp dẫn khi có sẵn các artifact được hỗ trợ cho họ mô hình đích, nhưng không phải là một công tắc chung cho mọi checkpoint. Hãy xác thực cặp đích/bộ đề xuất chính xác và phiên bản engine phục vụ trước khi đưa vào sử dụng chính thức.
Giải mã suy đoán LLM Medusa
Medusa đặt nhiều head giải mã trên một mô hình backbone và dùng attention dựa trên cây để tạo cũng như xác minh một số phần tiếp diễn ứng viên. Điều đó tránh phải duy trì một mô hình bản nháp độc lập hoàn toàn riêng biệt, nhưng các head phải được huấn luyện hoặc fine-tune cho backbone. Bài báo Medusa phân biệt đường backbone đóng băng với fine-tuning chung và báo cáo mức tăng tốc benchmark cho các thiết lập thử nghiệm đó. Đọc bài báo Medusa.
Đánh đổi về vận hành khác với cặp mô hình bản nháp: có thể cần ít quản lý mô hình riêng biệt hơn, nhưng phải có artifact đặc thù mô hình cùng yêu cầu huấn luyện hoặc tích hợp. Hãy coi đây là một lựa chọn phục vụ mô hình, không phải mẹo lúc chạy.
Kế hoạch triển khai thực tế cho suy luận GPU
1. Thiết lập đường cơ sở đại diện
Thu thập ít nhất một lát yêu cầu giống môi trường production: các dải độ dài prompt, dải độ dài đầu ra, loại ngôn ngữ hoặc tác vụ, thiết lập temperature/top-p, hành vi streaming và mức đồng thời. Ghi nhận đường cơ sở riêng cho thời gian đến token đầu tiên và giai đoạn giải mã. Nếu khối lượng công việc thiên về prompt, đừng để benchmark token đầu ra che khuất vấn đề prefill.
2. Chọn một chiến lược bộ đề xuất và độ sâu thận trọng
Hãy bắt đầu với một phương pháp được hỗ trợ — mô hình bản nháp, EAGLE, Medusa hoặc bộ đề xuất khác được engine hỗ trợ — và độ dài ứng viên nhỏ. Ví dụ, vLLM ghi nhận các thiết lập --speculative-config như phương pháp, mô hình bộ đề xuất và num_speculative_tokens; hãy tham khảo tài liệu khớp phiên bản trước khi sao chép bất kỳ cấu hình nào vào production. Để biết thiết lập vận hành rộng hơn, xem hướng dẫn triển khai vLLM. Đừng tinh chỉnh độ sâu suy đoán và batching cùng lúc trong lần đầu.
3. Chạy ma trận tải, không phải một benchmark duy nhất
Kiểm tra cùng lát lưu lượng ở mức đồng thời thấp, trung bình và tương tự đỉnh. Với mỗi điểm, hãy so sánh:
- Độ trễ đầu cuối của đường cơ sở so với suy đoán.
- Độ trễ giữa các token p50 và p95 cho yêu cầu streaming.
- Tổng token đầu ra/giây và số yêu cầu hoàn thành/giây.
- Độ dài được chấp nhận, tần suất từ chối và độ trễ của bộ đề xuất.
- Bộ nhớ GPU, áp lực KV-cache, độ trễ hàng đợi và tỷ lệ lỗi/hết thời gian chờ.
Nếu có thể, hãy chia tách kết quả theo dải prompt và dải đầu ra. Một cấu hình hỗ trợ các phần hoàn thiện mã dài có thể không hỗ trợ câu trả lời chat ngắn, và kết quả offline tốt có thể suy giảm sau khi tính cả thời gian xếp hàng.
4. Thiết lập rào chắn trước canary
Xác định ngưỡng rollback trước khi lưu lượng gặp thay đổi: ví dụ, suy giảm p95 ITL, giảm số yêu cầu hoàn thành/giây ở tải đỉnh, tăng sự kiện hết bộ nhớ hoặc sụp đổ tỷ lệ chấp nhận kéo dài. Ban đầu chỉ định tuyến một lát đủ điều kiện và duy trì đường cơ sở để so sánh nhanh.
5. Tiếp tục đo lường sau khi ra mắt
Mức chấp nhận thay đổi theo bản cập nhật mô hình, phân phối prompt, định dạng sử dụng công cụ và mặc định lấy mẫu. Chạy lại so sánh sau bất kỳ thay đổi đáng kể nào về mô hình đích, tokenizer, lượng tử hóa, GPU, engine phục vụ hoặc hồ sơ lưu lượng.
Điểm khởi đầu vLLM tối thiểu
Đối với engine phục vụ có hỗ trợ, cấu hình nên nêu rõ phương pháp bộ đề xuất thay vì che giấu nó trong một mặc định mơ hồ. Tài liệu vLLM hiện tại sử dụng cấu trúc như sau cho một mô hình bản nháp riêng biệt:
vllm serve <target-model> \
  --speculative-config '{
    "method": "draft_model",
    "model": "<compatible-draft-model>",
    "num_speculative_tokens": 5
  }'
Các placeholder là có chủ đích. Mô hình tương thích, số token suy đoán, thiết lập song song và ngân sách bộ nhớ phải được chọn từ các artifact và phiên bản engine mà bạn đã thử nghiệm. Đừng sao chép đoạn mã này như bằng chứng rằng một cặp đích/bản nháp cụ thể được hỗ trợ.
Tổng quan nhanh về mức tăng thông lượng và các đánh đổi
| Quyết định | Lợi ích có khả năng đạt được | Chi phí hoặc chế độ lỗi chính | Điều cần đo lường đầu tiên |
|---|---|---|---|
| Bật mô hình bản nháp riêng biệt | Ít bước giải mã đích nối tiếp hơn khi mức chấp nhận cao | Bộ nhớ mô hình bổ sung, tương thích và độ trễ bản nháp | Độ dài được chấp nhận, dung lượng dự phòng KV-cache, p95 ITL |
| Tăng độ dài suy đoán | Nhiều token tiềm năng hơn trên mỗi lần xác minh | Nhiều công việc bản nháp lãng phí hơn khi token phía sau bị từ chối | ITL ròng và TPS đầu ra tổng, không chỉ mức chấp nhận |
| Dùng EAGLE | Đường đề xuất dựa trên mô hình mạnh khi artifact được hỗ trợ | Yêu cầu tương thích họ mô hình và engine | Tương thích đích/bộ đề xuất và kết quả benchmark theo hình dạng tải |
| Dùng Medusa | Đề xuất đa head mà không cần mô hình bản nháp đầy đủ riêng biệt | Các head đặc thù mô hình và công việc tích hợp/huấn luyện | Kiểm tra chất lượng đầu ra, hỗ trợ phục vụ và đường rollback |
| Bật ở QPS đỉnh | Lợi ích thông lượng có thể có với engine/khối lượng công việc phù hợp | Cạnh tranh về bộ lập lịch, bộ nhớ hoặc tính toán có thể xóa mất lợi ích | Số yêu cầu hoàn thành/giây, thời gian xếp hàng và tỷ lệ lỗi |
Câu hỏi thường gặp
Giải mã suy đoán có thay đổi câu trả lời từ mô hình đích không?
Lấy mẫu suy đoán đúng cách sử dụng xác minh và hiệu chỉnh của mô hình đích để việc lấy mẫu có thể bảo toàn phân phối đích. Sự đảm bảo phụ thuộc vào việc sử dụng thuật toán đúng và triển khai tương thích. Một thay đổi trong phục vụ vẫn có thể ảnh hưởng đến hành vi vận hành — chẳng hạn như độ trễ, xếp hàng hoặc lỗi — vì vậy hãy đánh giá cả chất lượng và độ tin cậy, bên cạnh tốc độ.
Giải mã suy đoán có cải thiện thời gian đến token đầu tiên không?
Thông thường, nó nhắm đến giai đoạn giải mã sau khi bắt đầu sinh. Nếu xử lý prompt chi phối các yêu cầu của bạn, thời gian đến token đầu tiên có thể thay đổi rất ít. Hãy đo prefill và giải mã riêng biệt.
Tôi nên dùng bao nhiêu token suy đoán?
Không có giá trị tốt nhất mang tính phổ quát. Hãy thử một phạm vi nhỏ với mô hình, bộ đề xuất, thiết lập lấy mẫu, loại GPU và mức đồng thời của bạn. Đề xuất dài hơn chỉ có lợi khi đủ nhiều token được chấp nhận và công việc bổ sung của nó không làm giảm năng lực phục vụ.
Tôi nên dùng EAGLE hay Medusa?
Hãy chọn phương pháp mà mô hình đích và engine phục vụ của bạn hỗ trợ tốt, sau đó benchmark trên khối lượng công việc của bạn. EAGLE dựa vào các artifact tạo bản nháp cấp độ đặc trưng được hỗ trợ; Medusa dựa vào nhiều head liên kết với một backbone. Không phương pháp nào tự động có thể thay thế cho một mô hình bản nháp chung.
Đặt quyết định vào bối cảnh
Giải mã suy đoán là một lớp tối ưu hóa phục vụ LLM. Nó hoạt động tốt nhất khi đi cùng lựa chọn phục vụ mô hình rõ ràng, giới hạn năng lực thực tế và giám sát tường minh. Để so sánh engine phục vụ rộng hơn, xem vLLM so với SGLang: Thông lượng, Độ trễ, Hỗ trợ Mô hình và Vận hành. Để tìm hiểu khía cạnh năng lực của API production, xem RPM so với TPM: Giới hạn tốc độ LLM và cách khắc phục lỗi 429.
Nếu bạn đang lập kế hoạch thử nghiệm GPU hoặc môi trường suy luận mới, hãy khám phá Flatkey Compute và bắt đầu bằng kế hoạch benchmark báo cáo cả độ trễ người dùng nhìn thấy lẫn thông lượng ở cấp độ toàn cụm. Cấu hình LLM giải mã suy đoán tốt nhất là cấu hình cải thiện chỉ số bị ràng buộc của bạn dưới tải thực tế — và có thể rollback an toàn khi khối lượng công việc thay đổi. Hướng dẫn giải mã suy đoán LLM này là điểm khởi đầu cho kỷ luật đo lường đó, không phải sự thay thế cho nó.