Спекулятивное декодирование для инференса LLM: прирост пропускной способности и компромиссы
Обслуживание LLM со спекулятивным декодированием может сократить время ожидания следующего токена — без необходимости превращать целевую модель в другую модель. Вместо того чтобы позволять большой целевой модели генерировать лишь один токен на каждом шаге декодирования, более дешёвая модель-предложитель создаёт короткое продолжение. Целевая модель параллельно проверяет это продолжение, фиксирует принятый префикс и продолжает с первого расхождения.
Это звучит как универсальный ускоритель. Но это не так. Результат зависит от качества черновика, состава запросов, батчинга, настроек сэмплирования, запаса памяти GPU и того, действительно ли ваша нагрузка ограничена декодированием. В этом руководстве объясняется, что происходит внутри, как EAGLE и Medusa меняют архитектуру и как решить, стоит ли включать спекулятивное декодирование в ваш стек обслуживания.
Практическое правило: относитесь к спекулятивному декодированию как к измеряемой оптимизации обслуживания, а не как к настройке, обеспечивающей ускорение из статьи. Оставляйте его только тогда, когда оно улучшает целевой показатель задержки или пропускной способности по выходным токенам, важный для вашего фактического трафика, не снижая при этом параллелизм или надёжность.
Что такое инференс LLM со спекулятивным декодированием?
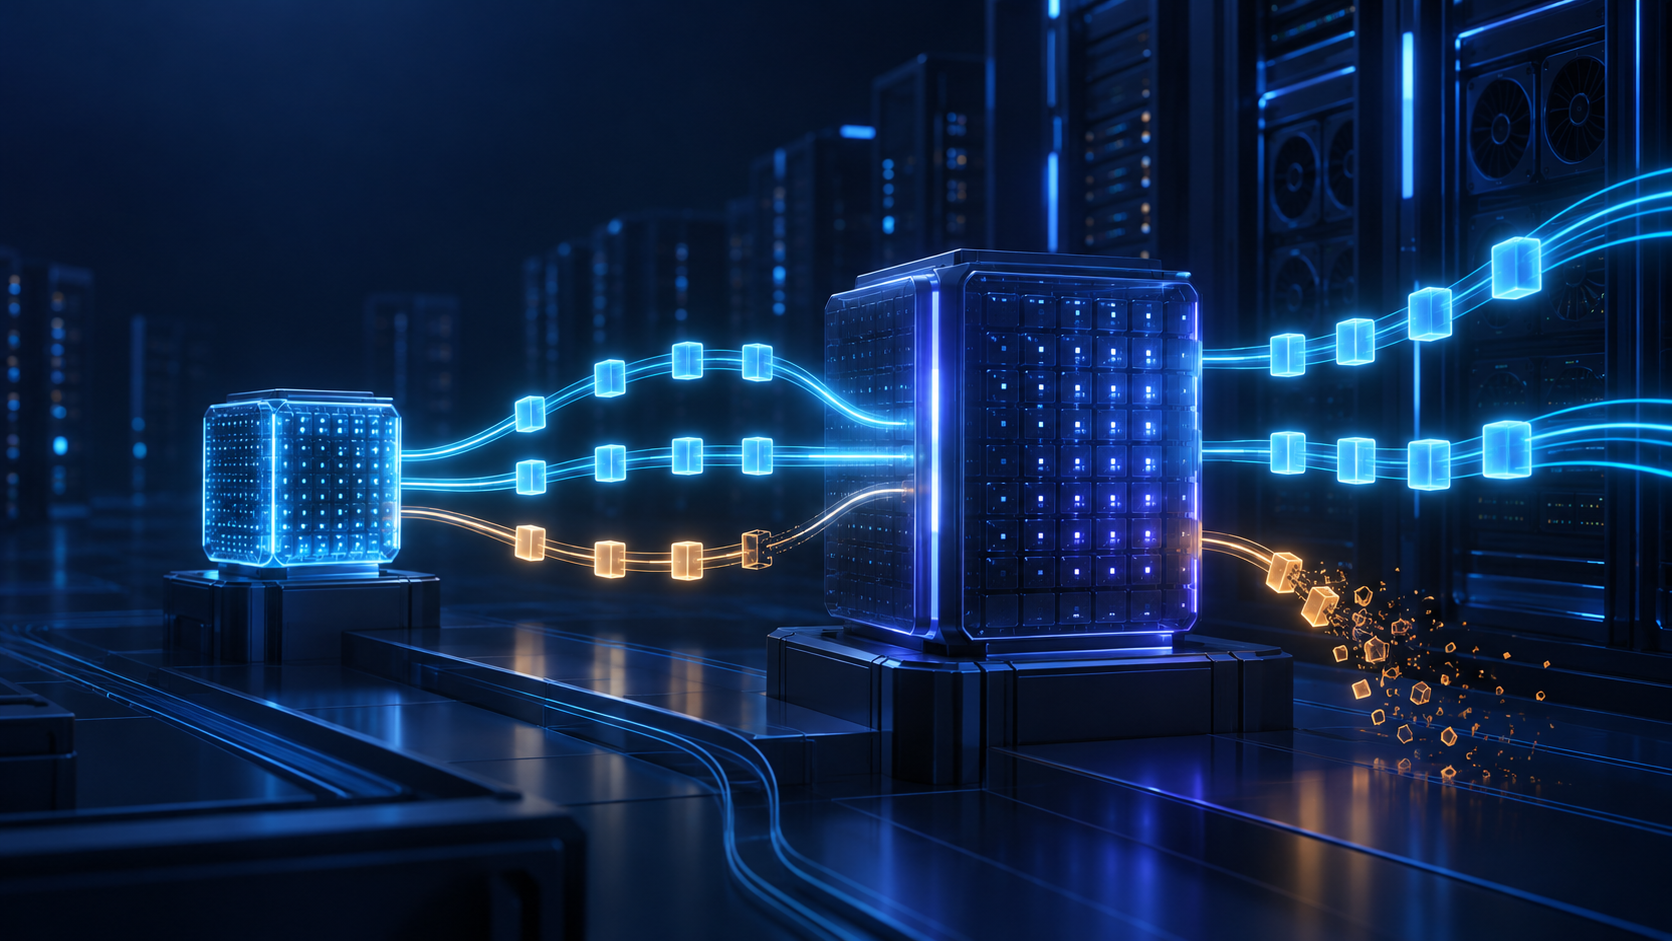
Авторегрессионная генерация последовательна: токен t + 1 зависит от предшествующих ему токенов. Поэтому обычный декодер ожидает однократного запуска большой целевой модели для каждого генерируемого токена. Спекулятивное декодирование изменяет расписание, но не целевое распределение: меньший или специализированный черновой механизм предсказывает несколько токенов-кандидатов; целевая модель одновременно оценивает или проверяет позиции кандидатов; система принимает совпадающий префикс и откатывается на первой отклонённой позиции.
В исходной статье о спекулятивном декодировании этот подход описывается как способ получать точные выборки из целевой модели, одновременно вычисляя несколько позиций кандидатов. Указанный в ней результат 2–3× был результатом бенчмарка для конфигурации T5, а не обещанием для каждой модели или сервиса. Прочитать исходную статью.
Схема инференса LLM со спекулятивным декодированием
request + current context
            |
            v
  draft mechanism proposes:  [A] [B] [C] [D]
            |
            v
  target model verifies all proposed positions in one pass
            |
            +-- accepts [A] [B] [C] -> commit that prefix (and possibly one extra target token)
            |
            +-- rejects at [C] -> commit [A] [B], sample/correct at [C], then repeat
Сохраняемые вычисления — не сами черновые вычисления. Потенциальный выигрыш возникает за счёт замены нескольких последовательных итераций декодирования целевой модели одним проходом проверки целевой моделью. Если предложение часто оказывается неверным, целевой модели всё равно приходится часто восстанавливаться, и выигрыш сокращается.
Ключевая метрика: принятые токены на одну проверку целевой моделью
Наиболее полезный индикатор состояния — число предложенных токенов, прошедших проверку. Команды часто называют это коэффициентом принятия или принятой длиной. Отслеживайте оба показателя:
| Метрика | Что она показывает | Почему сама по себе может вводить в заблуждение |
|---|---|---|
| Коэффициент принятия | Какую долю предложенных токенов принимает целевая модель | Не учитывает стоимость черновой генерации или проверки целевой моделью. |
| Средняя принятая длина | Сколько зафиксированных черновых токенов получается за один раунд | Средние значения могут скрывать запросы с длинным хвостом и различные режимы сэмплирования. |
| Межтокенная задержка (ITL) | Время между потоково передаваемыми токенами | Обычно это метрика декодирования, видимая пользователю. |
| Совокупное число выходных токенов в секунду | Полезная пропускная способность сервинга при параллельных запросах | Показатель может улучшиться, пока интерактивный пользователь с низким QPS почти не увидит пользы, или наоборот. |
| Память GPU и число активных запросов | Вытесняет ли механизм предложений KV-кеш или снижает параллелизм | Более быстрый одиночный запрос может быть худшей конфигурацией на уровне всего парка. |
Для честного A/B-теста зафиксируйте ревизию модели, токенизатор, квантизацию, максимальную длину вывода, состав промптов, параметры сэмплирования, оборудование и политику параллелизма. Сравнивайте сквозную задержку, время до первого токена, p50/p95 ITL, выходные токены в секунду и частоту ошибок. Одного показателя «токенов/с» без профиля нагрузки недостаточно для выбора конфигурации.
Где спекулятивное декодирование помогает — и где нет
Сервинг LLM со спекулятивным декодированием обычно наиболее привлекателен, когда декодирование ограничено памятью и каждый запрос генерирует достаточно длинный вывод, чтобы повторяющиеся раунды проверки имели значение. Актуальное руководство vLLM конкретно позиционирует его как способ снизить межтокенную задержку для ограниченных памятью нагрузок со средним или низким QPS и отмечает, что фактический выигрыш зависит от семейства моделей, трафика, оборудования и настроек сэмплирования. Смотреть руководство vLLM по спекулятивному декодированию.
Он менее убедителен в следующих случаях:
- Префилл доминирует в запросе. Длинные промпты с короткими ответами тратят большую часть времени на обработку контекста. Черновая генерация изменяет работу декодирования, но не работу префилла промпта, которая уже доминирует в сквозной задержке.
- Принятие кандидатов низкое. Творческое декодирование, несоответствующая черновая модель или конфигурация, создающая слабые продолжения-кандидаты, могут приводить к повторяющимся сбоям проверки.
- Ваш сервер уже насыщен батчами. При высокой параллельности GPU целевой модели может эффективно использоваться обычным планировщиком. Добавление чернового механизма может потреблять память или вычислительные ресурсы, которые иначе обслуживали бы больше запросов.
- Запас для KV-кеша ограничен. Дополнительная черновая модель или состояние механизма предложений могут сократить число активных последовательностей до начала вытеснения или постановки в очередь. Изучите требования LLM к памяти GPU, прежде чем интерпретировать ускорение одиночного запроса как выигрыш для всего парка.
- Целевая модель несовместима с выбранным механизмом предложений. Методы на основе моделей требуют совместимых артефактов, токенизации и поддержки сервинга; никогда не предполагайте, что небольшая модель является допустимой черновой моделью лишь потому, что она дешевле.
Таким образом, правильный вопрос не «Может ли спекулятивное декодирование ускорить эту модель?», а «Какое ограничение на уровне сервиса оно улучшает при нашем распределении трафика?»
Черновые модели, EAGLE и Medusa: три способа предлагать токены
Отдельная черновая модель
Классическая архитектура объединяет быструю черновую модель с более крупной целевой моделью. Черновая модель предлагает k токенов; целевая модель их проверяет. Концептуально это может быть просто, но добавляет ещё один артефакт модели, потребление памяти, работу по совместимости и операционную поверхность, которую нужно версионировать и мониторить.
Используйте этот подход, если у вас есть доказуемо совместимый механизм предложений с низкой задержкой и достаточно GPU-ресурсов для сохранения параллелизма сервиса целевой модели. Начните с небольшого набора спекулятивных длин, а не предполагая, что более глубокое предложение всегда лучше.
Спекулятивное декодирование LLM EAGLE
EAGLE — это подход на основе модели, который создаёт черновики на уровне признаков, а не использует только традиционный путь предложений небольшой токенной модели. В статье описывается обусловливание предсказания признаков последовательностью токенов на один шаг вперёд для устранения неопределённости на уровне признаков. В протестированных в статье настройках сообщается об улучшении задержки и пропускной способности при сохранении распределения генерируемого текста; это полезное свидетельство потенциала метода, а не прогноз мощности для другой модели или парка GPU. Прочитать статью об EAGLE.
Для операторов вывод очевиден: EAGLE может быть привлекательным, когда для целевого семейства доступны поддерживаемые артефакты, но это не универсальный переключатель для каждого чекпойнта. Проверьте точную пару целевой модели и механизма предложений, а также версию движка сервинга, прежде чем внедрять решение.
Спекулятивное декодирование LLM Medusa
Medusa добавляет несколько голов декодирования к базовой модели и использует внимание на основе дерева для создания и проверки нескольких продолжений-кандидатов. Это избавляет от необходимости поддерживать отдельную полностью независимую черновую модель, но головы должны быть обучены или дообучены для базовой модели. В статье о Medusa различаются путь с замороженной базовой моделью и совместное дообучение, а также приводятся ускорения в бенчмарках для этих экспериментальных конфигураций. Прочитать статью о Medusa.
Операционный компромисс отличается от пары с черновой моделью: потенциально меньше управления отдельными моделями, но требуется специфичный для модели артефакт и обучение либо интеграция. Рассматривайте это как выбор для сервинга модели, а не как трюк времени выполнения.
Практический план внедрения для инференса на GPU
1. Сформируйте репрезентативный базовый уровень
Соберите как минимум один срез запросов, похожий на производственный: диапазоны длины промптов, диапазоны длины вывода, язык или тип задачи, настройки temperature/top-p, потоковое поведение и уровни параллелизма. Запишите базовые показатели отдельно для времени до первого токена и декодирования. Если нагрузка преимущественно состоит из промптов, не позволяйте бенчмарку выходных токенов скрыть проблему префилла.
2. Выберите одну стратегию предложений и консервативную глубину
Начните с одного поддерживаемого метода — черновой модели, EAGLE, Medusa или другого поддерживаемого движком механизма предложений — и небольшой длины кандидата. Например, vLLM документирует настройки --speculative-config, такие как метод, модель предложений и num_speculative_tokens; перед копированием любой конфигурации в производство обращайтесь к документации, соответствующей вашей версии. Более широкую информацию по операционной настройке см. в руководстве по развёртыванию vLLM. При первом проходе не настраивайте одновременно спекулятивную глубину и батчинг.
3. Запустите матрицу нагрузок, а не один бенчмарк
Протестируйте один и тот же срез трафика при низком, среднем и близком к пиковому параллелизме. Для каждой точки сравните:
- Базовую и спекулятивную сквозную задержку.
- p50 и p95 межтокенной задержки для потоковых запросов.
- Совокупное число выходных токенов в секунду и завершённых запросов в секунду.
- Принятую длину, частоту отклонений и задержку механизма предложений.
- Память GPU, нагрузку на KV-кеш, задержку в очереди и частоту ошибок/тайм-аутов.
Если возможно, разделите результаты по диапазонам промптов и вывода. Конфигурация, которая помогает при длинных дополнениях кода, может не помочь при коротких ответах в чате, а хороший офлайн-результат может ухудшиться после учёта очередей.
4. Задайте защитные пороги до канареечного запуска
Определите пороги отката до того, как трафик увидит изменение: например, регрессия p95 ITL, снижение числа завершённых запросов в секунду при пиковой нагрузке, рост событий нехватки памяти или устойчивое падение коэффициента принятия. Сначала направляйте только подходящий срез и сохраняйте базовый путь для быстрого сравнения.
5. Продолжайте измерения после запуска
Принятие меняется вместе с обновлениями модели, распределениями промптов, форматами использования инструментов и настройками сэмплирования по умолчанию. Повторяйте сравнение после любого существенного изменения целевой модели, токенизатора, квантизации, GPU, движка сервинга или профиля трафика.
Минимальная отправная точка vLLM
Для движка сервинга, который это поддерживает, конфигурация должна явно указывать метод предложений, а не скрывать его в непрозрачной настройке по умолчанию. В текущей документации vLLM для отдельной черновой модели используется структура вида:
vllm serve <target-model> \
  --speculative-config '{
    "method": "draft_model",
    "model": "<compatible-draft-model>",
    "num_speculative_tokens": 5
  }'
Заполнители использованы намеренно. Совместимую модель, число спекулятивных токенов, настройки параллелизма и бюджет памяти необходимо выбирать на основе артефактов и версии движка, которые вы протестировали. Не воспринимайте этот фрагмент как доказательство того, что конкретная пара целевой и черновой моделей поддерживается.
Прирост пропускной способности и компромиссы: краткий обзор
| Решение | Вероятное преимущество | Основная стоимость или режим отказа | Что измерить в первую очередь |
|---|---|---|---|
| Включить отдельную черновую модель | Меньше последовательных шагов декодирования целевой моделью при высоком принятии | Дополнительная память для модели, совместимость и задержка черновой генерации | Принятая длина, запас KV-кеша, p95 ITL |
| Увеличить спекулятивную длину | Больше потенциальных токенов на одну проверку | Больше бесполезной черновой работы при отклонении поздних токенов | Чистая ITL и совокупный выходной TPS, а не только принятие |
| Использовать EAGLE | Сильный путь предложений на основе модели при наличии поддерживаемых артефактов | Требования совместимости семейства моделей и движка | Совместимость целевой модели и механизма предложений, а также результаты бенчмарков с профилем нагрузки |
| Использовать Medusa | Предложения с несколькими головами без отдельной полной черновой модели | Специфичные для модели головы и работа по интеграции/обучению | Проверки качества вывода, поддержка сервинга и путь отката |
| Включить при пиковом QPS | Возможный выигрыш в пропускной способности для подходящего движка/нагрузки | Конкуренция за планировщик, память или вычислительные ресурсы может устранить выигрыш | Завершённые запросы/с, время в очереди и частота ошибок |
FAQ
Меняет ли спекулятивное декодирование ответ целевой модели?
Корректное спекулятивное сэмплирование использует проверку и коррекцию целевой моделью, поэтому сэмплирование может сохранять целевое распределение. Гарантия зависит от использования правильного алгоритма и совместимой реализации. Изменение в сервинге всё же может влиять на операционное поведение — например, на задержку, постановку в очередь или ошибки, — поэтому оценивайте качество и надёжность наряду со скоростью.
Улучшает ли спекулятивное декодирование время до первого токена?
Обычно оно нацелено на фазу декодирования после начала генерации. Если в ваших запросах доминирует обработка промптов, время до первого токена может почти не измениться. Измеряйте префилл и декодирование отдельно.
Сколько спекулятивных токенов следует использовать?
Универсального оптимального значения не существует. Протестируйте небольшой диапазон на вашей модели, механизме предложений, настройках сэмплирования, типе GPU и уровне параллелизма. Более длинное предложение выигрывает только тогда, когда принимается достаточно его токенов, а дополнительная работа не снижает ёмкость сервиса.
Стоит ли использовать EAGLE или Medusa?
Выберите метод, который хорошо поддерживается вашей целевой моделью и движком сервинга, затем протестируйте его на своей нагрузке. EAGLE опирается на поддерживаемые артефакты черновой генерации на уровне признаков; Medusa — на несколько голов, связанных с базовой моделью. Ни один из них не является автоматически взаимозаменяемым с универсальной черновой моделью.
Рассмотрите решение в контексте
Спекулятивное декодирование — один из уровней оптимизации сервинга LLM. Оно лучше всего работает вместе с ясным выбором сервинга модели, реалистичными ограничениями ёмкости и явным мониторингом. Для более широкого сравнения движков сервинга см. vLLM vs SGLang: пропускная способность, задержка, поддержка моделей и эксплуатация. Вопросам ёмкости производственных API посвящена статья RPM vs TPM: ограничения скорости LLM и устранение ошибок 429.
Если вы планируете эксперименты с GPU или новую среду инференса, изучите Flatkey Compute и начните с плана бенчмарков, который отражает как видимую пользователю задержку, так и пропускную способность на уровне парка. Лучшая конфигурация LLM со спекулятивным декодированием — та, которая улучшает вашу ограниченную метрику при реальной нагрузке и допускает безопасный откат при изменении нагрузки. Это руководство по спекулятивному декодированию LLM — отправная точка для такой дисциплины измерений, а не её замена.