
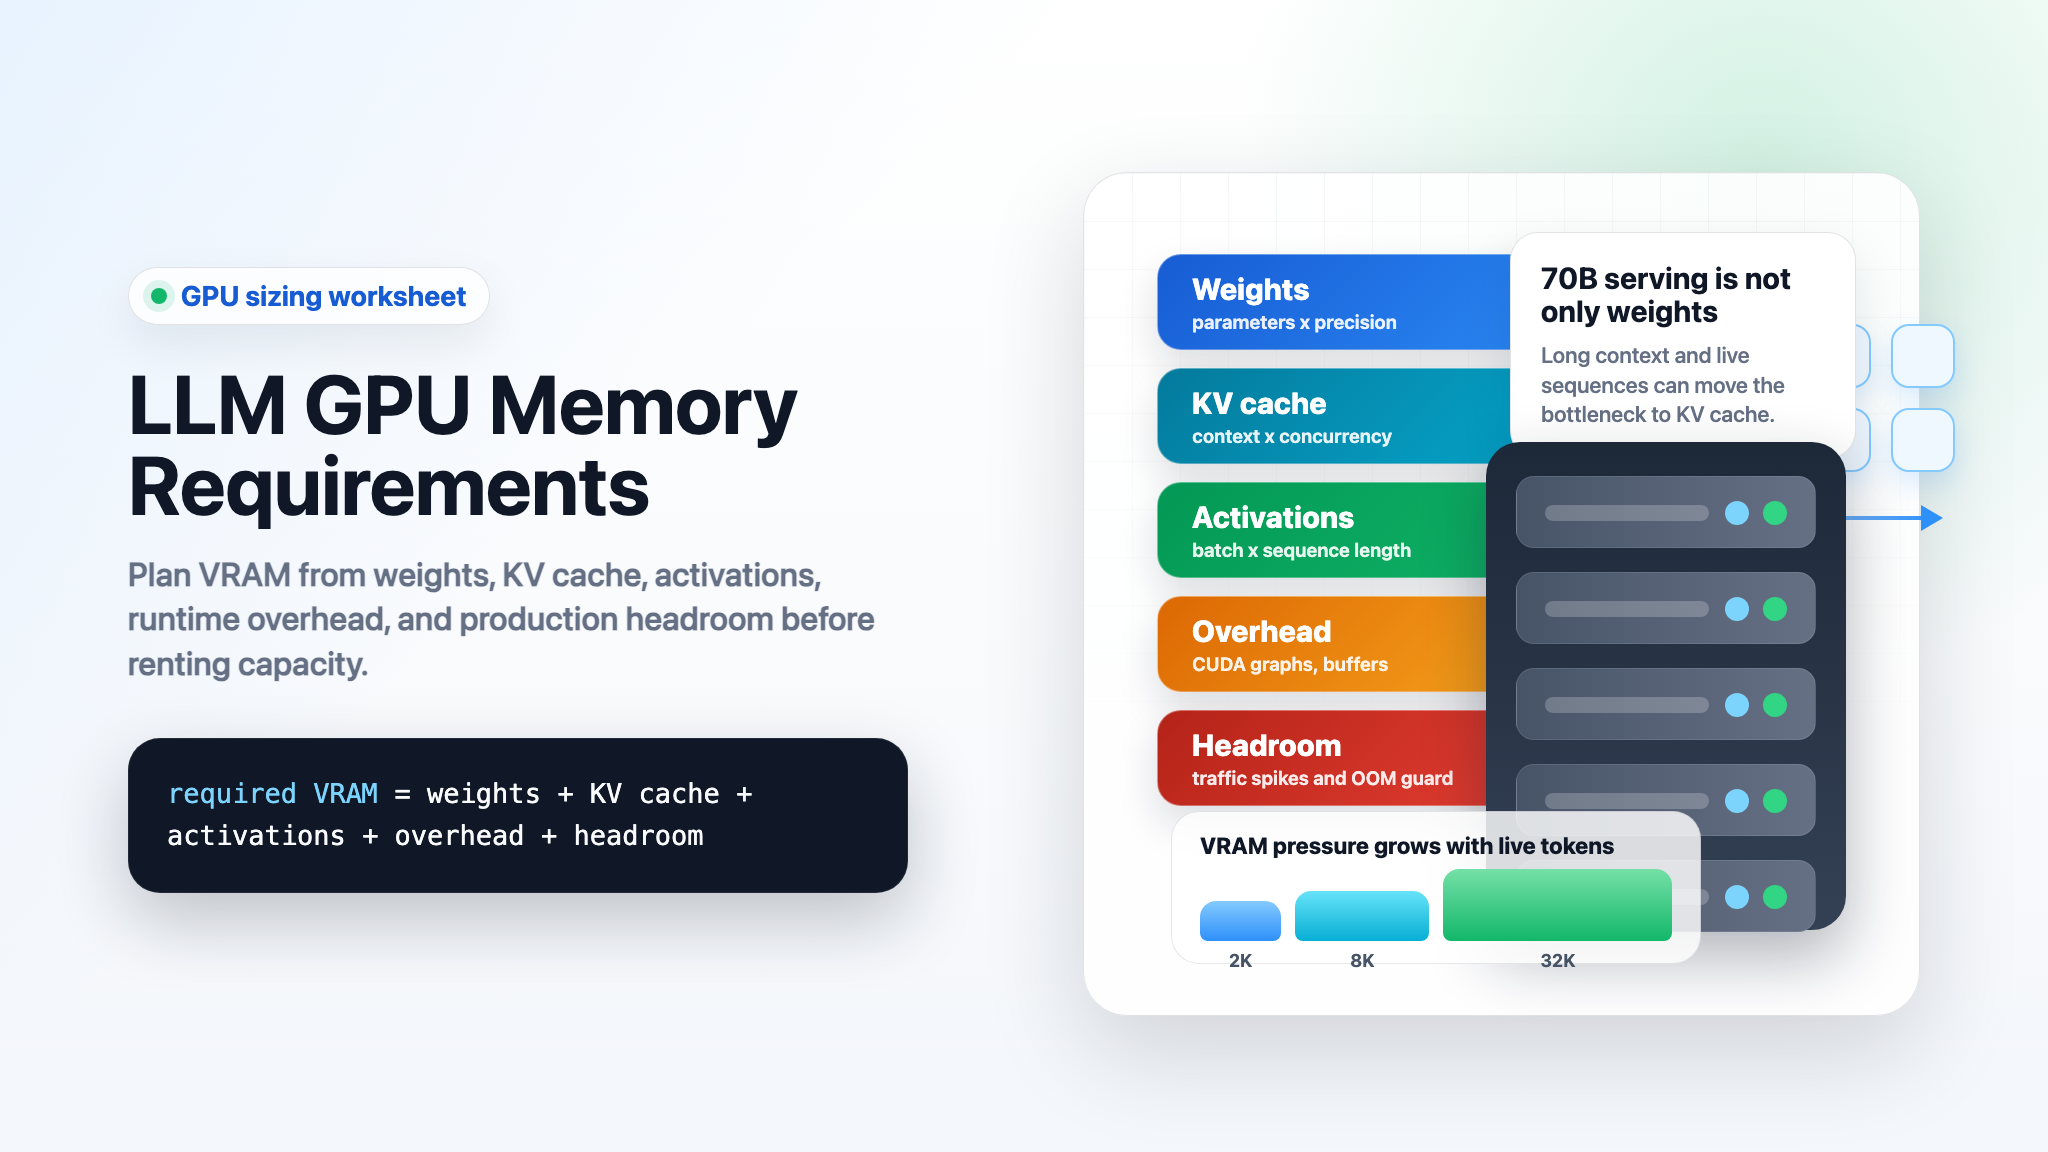
Persyaratan memori GPU LLM bukan sekadar "ukuran model ditambah sedikit ruang." Sebuah pekerjaan serving atau training memiliki beberapa bucket memori terpisah: bobot model, KV cache, aktivasi, workspace framework, CUDA graph, buffer sementara, dan ruang cadangan operasional.
Aturan perencanaan cepatnya adalah sebagai berikut:
memori VRAM yang diperlukan =
  bobot model
+ KV cache untuk token aktif
+ memori aktivasi dan workspace
+ state training, jika training atau fine-tuning penuh
+ ruang cadangan allocator dan keamanan
Itulah sebabnya dua tim dapat menjalankan model 70B yang sama pada kelas GPU yang sama dan melihat hasil yang berbeda. Satu menggunakan prompt pendek, satu stream, KV cache FP8, dan batching yang konservatif. Yang lain menggunakan context panjang, banyak request bersamaan, CUDA graph capture, dan pengaturan gpu_memory_utilization yang tinggi. Pekerjaan pertama muat. Pekerjaan kedua gagal dengan error out-of-memory atau mengalami latensi tinggi karena memindahkan pekerjaan ke tempat lain.
Panduan ini memberikan lembar kerja praktis untuk persyaratan memori GPU llm untuk inference, serving vLLM, fine-tuning, dan training. Gunakan sebelum menyewa GPU, memilih kapasitas H100 versus H200 versus B200, atau memutuskan apakah API model lebih sederhana daripada mengoperasikan endpoint GPU Anda sendiri.
Jawaban cepat persyaratan memori GPU LLM
Untuk inference, mulai dari bobot, lalu tentukan ukuran KV cache dari panjang konteks dan concurrency. Untuk training, bobot hanyalah awalnya; state optimizer, gradient, dan aktivasi yang disimpan mendominasi rencana memori.
| Beban kerja | Apa yang biasanya mendominasi VRAM | Aturan perencanaan cepat |
|---|---|---|
| Inference satu permintaan | Bobot | parameter x byte_per_bobot, lalu tambahkan KV cache untuk prompt dan token yang dihasilkan. |
| Inference throughput tinggi | KV cache dan ruang cadang scheduler | Tentukan ukuran berdasarkan concurrent sequences x tokens per sequence, bukan hanya jumlah parameter model. |
| Serving konteks panjang | KV cache | Melipatgandakan panjang konteks kira-kira melipatgandakan memori KV cache untuk model dan batch yang sama. |
| Fine-tuning penuh | State optimizer, gradient, aktivasi | AdamW presisi campuran dapat memerlukan memori berkali-kali lipat dari memori bobot model sebelum aktivasi. |
| Tuning LoRA atau adapter | Bobot dasar plus aktivasi dan state adapter | Jauh lebih kecil daripada fine-tuning penuh, tetapi konteks panjang dan ukuran batch tetap penting. |
| Pretraining | State training plus aktivasi plus overhead terdistribusi | Rencanakan dari run framework yang terukur; rumus hanya langkah awal. |
Jika Anda hanya membutuhkan output model, bandingkan dulu serving GPU langsung dengan baseline API model. GPU langsung masuk akal ketika Anda membutuhkan bobot kustom, kontrol penempatan, kebijakan runtime privat, atau beban kerja yang lebih murah setelah utilisasi diukur. Jika Anda terutama membutuhkan respons API yang andal, jalur model terkelola dapat menghindari berminggu-minggu pekerjaan sizing GPU, antrean, dan operasional.
Lembar kerja persyaratan memori GPU LLM
Gunakan lembar kerja ini sebelum memilih instance.
| Bucket | Rumus atau pemeriksaan | Catatan |
|---|---|---|
| Bobot | parameter_count x weight_bytes |
BF16/FP16 menggunakan sekitar 2 byte per parameter. INT8 menggunakan sekitar 1 byte. 4-bit menggunakan sekitar 0.5 byte sebelum metadata kuantisasi. |
| KV cache | active_tokens x layers x kv_heads x head_dim x 2 x kv_bytes |
2 adalah untuk key dan value. Grouped-query attention mengurangi kv_heads dibandingkan full multi-head attention. |
| Aktivasi | Inference: biasanya kecil. Training: skala dengan batch, panjang sequence, hidden size, layer, dan pilihan checkpointing. | Anatomi memori model dari Hugging Face menyebutkan bobot, state optimizer, gradient, aktivasi yang disimpan, buffer sementara, dan memori khusus fungsi untuk training. |
| Cadangan framework serving | vLLM, TensorRT-LLM, SGLang, PyTorch, CUDA graphs, kernel attention, antrean penjadwalan | vLLM menyediakan kontrol memori seperti gpu_memory_utilization, kv_cache_memory_bytes, kv_cache_dtype, max_model_len, dan max_num_seqs. |
| Ruang cadang keamanan | 10-20% untuk produksi, lebih banyak selama benchmark awal | Sisakan ruang untuk fragmentasi allocator, lonjakan traffic, prompt yang lebih panjang, pemuatan ulang model, dan agen observability. |
Kesalahan yang paling umum adalah memuat bobot dan melupakan token aktif. Untuk estimasi persyaratan memori GPU inference LLM, KV cache bisa menjadi pembeda antara endpoint yang stabil dan loop OOM.
Langkah 1: hitung memori bobot model
Bobot adalah bagian paling sederhana dari persyaratan memori GPU untuk beban kerja LLM.
weight_memory_gib = parameters x bytes_per_parameter / 1024^3
| Ukuran model | Bobot BF16 / FP16 | Bobot INT8 | Bobot 4-bit sebelum metadata |
|---|---|---|---|
| 7B | ~13.0 GiB | ~6.5 GiB | ~3.3 GiB |
| 13B | ~24.2 GiB | ~12.1 GiB | ~6.1 GiB |
| 34B | ~63.3 GiB | ~31.7 GiB | ~15.8 GiB |
| 70B | ~130.4 GiB | ~65.2 GiB | ~32.6 GiB |
| 405B | ~754.4 GiB | ~377.2 GiB | ~188.6 GiB |
Tabel ini adalah batas bawah. Deployment nyata menambahkan skala kuantisasi, buffer non-parameter, state tokenizer/runtime, temporary workspace, dan overhead serving.
Untuk estimasi vLLM GPU memory requirements 70B model VRAM, bobot BF16/FP16 saja sudah melebihi satu H100 80 GB. Satu H200 memiliki 141 GB HBM3e menurut halaman H200 NVIDIA, jadi bobotnya secara prinsip bisa muat, tetapi KV cache yang tersisa dan headroom runtime masih dapat memaksa konteks yang lebih kecil, konkurensi yang lebih rendah, kuantisasi KV-cache, atau tensor parallelism. NVIDIA mencantumkan H100 SXM pada 80 GB, H200 pada 141 GB, dan DGX B200 sebagai delapan GPU Blackwell dengan total 1.440 GB HBM3e, yang secara efektif berarti 180 GB per GPU B200 dalam sistem tersebut.
Langkah 2: hitung memori KV cache untuk persyaratan memori GPU LLM
KV cache adalah memori yang digunakan untuk menyimpan attention keys dan values bagi token yang sudah diproses. Ini memungkinkan model menghasilkan output tanpa menghitung ulang prefix penuh setiap kali.
Untuk inferensi decoder-only transformer:
kv_cache_bytes =
  active_tokens
x num_layers
x num_kv_heads
x head_dim
x 2
x bytes_per_kv_element
Di mana:
| Variabel | Arti |
|---|---|
active_tokens |
Jumlah prompt dan token yang dihasilkan yang saat ini berada di cache di seluruh request yang aktif. |
num_layers |
Jumlah lapisan transformer. |
num_kv_heads |
KV heads, tidak selalu sama dengan attention heads. Grouped-query attention dapat membuatnya jauh lebih kecil. |
head_dim |
Dimensi per head. |
2 |
Tensor key plus value. |
bytes_per_kv_element |
2 untuk BF16/FP16, 1 untuk FP8, lebih rendah untuk mode cache lower-bit yang didukung. |
Sebagai contoh, bentuk Llama-style 70B dengan 80 lapisan, 8 KV heads, dan dimensi head 128 menggunakan:
80 x 8 x 128 x 2 x 2 bytes = 327,680 bytes per token
Itu sekitar 0,3125 MiB per active token dalam KV cache BF16/FP16.
| Konteks aktif per urutan | Perkiraan KV cache untuk satu urutan | Perkiraan KV cache untuk 16 urutan aktif |
|---|---|---|
| 2.048 token | ~0,6 GiB | ~10,0 GiB |
| 4.096 token | ~1,3 GiB | ~20,0 GiB |
| 8.192 token | ~2,5 GiB | ~40,0 GiB |
| 16.384 token | ~5,0 GiB | ~80,0 GiB |
| 32.768 token | ~10,0 GiB | ~160,0 GiB |
Angka pastinya berubah לפי arsitektur model. Model dengan lebih banyak KV heads menggunakan lebih banyak memori KV. Model dengan multi-query atau grouped-query attention dapat menggunakan jauh lebih sedikit memori KV dibandingkan desain multi-head attention penuh.
vLLM mendokumentasikan beberapa pengaturan yang relevan di sini: --gpu-memory-utilization mengontrol fraksi memori GPU yang digunakan oleh model executor, --kv-cache-memory-bytes dapat menetapkan ukuran KV cache secara eksplisit, --kv-cache-dtype dapat memilih presisi cache, dan panduan conserving-memory merekomendasikan mengurangi max_model_len dan max_num_seqs saat memori terbatas. vLLM juga mendokumentasikan KV cache FP8 sebagai cara untuk mengurangi jejak KV cache dan mendukung konteks yang lebih panjang atau throughput yang lebih tinggi, dengan validasi akurasi tetap diperlukan.
Langkah 3: tambahkan aktivasi dan overhead runtime
Untuk inferensi, memori aktivasi biasanya lebih kecil daripada bobot dan KV cache, tetapi tidak nol. Prefill, CUDA graphs, attention kernels, temporary buffers, multimodal processors, speculative decoding, dan batch scheduling dapat memesan memori tambahan.
Untuk training, memori aktivasi menjadi komponen utama. Anatomi memori model dari Hugging Face mencantumkan komponen memori training sebagai bobot model, state optimizer, gradients, forward activations yang disimpan untuk perhitungan gradien, temporary buffers, dan memori khusus fungsi. Itu juga mencatat bahwa memori aktivasi bergantung pada panjang sequence, ukuran hidden, dan batch size.
Pembagian perencanaan yang berguna adalah:
| Skenario | Pendekatan aktivasi dan overhead |
|---|---|
| Inferensi sederhana, batch 1 | Biarkan setidaknya 10% headroom setelah bobot dan KV cache. |
| Serving vLLM dengan CUDA graphs dan batching | Mulai dengan headroom 15-20%, lalu sesuaikan gpu_memory_utilization, max_model_len, dan max_num_seqs. |
| Serving konteks panjang | Anggap KV cache sebagai variabel utama dan sisihkan headroom lebih besar untuk lonjakan prefill. |
| Fine-tuning | Ukur run kecil pada panjang sequence target sebelum scaling; aktivasi dapat mendominasi saat batch dan konteks membesar. |
| Model multimodal | Tambahkan cache processor dan memori input media; panduan conserving-memory vLLM mencatat cache multimodal dan kontrol batas input. |
Jangan jalankan produksi pada 99% memori hanya karena request uji muat. Itu tidak menyisakan ruang untuk prompt yang lebih panjang, hot reload, capture CUDA graph, perilaku allocator, atau campuran traffic yang berbeda dari benchmark.
Langkah 4: estimasi memori training dan fine-tuning
Memori training lebih besar karena GPU harus menampung lebih dari sekadar bobot forward-pass.
Untuk full fine-tuning dengan mixed precision dan AdamW, anatomi memori Hugging Face memberikan rincian praktis: pelatihan mixed precision dapat menyimpan salinan bobot FP32 dan FP16/BF16, state optimizer AdamW, gradien, aktivasi yang disimpan, buffer sementara, dan memori khusus fungsionalitas. Halaman yang sama merangkum setup AdamW mixed precision yang umum sebagai 18 byte per parameter model ditambah memori aktivasi.
Artinya:
| Ukuran model | 18 byte per parameter sebelum aktivasi |
|---|---|
| 7B | ~117 GiB |
| 13B | ~218 GiB |
| 34B | ~570 GiB |
| 70B | ~1.173 GiB |
Inilah mengapa kueri gpu memory requirements LLM training membutuhkan jawaban yang berbeda dari kueri inference. Model 70B yang bisa disajikan dengan tensor parallelism dan KV cache terkuantisasi tidak otomatis praktis untuk full fine-tuning pada sejumlah kecil GPU.
Cara mengurangi memori pelatihan meliputi:
| Teknik | Apa yang dikurangi | Tradeoff |
|---|---|---|
| LoRA / QLoRA | Memori parameter yang dapat dilatih dan optimizer | Tidak sama dengan full fine-tuning; tetap membutuhkan memori model dasar dan aktivasi. |
| Activation checkpointing | Memori aktivasi yang disimpan | Lebih banyak recomputation dan throughput pelatihan lebih rendah. |
| ZeRO / FSDP / tensor parallelism | Optimizer, gradien, parameter, atau memori komputasi per GPU | Kompleksitas terdistribusi lebih tinggi dan sensitivitas komunikasi. |
| Sequence length lebih pendek | Memori aktivasi dan attention | Dapat menurunkan kualitas tugas jika workload membutuhkan konteks panjang. |
| Micro-batch lebih kecil | Memori aktivasi | Mungkin memerlukan gradient accumulation untuk mempertahankan ukuran batch efektif. |
Untuk pelatihan penuh, formula membawa Anda ke bentuk cluster awal. Formula tidak menggantikan run framework yang diukur.
Langkah 5: petakan persyaratan memori GPU LLM ke ukuran memori GPU yang umum
Gunakan kapasitas memori GPU sebagai batasan, bukan satu-satunya kriteria pembelian. Bandwidth memori, topologi NVLink, networking, storage, scheduling, dan utilisasi bisa sama pentingnya dengan VRAM mentah.
| Kelas GPU | Patokan memori publik | Biasanya berarti apa untuk persyaratan memori GPU LLM |
|---|---|---|
| H100 SXM | 80 GB HBM3 | Default yang kuat untuk serving 7B-34B dan banyak job fine-tuning. 70B BF16 biasanya membutuhkan tensor parallelism atau kuantisasi. |
| H100 NVL | 94 GB per GPU, pasangan 188 GB di halaman H100 NVIDIA | Dirancang untuk inference LLM yang lebih besar di rack enterprise dengan batas daya; tetap validasi topologi dan SKU penyedia. |
| H200 | 141 GB HBM3e | Lebih nyaman untuk bobot model besar dan konteks lebih panjang daripada H100, tetapi serving 70B dengan concurrency tinggi masih bisa terkendala KV-cache. |
| B200 di DGX B200 | Total 1.440 GB di 8 GPU | Kolam memori besar untuk sistem training dan inference enterprise, dengan kebutuhan operasional yang melampaui spesifikasi satu GPU. |
Jika worksheet Anda mengatakan satu H200 "cukup pas" untuk model 70B, itu bukan rencana deployment. Itu adalah sinyal untuk membenchmark pengaturan ini:
| Pengaturan | Mengapa penting |
|---|---|
max_model_len |
Menetapkan batas atas konteks dan dengan demikian KV cache. |
max_num_seqs |
Menetapkan batas atas sequence simultan dan tekanan scheduler. |
kv_cache_dtype |
Dapat mengurangi memori KV cache, tetapi memerlukan pengecekan kualitas. |
| Ukuran tensor parallel | Membagi pekerjaan model di antara GPU; juga mengubah kebutuhan komunikasi. |
| Format kuantisasi | Mengurangi bobot dan terkadang KV cache; dapat memengaruhi kualitas dan dukungan kernel. |
| Target latensi p95 | Pengaturan throughput yang lebih tinggi dapat merugikan latensi meskipun memori cukup. |
Untuk detail pemilihan hardware, gunakan worksheet ini bersama panduan Flatkey GPU terbaik untuk inference LLM, H200 vs H100, dan B200 vs H200.
Contoh: penentuan ukuran inference 70B di vLLM
Berikut cara konservatif untuk menalar vllm gpu memory requirements 70b model vram sebelum Anda menyewa kapasitas.
Asumsikan:
| Input | Nilai |
|---|---|
| Bobot model | 70B parameter |
| Presisi bobot | BF16 / FP16 |
| Memori bobot | ~130.4 GiB |
| Bentuk KV cache | 80 layer, 8 KV head, dimensi head 128 |
| Presisi KV | BF16 / FP16 |
| KV per token aktif | ~0.3125 MiB |
Kemudian bandingkan beberapa bentuk serving:
| Target serving | Perkiraan KV cache | Mengapa ini penting |
|---|---|---|
| 1 sequence aktif, 4K token | ~1.3 GiB | Bobot mendominasi. Satu GPU dengan memori besar mungkin hanya muat dengan headroom rendah. |
| 8 sequence aktif, 4K token | ~10.0 GiB | Memerlukan headroom nyata di luar bobot. |
| 16 sequence aktif, 8K token | ~40.0 GiB | Rencana satu GPU biasanya rapuh kecuali bobot atau KV cache dikuantisasi. |
| 16 sequence aktif, 16K token | ~80.0 GiB | KV cache saja kira-kira setara memori satu H100 SXM. |
Secara operasional, rencana vLLM 70B biasanya masuk ke salah satu jalur berikut:
| Jalur | Kesesuaian |
|---|---|
| Bobot BF16, konkurensi rendah, konteks lebih pendek | Memori kelas H200 mungkin bekerja setelah pemeriksaan overhead. |
| Bobot BF16, konkurensi produksi | Gunakan tensor parallelism dan verifikasi jaringan/topologi. |
| Bobot terkuantisasi, KV cache BF16/FP16 | Benchmark awal yang baik ketika kualitas memungkinkan kuantisasi bobot. |
| Bobot terkuantisasi plus KV cache FP8 | Dapat membuka konteks lebih panjang atau lebih banyak konkurensi, tetapi perlu validasi akurasi dan latensi. |
| Tidak ada kebutuhan kontrol perangkat keras | Bandingkan jalur model API sebelum berkomitmen pada operasi GPU. |
Ini adalah jawaban praktis untuk gpu memory requirements for LLM serving: jumlah parameter memberi tahu apakah model bisa dimuat; KV cache dan cadangan runtime memberi tahu apakah model bisa melayani traffic yang berguna.
Mengapa panjang konteks mengubah jawabannya
Konteks panjang mahal karena cache bertambah seiring token aktif. Jika Anda menggandakan konteks dari 8K ke 16K, KV cache kira-kira ikut berlipat dua untuk model, presisi, dan konkurensi yang sama. Jika Anda menggandakan konkurensi pada konteks yang sama, KV cache kira-kira berlipat dua lagi.
Bagi tim yang membandingkan rencana llm hardware requirements gpu memory, ini menciptakan pola sizing yang sederhana:
lebih banyak pengguna x prompt lebih panjang x lebih banyak token output = lebih banyak KV cache
Sebelum menyewa GPU yang lebih besar, tanyakan apakah produk benar-benar membutuhkan konteks maksimum untuk setiap permintaan. Banyak sistem dapat merutekan:
| Jenis permintaan | Kebijakan penghemat memori |
|---|---|
| Chat singkat atau ekstraksi | Batas konteks lebih kecil, konkurensi lebih tinggi. |
| Analisis dokumen panjang | Batas konteks lebih besar, pool konkurensi lebih rendah. |
| Job batch | Antre berdasarkan anggaran token, bukan hanya jumlah permintaan. |
| Workload premium | Pool khusus dengan konteks maksimum eksplisit dan target p95. |
Ini sering kali lebih murah dan lebih stabil daripada menjalankan satu endpoint raksasa dengan satu pengaturan memori global.
Apa yang harus diukur pada benchmark pertama
Jalankan benchmark yang menyerupai traffic produksi, bukan satu prompt jalur bahagia.
| Metrik | Mengapa metrik ini perlu dalam benchmark pertama |
|---|---|
| VRAM teralokasi dan terreservasi puncak | Mendeteksi headroom allocator dan framework, bukan hanya matematika tensor. |
| Latensi prefill | Prompt panjang menekan bandwidth memori dan kernel attention. |
| Decode token per detik | Menunjukkan throughput generasi steady-state. |
| Latensi p95 dan p99 | Mencegah konfigurasi yang hanya mengejar throughput tetapi merugikan pengguna. |
| Rasio OOM | Melacak kegagalan memori pada campuran traffic nyata. |
| Penggunaan KV cache | Menjelaskan apakah konteks/konkurensi atau bobot yang menjadi bottleneck. |
| Biaya output yang diterima | Menghubungkan biaya sewa GPU dengan completion yang bisa dipakai, bukan token mentah. |
Untuk deployment multi-node, padukan ini dengan checklist arsitektur cluster GPU dan TCO cluster GPU. Model yang muat secara memori tetap bisa mahal jika jaringan, storage, antrian, atau utilisasi buruk.
Kesalahan umum
| Kesalahan | Pendekatan yang lebih baik |
|---|---|
| Mengukur hanya dari jumlah parameter | Tambahkan KV cache, aktivasi, cadangan framework, dan headroom. |
| Menganggap "muat sekali" sebagai siap produksi | Uji konteks target, konkurensi, panjang output, dan perilaku retry. |
| Mengabaikan presisi KV cache | Validasi FP8 atau format cache lain ketika memori menjadi bottleneck. |
| Menggunakan nama GPU dari provider tanpa SKU yang tepat | Konfirmasikan kapasitas memori, interkoneksi, kebijakan MIG, stack driver, dan apakah GPU dibagi. |
| Mengasumsikan memori training sama dengan memori inference | Training menambah state optimizer, gradien, activations tersimpan, dan overhead terdistribusi. |
Menjalankan gpu_memory_utilization terlalu agresif |
Biarkan cadangan yang cukup untuk CUDA graphs, buffer, lonjakan traffic, dan perilaku allocator. |
Panduan keputusan: sewa GPU atau gunakan model API?
Kapasitas GPU langsung adalah arah yang tepat ketika Anda membutuhkan satu atau lebih dari hal berikut ini:
| Pilih GPU langsung ketika... | Pilih baseline API model ketika... |
|---|---|
| Anda melayani bobot kustom atau fine-tune privat. | Anda menggunakan model hosted umum dan terutama membutuhkan output yang andal. |
| Anda memerlukan penempatan, isolasi, atau kontrol runtime. | Anda tidak ingin mengelola antrean, autoscaling, image, driver, dan kegagalan GPU. |
| Pemanfaatan yang Anda ukur cukup tinggi untuk mengalahkan ekonomi API. | Lalu lintas bersifat bursty, masih awal, atau sulit diprediksi. |
| Anda dapat menangani benchmarking dan respons insiden sendiri. | Tim Anda lebih memilih menghabiskan waktu engineering pada logika produk. |
Flatkey berguna sebagai jalur baseline ketika kontrol hardware bukan kebutuhan produk. Ini memberi tim satu keseimbangan di seluruh model dan tools resmi, sehingga Anda bisa membandingkan biaya sewa GPU dengan biaya output API model sebelum berkomitmen pada klaster yang berjalan lama. Jika benchmark membuktikan GPU langsung menang, gunakan lembar kerja memori di atas untuk menyewa bentuk terkecil yang andal alih-alih yang terbesar dan paling mengesankan.
Pertanyaan yang sering diajukan
Berapa banyak memori GPU yang dibutuhkan LLM 70B?
Bobot BF16 atau FP16 untuk model 70B membutuhkan sekitar 130 GiB sebelum KV cache dan overhead runtime. Bobot INT8 sekitar 65 GiB sebelum metadata. Bobot 4-bit sekitar 33 GiB sebelum metadata kuantisasi. Untuk inferensi produksi, tambahkan KV cache untuk konteks dan konkurensi, reserve framework serving, serta cadangan keamanan.
Mengapa model berhasil dimuat tetapi gagal saat menerima trafik?
Uji muat mungkin hanya muat untuk bobot. Trafik nyata menambahkan KV cache untuk prompt aktif dan token yang dihasilkan, overhead batching, buffer sementara, dan reserve framework. Prompt yang lebih panjang dan lebih banyak sequence konkuren dapat mendorong model yang sama ke OOM.
Apa yang paling memengaruhi kebutuhan memori GPU untuk inferensi LLM?
Variabel terbesar adalah ukuran model, presisi bobot, panjang konteks, sequence konkuren, presisi KV cache, dan pengaturan framework serving. Untuk serving konteks panjang, KV cache sering menjadi bottleneck.
Apa yang memengaruhi kebutuhan hardware LLM untuk memori GPU saat pelatihan?
Pelatihan menambahkan state optimizer, gradients, aktivasi yang disimpan, buffer sementara, dan overhead framework terdistribusi. Ukuran batch, panjang sequence, activation checkpointing, pilihan optimizer, dan strategi sharding dapat mengubah jumlah GPU secara dramatis.
Apakah vLLM mengurangi kebutuhan memori GPU?
vLLM memberikan kontrol memori yang berguna dan manajemen KV-cache yang efisien, tetapi tidak menghilangkan anggaran memori yang mendasarinya. Anda tetap membutuhkan VRAM yang cukup untuk bobot, KV cache, aktivasi, reserve runtime, dan headroom. Kontrol memorinya membantu Anda memilih trade-off antara panjang konteks, konkurensi, presisi, dan throughput.
Apakah KV cache FP8 dapat mengatasi tekanan memori konteks panjang?
Itu dapat mengurangi footprint KV cache, dan vLLM mendokumentasikan dukungan KV cache FP8. Anggap ini sebagai pengaturan benchmark, bukan sakelar gratis: validasi kualitas output, latensi, jalur hardware/software yang didukung, dan perilaku kegagalan sebelum menggunakannya di produksi.
Daftar periksa akhir
Sebelum Anda menyewa kapasitas, jawab pertanyaan-pertanyaan ini:
- Berapa ukuran model dan presisi bobot yang Anda layani?
- Berapakah panjang konteks maksimum yang benar-benar dapat dikirim pengguna?
- Berapa banyak sequence konkuren yang harus muat pada beban p95?
- Berapa panjang output yang Anda cadangkan untuk generasi?
- Apakah KV cache menggunakan BF16/FP16, FP8, atau format lain yang didukung?
- Berapa headroom yang tersisa setelah bobot dan KV cache?
- Apakah Anda menggunakan tensor parallelism, kuantisasi, LoRA, FSDP, atau ZeRO?
- SKU GPU, kapasitas memori, dan topologi apa yang tepat akan dialokasikan penyedia?
- Ambang OOM, latensi, dan biaya per output yang diterima apa yang mendefinisikan keberhasilan?
- Jika Anda tidak memerlukan kontrol hardware, berapa biaya baseline API model?
Perkiraan llm gpu memory requirements terbaik adalah yang tetap bertahan pada benchmark yang menyerupai produksi. Gunakan lembar kerja untuk menolak bentuk GPU yang mustahil dengan cepat, lalu validasi daftar pendek dengan panjang konteks nyata, konkurensi nyata, dan headroom yang cukup agar tetap online.
Sumber
- Argumen engine vLLM:
gpu_memory_utilization,kv_cache_memory_bytes,kv_cache_dtype, dan kontrol cache terkait: https://docs.vllm.ai/en/latest/configuration/engine_args.html - Panduan penghematan memori vLLM: tensor parallelism, kuantisasi, panjang konteks, ukuran batch, memori CUDA graph, dan kontrol memori multimodal: https://docs.vllm.ai/en/latest/configuration/conserving_memory/
- Panduan KV cache terkuantisasi vLLM: opsi dan trade-off KV cache FP8: https://docs.vllm.ai/en/latest/features/quantization/quantized_kvcache.html
- Anatomi memori model Hugging Face Transformers: bucket memori pelatihan, state optimizer, gradients, aktivasi, dan catatan memori mixed-precision: https://huggingface.co/docs/transformers/v4.57.1/en/model_memory_anatomy
- Halaman produk NVIDIA H100: memori H100, bandwidth, H100 NVL, dan positioning LLM: https://www.nvidia.com/en-us/data-center/h100/
- Halaman produk NVIDIA H200: 141 GB HBM3e dan bandwidth memori: https://www.nvidia.com/en-us/data-center/h200/
- Halaman produk NVIDIA DGX B200: delapan GPU B200 dan total 1.440 GB HBM3e: https://www.nvidia.com/en-us/data-center/dgx-b200/


