LLM Rate Limits Explained: RPM, TPM, and Retries adalah topik keandalan produksi terlebih dahulu sebelum menjadi pengaturan SDK. Batas laju menentukan berapa banyak request, token, job, atau generasi simultan yang dapat aplikasi Anda lewatkan melalui provider atau gateway dalam jendela waktu tertentu. Retry menentukan apa yang terjadi ketika batas tercapai. Kebijakan retry yang salah dapat mengubah lonjakan kecil menjadi gangguan berkepanjangan.
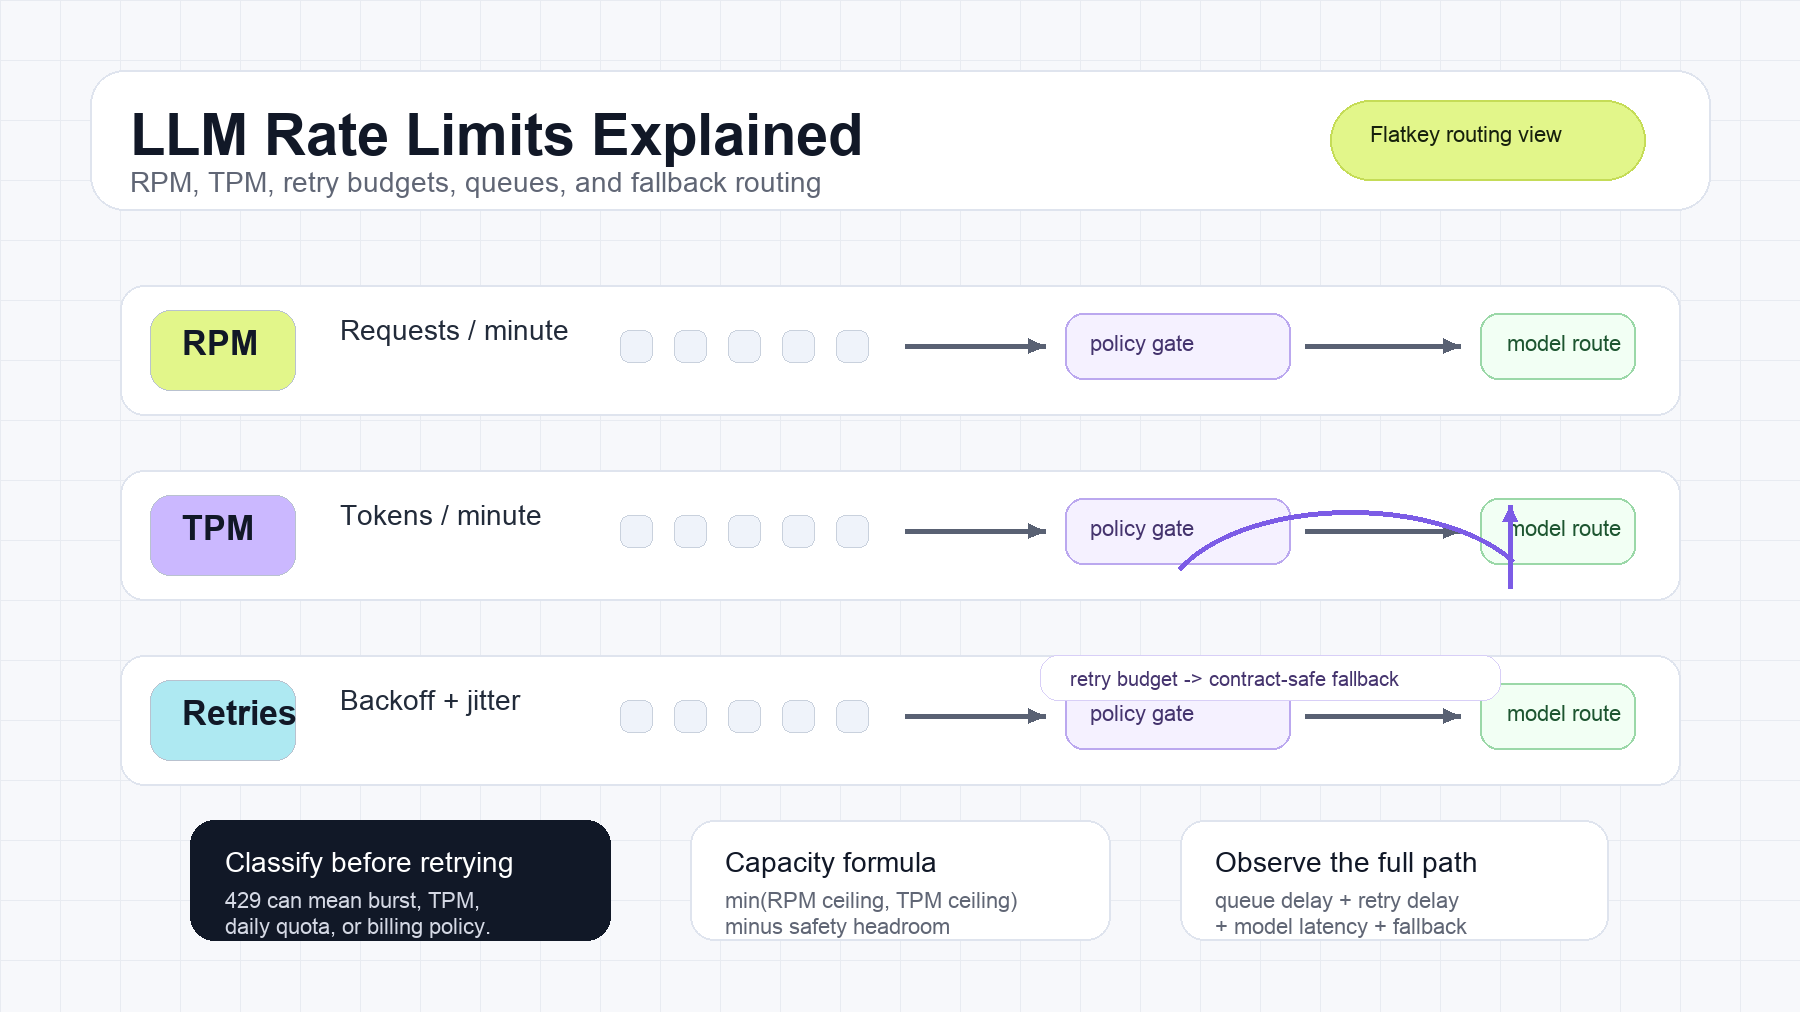
Aturan praktisnya sederhana: RPM mengontrol frekuensi request, TPM mengontrol throughput token, concurrency mengontrol pekerjaan yang sedang berjalan, dan retry menghabiskan kapasitas langka yang sama kecuali jika dibatasi. Sistem produksi harus mengklasifikasikan resource yang terkendala terlebih dahulu, lalu memilih antara pacing, queueing, mengurangi token, retry singkat, atau merutekan ke model lain yang kompatibel secara kontrak.
Panduan ini memperlakukan LLM Rate Limits Explained: RPM, TPM, and Retries sebagai playbook operasional untuk tim produk dan platform AI. Panduan ini mencakup istilah, matematika kapasitas, kebijakan retry, field observability, dan kontrol gateway gaya Flatkey yang mencegah batas laju API LLM menjadi insiden pelanggan.
Jawaban Singkat LLM Rate Limits Explained: RPM, TPM, and Retries
Gunakan tabel ini saat Anda melakukan triase insiden batas laju LLM.
| Sinyal | Apa yang Diukur | Gejala Umum | Kontrol Pertama |
|---|---|---|---|
| RPM | Request yang diterima per menit atau jendela yang ditentukan provider | Banyak panggilan kecil gagal dengan 429 |
Atur laju request, antre lonjakan, batch tugas kecil |
| TPM | Token input dan/atau output yang diterima per menit atau jendela | Prompt panjang, output panjang, atau run evaluasi ter-throttle | Cadangkan token, pendekkan konteks, batasi output |
| RPD / TPD | Request atau token yang diterima per hari | Pekerjaan berhenti sampai kuota di-reset | Hentikan retry, jadwalkan ulang, minta tier yang lebih tinggi |
| Concurrency | Request atau job yang sedang berjalan sekaligus | Generasi yang lambat menumpuk bahkan pada RPM yang moderat | Batasi worker, tambahkan backpressure |
| Retry budget | Seberapa banyak pekerjaan tambahan yang boleh dihabiskan pemanggil setelah gagal | Retry storm, latensi membengkak, side effect duplikat | Batasi percobaan, waktu berlalu, dan status yang dapat di-retry |
| Fallback route | Model atau provider alternatif yang memenuhi syarat | Rute utama terkendala tetapi produk masih memerlukan output | Rutekan hanya jika kemampuan, kebijakan, dan biaya sesuai |
LLM Rate Limits Explained: RPM, TPM, and Retries bermuara pada satu keputusan operasional: jangan melakukan retry secara membabi buta. 429 bukan perintah untuk segera mengirim request yang sama lagi. Itu adalah sinyal bahwa satu bucket kapasitas, kebijakan kuota, status penagihan, atau mekanisme proteksi provider menolak request tersebut.
Mengapa Batas Laju Ada
Provider menerapkan batas laju API LLM untuk melindungi kapasitas bersama, mencegah akun yang lepas kendali, dan menjaga konsistensi kebijakan billing atau service-tier. OpenAI, Anthropic, dan Gemini semuanya mendokumentasikan konsep batas laju, tetapi mereka mengekspos nama bucket, scope, header, dan dashboard yang berbeda. OpenAI mendokumentasikan batas laju dan menyarankan klien menangani error batas dengan backoff. Anthropic mendokumentasikan batas belanja organisasi dan workspace plus batas laju level model yang dapat mencakup request dan token. Gemini mendokumentasikan tier dengan konsep batas request, token, dan harian.
Kontrol provider tersebut diperlukan, tetapi itu bukan kebijakan produk yang lengkap. Biasanya mereka menjawab pertanyaan di sisi provider: “Apakah project ini dapat mengirim traffic lebih banyak sekarang?” Aplikasi Anda masih perlu menjawab pertanyaan di sisi produk:
- Customer, workspace, tim, atau fitur mana yang menyebabkan lonjakan?
- Resource yang terkendala adalah request, token input, token output, concurrency, kuota harian, atau belanja?
- Apakah workload ini harus menunggu, menurun kualitasnya, diturunkan skalanya, atau gagal cepat?
- Apakah fallback route diizinkan oleh kemampuan, kebijakan data, harga, dan kontrak pelanggan?
- Apakah retry justru memperburuk batas?
Untuk kontrol kuota yang berdekatan, padukan artikel ini dengan manajemen kuota AI API dan manajemen belanja AI API.
RPM, TPM, Dan Concurrency Adalah Batas yang Berbeda
Tim sering memperlakukan batas laju sebagai satu angka. Itu menyembunyikan bottleneck yang sebenarnya.
RPM: Request Per Menit
RPM membatasi jumlah request yang diterima selama jendela waktu yang ditentukan provider. Prompt kecil, health check, loop tool agen, dan job evaluasi dengan fanout tinggi biasanya menekan RPM terlebih dahulu. Workload bisa jauh di bawah TPM tetapi tetap kena RPM jika mengirim terlalu banyak panggilan kecil.
TPM: Token Per Menit
TPM membatasi throughput token. Bergantung pada provider dan model, batas ini dapat mempertimbangkan token input, token output, token yang di-cache, atau bucket input dan output terpisah. Retrieval konteks panjang, riwayat percakapan, output yang verbose, generasi multi-kandidat, dan evaluasi paralel biasanya menekan TPM sebelum RPM.
Concurrency: Pekerjaan yang Sedang Berjalan
Concurrency bukan RPM. Sistem dapat hanya mengirim 60 request per menit tetapi tetap memiliki concurrency tinggi jika setiap generasi memakan waktu 20 detik. Streaming dan tool call yang berjalan lama membuat hal ini terlihat. Membatasi worker pool dan kedalaman antrean biasanya merupakan kontrol yang lebih baik daripada menambah retry.
Batas Harian Dan Batas Belanja
Beberapa batas tidak pulih setelah tidur singkat. Batas permintaan harian, batas token harian, batas pengeluaran bulanan, dan pembatasan penagihan biasanya harus menghentikan retry. Tindakan yang tepat adalah menjadwalkan ulang, menaikkan tier, menyesuaikan anggaran, atau memberi tahu pengguna bahwa kapasitas telah habis.
Mengapa Anda Bisa Mendapat 429 Di Bawah Batas Utama
Batas yang dipublikasikan seperti “1.000 RPM” jarang berarti klien dapat mengirim 1.000 permintaan pada detik pertama dalam satu menit. Penyedia dapat menerapkan rolling window, token bucket, pool model, aturan burst khusus tier, batas akselerasi, atau kuota proyek bersama.
Sebuah permintaan dapat menerima 429 Too Many Requests meskipun penghitung lokal terlihat aman karena:
- Beberapa worker, pengguna, layanan, atau lingkungan berbagi batas akun yang sama.
- Token input dan output dihitung dalam bucket yang berbeda.
- Satu model memiliki pool yang lebih sempit daripada model lain.
- Retry dari kegagalan sebelumnya masih mengonsumsi kapasitas permintaan.
- Peningkatan trafik terlalu curam untuk kontrol akselerasi.
- Aturan harian, pengeluaran, workspace, atau tier layanan sedang aktif.
- Penyedia mengembalikan
429generik untuk beberapa kebijakan kapasitas.
Inilah sebabnya Penjelasan Batas Laju LLM: RPM, TPM, dan Retry harus dimulai dengan klasifikasi, bukan kode. Catat kode status, jenis error penyedia, header respons, model, akun atau proyek, perkiraan token, token aktual, nomor percobaan, penundaan antrean, dan ID permintaan penyedia jika tersedia.
Rumus Perencanaan Kapasitas
Mulailah dengan batas independen untuk permintaan dan token, lalu operasikan di bawah maksimum.
request_ceiling = RPM * safety_factor

token_ceiling = (TPM * safety_factor) / average_total_tokens_per_request

safe_requests_per_minute = min(request_ceiling, token_ceiling)
Gunakan faktor keamanan seperti 0.70 hingga 0.90 bergantung pada varians token, konsumen bersama, perilaku retry, dan seberapa mahal target latensi yang terlewat.
Contoh:
RPM = 1,000
TPM = 2,000,000
average_total_tokens_per_request = 4,000
safety_factor = 0.80

request_ceiling = 1,000 * 0.80 = 800 requests/minute

token_ceiling = (2,000,000 * 0.80) / 4,000 = 400 requests/minute

safe_requests_per_minute = min(800, 400) = 400 requests/minute
Dalam contoh ini, TPM adalah batas yang mengikat. Menambah lebih banyak worker tidak akan meningkatkan throughput yang berkelanjutan. Itu akan menciptakan lebih banyak antrean, lebih banyak retry, atau lebih banyak error 429.
Untuk sistem online, terjemahkan laju permintaan aman menjadi titik awal concurrency:
target_concurrency ~= requests_per_second * average_request_seconds
Jika laju aman adalah 400 permintaan per menit, itu sekitar 6,67 permintaan per detik. Jika latensi model rata-rata 3 detik, concurrency awalnya sekitar 20. Lakukan tuning terhadap latensi p95 dan p99, bukan hanya rata-rata.
Reservasi Token Untuk Keamanan TPM
Insiden TPM sering berasal dari penjadwalan yang terlalu optimistis. Aplikasi menerima pekerjaan berdasarkan token yang diharapkan, tetapi model menghasilkan output yang lebih panjang dari yang direncanakan.
Scheduler yang lebih aman mencadangkan token sebelum mengirim permintaan:
reservation:
  workload: support_answer
  model_route: primary_chat_route
  request_id: req_8f3a
  estimated_input_tokens: 3200
  max_output_tokens: 900
  reserved_total_tokens: 4100
  reservation_expires_at: 2026-10-10T11:03:00Z
Setelah respons, rekonsiliasikan token yang dicadangkan dengan token aktual:
actual_usage:
  input_tokens: 3014
  output_tokens: 622
  total_tokens: 3636
  retry_attempts: 0
  accepted_result: true
Cadangkan berdasarkan p95 atau estimasi khusus beban kerja untuk produksi. Gunakan penggunaan aktual untuk atribusi biaya dan peramalan. Pemisahan itu membuat batas laju API LLM lebih mudah dioperasikan: kontrol penerimaan menggunakan estimasi aman, sementara keuangan dan produk meninjau biaya aktual per hasil yang diterima.
Pohon Keputusan Batas Laju
Ketika permintaan ditolak atau antrean membesar, tentukan kontrol berdasarkan penyebabnya.
Apakah penyedia mengembalikan Retry-After atau header reset?
  yes -> tunggu petunjuknya jika sesuai dengan anggaran latensi pemanggil
  no  -> gunakan exponential backoff terbatas dengan jitter untuk kelas sementara

Apakah penyebabnya kuota harian, penagihan, izin, atau batas pengeluaran keras?
  yes -> jangan retry; gagal, jadwalkan ulang, atau minta kapasitas
  no  -> lanjutkan

Apakah RPM adalah batas yang mengikat?
  yes -> atur tempo permintaan, batch pekerjaan kecil, atau antrekan trafik prioritas rendah
  no  -> lanjutkan

Apakah TPM adalah batas yang mengikat?
  yes -> pendekkan konteks, batasi output, cadangkan token, atau tunda pekerjaan panjang
  no  -> lanjutkan

Apakah concurrency adalah batas yang mengikat?
  yes -> kurangi worker, tetapkan tenggat antrean, dan terapkan backpressure
  no  -> lanjutkan

Apakah rute fallback yang memenuhi syarat sehat dan disetujui kebijakan?
  yes -> alihkan setelah anggaran retry habis
  no  -> kembalikan kegagalan yang terkontrol
Pohon keputusan ini adalah aset bernilai untuk Penjelasan Batas Laju LLM: RPM, TPM, dan Retry. Ini mencegah penanganan 429 menjadi loop tanpa batas, dan mengubah Penjelasan Batas Laju LLM: RPM, TPM, dan Retry dari topik definisi menjadi alur kerja respons insiden.
Cara Menggunakan Retry-After
HTTP Retry-After memberi tahu klien berapa lama harus menunggu sebelum melakukan permintaan lain. RFC mendefinisikannya sebagai penundaan dalam detik atau tanggal HTTP. Referensi 429 Too Many Requests di MDN juga menjelaskan penggunaan Retry-After untuk menunjukkan kapan klien boleh mencoba lagi.
Aturan praktis:
- Hormati
Retry-Afteryang valid ketika sesuai dengan anggaran latensi pemanggil. - Batasi nilai yang sangat lama untuk panggilan interaktif; jangan membiarkan permintaan pengguna terbuka selamanya.
- Perlakukan nilai yang tidak valid atau hilang sebagai alasan untuk menggunakan backoff di sisi klien.
- Jangan mencoba lagi penyebab yang tidak dapat di-retry hanya karena
Retry-Aftertidak ada. - Catat petunjuk dari penyedia dan penundaan aktual yang digunakan.
Untuk alur pengguna interaktif, anggaran retry sering kali lebih kecil daripada petunjuk penyedia. Dalam kasus itu, gagal cepat dengan pesan yang berguna atau arahkan ke tempat lain. Untuk pekerjaan batch, antrian mungkin lebih baik daripada mengembalikan error.
Exponential Backoff Dengan Jitter
Exponential backoff meningkatkan penundaan setelah setiap percobaan yang gagal. Jitter mengacak penundaan itu agar pekerja tidak tersinkronisasi dan mencoba lagi bersamaan. Panduan backoff dan jitter dari AWS berguna karena menjelaskan mengapa exponential backoff berkapasitas terbatas yang polos masih bisa membuat retry bergerombol tanpa keacakan.
Rumus full-jitter yang umum:
delay_ms = random(0, min(cap_ms, base_ms * 2^attempt))
Kebijakan retry produksi membutuhkan lebih dari sekadar rumus penundaan:
| Field Kebijakan | Kontrol yang Direkomendasikan |
|---|---|
| Status yang dapat di-retry | 429, 5xx tertentu, dan kegagalan jaringan sementara |
| Status yang tidak dapat di-retry | kesalahan validasi, kesalahan autentikasi, kesalahan izin, kesalahan penagihan, habisnya kuota harian |
| Jumlah percobaan maksimum | Jumlah kecil untuk panggilan interaktif; lebih besar hanya untuk pekerjaan offline |
| Waktu berjalan maksimum | Dibatasi oleh anggaran latensi yang terlihat oleh pengguna atau tenggat pekerjaan |
| Jitter | Wajib untuk sistem multi-worker |
| Retry-After | Gunakan jika valid dan terjangkau |
| Cancellation | Hentikan segera saat pemanggil membatalkan |
| Observability | Jumlah percobaan, waktu tunggu, status akhir, request ID, penundaan antrean |
Permintaan yang tidak berhasil tetap dapat mengonsumsi kapasitas batas laju. Karena itu retry harus menjadi bagian dari perencanaan batas laju, bukan pemikiran belakangan.
TypeScript Retry Helper Untuk OpenAI-Compatible APIs
Helper ini menggunakan Retry-After saat tersedia, jika tidak full jitter. Helper berhenti ketika jumlah percobaan atau waktu berjalan habis.
type ChatRequest = {
  model: string;
  messages: Array<{ role: "system" | "user" | "assistant"; content: string }>;
  max_tokens?: number;
};

const sleep = (milliseconds: number) =>
  new Promise((resolve) => setTimeout(resolve, milliseconds));

function retryAfterMilliseconds(response: Response): number | null {
  const value = response.headers.get("retry-after");
  if (!value) return null;

  const seconds = Number(value);
  if (Number.isFinite(seconds)) return Math.max(0, seconds * 1_000);

  const date = Date.parse(value);
  return Number.isNaN(date) ? null : Math.max(0, date - Date.now());
}

export async function createChatCompletion(
  apiKey: string,
  request: ChatRequest,
  options: { maxAttempts?: number; maxElapsedMs?: number } = {},
) {
  const maxAttempts = options.maxAttempts ?? 4;
  const maxElapsedMs = options.maxElapsedMs ?? 30_000;
  const startedAt = Date.now();

  for (let attempt = 0; attempt < maxAttempts; attempt += 1) {
    const response = await fetch("https://router.flatkey.ai/v1/chat/completions", {
      method: "POST",
      headers: {
        Authorization: `Bearer ${apiKey}`,
        "Content-Type": "application/json",
      },
      body: JSON.stringify(request),
    });

    if (response.ok) return response.json();

    const retryable = response.status === 429 || response.status >= 500;
    const finalAttempt = attempt === maxAttempts - 1;
    if (!retryable || finalAttempt) {
      throw new Error(`LLM request failed with ${response.status}: ${await response.text()}`);
    }

    const serverDelay = retryAfterMilliseconds(response);
    const exponentialCap = Math.min(8_000, 500 * 2 ** attempt);
    const jitteredDelay = Math.random() * exponentialCap;
    const delayMs = serverDelay ?? jitteredDelay;

    if (Date.now() + delayMs - startedAt >= maxElapsedMs) {
      throw new Error("LLM retry budget exhausted");
    }

    await sleep(delayMs);
  }

  throw new Error("Unreachable retry state");
}
Tambahkan timeout permintaan, kelas error terstruktur, telemetri, dan cancellation sebelum penggunaan produksi. Jika panggilan dapat menimbulkan efek samping eksternal, buat operasi bisnis idempotent sebelum mencoba lagi.
Retry, Antrekan, Kurangi, atau Alihkan Rute?
Sistem yang tangguh memiliki lebih dari satu respons terhadap throttling.
| Situasi | Retry | Antrian | Kurangi Token | Arahkan ke Tempat Lain |
|---|---|---|---|---|
Satu 429 transient yang singkat |
Ya, dibatasi | Opsional | Tidak | Biasanya tidak |
| Kehabisan RPM yang berkelanjutan | Sangat terbatas | Ya | Biasanya tidak | Terkadang |
| Kehabisan TPM yang berkelanjutan | Sangat terbatas | Ya | Ya | Terkadang |
| Kouta harian habis | Tidak | Hanya jika reset di kemudian hari dapat diterima | Tidak | Mungkin |
| Error penagihan atau izin | Tidak | Tidak | Tidak | Tidak, perbaiki akses terlebih dahulu |
| Kelebihan beban provider dengan fallback yang sehat | Singkat | Opsional | Tidak | Ya, setelah pemeriksaan kebijakan |
| Partial stream sudah terkirim | Biasanya tidak ada replay | Mungkin lanjut atau mulai ulang secara eksplisit | Mungkin | Hanya dengan semantik yang jelas |
Antrian melindungi provider dan pengalaman pengguna ketika pekerjaan bisa menunggu. Pengurangan token melindungi TPM. Routing melindungi ketersediaan hanya ketika jalur alternatif memenuhi kontrak produk yang sama.
Untuk pola khusus overload, gunakan playbook API Error 529 overloaded. Untuk implikasi biaya, hubungkan perilaku retry dan fallback dengan harga AI gateway dan cara membandingkan harga model AI.
Batas Laju dalam Evaluasi Model
Batas laju dapat membatalkan perbandingan model.
Jika model A diuji dengan 10 worker dan model B dengan 100 worker, model B mungkin terlihat lebih lambat karena harness menyebabkan antrian dan retry. Pengukuran itu lebih banyak berbicara tentang konfigurasi pengujian daripada latensi model.
Untuk evaluasi yang dapat dipertanggungjawabkan:
- Pisahkan latensi model, delay antrian, dan delay retry.
- Gunakan proses kedatangan yang sama atau level utilisasi yang dinormalisasi untuk setiap rute.
- Panaskan traffic secara bertahap saat provider menggunakan kontrol akselerasi.
- Rekam token dan percobaan per tugas yang selesai.
- Laporkan tingkat keberhasilan percobaan pertama dan tingkat keberhasilan akhir secara terpisah.
- Bandingkan biaya per tugas yang diterima, bukan hanya harga token.
- Jalankan pengujian overload secara terpisah dari pengujian kualitas.
Ini terutama penting untuk akun gratis atau level rendah. Artikel free LLM APIs berguna sebagai konteks karena batas gratis sering dirancang untuk eksplorasi, bukan beban produksi.
Metrik yang Perlu Di-Alert
Lacak hal-hal berikut berdasarkan provider, model, rute, tenant, workload, dan lingkungan:
- Request per menit.
- Input token per menit dan output token per menit.
- Estimasi token yang dicadangkan versus token aktual yang digunakan.
- Kedalaman antrian dan usia item tertua di antrian.
- Waktu menunggu kapasitas rate.
- Tingkat keberhasilan percobaan pertama.
- Percobaan retry per request yang berhasil.
- Tingkat
429berdasarkan penyebab yang diklasifikasikan. - Amplifikasi retry: total percobaan dibagi hasil yang berhasil.
- Tingkat fallback dan hasil fallback.
- Latensi end-to-end p50, p95, dan p99.
- Biaya per tugas yang berhasil atau diterima.
Semantic convention generative AI dari OpenTelemetry dapat membantu menstandarkan telemetry model, operasi, token, respons, dan error. Tetap sertakan dimensi spesifik produk juga: pelanggan, workspace, kelas traffic, lingkungan, fitur, dan pemilik.
Alert pada total jumlah 429 saja bersifat berisik. Sinyal yang lebih baik menggabungkan tingkat throttling, usia antrian, amplifikasi retry, dan tingkat kegagalan akhir.
Arsitektur Batas Laju Produksi
Jalur request yang tangguh biasanya memiliki tujuh lapisan kontrol:
client
  -> admission control
  -> priority queue
  -> token reservation
  -> RPM + TPM limiter
  -> provider/model route
  -> bounded retry controller
  -> contract-safe fallback
  -> usage, cost, and latency ledger
Gunakan admission control ketika antrian tidak dapat memenuhi tenggat waktu pemanggil. Gunakan priority queue agar evaluasi yang tidak kritis tidak mengalahkan traffic produksi. Gunakan token reservation untuk menjaga TPM tetap akurat. Gunakan centralized retry controller agar SDK, antrian, gateway, dan layer worker tidak semuanya melakukan retry secara independen.
Buku besar penggunaan harus merekam:
rate_limit_event:
  request_id: req_8f3a
  workspace_id: ws_42
  environment: production
  workflow: support_answer
  route_requested: primary_chat_route
  route_final: fallback_chat_route
  estimated_input_tokens: 3200
  max_output_tokens: 900
  actual_input_tokens: 3014
  actual_output_tokens: 622
  attempt_count: 2
  retry_delay_ms: 740
  queue_delay_ms: 1180
  final_status: success
  classified_limit: transient_rpm_burst
  accepted_result: true
Ini membuat batas laju API LLM dapat ditinjau setelah insiden. Ini juga memberi tim finance dan product bukti yang mereka butuhkan ketika retry atau fallback mengubah biaya per hasil yang diterima.
Bagaimana Flatkey Sesuai
Flatkey memberi tim satu API key dan base URL yang kompatibel dengan OpenAI untuk rute model yang didukung. Itu tidak menghapus batas laju LLM di hulu. Itu memberi tim satu permukaan integrasi tempat routing, peninjauan penggunaan, dan kebijakan dapat dibuat konsisten lintas provider.
Untuk workflow Penjelasan Batas Laju LLM: RPM, TPM, dan Retry, layer gateway membantu ketika:
- Aplikasi Anda membutuhkan satu kebijakan retry, antrean, dan fallback, bukan logika per-provider yang tersebar di berbagai layanan.
- Tim produk perlu membandingkan kesehatan rute, latensi, token, dan biaya hasil yang diterima dalam satu buku besar.
- Tim platform membutuhkan allowlist model, budget sub-key, dan kontrol penggunaan per lingkungan atau alur kerja.
- Tim keuangan membutuhkan satu saldo, faktur, dan bukti di level permintaan, bukan dashboard provider yang terpisah-pisah.
- Operator perlu memindahkan traffic yang memenuhi syarat ketika suatu rute dibatasi, tanpa menulis ulang SDK aplikasi.
Gateway tetap harus mempertahankan kontrak spesifik model. Jangan melakukan routing dari satu model ke model lain kecuali jendela konteks, perilaku tool, output terstruktur, kebijakan keamanan, kontrol data, latensi, dan biaya dapat diterima untuk beban kerja tersebut. Periksa ketersediaan rute dan harga saat ini di direktori model Flatkey dan harga Flatkey sebelum peluncuran ke produksi.
Kesalahan Umum
Menganggap RPM Sebagai Konkruensi
RPM mengukur penerimaan dari waktu ke waktu. Konkruensi mengukur pekerjaan yang sedang berjalan. Generasi yang lambat dapat menciptakan konkruensi tinggi meskipun RPM sedang.
Mencoba Ulang Setiap 429 Secara Langsung
Retry langsung menyinkronkan worker dan menghabiskan lebih banyak kapasitas. Patuhi Retry-After jika valid, tambahkan jitter, dan batasi anggaran retry.
Menggunakan Satu Pembatas Untuk Setiap Model
Provider mungkin menggunakan pool model terpisah atau pool akun bersama. Pembatas harus mengikuti cakupan kuota yang didokumentasikan dan header respons yang diamati.
Mengabaikan Konsumen Bersama
Dashboard, runner evaluasi, coding agent, dan API produksi dapat berbagi satu proyek. Sisihkan kapasitas berdasarkan beban kerja dan isolasi traffic kritis jika memungkinkan.
Mencoba Ulang Stream Parsial
Begitu token telah mencapai pengguna atau aksi tool telah dijalankan, replay diam-diam dapat menggandakan output atau efek samping. Definisikan semantik kelanjutan, restart, atau idempotensi secara eksplisit.
Hanya Mengukur Latensi Provider
Latensi pengguna akhir mencakup penundaan antrean, penundaan retry, penundaan fallback, dan latensi model. Beri peringatan pada seluruh jalur dan pisahkan komponennya.
FAQ
Apa perbedaan antara RPM dan TPM?
RPM membatasi berapa banyak permintaan yang diterima dari waktu ke waktu. TPM membatasi berapa banyak token input dan/atau output yang diterima. Prompt kecil biasanya terkena RPM terlebih dahulu; beban kerja dengan konteks panjang atau output tinggi sering kali terkena TPM terlebih dahulu.
Mengapa saya mendapat error 429 di bawah batas RPM saya?
Provider mungkin menerapkan rolling window, token bucket, kuota akun bersama, batas token terpisah, pool khusus model, batas harian, atau kontrol akselerasi. Penghitung permintaan lokal Anda mungkin tidak merepresentasikan cakupan kuota secara penuh.
Haruskah saya mencoba ulang setiap 429?
Tidak. Coba ulang throttling yang singkat dengan anggaran kecil dan jitter. Jangan berulang kali mencoba ulang habisnya kuota harian, pembatasan penagihan, error izin, error validasi, atau overload berkepanjangan yang tidak memiliki jendela pemulihan yang realistis.
Apakah exponential backoff menjamin keberhasilan?
Tidak. Backoff mengurangi tabrakan dan memberi waktu kapasitas sementara untuk pulih. Backoff tidak dapat menciptakan kuota. Kekurangan yang persisten membutuhkan permintaan yang lebih rendah, kapasitas lebih besar, pekerjaan yang ditunda, atau rute lain yang memenuhi syarat.
Apakah retry dihitung terhadap rate limit?
Bisa. Provider dapat menghitung permintaan atau percobaan yang gagal terhadap limit aktif, sehingga amplifikasi retry harus dimonitor dan dibatasi.
Berapa banyak retry yang sebaiknya digunakan oleh permintaan LLM?
Tidak ada angka universal. Tentukan jumlah percobaan berdasarkan budget latensi yang terlihat oleh pengguna dan mode kegagalan. Aplikasi interaktif biasanya hanya memerlukan beberapa percobaan singkat sebelum gagal atau dialihkan; pekerjaan offline dapat menoleransi antrean yang lebih lama.
Daftar Periksa Akhir
Gunakan daftar periksa ini saat mengimplementasikan Penjelasan Batas Laju LLM: RPM, TPM, dan Retry di produksi:
- Modelkan RPM, TPM, batas harian, batas pengeluaran, dan konkruensi secara terpisah.
- Hitung kapasitas dari minimum batas permintaan dan token.
- Beroperasi di bawah maksimum yang dipublikasikan dengan faktor keamanan.
- Cadangkan token sebelum mengirim permintaan dengan varians tinggi.
- Gunakan antrean dan pacing untuk beban yang berkelanjutan.
- Patuhi
Retry-Afterjika valid dan terjangkau. - Gunakan exponential backoff dengan jitter jika tidak ada petunjuk server yang valid.
- Batasi jumlah percobaan dan total waktu retry.
- Hentikan retry untuk error kuota, penagihan, izin, dan validasi.
- Hindari replay stream parsial atau efek samping yang tidak idempotent.
- Routing hanya ke model yang mempertahankan kontrak produk yang dibutuhkan.
- Pisahkan penundaan antrean dan penundaan retry dari latensi model dalam evaluasi.
- Beri peringatan pada amplifikasi retry dan usia antrean, bukan hanya jumlah mentah
429. - Catat ID permintaan, estimasi token, token aktual, percobaan, rute fallback, dan hasil akhir dalam buku besar penggunaan.
Rate limit adalah kontrol perencanaan kapasitas sebelum menjadi pesan error. Inti pelajaran yang tahan lama dari Penjelasan Batas Laju LLM: RPM, TPM, dan Retry adalah mengukur frekuensi permintaan, throughput token, konkruensi, retry, dan hasil fallback secara independen sehingga 429 menjadi sinyal yang dapat ditindaklanjuti, bukan noise produksi.
Sumber
- Dokumentasi batas laju OpenAI: https://platform.openai.com/docs/guides/rate-limits
- OpenAI Cookbook, menangani batas laju: https://cookbook.openai.com/examples/how_to_handle_rate_limits
- Batas laju Anthropic: https://docs.anthropic.com/en/api/rate-limits
- Batas laju Gemini API: https://ai.google.dev/gemini-api/docs/rate-limits
- RFC 9110 Retry-After: https://www.rfc-editor.org/rfc/rfc9110.html#name-retry-after
- MDN 429 Too Many Requests: https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Status/429
- Blog Arsitektur AWS, exponential backoff dan jitter: https://aws.amazon.com/blogs/architecture/exponential-backoff-and-jitter/
- Konvensi semantik OpenTelemetry untuk AI generatif: https://opentelemetry.io/docs/specs/semconv/gen-ai/
- Harga Flatkey: https://flatkey.ai/pricing
- Direktori model Flatkey: https://flatkey.ai/models