
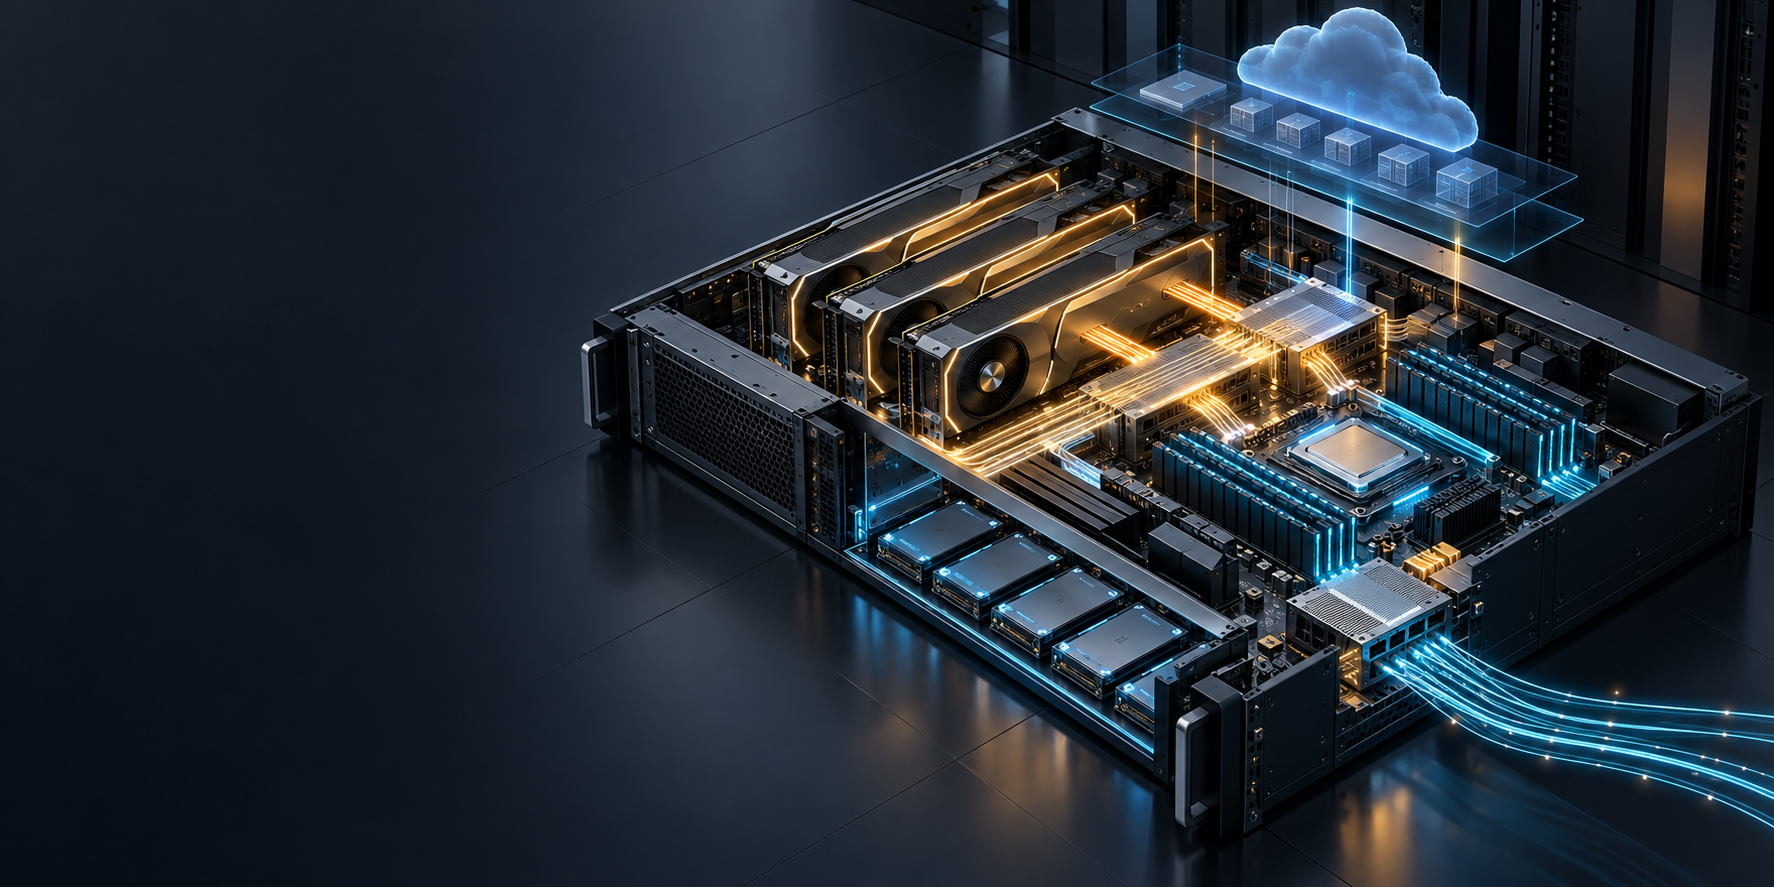
GPUサーバーは、CPUにアクセラレータを接続しただけのものではありません。AIワークロードでは、有用な単位はシステム全体です。すなわち、GPUメモリ、ホストメモリ、CPUレーン、ストレージパス、ネットワークパス、ランタイム、スケジューリングポリシー、そして完了した作業を測定する方法です。
このガイドは、AI開発者とMLインフラストラクチャエンジニアが、モデル名や時間単価だけで判断を済ませることなく、クラウドGPUサーバーを選定、導入、検証するのに役立ちます。ワークロード概要の作成、実際に提供されるトポロジーのテスト、安全な導入、そして有用な出力にコストを結び付けるために活用してください。
簡潔な回答:GPUサーバーとは?
GPUサーバーとは、並列コンピューティング用に1基以上のグラフィックスプロセッシングユニットを構成した物理サーバーまたは仮想サーバーです。通常、以下が含まれます。
- 1基以上のGPUと、その高帯域幅メモリ(HBMまたはVRAM)
- CPU、システムRAM、PCIeレーン、およびマザーボードのトポロジー
- キャッシュまたはステージング用のローカルNVMe、およびデータとチェックポイント用の永続ストレージ
- ユーザー、オブジェクトストレージ、およびマルチノードシステムでは集団通信のためのネットワークインターフェース
- ドライバー、コンテナランタイム、モニタリング、場合によってはオーケストレーション層
推論では、GPUサーバーはモデル、KVキャッシュ、バッチ処理の挙動、レイテンシ目標を同時に維持する必要があります。トレーニングまたは分散ファインチューニングでは、GPU間およびノード間の通信パスが、生のアクセラレータスループットと同じくらい重要になる場合があります。メディアおよびバッチパイプラインでは、ストレージと起動時の挙動によって、マシンが支払い対象の時間を有用な作業に費やせるかどうかが決まることがよくあります。
実務上の意味は単純です。ワークロード概要に基づいてGPUサーバーを選定し、その後、自身のワークロードで検証してください。同じアクセラレータ名の2つのホストが同じように動作すると想定してはいけません。
GPUサーバーアーキテクチャ:結果を左右する6つのレイヤー
GPUサーバーは、接続された6つのレイヤーとして捉えてください。弱いレイヤーがシステム全体の上限となる可能性があります。
| レイヤー | 確認する項目 | 重要な理由 |
|---|---|---|
| アクセラレータ | GPUファミリー、メモリ容量、パーティショニングの選択肢、サポートされる精度 | 何を収容できるか、およびワークロードで利用可能な演算パスを決定します。 |
| ノード内ファブリック | PCIeトポロジー、GPU間の直接リンク、存在する場合のスイッチファブリック | マルチGPUワークロードがテンソル、シャード、集団通信トラフィックをどれだけ効率的に交換できるかを左右します。 |
| ホストプレーン | CPUコア、システムRAM、NUMA配置、PCIeレーンレイアウト | GPUにデータを供給し、トークン化や前処理を支援し、隠れた転送ボトルネックを生む可能性があります。 |
| データパス | ローカルNVMe、永続ボリューム、オブジェクトストレージ、チェックポイントパス | モデルのロード時間、データセットスループット、チェックポイント復旧、再起動時の挙動を決定します。 |
| ネットワーク | NIC数、帯域幅、レイテンシ、レールレイアウト、アクセス制御 | リモートユーザー、分散ジョブ、データ移動で重要です。 |
| ソフトウェアと運用 | ドライバー、CUDAスタック、コンテナランタイム、スケジューラー、テレメトリー、アクセスポリシー | 単に割り当てられるだけでなく、容量を利用可能、可観測、かつ復旧可能なものにします。 |
アクセラレータとメモリは出発点となる制約であり、完全な答えではない
まず、モデルのメモリフットプリント、精度または量子化の計画、想定コンテキスト長、同時実行性、および安全マージンから始めます。GPUには静的な重み以上のための領域が必要です。サービングにはランタイム割り当て、ワークスペース、そして多くの場合、増大するKVキャッシュも必要になります。トレーニングではアクティベーション、勾配、オプティマイザの状態が追加されます。
そのため、AI GPU選定ガイドは、一般的な「最高のGPU」ランキングではなく、ワークロードから始めるべきです。ワークロードが1台のデバイスに余裕を持って収まるなら、追加のインターコネクトは無関係かもしれません。テンソル並列処理または同期トレーニングが必要な場合、トポロジーは容量要件の一部になります。
ノード内トポロジーが、複数GPUがチームとして動作できるかを決める
マルチGPU処理が自動的に高速になるわけではありません。GPUはPCIe、直接の高帯域幅リンク、またはスイッチファブリックを介して通信する場合があり、そのパスはGPUのペアごとに異なることがあります。NVIDIAは、nvidia-smi topo -mがノード内トポロジーの把握に役立ち、帯域幅ツールによって想定されるGPU間パスを検証できると説明しています。
マルチGPUサーバーを確定する前に、以下を取得してください。
- 対象となる正確なホストタイプのトポロジーマップ。
- フレームワークが使用するGPUペアにおけるピアツーピアの可用性。
- シンプルな帯域幅または集団通信のベースライン。
- GPUに対するCPUおよびNICのアフィニティ。
NVLinkまたはNVSwitchベースのシステムは、PCIeのみのレイアウトとは異なる通信設計を提供できます。NVIDIAのFabric Manager documentationは、GPUの接続およびファブリック管理におけるNVLinkとNVSwitchの役割を説明しています。これはバッジではなく、ワークロード適合性の問題として扱ってください。独立したシングルGPUの推論エンドポイントに、同期型マルチGPUジョブと同じファブリックは必要ありません。
ホストプレーンとデータパスは頻繁にボトルネックとなる
ホストがトークン化、メディアのデコード、シャードのロード、チェックポイントの復元、または想定外のPCIeパスを介したデータコピーを行っている間、GPUがアイドル状態になることがあります。アクセラレータの仕様と併せて、CPU、RAM、NUMA、ローカルディスク、ネットワークの詳細を確認してください。
ローカルNVMeは、使い捨てのキャッシュやステージング用として意図的に使用してください。モデルアーティファクト、データセット、チェックポイント、ワークフロー、承認済み出力については、永続化が必要な場合、交換可能なインスタンスでも失われないストレージに配置します。この分離により、クラウドGPUサーバーの再作成が容易になり、停止、リサイズ、またはホスト障害によって再開に必要な作業が失われるリスクを軽減できます。
ソフトウェアがGPUをスケジュール可能なキャパシティに変える
単一サーバーでは、通常、最小限のソフトウェア経路として、サポート対象のドライバー、CUDA互換ランタイム、コンテナツール、ワークロードイメージ、オブザーバビリティ、制御されたアクセス経路が必要です。Kubernetesでは、GPUサーバーにはデバイス検出、ベンダーのデバイスプラグイン、およびスケジューリングポリシーも必要です。
Kubernetesは、デバイスプラグインとカスタムのスケジュール可能リソースを通じてGPUを公開します。GPUスケジューリングのドキュメントでは、GPUリソースはコンテナの上限を通じて要求されると説明されています。NVIDIAのGPU Operatorは、ドライバー、コンテナツールキット、デバイスプラグイン、ノードラベル付け、DCGMベースのモニタリングなどの一般的なコンポーネントをバンドルしています。これらのコンポーネントは繰り返しのセットアップ作業を削減しますが、バージョン互換性、アクセスポリシー、受け入れテストは引き続き管理する必要があります。
ワークロード要件書に基づいてGPUサーバーを選ぶ
AI GPUサーバーまたは専用GPUサーバーホスティングの提案を評価する前に、この1ページの要件書を作成してください。
| 質問 | 記載する内容 | 判断に役立つこと |
|---|---|---|
| ワークロード | 推論、ファインチューニング、トレーニング、埋め込み、バッチ生成、または評価 | ランタイム、スケーリングパターン、関連ベンチマーク |
| モデルの特性 | モデル、精度、コンテキスト長、バッチ/並行性、アーティファクトサイズ | GPUメモリとメモリの余裕 |
| ユーザーの目標 | 最初のトークンまでの時間、トークン間レイテンシー、1時間あたりのジョブ数、チェックポイントまでの時間、完了した画像/動画 | 「十分に高速」を定義する指標 |
| 状態 | 再起動後も永続化する必要があるデータはどれか? | ローカルNVMeと永続ボリューム/オブジェクトストレージの使い分け |
| トポロジー | GPU 1基、1ホスト内の複数GPU、または複数ノード | PCIe/NVLink/NVSwitchおよびネットワーク要件 |
| 可用性 | インタラクティブ、スケジュールされたバッチ、または本番エンドポイント | キャパシティモデル、再起動ポリシー、オブザーバビリティ |
| 運用範囲 | パッチ適用、セキュリティ、監視、障害対応を誰が担うか? | 専用サーバー、マネージドキャパシティ、またはモデルAPIの選択 |
この要件書により、コストの高いミスマッチを防げます。低レイテンシーのサービングワークロードでは、予測可能なキャパシティとウォーム状態のアーティファクトが必要になる場合があります。バッチジョブは、適切にチェックポイントを作成できれば中断を許容できることがあります。トレーニング実行では、検証済みの集団通信と永続的なチェックポイントが必要になる場合があります。リストに「NVIDIA GPU server」または「server GPU」と記載されているだけでは、これらの質問のいずれにも答えられません。
キャパシティモデルのトレードオフについては、ワークロードのアイドル許容度と運用上の要件を把握した後に、サーバーレスGPUと専用GPUキャパシティを比較してください。
GPUサーバーのパフォーマンスを評価する方法
最も高速に見える仕様が、必ずしも最短時間で完了するワークロードにつながるとは限りません。次の順序でベースラインを確立してください。
1. ユーザー向けまたはジョブ向けの成果を測定する
ワークロードの所有者が認識できる少数の指標を選びます。
- インタラクティブなLLMサービング: 最初のトークンまでの時間、トークン間レイテンシー、1分あたりの成功リクエスト数、想定する並行性におけるテールレイテンシー。
- バッチ推論またはメディア生成: 1時間あたりの完了アイテム数、失敗/再試行率、キュー遅延、承認済み出力あたりのコスト。
- トレーニングまたはファインチューニング: 1秒あたりのサンプル数/トークン数、ステップ時間、通信時間、チェックポイント所要時間、リカバリー時間。
- 埋め込みまたは検索: 1秒あたりのドキュメント数/ベクトル数、エンドツーエンドの取り込み時間、インデックス永続化時間。
入力分布、モデルバージョン、ランタイムバージョン、並行性、キャッシュ状態、時間枠を記録してください。これらの条件がないベンチマークは、再現や比較が困難です。
2. フレームワークをチューニングする前にトポロジーを検証する
マルチGPUワークロードでは、まず実際のトポロジーを確認してください。NVIDIAのNCCLガイダンスでは、チューニングパラメーターを変更する前に、ノード内マップを確認し、想定されるGPU間帯域幅を測定することを推奨しています。また、あるベンチマークでの改善が、他の場所では有害になる可能性があるとも警告しています。
これは有用なガードレールです。別のホストの環境変数をコピーすることから始めないでください。まず、GPU、NIC、ドライバー、通信経路が、得たい結果の前提と一致していることを確認します。
3. コンピュート、通信、データパスの時間を分離する
アクセラレーターの使用率が低い場合でも、GPUが自動的に問題の原因とは限りません。実行を次の要素に分解します。
- キューおよびコールドスタート時間
- アーティファクトのダウンロードまたはモデルロード時間
- CPU前処理またはトークン化
- GPUコンピュート
- GPU間またはノード間通信
- 出力の書き込み、チェックポイント、または後処理時間
この分解により、次に行うべきテストは明確になります。モデルのロードが支配的であればストレージを測定します。同期ジョブが停止する場合は、トポロジーとコレクティブ通信を測定します。GPUが待機している場合は、CPUと入力パイプラインの動作を測定します。その後、無関係な実行結果と新しい設定を比較するのではなく、同じワークロードを再テストします。
4. ヘルスチェックとアクティブ診断を異なる目的で使い分ける
本番テレメトリは、ノードの稼働中に特定の状態が発生したかどうかを示します。アクティブ診断では、ドレインしたリソースが既知のワークロードを実行できるかをテストします。NVIDIAのDCGM Diagnostics documentationでは、この2つを区別しており、アクティブテストではコンピューティング、メモリ、PCIe、インターコネクト、電力、冷却の容量を消費する可能性があると説明しています。
侵襲的な診断は、通常のサービスから切り離した容量に対してのみ実行してください。得られた証拠は、GPUサーバーを復帰させるか、隔離するか、調査するかの判断に使用し、アプリケーションレベルの受け入れテストの代替にはしないでください。
クラウドGPUサーバーを導入する:本番運用を意識した手順
以下の導入手順は、まず単一の仮想マシンまたはベアメタルサーバーで機能し、運用モデルで必要になればスケジューラへと拡張できます。
ステップ1:永続状態を交換可能なコンピュートから分離する
データを次の3つのクラスに定義します。
- エフェメラル:再構築可能なコンテナレイヤー、コンパイル済みアーティファクト、キャッシュ。
- 永続的なランタイム状態:モデル、データセット、チェックポイント、ワークフロー、承認済みの出力。
- シークレットと設定:認証情報、レジストリアクセス、サービス設定、監査上重要な設定。
プラットフォームに適したストレージ方式で永続状態を接続します。明示的な復元パスを維持してください。再現可能なGPUサーバーの導入では、モデルまたは最後のチェックポイントの場所を推測することなく、コンピュートを交換できる必要があります。
ステップ2:ソフトウェアスタックを固定し、記録する
OSイメージ、GPUドライバーのブランチ、CUDA/ランタイムの互換性、コンテナイメージのダイジェスト、フレームワークのバージョン、モデルのリビジョン、起動設定を記録します。本番ワークロードの唯一のバージョン参照として「latest」を使用しないでください。
この記録により、ハードウェアまたはトポロジーの問題と、意図しないソフトウェア変更を区別できます。また、ドライバー、ランタイム、またはモデルの更新後にロールバックするための復帰点にもなります。
ステップ3:デフォルトでアクセスを非公開にする
ユーザーとサービスには、必要なアクセスのみを付与します。一般的な対策には、受信ネットワークルールの制限、キーまたはアイデンティティベースの管理アクセス、短期間で失効する認証情報、プライベートなモデル/データパス、最小権限のサービスアカウント、イメージに値を埋め込む代わりのシークレットマネージャーなどがあります。
具体的な対策はクラウドとコンプライアンス境界によって異なりますが、原則は変わりません。公開されたノートブック、推論ポート、またはリモートデスクトップは、導入戦略ではありません。
ステップ4:ワークロードトラフィックを受け入れる前にホストを検証する
短い事前チェックを実施します。
- オペレーティングシステムが想定どおりのGPUインベントリとドライバーを認識していることを確認する。
- コンテナが意図したGPUにアクセスできることを確認する。
- 小規模で代表的なワークロードを実行する。
- 複数のGPUを使用する場合は、トポロジーと通信の証拠を取得する。
- モデル/チェックポイントで使用するストレージロケーションに対して読み書きする。
- ログ、メトリクス、アラートが、オペレーターが対応できる場所に届くことを確認する。
Kubernetesクラスタでは、ワークロードをスケジュールする前に、ベンダーがサポートするドライバーとデバイスプラグインのパスをインストールします。以下の最小パターンはリソース宣言を示しています。イメージ、名前空間、セキュリティ制御、スケジューリングルールは、ご自身の環境に合わせて調整してください。
apiVersion: batch/v1
kind: Job
metadata:
  name: gpu-acceptance-check
spec:
  template:
    spec:
      restartPolicy: Never
      containers:
        - name: workload
          image: registry.example.com/your-workload@sha256:replace-with-image-digest
          resources:
            limits:
              nvidia.com/gpu: 1
ノードラベル、アフィニティ、テイント、クォータを使用して、互換性のないワークロードが同じGPU容量を奪い合わないようにします。Kubernetes GPU cluster guideでは、マルチノードスケジューリング、キュー、運用上の制御についてさらに詳しく説明しています。
ステップ5:本番導入前に受け入れゲートを作成する
新しいホストタイプ、イメージ更新、または重要なトポロジー変更ごとに、同じゲートを使用します。
| ゲート | 収集すべき証拠 | 保護につながる理由 |
|---|---|---|
| インベントリ | GPUモデル/台数、ドライバー、ランタイム、可視メモリ | 誤ったホストや不完全なドライバーパスを検出する |
| コンテナアクセス | 本番に近いイメージからのGPUアクセス成功 | ワークロードが割り当てられたデバイスを使用できることを証明する |
| ワークロードのベースライン | 代表的な入力、出力、目標メトリクス | 構成のみのテストを防ぐ |
| トポロジーのベースライン | マルチGPU作業向けのGPUマップと通信結果 | 弱い、または想定外のインターコネクトパスを検出する |
| データパス | モデルロードおよびチェックポイント/復元テスト | ストレージと再起動の制約を明らかにする |
| 可観測性 | メトリクス、ログ、アラート経路 | 引き継ぎ後に障害を診断可能にする |
| 復旧 | 永続状態を使用した停止/再起動または置換テスト | 導入環境が通常のクラウドイベントに耐えられることを証明する |
コスト管理:見栄えのするアイドルマシンではなく、完了した作業に対して支払う
クラウドGPUの料金は、GPUサーバーの総コストの一項目にすぎません。支払い対象期間を有用な出力と照らし合わせて追跡してください。
完了作業コスト = コンピューティング + ストレージ + データ移動 + プラットフォーム/運用オーバーヘッド + 失敗/再試行した作業
次に、以下を問いかけます。
- サーバーがウォーム状態なのは有用なトラフィックを処理しているためですか、それともシャットダウンが面倒なだけですか?
- ワークロードは、予測可能な形でチェックポイントを作成し、一時データをクリーンアップしていますか?
- モデルアーティファクトは、意図的に用意されたキャッシュや永続ストアからマウントされるのではなく、繰り返しコピーされていますか?
- 失敗したジョブが、予算やエラー分類なしに再試行されていますか?
- マルチGPUトポロジーは、本当に重要な作業を改善していますか?
キャパシティモデルの観点についてはGPUレンタル料金ガイドを、ストレージ、エグレス、アイドル時間、サポートに関する検討事項についてはクラウドGPUの隠れたコストガイドを参照してください。より大規模な導入では、1台のサーバーでは足りなくなった際に必要となるコンピューティング、ネットワーク、ストレージ、コントロールプレーンのレイヤーをGPUクラスタアーキテクチャガイドで解説しています。
GPUサーバーが適切な選択である場合と、そうでない場合
ランタイム、モデルアーティファクト、スケジューリング、システムライブラリ、データローカリティ、またはアクセラレータトポロジーを制御する必要がある場合は、GPU専用サーバーまたはクラウドGPUサーバーを使用してください。ワークロードの需要が運用境界を正当化できる程度に安定している場合にも、合理的な選択肢です。
直接的なシステム制御が要件に含まれず、ドライバー、キャパシティ割り当て、ランタイム保守、ハードウェア診断を自ら管理することなくモデル機能を提供することが優先される場合は、マネージドモデル/APIの方式を選択してください。判断では、料金表上の単なる「GPUクラウド」と「API」の比較ではなく、完了作業コストと運用負荷を比較すべきです。この境界については、GPUクラウドとモデルAPIを参照してください。
GPUサーバー導入チェックリスト
本番用サーバーを承認する前に、各質問に「はい」と答えられることを確認してください。
- ワークロード概要には、モデル、メモリ、同時実行性、成功メトリクスが具体的に記載されていますか?
- アクセラレータモデルだけでなく、正確なGPUサーバートポロジーをテストしましたか?
- 固定されたバージョンとイメージダイジェストからソフトウェアスタックを再現できますか?
- 永続状態は、置換可能なコンピューティングから分離されていますか?
- ワークロードには制限されたアクセスパスと管理されたシークレットがありますか?
- アプリケーションのベースラインに加え、トポロジーとデータパスの証拠がありますか?
- オペレーターは、健全性、エラー、使用率、コストに関連するアクティビティを確認できますか?
- 同じ永続状態計画を使用して、再起動または置換をテストしましたか?
- サーバーは有用な作業を提供していないときに停止、スケール、または別用途へ転用されますか?
よくある質問
GPUサーバーは何に使用されますか?
GPUサーバーは、AI推論、モデル学習、ファインチューニング、埋め込み、シミュレーション、レンダリング、メディア生成パイプラインなど、並列アクセラレーションの恩恵を受けるワークロードに使用されます。適切な導入方法は、ワークロードのメモリ、レイテンシー、スループット、データ、運用要件によって異なります。
専用GPUサーバーは常にサーバーレスGPUキャパシティより高速ですか?
いいえ。専用GPUサーバーはより多くの制御と安定したウォームキャパシティを提供できますが、その有用性は使用率、起動動作、ランタイムチューニング、および周辺のデータパスに依存します。サーバーレスキャパシティは、バースト性があり再起動可能な作業により適している場合があります。実際に運用する条件下で、完了したワークロードを測定してください。
LLMに適したGPUサーバーはどのように選べばよいですか?
モデルの重み、精度、コンテキスト長、同時実行性、KVキャッシュの余裕から始めてください。次に、モデルが1基のGPUに収まるか、複数デバイスを必要とするかを判断し、代表的なトラフィックを使用して最初のトークンまでの時間、トークン間レイテンシー、スループット、テール挙動をベンチマークしてください。パラメータ数だけで選択してはいけません。
1台のGPUサーバーにKubernetesは必要ですか?
いいえ。適切に管理された単一ホストが、最もシンプルで信頼性の高いデプロイメントになる場合があります。Kubernetesがより有用になるのは、再現可能なスケジューリング、分離、ポリシー、複数ノードの連携、またはチーム間で共有するキャパシティが必要な場合です。GPUを使用するからではなく、運用上の問題を解決するために導入してください。
本番環境の前にGPUサーバーをテストするにはどうすればよいですか?
本番環境に近いコンテナ、小規模で代表的なワークロード、ストレージの読み書き、可観測性、およびリカバリーをテストします。マルチGPUワークロードでは、トポロジーと通信に関する証跡も取得してください。継続的なシグナルにはヘルスモニタリングを使用し、インフラストラクチャレベルの検証が必要な場合は、ドレインしたキャパシティでアクティブ診断を実行します。
作業を中心にシステムを構築する
適切なGPUサーバーとは、意図した入力を、測定可能なパフォーマンス、復旧可能な状態、管理された運用コストで、受け入れ可能な出力へと繰り返し変換できるものです。ワークロードの要件定義から始め、受け取ったシステムを検証し、アーキテクチャの判断をハードウェアのラベルではなく証拠に結び付けてください。
ハードウェアを直接制御することが不可欠である場合は、その証拠を用いてGPUキャパシティを自信を持って選定・運用してください。そうでない場合は、不要なインフラストラクチャを引き受ける前に、サーバーの運用コストをマネージドモデル/APIのアプローチと比較してください。


