kubernetes gpu clusterの構築は、いくつかのワーカーノードにGPUを接続することと同じではありません。AIトレーニングと推論では、Kubernetesがアクセラレーターを安全に公開し、ジョブを適切なノードに配置し、希少なキャパシティをキューイングし、データセットとモデルの重みをコンピューティングに十分近い場所に保持し、高コストな実行が失敗した理由を運用担当者に伝える必要があります。
実践的な原則は、ワークロードを実証できる最小のKubernetes GPUクラスターを構築し、スケジューラー、ドライバー、ネットワーク、ストレージ、可観測性、コストモデルが受け入れテストに合格してから拡張することです。キュー待機時間、GPU使用率、チェックポイント復元時間、障害原因を説明できないクラスターは、まだ本番インフラストラクチャではありません。
このガイドでは、AIトレーニングと推論に使用するkubernetes gpu clusterのアーキテクチャと運用モデルを解説します。ノード設計、GPU公開、キューイング、ワークロードAPI、可観測性、実用的なkubernetes gpu cluster diagram、管理ツール、およびキャパシティをレンタルまたは予約する前にプロバイダーへ確認すべき質問を扱います。
プロダクトが必要とするのがモデル出力のみである場合は、まずモデルAPIまたはマネージド推論の選択肢を比較してください。カスタム重み、配置制御、プライベートサービング、分散トレーニング、または再現可能なベンチマークの所有が必要な場合は、Kubernetes GPUクラスターが適切なコントロールプレーンになる可能性があります。
Kubernetes GPUクラスターの要点
本番環境のkubernetes gpu clusterは、6つのレイヤーで構成されます。
| レイヤー | 管理対象 | 本番導入前に確認すること |
|---|---|---|
| GPUノード | GPUモデル、GPUメモリ、CPU/RAM、ローカルNVMe、NIC、ノードイメージ、ドライバー、コンテナランタイム | ノード構成が、宣伝されているGPU SKUだけでなく、トレーニングまたは推論のワークロードに適合していること。 |
| GPU公開 | デバイスプラグイン、GPU Operator、Dynamic Resource Allocation、MIGまたは共有ポリシー | Podが予測可能な形でアクセラレーターをリクエストでき、誤って不適切なデバイスを消費できないこと。 |
| スケジューリングとキュー | Kubernetesスケジューラー、Kueue、Volcano、Ray、Kubeflow、カスタムオペレーター | ジョブが公平に待機し、プリエンプションポリシーが明示され、チームがキュー待機時間を説明できること。 |
| ネットワークとストレージ | ノード内のNVLink/NVSwitch、ノード間のInfiniBand/RoCE/EFAまたはEthernet、オブジェクトストレージ、共有ファイルシステム、チェックポイントパス | 分散ジョブがGPUを遊休状態にすることなくスケールし、復旧できること。 |
| 可観測性 | DCGM、Prometheus、ログ、イベント、トレース、キューメトリクス、コストラベル | 運用担当者が、ワークロードごとの使用率、メモリ、電力、障害、所有者、支出を確認できること。 |
| セキュリティとガバナンス | RBAC、名前空間、クォータ、イメージポリシー、シークレット、ネットワークポリシー、監査ログ | クラスターが共有インフラストラクチャになる前に、マルチテナントアクセスが制御されていること。 |
重要な設計上の問いは「KubernetesはGPUを実行できるか?」ではありません。適切なデバイスプラグインとノード設定があれば、実行できます。より難しい問いは、実際のデータ、実際のユーザー、実際の障害、実際の予算制約の下で、ai infrastructure kubernetes gpu clusterがGPUを有効に活用し続けられるかどうかです。
Kubernetes GPUクラスター図
ツールを選定する前に、このkubernetes gpu cluster diagramをレビューのモデルとして使用してください。
                 developers / CI / notebooks / API traffic
                                  |
                                  v
        +--------------------------------------------------+
        | Kubernetes control plane                         |
        | API server, scheduler, RBAC, admission, secrets   |
        +--------------------------------------------------+
                                  |
                 +----------------+----------------+
                 |                                 |
                 v                                 v
        +------------------+              +------------------+
        | queue layer      |              | platform add-ons  |
        | Kueue / Volcano  |              | GPU Operator,     |
        | quotas, cohorts, |              | device plugin,    |
        | resource flavors |              | DCGM exporter     |
        +------------------+              +------------------+
                 |                                 |
                 +----------------+----------------+
                                  |
                                  v
        +--------------------------------------------------+
        | GPU worker node pools                            |
        | H100/H200/B200/A100/L40S/etc., CPU, RAM, NVMe,   |
        | NICs, CUDA/runtime, labels, taints, topology     |
        +--------------------------------------------------+
                 |                 |                 |
                 v                 v                 v
        training jobs       inference services       batch jobs
        PyTorch/JAX         vLLM/SGLang/Triton       Ray/Kubeflow
                 \                 |                 /
                  \                |                /
                   v               v               v
        +--------------------------------------------------+
        | network and data path                            |
        | high-speed fabric, object storage, shared FS,     |
        | model cache, checkpoints, logs, metrics, backups |
        +--------------------------------------------------+
この図は意図的にシンプルにしています。実際のkubernetes gpu cluster architectureには、ロードバランサー、プライベートレジストリ、サービスメッシュの境界、IAM、アーティファクトストア、実験追跡、請求エクスポートが追加されます。この図の役割は、1つの議論を促すことです。各障害モードをどのレイヤーが所有するのか、という議論です。
ステップ1: Kubernetesが適切なGPUコントロールプレーンかを判断する
AIプラットフォームでコンテナネイティブなデプロイ、API駆動の自動化、マルチテナント名前空間、サービスエンドポイント、ポリシー制御、既存のクラウドネイティブなオブザーバビリティとの統合が必要な場合、Kubernetesは有力な選択肢です。
通常、次の用途に適しています。
- ロールアウト、自動スケーリングの境界、ルーティング、サービスヘルスチェックを必要とするオンライン推論サービス。
- Job、Rayワークロード、またはカスタムオペレーターとして実行されるバッチ推論または埋め込みワークロード。
- 個別のGPUマシンではなく共有インフラストラクチャをチームが求める、ファインチューニングおよびトレーニングのワークロード。
- ノートブック、トレーニングジョブ、モデルサービング、サポートサービスが同じ運用モデルを共有する混在プラットフォーム。
- すでにKubernetesを運用しており、既存のアイデンティティ、CI/CD、レジストリ、ロギング、ポリシーシステムを拡張できるチーム。
チームに必要なのが時折の研究アクセス、単発のHPCスタイルのバッチジョブ、またはシンプルなSSH駆動のトレーニングだけである場合、Kubernetesは最初の選択として適さない可能性があります。そのような場合は、Slurm、マネージドトレーニングサービス、ホスト型ノートブック環境、またはGPUの直接レンタルのほうが、より迅速に有用な成果を生み出せる可能性があります。
kubernetes gpu clusterを構築する前に、ワークロードの境界を定義してください。
| 質問 | 重要な理由 |
|---|---|
| ワークロードはトレーニング、バッチ推論、オンライン推論、ノートブック、または混在型のどれですか? | 回答によって、スケジューリング、ストレージ、ネットワーク、可用性の要件が変わります。 |
| ジョブにはGPU全体、MIGスライス、または時分割アクセスのどれが必要ですか? | GPU共有は、分離、使用量計測、パフォーマンスの予測可能性を変化させます。 |
| ワークロードは単一ノードですか、それともマルチノードですか? | マルチノードトレーニングでは、GPUの可用性だけでなく、ネットワークと配置のテストが必要です。 |
| データセット、チェックポイント、モデルウェイトのサイズはどの程度ですか? | データ移動がGPUコストの大部分を占める可能性があります。 |
| ビジネス上の分母は何ですか? | GPU時間だけではなく、完了したトレーニング実行、受理された推論出力、生成メディアジョブ、または顧客リクエストを使用してください。 |
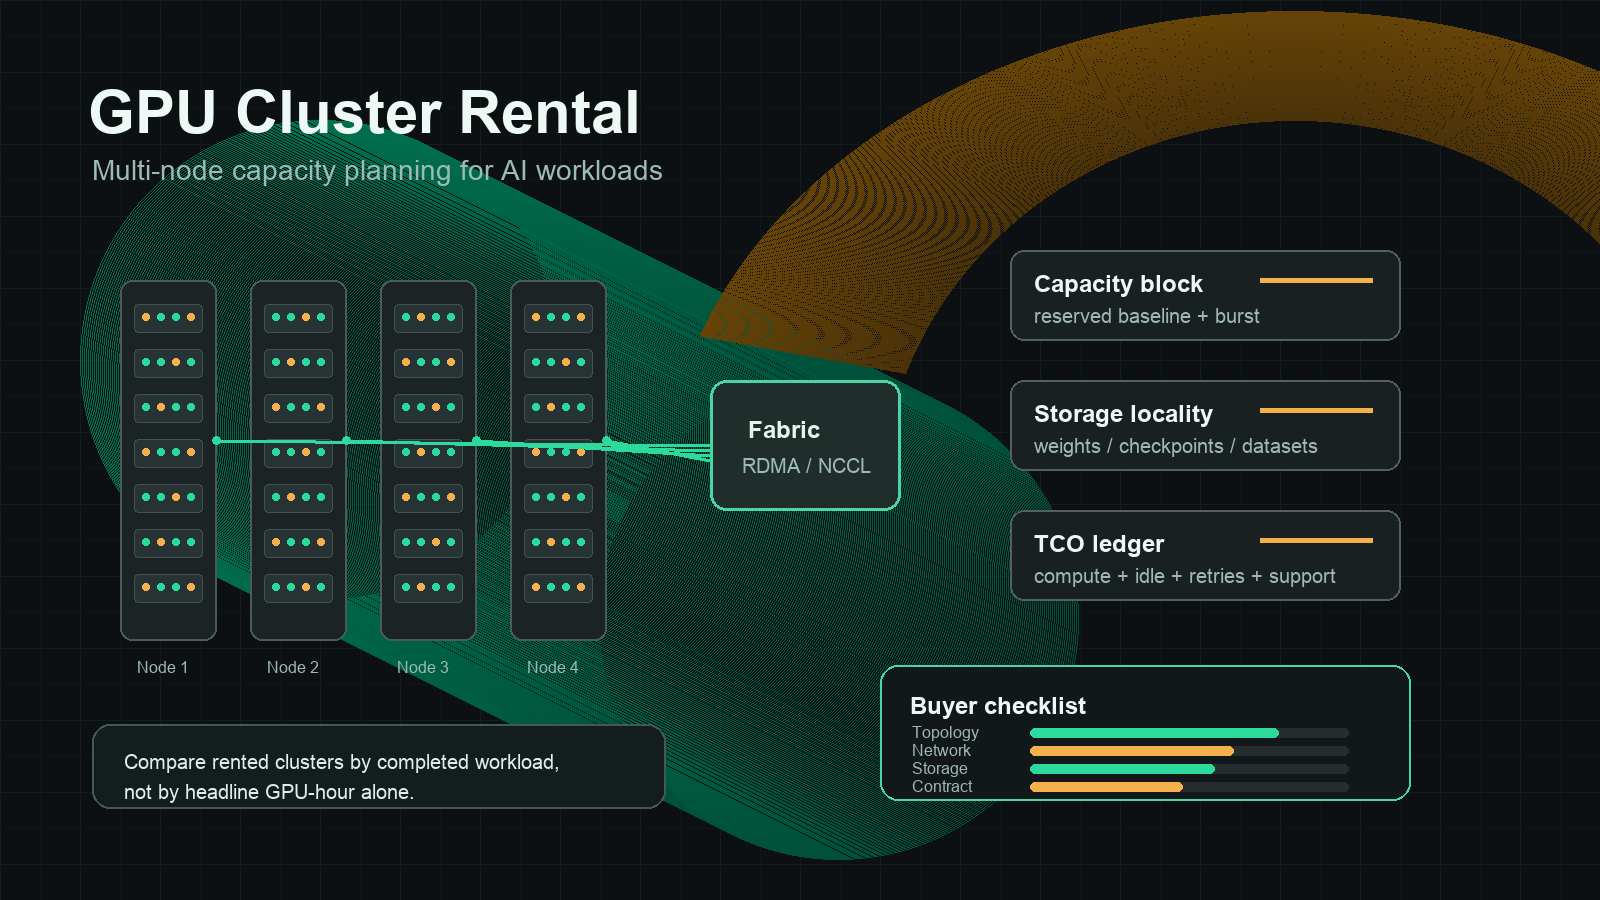
より広範なシステム設計については、この実装計画をgpu cluster architectureのレビューに結び付けてください。コンピューティング、ネットワーク、ストレージ、コントロールプレーンは一体として設計する必要があります。
ステップ2: ワークロードの特性に合わせてGPUノードプールを設計する
kubernetes gpu clusterには、アクセラレーターマシンを無秩序に混在させるのではなく、意図的に設計されたノードプールが必要です。
各ノードプールについて、以下を指定します。
- GPUモデルとメモリ容量。
- ノードあたりのGPU数。
- 該当する場合は、PCIe、SXM、NVLink、NVSwitch、またはその他のトポロジー詳細。
- CPUモデル、CPU数、RAM、NUMAレイアウト。
- ローカルNVMeの容量とスループット。
- NIC数、NIC速度、ファブリックタイプ。
- OSイメージ、カーネル、ドライバー、CUDA、コンテナランタイム、パッチ適用プロセス。
- Kubernetesラベル、テイント、トレランス、トポロジーラベル。
- ワークロードでGPU全体、MIG、タイムスライシング、または別の共有モードのどれを使用するか。
強い理由がない限り、トレーニングと推論の要件は分けてください。トレーニングでは、all-reduceのパフォーマンス、チェックポイント帯域幅、ギャングスケジューリングが最も重要になることがあります。オンライン推論では、コールドスタート時間、モデルキャッシュの局所性、テールレイテンシー、ロールアウトの安全性のほうが重要になる場合があります。
実用的なノードプールの命名パターンは次のとおりです。
gpu-pool:
  accelerator: h100-80gb
  topology: 8gpu-sxm-nvlink
  fabric: infiniband
  workload: distributed-training
  sharing: full-gpu
これらのラベルは単なるドキュメントではありません。スケジューリングセレクター、クォータのディメンション、コストタグ、デバッグコンテキストになります。
ステップ3: 適切なKubernetesメカニズムでGPUを公開する
Kubernetesは、専用のリソースメカニズムを通じてGPUをスケジューリングします。一般的なベースラインは、GPUリソースをkubeletに通知し、Podが拡張リソースとしてリクエストできるようにするベンダーデバイスプラグインです。Kubernetesは、リクエストモデルとノード選択の制約をGPUスケジューリングガイドで説明しています。NVIDIA Kubernetes device pluginはNVIDIA GPU向けの標準的な手段であり、NVIDIA GPU Operatorは、ドライバーとランタイム管理、デバイスプラグインのデプロイ、MIG管理、GPUテレメトリーなど、複数の運用コンポーネントをパッケージ化しています。
多くのチームにとって、最初の本番環境への導入パスは次のとおりです。
node image + kernel prerequisites
  -> NVIDIA driver and container runtime
  -> NVIDIA GPU Operator
  -> Kubernetes device plugin
  -> DCGM exporter metrics
  -> workload namespaces and quotas
Kubernetes Dynamic Resource Allocationも、より高度なデバイス割り当てモデルを評価するチームにとって重要です。DRAはリソースクレームとデバイスクラスを中心に設計されており、単純な拡張リソース要求では十分に表現できない配置要件やデバイス固有の要件に役立ちます。これは意図的なプラットフォーム選択として扱ってください。ドライバー、Kubernetesのバージョン、ワークロードAPI、オブザーバビリティの仕組みをすべて組み合わせてテストする必要があります。
実務上の判断は次のとおりです。
| ニーズ | 評価すべきKubernetesの仕組み |
|---|---|
| 基本的なフルGPUのPodスケジューリング | デバイスプラグインとnvidia.com/gpu形式の拡張リソース。 |
| NVIDIA GPUのライフサイクル管理 | NVIDIA GPU Operator。 |
| GPUテレメトリ | DCGM exporterとPrometheus/Grafana、または使用中のオブザーバビリティスタック。 |
| より表現力の高いデバイスクレーム | Kubernetes Dynamic Resource Allocation。 |
| GPUパーティショニング | サポートされている場合はMIG。ただし、分離とパフォーマンスに関する注意点を明示します。 |
| 開発用の時間共有アクセス | 分離およびクォータのルールを明確にした後に限り、タイムスライシングまたはプラットフォームポリシー。 |
このレイヤーをアプリケーションチームから隠してはいけません。パフォーマンスやデバッグに関する前提が変わるため、Podがアクセラレーター全体、MIGスライス、または時間共有デバイスのどれを受け取るのかを把握する必要があります。
ステップ4:チームがGPUを奪い合う前にキューレイヤーを追加する
デフォルトのKubernetesスケジューラーだけでは、完全なマルチテナントAIキューにはなりません。AIチームには通常、ワークロードの受け入れ制御、公平な共有、クォータ、プリエンプションポリシー、およびジョブが待機している理由の可視化が必要です。
バッチ処理やAI/MLのキューイングが重要な場合、評価すべきKubernetesネイティブのプロジェクトはKueueです。そのコアコンセプトには、ワークロード、ローカルキュー、クラスターキュー、コホート、リソースフレーバーが含まれます。これにより、プラットフォームチームは希少なGPUプールをモデル化し、リソースが利用可能になった際にどのジョブを受け入れるかを決定できます。
Volcanoも、AI、ビッグデータ、HPCスタイルのワークロード向けのKubernetesバッチスケジューリングの選択肢です。そのギャングスケジューラーは、全か無かの最小Pod条件を使用します。これは、ピアを待つ間に部分的に割り当てられたGPUを無駄にしてしまう分散ジョブで評価する価値があります。
AIインフラストラクチャ向けKubernetes GPUクラスターでは、キューポリシーを文書で定義してください。
| ポリシー | 決定すべき事項 |
|---|---|
| 受け入れ | どのジョブがキューに入れるか、またどのメタデータが必要か? |
| 公平な共有 | GPUをチーム、プロジェクト、環境間でどのように配分するか? |
| 優先度 | どの本番推論ジョブ、またはローンチに不可欠なトレーニングジョブがキューを優先できるか? |
| プリエンプション | ジョブを退避できるか、また退避前にチェックポイントをどのように必須とするか? |
| リソースフレーバー | どのGPUプールを代替可能とし、どれを代替不可とするか? |
| バックフィル | 大規模な分散実行が待機している間に、より小規模なジョブを実行できるか? |
| 可視性 | ユーザーはプラットフォームエンジニアに問い合わせずに、キュー内の位置と拒否理由を確認できるか? |
キューポリシーはコスト管理の仕組みです。これがなければ、最も声の大きいチームが最も高価なキャパシティを消費し、小規模なジョブは待機するか、管理されていないシャドーインフラストラクチャへ移される可能性があります。
ステップ5:トレーニングと推論のためのワークロードAPIを選択する
Kubernetes GPUクラスターは、アプリケーションチームが毎回低レベルのPod仕様を手書きせずにワークロードを送信できる場合に最も有用です。
トレーニングでは、以下を評価します。
- 単純な単一ノード実行には、ネイティブKubernetes Jobs。
- フレームワークをまたぐ分散トレーニングワークフローには、Kubeflow Trainer。
- 分散Python、バッチ推論、サービングパターンにはRayとKubeRay。
- ギャングスケジューリングまたはキューによる受け入れ制御が必要な場合は、VolcanoまたはKueueとの統合。
- 汎用ツールでは対応できない安定した内部パターンがプラットフォームに存在する場合にのみ、カスタムOperator。
推論では、以下を評価します。
- 単純なサービスにはDeploymentsまたはStatefulSets。
- モデルとパフォーマンス目標に応じた、vLLM、SGLang、Triton、またはTensorRT-LLMのサービングコンテナ。
- チームがモデルライフサイクルの抽象化を必要とする場合は、KServeまたは別のモデルサービングレイヤー。
- キュー深度、レイテンシー、GPUメモリ、リクエスト構成に基づく水平・垂直スケーリングルール。
- レイテンシーに敏感な本番トラフィックとバッチワークロードを分ける専用ノードプール。
最初はワークロードAPIをシンプルに保ってください。ラベル、リソース要求、ストレージマウント、ログエクスポートを備えた明確なJobテンプレートは、誰もデバッグできない複雑なプラットフォームより優れています。
ステップ6:ネットワークとストレージのパスを検証する
動作するデモと本番のKubernetes GPUクラスターAIインフラストラクチャの違いは、多くの場合、ネットワークとストレージのテストで明らかになります。
分散トレーニングでは、以下を検証します。
- ノード間の配置。
- 対象となるすべてのノード間でのNCCL all-reduceの動作。
- ファブリックエラー、再送、輻輳、およびノード間のばらつき。
- ドライバー、CUDA、NCCL、コンテナイメージのバージョン。
- クリーンなベンチマークイメージ上だけでなく、本番用コンテナイメージをインストールした後のパフォーマンス。
ストレージでは、以下を検証します。
- データセットのステージング時間。
- モデル重みのダウンロードとキャッシュのウォームアップ。
- チェックポイントの書き込み頻度と所要時間。
- ノードまたはPodの障害後の復元時間。
- 同時実行ジョブ下での共有ファイルシステムの挙動。
- オブジェクトストレージのリージョン、エグレス、ライフサイクルルール。
最小限の受け入れテストは次のようになります。
1. 本番コンテナでキューに入るトレーニングジョブを送信する。
2. 実際のデータセットサンプルとベースモデルの重みを取得する。
3. ワークロードが分散されている場合は、マルチノード通信ベンチマークを実行する。
4. 固定時間枠でトレーニングまたはファインチューニングを行う。
5. チェックポイントを書き込み、Podを削除して、チェックポイントから復元する。
6. GPU、ネットワーク、ストレージ、キュー、コストのラベルをエクスポートする。
7. 有用な作業をモデル/APIまたはGPUレンタルのベースラインと比較する。
このテストは、長期予約や高額なコミットメントの前に実行する必要があります。ローンチ期間中ではなくベンチマーク中に脆弱なファブリックや遅いチェックポイント経路を発見する方が、コストを抑えられます。
Kubernetes GPUクラスター管理ツール
kubernetes gpu cluster management toolsというフレーズは、いくつかの異なる業務を指します。実行する業務を明確にする前に、ツールを購入または導入しないでください。
| 管理上のニーズ | 評価すべきツールまたはプロジェクト | 「良い」状態 |
|---|---|---|
| GPUライフサイクル | NVIDIA GPU Operator、device plugin、ノードイメージ自動化 | ドライバー、ランタイム、デバイス公開、テレメトリーがノード間で再現可能である。 |
| キューイング | Kueue、Volcano、Rayのジョブ送信パターン | ユーザーが、許可済み、保留中、実行中、失敗、完了の状態を明確に確認できる。 |
| トレーニングワークフロー | Kubeflow Training Operator、Ray、ネイティブJobs | 分散ジョブが再現可能であり、毎回個別のPod YAMLを必要としない。 |
| 推論サービング | vLLM、SGLang、Triton、KServe、Deployments | ロールアウト、ヘルスチェック、レイテンシー、モデルキャッシュの挙動を可視化できる。 |
| 可観測性 | DCGM exporter、Prometheus、Grafana、ログ、トレース、Kubernetesイベント | GPUメトリクスをジョブ、チーム、モデル、コストのラベルに関連付けられる。 |
| ポリシー | RBAC、ResourceQuota、LimitRange、アドミッション制御、イメージポリシー、ネットワークポリシー | 通常の開発を妨げることなく、マルチテナントアクセスを制限できる。 |
| コスト配賦 | Namespaceラベル、ワークロードラベル、使用量エクスポート、請求ダッシュボード | 財務部門が支出をチーム、環境、モデル、承認済みの出力に対応付けられる。 |
割り当て済みGPU時間のみを報告するプラットフォームは避けてください。有用な管理では、GPUがアイドル状態だった理由、どの失敗したジョブが容量を消費したか、推論出力またはトレーニングのマイルストーンが支出を正当化したかを示します。
CoreWeave Kubernetes GPUクラスターに関する質問
一部のチームがcoreweave kubernetes gpu clusterを検索するのは、汎用仮想マシンではなく、クラウドGPU容量へのKubernetesネイティブなアクセスを求めているためです。このプロバイダー名を含む検索クエリはデューデリジェンスのきっかけとして扱ってください。CoreWeaveまたは類似のGPUクラウドプロバイダーについては、本番ワークロードをコミットする前に、正確なKubernetesアクセスモデル、ノードプール制御、Operator互換性、クォータのエクスポート、サポート範囲を確認してください。
どのプロバイダーに対しても、同じデューデリジェンスを実施してください。
| 質問 | 重要な理由 |
|---|---|
| 要求したリージョンで実際に利用可能なGPU SKUとノード形状は何か。 | マーケティング上の在庫と割り当て可能な容量は同じではない。 |
| 予約またはプール内のノードは均一か。 | ノードが混在すると、パフォーマンスに関する前提が崩れる可能性がある。 |
| GPUノード間にはどのファブリックが使用されるか。 | マルチノードトレーニングは、配置とネットワークの挙動に依存する。 |
| ドライバー、CUDA、Kubernetesのアップグレードは誰が担当するか。 | アップグレードの責任範囲は、ダウンタイムと再現性に影響する。 |
| GPU Operator、Kueue、Volcano、Ray、または必要なOperatorを実行できるか。 | マネージドKubernetesでもプラットフォーム互換性が必要である。 |
| クォータ、使用量エクスポート、ラベルはどのように公開されるか。 | 財務チームとプラットフォームチームにはコスト帰属が必要である。 |
| 分散実行が失敗した場合のサポート経路はどうなっているか。 | 本番運用前に、ログ、ノードID、エスカレーション手段が必要である。 |
| データ、モデル重み、チェックポイントの移行経路はどうなっているか。 | 移行コストもアーキテクチャの意思決定に含める必要がある。 |
プロバイダーのKubernetesを利用しても、受け入れテストの必要性はなくなりません。直接運用するレイヤーと、サービスレベルの証跡を通じて検証するレイヤーが変わるだけです。
セキュリティとマルチテナンシーのチェックリスト
GPUクラスターは、すぐに共有インフラストラクチャになることがよくあります。2つ目のチームがクラスターを使い始める前に、セキュリティを設計する必要があります。
最低限のコントロール:
- チーム、環境、またはワークロード境界ごとにNamespaceを分ける。
- アイデンティティプロバイダーに紐付けたRBAC。
- GPU、CPU、メモリ、ストレージ向けのResourceQuotaとLimitRange。
- 特権Pod、ホストマウント、ホストネットワーキング、デバイスアクセスに関する明示的なポリシー。
- シークレットの管理とローテーション。
- プライベートイメージレジストリのポリシー、署名、スキャン、またはアドミッションチェック。
- 送信トラフィック、データセットアクセス、サービス境界のためのネットワークポリシー。
- ジョブ送信、シークレットアクセス、イメージ使用、管理操作の監査ログ。
- ローカルNVMe、スクラッチボリューム、チェックポイント、ログ、失敗したジョブのデータクリーンアップルール。
クラスターが顧客データまたは独自のモデル重みを扱う場合、ワーカーノードは機密性の高いインフラとして扱ってください。GPUにアクセスできるPodは、高価値なデータ、モデルアーティファクト、認証情報にもアクセスできる可能性があります。
可観測性とコストモデル
本番環境のkubernetes gpu clusterには、同時に3つの視点が必要です。
- プラットフォームの視点: ノードの健全性、GPUの健全性、ネットワーク、ストレージ、キューの状態、Kubernetesイベント。
- ワークロードの視点: ジョブ所有者、イメージ、モデル、データセット、ランタイム、リトライ回数、終了理由、出力品質。
- 財務の視点: 割り当てられたGPU時間、有効なGPU時間、アイドル時間、失敗ジョブによる消費、受け入れられた単位あたりのコスト。
少なくとも以下を追跡してください。
- GPU使用率、GPUメモリ、電力、温度、エラーイベント。
- Pod、ジョブ、Namespace、ノードプール、モデル、チームのラベル。
- キュー待機時間とアドミッション理由。
- トレーニングスループット、チェックポイント時間、リストア時間。
- 推論レイテンシ、スループット、バッチサイズ、キャッシュヒット率、エラー率。
- ストレージスループットとオブジェクトストア転送時間。
- ノード障害、退避、プリエンプション、リトライ。
次に、コストを正規化します。
effective_kubernetes_gpu_cluster_cost =
  (compute + network + storage + support + idle + failed_runs + operations)
  / accepted_workload_units
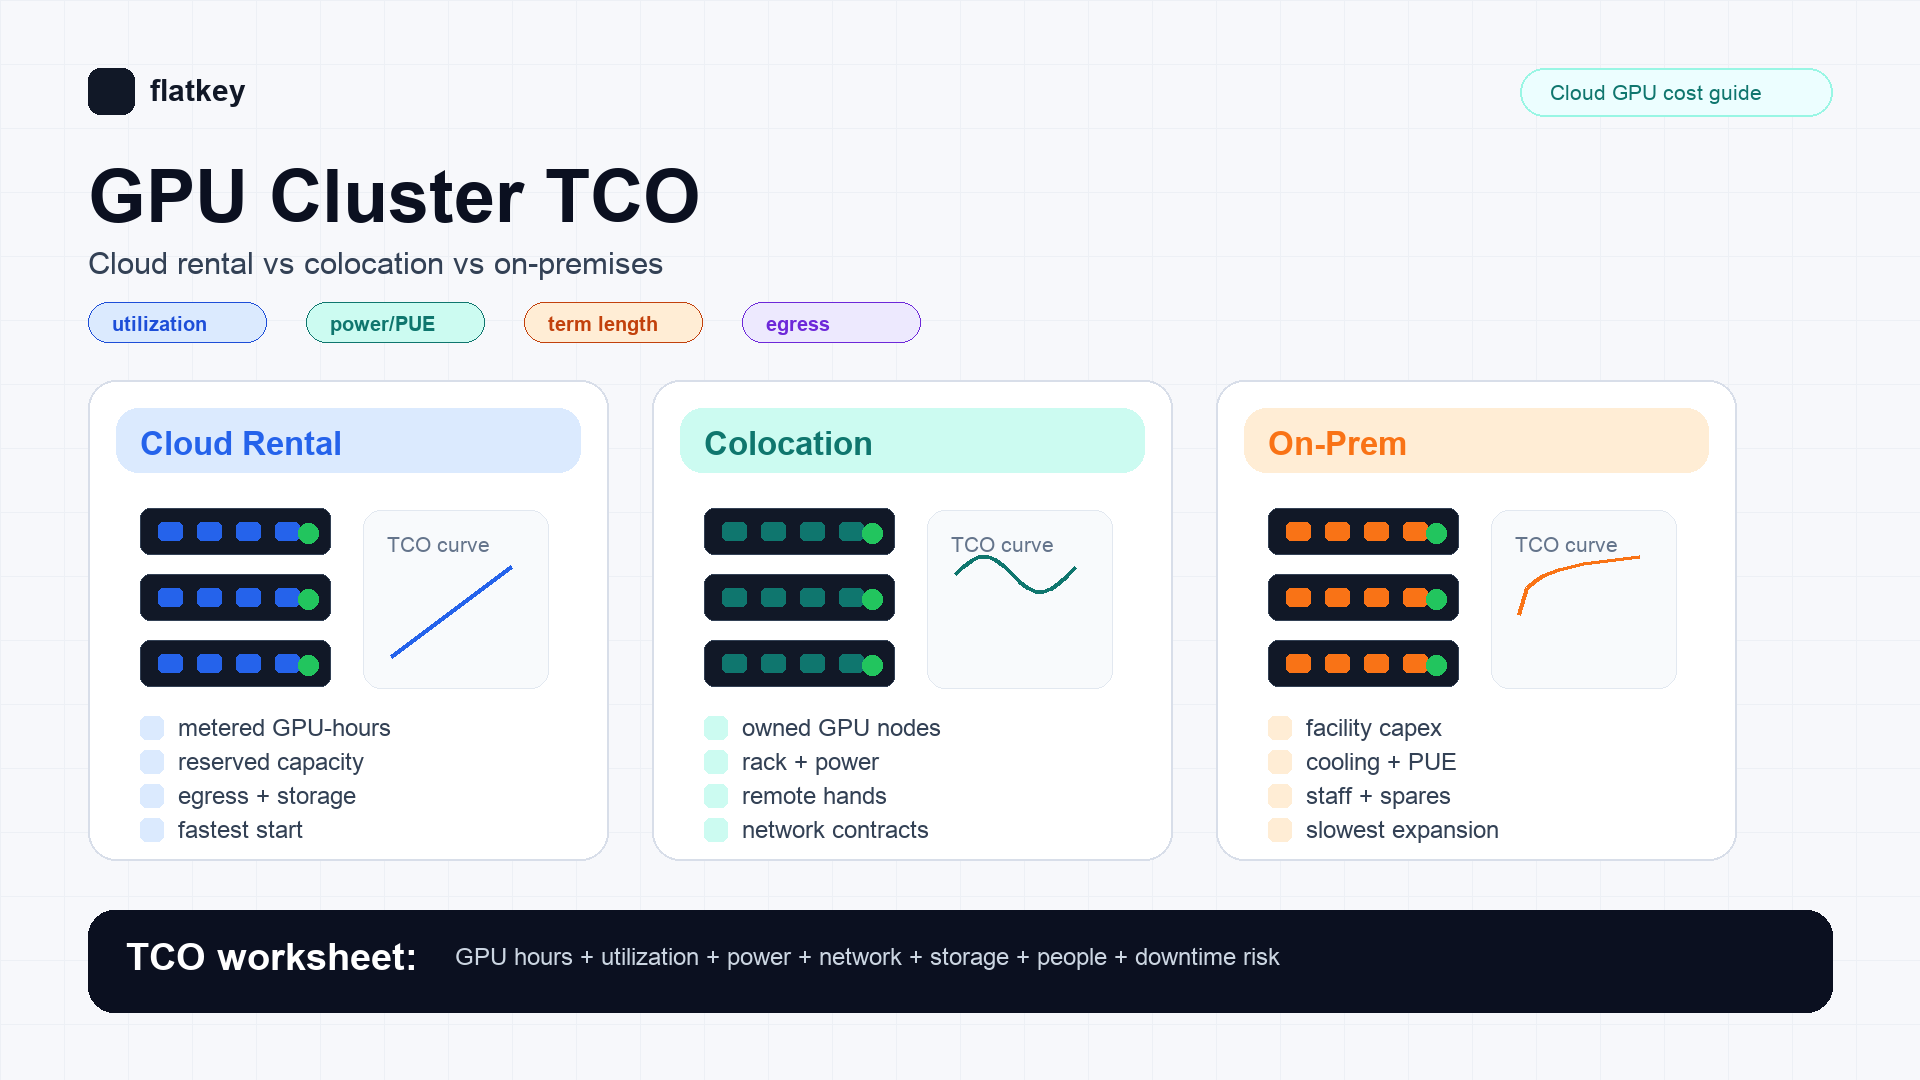
分母はビジネスに合わせる必要があります。完了したトレーニング実行、受け入れられたモデル出力、生成メディアジョブ、インデックス作成バッチ、または顧客リクエストなどです。より詳細なコストの枠組みについては、GPU cluster TCOワークシートを使用し、クラスターを拡張する前にGPU cloud vs model APIと比較してください。
実装チェックリスト
最初の本番環境向け構成を構築する順序として、以下を使用してください。
| フェーズ | 成果物 | 合格条件 |
|---|---|---|
| ワークロード概要 | 1ページのワークロード仕様 | チームがモデル、フレームワーク、データ、規模、SLA、コストの分母について合意している。 |
| ノードプール | GPUノード仕様とラベル | ノード構成、トポロジー、ドライバー、ランタイム、アップグレードポリシーが文書化されている。 |
| GPU公開 | デバイスプラグインまたはGPU Operatorをインストール済み | PodがGPUを要求でき、DCGMメトリクスが可視化されている。 |
| キューイング | Kueue、Volcano、または文書化されたスケジューリングポリシー | ユーザーがジョブを送信し、キュー/アドミッション状態を確認できる。 |
| ストレージ | データセット、モデルキャッシュ、チェックポイント、ログのパス | 強制的なPodまたはノード障害後にリストアテストに合格する。 |
| ネットワーク | ファブリックテストと本番トラフィックテスト | 分散ベンチマークまたは推論パスがワークロードのしきい値を満たす。 |
| セキュリティ | RBAC、Namespace、クォータ、シークレット、イメージポリシー | 新しいチームがcluster-adminアクセスなしでオンボーディングできる。 |
| 可観測性 | ダッシュボードと使用量エクスポート | 運用担当者が、誰がどのGPUを使用したか、またジョブが失敗した理由を回答できる。 |
| 受け入れ | エンドツーエンドのワークロード実行 | 有用な出力がモデル/APIまたはレンタルのベースラインを上回る、もしくはそのコストを正当化できる。 |
このチェックリストが当たり前に実行できるようになるまでは、8基のGPUから80基のGPUへスケールしないでください。当たり前であることが目標です。再現可能なジョブ送信、予測可能な配置、既知の障害復旧、可視化されたコスト、明確な所有責任が必要です。
よくある間違い
- データ移動とチェックポイント復旧を実証する前にGPU容量を購入する。
- デバイスプラグインをプラットフォーム全体と見なす。
- 優先順位と分離ルールなしに、同じノードプールでトレーニングと本番推論を混在させる。
- 共通ラベルなしに、すべてのチームが独自のPod仕様を作成することを許可する。
- 割り当てGPU時間は追跡するが、有効な作業を追跡しない。
- クラスターがすでに過負荷になるまでキューポリシーを後回しにする。
- マネージドKubernetesがマネージドAIインフラを意味すると考える。
- クリーンなイメージでベンチマークを実行し、本番では別のイメージを使用する。
- データセット、重み、チェックポイント、ログの退出パスを忘れる。
これらの間違いは、受け入れられる成果を生み出さずに貴重なGPU時間を消費するため、高コストです。
FAQ
Kubernetes GPUクラスターとは何ですか?
Kubernetes GPUクラスターとは、GPU対応ワーカーノード、デバイス公開、スケジューリングポリシー、ストレージ、ネットワーキング、可観測性が構成されたKubernetesクラスターです。これにより、Podとジョブはトレーニング、推論、バッチ処理、研究ワークロードのためにアクセラレーターを使用できます。
NVIDIA GPU Operatorは必要ですか?
必ずしも必要ではありません。ただし、多くのNVIDIAベースのKubernetes GPUプラットフォームでは、ドライバー、ランタイム、デバイスプラグイン、MIG、テレメトリーコンポーネントをOperator管理のワークフローにまとめているため、その導入を検討します。一部のマネージドプロバイダーは、このスタックの一部を代行して管理します。そのため、自分でインストールする前に、管理責任の境界を確認してください。
Kubernetes GPUクラスターにKueueは必要ですか?
Kueueはすべてのクラスターに必要なわけではありませんが、限られたGPU容量をチーム間またはバッチAIジョブ間で共有する場合は、評価する価値があります。キュー層がないと、ユーザーはジョブが待機する理由やクォータが拒否される理由を把握しにくくなることがよくあります。
Kubernetesでマルチノードトレーニングを実行できますか?
はい。ただし、マルチノードトレーニングにはGPUスケジューリング以上のものが必要です。配置、高速ネットワークの検証、互換性のあるコンテナ、チェックポインティング、そして多くの場合キューイングまたはギャングスケジューリングの動作が必要です。大規模な容量を確保する前に、正確なノードプールと本番イメージをテストしてください。
推論とトレーニングは同じGPUクラスターを共有すべきですか?
共有することはできますが、明確なノードプール、優先度ルール、クォータ、分離がある場合に限ります。本番推論には通常、レイテンシーと可用性の要件があり、大規模なトレーニングジョブと競合します。負荷下で共有ポリシーを実証できない限り、まずは分離してください。
Kubernetes GPUクラスターではなくモデルAPIを使用すべきなのはどのような場合ですか?
モデルの出力だけが必要な場合、使用するモデルの組み合わせが頻繁に変わる場合、使用率が低い場合、またはチームがGPUドライバー、キュー、ストレージ、監視、インシデントの運用準備ができていない場合は、まずモデルAPIを使用してください。制御、プライバシー、カスタムウェイト、またはワークロードの経済性が運用負荷を正当化する場合に、クラスターを構築します。
公式リファレンス
- Kubernetes: GPUのスケジューリング
- Kubernetes: デバイスプラグイン
- Kubernetes: 動的リソース割り当て
- Kubernetes: Podのノードへの割り当て
- NVIDIA GPU Operator
- NVIDIA: GPU Operatorのインストール
- NVIDIA: DCGM Exporterのインストール
- Kueueの概念
- Volcanoギャングスケジューリング
- Kubeflow Trainerの概要
まとめ
kubernetes gpu clusterは、KubernetesによってアドホックなGPUマシンやマネージドAPIよりも、AIインフラの配置、再現性、セキュリティ、可観測性、コストを適切に制御できる場合に構築する価値があります。対象を絞ったワークロードから始め、ノードプールを実証し、GPUを適切に公開し、競合が始まる前にキューイングを追加し、GPUの生の割り当てではなく有用な出力を測定してください。
クラスターが、受け入れられた作業において、よりシンプルなGPUレンタルやモデル/APIの選択肢を上回れない場合は、拡張しないでください。上回れる場合、Kubernetesは希少なアクセラレーターを共有AIプラットフォームへと変えるコントロールプレーンになります。