
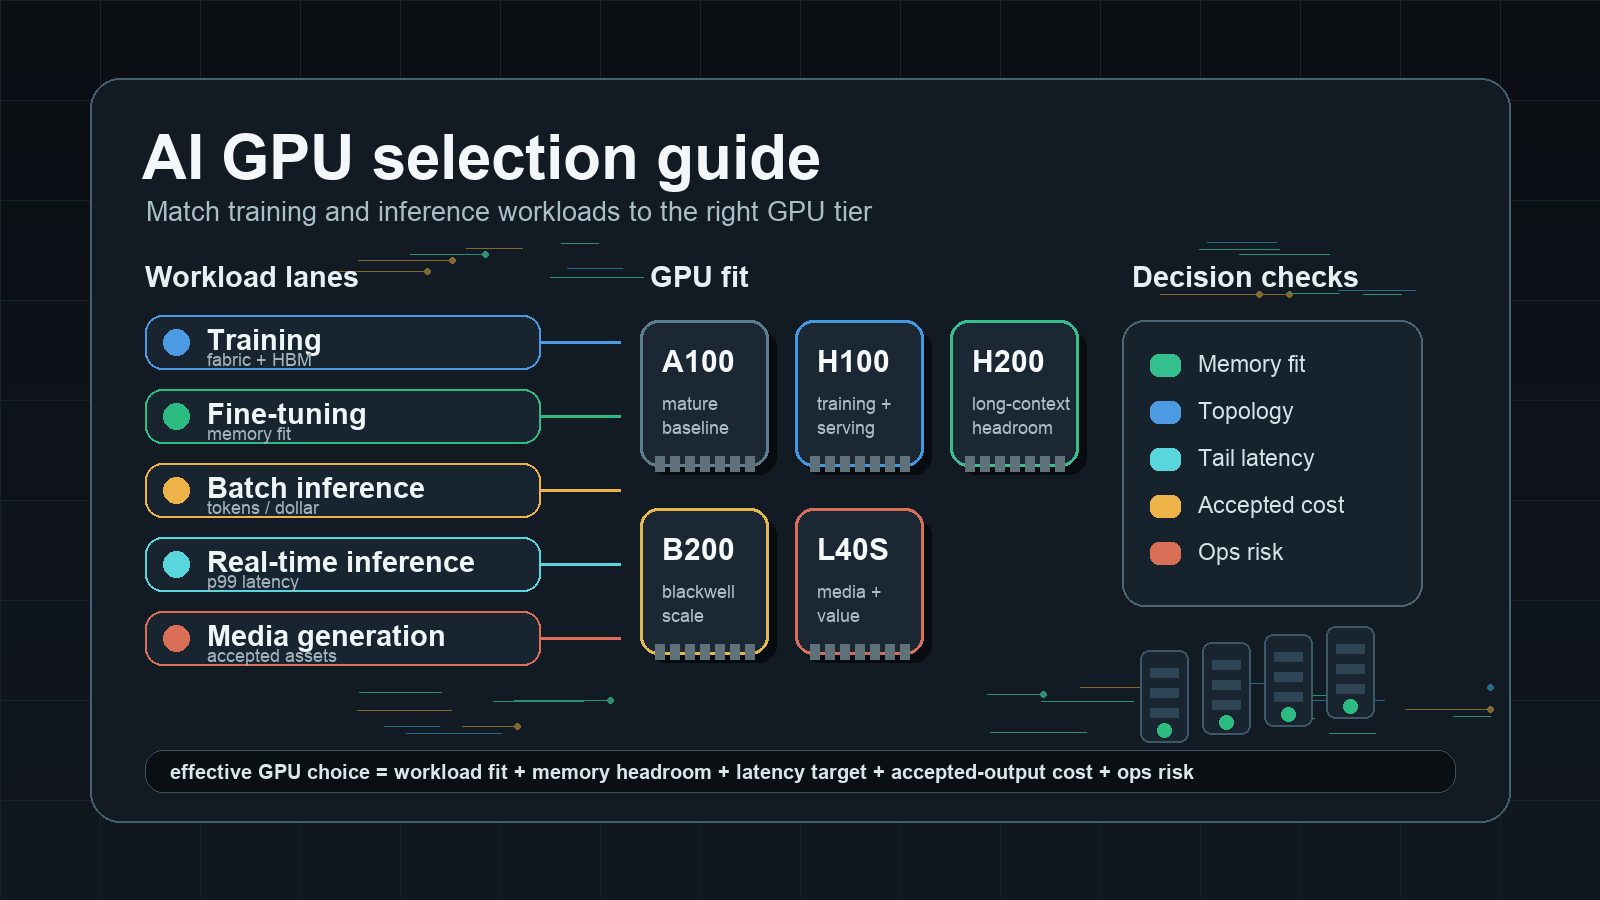
AI GPU選定ガイド: 学習と推論のワークロードに最適なGPUを選ぶ
AI GPU選定ガイドは、最新のアクセラレータ名ではなく、ワークロードから始めるべきです。学習、ファインチューニング、バッチ推論、リアルタイム推論、検索パイプライン、メディア生成、評価ジョブは、それぞれ異なる形でGPUに負荷をかけます。間違ったGPUは料金表上では魅力的に見えても、メモリ適合性、ネットワークトポロジー、アイドル時間、キューイング、サービングスタックの作業、そして受け入れられる出力品質を加味すると、最終的には不利になることがあります。
このAI GPU選定ガイドを、調達とアーキテクチャのチェックリストとして活用してください。一般的なAIワークロードと重要なGPU特性を対応づけ、H100、H200、B200、A100、L40S、GB200クラスのシステム、そしてローカルのRTXクラスGPUがどのような場面で適するかを説明し、合成的なピーク数値ではなく、完了した作業に結びつくベンチマーク計画を示します。
Flatkeyの実践的なルールは、完了した学習ランあたりのコスト、受け入れられたトークンあたりのコスト、受け入れられた画像または動画あたりのコスト、そして自分たちが引き受けられる運用リスクでGPUを選ぶことです。モデルへのアクセス、ガバナンス、フェイルオーバー、単一の利用台帳だけが必要なら、ハードウェアを導入する前にGPUレンタルとモデル/API経路を比較してください。
AI GPU選定ガイドのクイックアンサー
プロバイダーの見積もりを比較する前に、まずこのマトリクスから始めてください。
| ワークロード | 通常重視するもの | GPUの方向性 | 注意点 |
|---|---|---|---|
| 事前学習または大規模学習 | マルチノードファブリック、HBM容量、メモリ帯域、BF16/FP8スループット、チェックポイントI/O | H100/H200、B200/GB200クラスのシステム、マネージド学習クラスター | 時間単価よりも、完了までの時間と再起動リスクのほうが重要 |
| フルファインチューニング | メモリの余裕、オプティマイザ状態の収まり、テンソル並列化、ストレージの局所性 | H100、H200、B200、小規模モデル向けのA100 | VRAM不足により、より遅いシャーディングや小さなバッチサイズを強いられることがある |
| LoRA/QLoRAファインチューニング | VRAM適合性、CUDA互換性、ドルあたりのスループット | A100、L40S、H100、H200、小規模ジョブ向けの高性能ローカルGPU | データセットとコンテキスト長でメモリ要件は変わる |
| バッチLLM推論 | メモリ適合性、バッチ効率、トークンあたりのコスト、キュー許容度 | モデルサイズに応じてL40S、A100、H100、H200、B200 | 利用率が低いと、安価なGPU料金の利点が消えることがある |
| リアルタイムLLM推論 | p95/p99レイテンシ、KVキャッシュ容量、ストリーミングの安定性、サービングフレームワークのサポート | 大規模または長文脈モデル向けのH100/H200/B200; 小規模モデル向けのL40S/A100 | ピークトークン/秒よりも、テールレイテンシと再試行のほうが重要 |
| 埋め込みと再ランキング | ドルあたりのスループット、CPU/GPUバランス、バッチサイズ、サービスのシンプルさ | L40S、A100、小規模クラウドGPU、低トラフィックではCPUの場合もある | トラフィックが少ないとGPUの過剰性能になりがち |
| 画像・動画生成 | VRAM、メディア向けカーネル、ストレージスループット、キュー許容度 | L40S、より重いパイプライン向けのH100/H200/B200、クリエイター向けのRTXクラスのローカルワークステーション | 生のレンダリング速度よりも、エンドツーエンドで受け入れられた画像/クリップあたりのコストが重要 |
| 評価と合成データ | バースト容量、コスト管理、モデルの多様性 | スポット/マーケットプレイスGPU、バッチAPI、またはモデル/API経路 | たまに起こるスパイクのためにアイドル容量を所有しないこと |
このクイックアンサーは、意図的に「最速のGPUを買う」とはしていません。エンタープライズAIチームにとって最適なGPUは、モデル、コンテキスト長、レイテンシ目標、同時実行数、データ境界、そしてチームの運用モデルに適合するものです。
ステップ1: ワークロードを分類する
AI GPU選定ガイドの最初のステップは、ワークロードの分類です。これがなければ、その後の比較はすべて一般論のアクセラレータ議論に崩れてしまいます。
GPUの議論は必ずワークロードの要件定義から始めるべきです。ベンダーに見積もりを依頼する前に、書き出してください。
| 項目 | 記録する内容 |
|---|---|
| ワークロード種別 | 学習、ファインチューニング、バッチ推論、オンライン推論、メディア生成、埋め込み、評価、またはノートブック |
| モデル形状 | パラメータ数、アーキテクチャ、精度、量子化、コンテキストウィンドウ、モダリティ、トークナイザーの挙動 |
| リクエスト形状 | 平均およびp95の入力トークン、出力トークン、画像サイズ、動画長、バッチサイズ、同時セッション数、またはジョブあたりのレコード数 |
| 成功単位 | 完了した学習ラン、受け入れられたパッチ、受け入れられた応答、受け入れられたトークン、受け入れられた画像、受け入れられたクリップ、または受け入れられたレコード |
| レイテンシ目標 | オフライン、分単位、秒単位、サブ秒、p95/p99要件、またはストリーミング要件 |
| 稼働形態 | 常時稼働、定期バッチ、季節的バースト、実験用途、または開発者向けノートブック |
| 運用境界 | パブリッククラウド、プライベートネットワーク、専用クラスター、オンプレミス、データレジデンシー、またはマネージドAPI |
| ツール群 | vLLM、SGLang、TensorRT-LLM、Triton、Ray、Slurm、Kubernetes、ComfyUI、またはプロバイダー管理のエンドポイント |
この表を埋められないなら、GPU選定はいったん止めてください。まだ容量ではなく、可能性を買おうとしている段階です。
ステップ2: 適切な判断指標を選ぶ
AI GPU選定ガイドの2つ目のステップは、分母を選ぶことです。良い分母は、GPUの判断をベンダーの仕様書ではなく、完了した作業に結びつけます。
ピークFLOPS、Tensor Core数、1時間あたりのGPU価格は有用な入力ですが、意思決定指標ではありません。ビジネス成果に結びつく分母を使いましょう。
| ワークロード | より適切な指標 |
|---|---|
| Training | 目標の評価スコアに到達した完了済み学習ランのコスト |
| Fine-tuning | 受け入れられた微調整チェックポイント1件あたりのコスト |
| Online inference | p95/p99レイテンシ目標を満たした受け入れ済み応答1件あたりのコスト |
| Batch inference | 受け入れ済みレコード1件、または受け入れ済み出力トークン1件あたりのコスト |
| Code agents | 受け入れ済みタスク、受け入れ済みパッチ、または解決済みIssue1件あたりのコスト |
| Image generation | 品質フィルター通過後の受け入れ済み画像1枚あたりのコスト |
| Video generation | 受け入れ済み秒数、または受け入れ済みクリップ1件あたりのコスト |
| Evaluation | 完了した評価スイート1件あたりのコストと応答時間 |
次の基本式を使います:
effective_unit_cost =
  all_in_workload_cost
  / accepted_outputs_after_retries_failures_and_quality_filters
学習の場合:
training_run_cost =
  gpu_hours
  + storage
  + network
  + checkpointing
  + failed_run_waste
  + platform_labor
推論の場合:
inference_cost_per_accepted_output =
  gpu_compute
  + storage
  + serving_stack
  + idle_capacity
  + retry_waste
  + observability
  + platform_labor
  / accepted_outputs
ここでGPU選定は変わります。スループットベンチマークで勝つGPUでも、高価なトポロジーを必要としたり、低い利用率で動作したり、レイテンシ目標を満たせなかったり、追加の運用作業を強いたりすると、負けることがあります。
学習向けGPU選定
学習においては、AI GPU選定ガイドはクラスタガイドのように機能すべきです。個々のGPUは重要ですが、配置、相互接続、ストレージ、再開時の挙動が、完了済みランのコストを左右することが多くあります。
学習では、大容量メモリ、高いメモリ帯域、GPU間の高速ネットワーク、安定したマルチノード配置、そしてチェックポイントの信頼性が求められます。1台のノード障害で何時間、何日分もの計算が無駄になる可能性があるため、推論よりも許容度が低いです。
学習で最も重要な要素
- HBM容量: モデルパラメータ、勾配、オプティマイザ状態、活性、シーケンス長、バッチサイズがすべてメモリを奪い合います。
- メモリ帯域: 大規模行列演算やオプティマイザ更新は帯域制約を受けることがあります。
- 相互接続: NVLink、NVSwitch、InfiniBand、RoCE、EFA、またはプロバイダー固有のAIファブリックが、スケーリングの効率を左右します。
- 精度対応: BF16、FP8、その他の新しい低精度経路は、フレームワークとモデルレシピが安全に使用できる場合にのみ重要です。
- ストレージとチェックポイントI/O: チェックポイントの書き込み時間と復旧時間は、完了済みランのコストに含まれます。
- 配置の信頼性: 脆弱なファブリック上に分散した適切なGPUは、一体的な学習クラスタとは同じではありません。
学習向けGPUの方向性
Hopper世代の学習サポートが実績として必要で、かつフレームワークの成熟度が広く求められる場合は、H100またはH200を使います。H200はH100よりもHBM容量と帯域が増えており、メモリを多く使う学習やファインチューニングに有用です。ワークロードがBlackwell世代のスループット、低精度経路の恩恵を受けられ、さらにプロバイダーが必要なトポロジー、フレームワークサポート、受け入れテストを実際に提供できるなら、B200またはGB200クラスのシステムを使います。モデルが小さく、学習レシピが成熟していて、予算が限られているか、ピーク性能より可用性が重要な場合は、A100を使います。
学習GPUを1つのベンチマークだけで選ばないでください。実際のレシピ、またはそれに近いプロキシで試します。目標の評価スコアに到達するまでの時間、再開時の挙動、チェックポイント時間、そして総コストを測定してください。H100 vs A100 や H200 vs H100 の判断は、通常は時間単価ではなく、完了済みランの観点で行う判断です。
関連する参考資料: H100 vs A100、H200 vs H100、B200 vs H200、および B300 vs B200。
ファインチューニング向けGPU選定
ファインチューニングは学習と推論の中間に位置します。フルファインチューニングは学習のように振る舞いますが、LoRAやQLoRAは、モデルサイズ、コンテキスト長、バッチサイズ、精度を制御できるなら、より小さなハードウェアでも実行できます。
フルファインチューニング
フルファインチューニングでは、まずメモリとトポロジーを優先します。GPUは学習状態を保持するか、それを効率よく分割できなければなりません。H100、H200、B200、およびマルチGPUのA100クラスタは、モデルサイズと予算に応じた一般的な選択肢です。H200やB200クラスのGPUは、メモリを多く使うジョブで分割の負担を減らせますが、プロバイダースタックとフレームワークのバージョンが準備できている場合に限られます。
確認すべき質問:
- ファインチューニングしなければならない最大のモデルとコンテキスト長は何ですか?
- オプティマイザ状態は完全にロードされますか、分割されますか、オフロードされますか、それとも量子化されますか?
- ジョブにはテンソル並列、パイプライン並列、FSDP、DeepSpeed、または別の分散手法が必要ですか?
- データセットはGPUリージョン内にありますか?
- 失敗したチェックポイントのコストはどの程度ですか?
アダプターファインチューニング
LoRA、QLoRA、Instruction Tuning、および小規模なドメイン適応では、答えはより柔軟になり得ます。A100、L40S、H100、H200、そしてローカルのRTXクラスGPUは、ワークフローの異なる部分に適合する場合があります。リスクは、小さなデモが通ったからといって本番ジョブも収まると考えてしまうことです。より長いコンテキスト、より大きいバッチサイズ、より多くの例、検証実行によって、ジョブは別のクラスに押し上げられる可能性があります。
これは、2段階ベンチマークを実行するのに適した場所です。まずメモリに収まることを確認し、次にチェックポイントまでの時間と、受け入れられたファインチューニング済みモデル1件あたりのコストを確認します。
LLM推論向けGPU選定
推論では、AI GPU選定ガイドはメモリ適合とレイテンシ適合を分けて考えるべきです。GPUはモデルを読み込めても、本番のp99目標を満たせないことがあります。
推論は単一のワークロードではありません。適切なGPUは、モデルサイズ、コンテキスト長、同時実行数、レイテンシ目標、そしてリクエストがバッチかリアルタイムかによって変わります。
まずメモリ適合が先
LLM推論では、GPUメモリにモデル重みとKVキャッシュが収まり、さらにサービングフレームワーク用の余裕が必要です。長いコンテキストと高い同時実行数は、KVキャッシュを主要なメモリ圧迫要因にすることがあります。1ユーザー向けには収まるGPUでも、本番の同時実行数では不足することがあります。
次のチェックリストを使用してください:
- 精度に応じた重みサイズ: FP16、BF16、FP8、INT8、INT4、または別の量子化形式。
- コンテキストウィンドウと想定p95入力長。
- 出力長とストリーミング挙動。
- 同時セッション数とバッチサイズ。
- KVキャッシュ戦略、プレフィックスキャッシュ、エビクション挙動。
- サービングフレームワークのオーバーヘッド。
- スパイクと断片化に対する安全マージン。
メモリが厳しい場合は、理論上はより高速な小容量メモリのGPUよりも、大容量メモリのGPUのほうが、シャーディング、オフロード、または低品質な量子化を避けられるため優れることがあります。
リアルタイム推論
リアルタイム推論では、平均スループットだけでなくp95およびp99レイテンシが重要です。H100、H200、B200クラスのGPUは、一般に大きなモデル、長いコンテキスト、レイテンシに敏感なワークロードにより適しています。L40SとA100は、小規模モデル、低い同時実行数、またはp99目標がそれほど厳しくないワークロードでは、コスト効率の高い選択肢になりえます。
測定する項目:
- 最初のトークンまでの時間。
- トークン間レイテンシ。
- p95/p99のエンドツーエンドレイテンシ。
- GPUあたりの1秒あたりトークン数。
- ドルあたりの受け入れトークン数。
- バーストトラフィック下でのエラー率。
- レート制限、OOM、またはデプロイ時のリトライ増幅。
サービングスタックの選定については、vLLM vs SGLang と vLLM deployment guide を参照してください。
バッチ推論
バッチ推論では、レイテンシをスループットと引き換えにできます。これにより、より多くのGPU選択肢が開けます。モデルが収まり、使用率が高いなら、L40S、A100、H100、H200、B200はいずれも妥当です。判断基準は通常、バッチ実行時間内のドルあたり受け入れ出力数です。
バッチワークロードは、再試行挙動が制御されている場合、スポット、予約枠、またはサーバーレスGPUキャパシティにも適しています。同じバッチを運用負荷の少ないモデルAPIに送れるなら、GPU cloud vs model API のワークシートで両方の経路を比較してください。
メディア生成向けGPU選定
画像および動画生成は、テキスト推論とは異なる挙動を示すことがよくあります。VRAM、モデルパイプラインの複雑さ、ストレージI/O、キューイング許容度のほうが、会話レイテンシより重要です。
L40Sは、H100クラスGPUより低い調達階層でありながら強力な推論性能とグラフィックス指向の特性を持つため、画像や小規模なメディアワークロードにしばしば魅力的です。H100、H200、B200は、ワークロードがより重い、より大きい、マルチモーダルである、または厳しくレイテンシ制約がある場合に、より重要になります。ローカルのRTXクラスのワークステーションは、クリエイター、プロトタイピング、低ボリュームのパイプラインに有用ですが、本番チームには依然としてキューイング、ストレージ、リトライ、可観測性が必要です。
生のレンダリング時間ではなく、受け入れられた画像やクリップのコストを使ってください:
media_accepted_cost =
  gpu_cost
  + storage
  + failed_renders
  + moderation_or_quality_filtering
  + queue_overhead
  + operator_review
  / accepted_assets
チームが複数の画像または動画モデルへのアクセスだけを必要とするなら、GPUメディアパイプラインを運用するよりもモデル/API経路のほうが簡単かもしれません。テキストと同じ調達基準、つまり一覧価格だけでなく、受け入れられた成果物1件あたりのコストを使って比較してください。
GPUモデル早見表
この表は出発点として使用し、その後、公式プロバイダーページで最新の仕様と提供状況を確認してください。価格表として扱わないでください。
| GPUファミリー | 実用上の役割 | 最適な兆候 | よくある注意点 |
|---|---|---|---|
| NVIDIA A100 | 学習と推論の成熟したベースライン | 既存のレシピ、40GB/80GBバリアント、幅広いクラウドでの提供、予算重視のワークロード | 旧世代であり、H100/H200/B200よりメモリ帯域幅と新しい精度パスが低い |
| NVIDIA H100 | Hopper世代の学習・推論向け主力機 | 高いフレームワーク成熟度、FP8 Transformer Engine対応、高いメモリ帯域幅、NVLink/NVSwitchオプション | 供給と価格は依然として制約を受ける場合がある。非常に長いコンテキストや高同時実行の推論ではメモリが不足する可能性がある |
| NVIDIA H200 | より大容量メモリのHopperオプション | H100より大きいHBM容量と帯域幅。長文コンテキスト推論やメモリ負荷の高いジョブに有用 | 提供状況と価格は変動する。実際のワークロードでH100と比較してベンチマークを行うこと |
| NVIDIA B200 | Blackwell世代のアクセラレータ | 重い学習と推論、新しい低精度パス、大容量メモリと帯域幅 | スタックの準備状況、提供事業者の可用性、トポロジーの検証が必要 |
| NVIDIA GB200 / rack-scale systems | 大規模学習と高密度推論 | GPUシリコンと同じくらいシステムアーキテクチャが重要なクラスタ規模のジョブ | 調達と運用は単一GPUの判断ではなく、システム全体の判断になる |
| NVIDIA L40S | コスト重視の推論とメディア処理 | 48GB級メモリ、画像/動画パイプライン、小規模LLM推論、バッチジョブ | 大規模学習や厳しいp99 LLM推論ではH100/H200の普遍的な代替にはならない |
| RTX-class local GPUs | ローカルでの実験とクリエイター向けワークフロー | プロトタイピング、小規模モデル、プライベートワークステーションでの反復作業 | メモリが限られ、データセンター運用の面が弱く、単体では本番クラスタにはならない |
この表が示さない重要な調達の真実があります。GPUモデルは答えの一部にすぎません。ノード形状、ストレージ、スケジューラ、相互接続、クォータモデル、サポート品質が、そのGPUを有用にできるかを左右します。
調達チェックリスト
購入またはレンタルの前に、提供事業者へ次の詳細を確認してください。
ハードウェアとトポロジー
- 正確なGPUモデル、メモリ容量、ノード形状、ノードあたりのGPU数。
- ノード内およびノード間の相互接続。
- CPU、RAM、ローカルNVMe、ストレージ帯域幅、ネットワーク帯域幅。
- リージョン、ゾーン、配置グループ、ラック、または専用クラスタに関する前提。
- GPU、ノード、ストレージ、ネットワーク機器の故障時の交換手順。
ソフトウェアスタック
- ドライバ、CUDA、cuDNN、NCCL、コンテナランタイム、対応フレームワークのバージョン。
- Kubernetes、Slurm、マネージドエンドポイント、またはベアメタルアクセスのモデル。
- vLLM、SGLang、TensorRT-LLM、Triton、Ray、またはメディアパイプラインのサポート。
- GPU使用率、メモリ、キュー待機、レイテンシ、エラー、支出に関する可観測性フィールド。
- アップグレードとロールバックの手順。
商用モデル
- オンデマンド、スポット、予約、マーケットプレイス、専用クラスタ、プライベートクラウド、またはマネージドエンドポイント。
- 最低契約、解約権、超過料金、サポート階層。
- ストレージ、エグレス、スナップショット、パブリックIP、ロードバランサー、プライベートネットワークのコスト。
- 利用実績のエクスポート形式と請求書の粒度。
- アイドル容量が課金対象かどうか、シャットダウン自動化の仕組み。
セキュリティとガバナンス
- ネットワーク境界、VPC/VNetモデル、プライベートエンドポイント対応、エグレスポリシー。
- IAM、シークレット管理、監査ログ、サポートアクセス、インシデント通知。
- データ保存、チェックポイント保持、バックアップ、削除、リーガルホールド。
- コンプライアンス証跡とベンダー審査支援。
- チームごとの予算、クォータ、タグ、チャージバック/ショーバック対応。
このチェックリストは、パブリックGPUクラウド、プライベートGPUクラウド、GPUクラスタレンタルに適用されます。コミットメントが深いほど、より多くの証拠を求めるべきです。
ベンチマーク計画: 契約前にどう試すか
これはAI GPU選定ガイドの中で、調達の証拠として残すべき部分です。後で財務チームやプラットフォームチームが判断をレビューできるよう、入力、出力、受け入れ基準を保存してください。
ワークロードに近いベンチマークを実行してください。公開ベンチマーク表だけに頼ってはいけません。
フェーズ1: メモリ適合テスト
- 対象モデルそのもの、または最も近い代替を読み込む。
- 想定する精度と量子化を使用する。
- 目標コンテキスト長とバッチサイズを設定する。
- 代表的なプロンプトまたはレコードを実行する。
- ピークメモリ、断片化、OOM率、安全な余裕を記録する。
フェーズ2: スループットとレイテンシのテスト
- 定常トラフィックとバーストトラフィックをテストする。
- p50、p95、p99レイテンシを測定する。
- ストリーミングLLMワークロードでは、最初のトークンまでの時間を測定する。
- tokens/sec、images/hour、clips/hour、またはrecords/hourを測定する。
- 生成された出力だけでなく、受け入れられた出力を記録する。
フェーズ3: 障害と運用のテスト
- ワーカーを停止し、ノードをドレインし、サービングスタックを再起動し、悪いデプロイをシミュレートする。
- 学習とファインチューニングのチェックポイント復旧を検証する。
- コールドスタート時間とモデル読み込み時間を確認する。
- ログとメトリクスがプラットフォーム、セキュリティ、財務の各チームに利用可能であることを確認する。
- コスト配賦が再試行と障害をまたいで保持されることを検証する。
フェーズ4: 財務の正規化
候補ごとに1行作成します:
| 候補 | GPUコスト | ストレージ/ネットワーク | プラットフォーム人件費 | 失敗による無駄 | 承認済み出力 | 実効単価 | 備考 |
|---|---|---|---|---|---|---|---|
| Provider A H100 | 見積もりから入力 | 出典確認済みの追加費用を加算 | 見積もり | 測定値 | 測定値 | 算出値 | p95レイテンシを含める |
| Provider B H200 | 見積もりから入力 | 出典確認済みの追加費用を加算 | 見積もり | 測定値 | 測定値 | 算出値 | メモリの余裕を含める |
| Model/API route | 出典確認済みのAPIコスト | ゲートウェイ/運用コスト | 低めの運用見積もり | 測定済み再試行 | 測定値 | 算出値 | 品質の受け入れを含める |
これにより、AI GPU選定ガイドは、財務、プラットフォーム、製品が確認できる意思決定記録になります。
借りる、予約する、購入する、それともModel APIを使う?
このAI GPU選定ガイドの最後のステップは、そのキャパシティを借りる、予約する、購入する、あるいはModel APIによって回避するかを決めることです。
GPUのモデル選定とキャパシティモデル選定は別の判断です。
| 状況 | より適した出発点 |
|---|---|
| 需要が不確実、モデルが変化中、またはプロトタイプ | Model APIまたは短期レンタル |
| 突発的な実験や評価ジョブ | スポット/マーケットプレイスGPUまたはバッチModel API |
| 1つのモデルで安定した大規模推論 | 予約済みGPU、専用エンドポイント、またはコミット済みクラスタ |
| トポロジ要件のあるマルチノード学習 | 専用学習クラスタまたは予約済みの高速ファブリック |
| 厳格なプライベートネットワークまたはハードウェア分離 | プライベートGPUクラウドまたは専用クラスタ |
| 多数の公式モデル、1つの請求書、フォールバックが必要 | Flatkeyで管理されたmodel/APIルート |
GPUを選ぶ理由が主に「AIモデルへのアクセスが必要だから」であれば、model/APIルーティングから始めます。理由が「トポロジ、実行環境、重み、データ境界、またはカスタムカーネルを制御する必要があるから」であれば、GPUの選択肢を開いたままにしておきます。この違いは重要です。なぜなら、GPUインフラにはスケジューラ、ランタイム、セキュリティ、FinOps、そしてインシデント対応の責任が伴うからです。
Flatkeyはその判断のAPI側を支援します: 1つのキー、1つの残高、1つの請求書、利用台帳の管理、そして公式のモデル/ツールルートです。ハードウェア制御が要件である場合、それは代替ではありません。本当の要件が、統制されたモデルアクセスとコスト可視化であるときの、よりシンプルな選択肢です。
GPU選定でよくあるミス
ミス1: 時間単価だけで選ぶ
時間単価だけでは、利用率、再試行、アイドル時間、ストレージ、ネットワーク、サポート、そしてエンジニアの工数が抜け落ちます。完了したワークロードのコストで判断してください。GPUレンタル価格ガイドでは、隠れたコスト項目を説明しています。
ミス2: メモリに収まるかを単純なはい/いいえで捉える
あるプロンプト長やバッチサイズでメモリに収まることは、本番での適合を証明しません。長いコンテキスト、高い同時実行数、モデル切り替え、サービングフレームワークのオーバーヘッドによって答えは変わります。
ミス3: インターコネクトを無視する
マルチGPUおよびマルチノードのジョブでは、トポロジもGPUの一部です。配置の弱い安価なGPUプールは、より高価でも一貫性のあるクラスタに負けることがあります。
ミス4: 承認済み出力ではなく生成出力をベンチマークする
AIワークロードには、品質フィルタ、安全性フィルタ、再試行、失敗した生成、失敗したパッチ、失敗した評価があります。承認済み出力のコストを測定してください。
ミス5: プラットフォームの責任を忘れる
ドライバ、CUDA、コンテナ、モデルサーバー、自動スケーリング、クォータ、ログ、アラート、インシデント、支出レポートを運用する人が必要です。そのチームが存在しない場合は、その分を織り込んでください。
ミス6: 今日のモデルだけを前提に購入する
モデル選択は変わります。コンテキストウィンドウは拡大します。量子化は改善します。プロバイダーの提供状況は変化します。意思決定記録は柔軟に保ち、1つのモデルが今後も優勢であると仮定したコミットメントは避けてください。
確認すべき公式ソース
変動が大きい、またはベンダー固有の詳細には公式ページを使用してください:
- Hopper世代GPUの文脈でのNVIDIA H100の概要: NVIDIA H100 Tensor Core GPU。
- より大きなHBM3eメモリと帯域幅の文脈でのNVIDIA H200の概要: NVIDIA H200 Tensor Core GPU。
- Blackwellシステムの文脈でのNVIDIA Blackwell/DGX B200およびGB200関連資料: NVIDIA DGX B200 と NVIDIA GB200 NVL72。
- 成熟したAmpereのベースライン文脈でのNVIDIA A100の概要: NVIDIA A100 Tensor Core GPU。
- 推論およびグラフィックス/メディアワークロードの文脈でのNVIDIA L40Sページ: NVIDIA L40S。
- サポートされているGPUを分割する際のNVIDIA MIGドキュメント: NVIDIA Multi-Instance GPU User Guide。
- ランタイム適合性のためのサービングフレームワークのドキュメント: vLLM OpenAI-compatible server、SGLang documentation、および NVIDIA TensorRT-LLM。
- 現在の入手可能性とコストについては、プロバイダーの見積もりページおよび価格ページを確認してください。見積書にコピーする各価格には必ずタイムスタンプを付けてください。
よくある質問
AIトレーニングに最適なGPUは何ですか?
AIトレーニングに最適なGPUは、モデルサイズ、学習レシピ、メモリ要件、相互接続、チェックポイントの挙動、目標evalスコアまでの時間によって異なります。H100、H200、B200、GB200クラスのシステムは大規模トレーニングジョブに有力な候補ですが、A100も小規模または予算重視のワークロードでは十分に実用的です。選定前に、完了済み実行のコストでベンチマークしてください。
LLM推論に最適なGPUは何ですか?
LLM推論に最適なGPUは、p95/p99レイテンシーと許容されるトークン単価の目標を満たしつつ、モデル重みとKVキャッシュに収まるものです。H100、H200、B200は大規模または長文脈のワークロードに強いです。L40SとA100は、小規模モデル、バッチ推論、より緩いレイテンシー目標に対して効率的な場合があります。推論専用の計算については、LLM推論に最適なGPUの詳しいガイドを参照してください。
H200は常にH100より優れているのですか?
いいえ。H200はH100よりも大きなメモリ余裕と帯域幅を提供するため、メモリ集約型の推論やトレーニングに役立ちます。しかし、より良い選択は価格、入手可能性、フレームワークの成熟度、バッチサイズ、レイテンシー、そして実際にそのワークロードがメモリ制約を受けているかどうかに依存します。H100で目標をより低い実効コストで達成できるなら、H100が勝つこともあります。
H100の代わりにL40Sを選ぶべきなのはいつですか?
モデルが収まり、レイテンシー目標が中程度で、ドルあたりのメディア/推論スループットが重要で、H100クラスの容量を十分に使い切れない場合はL40Sを選びます。より大きなモデル、より厳しいp99レイテンシー、トレーニング、または高並列推論に強いデータセンター向けアクセラレータ性能が必要な場合はH100を選びます。
GPUを借りるべきですか、それともモデルAPIを使うべきですか?
ハードウェア制御、カスタムランタイム、プライベートなトポロジー、または安定したモデルでの継続的な高い利用率が必要な場合はGPUを借ります。需要が不確実、モデルが頻繁に変わる、最先端モデルへのアクセスが重要、またはチームにとってハードウェア制御よりもガバナンス、フェイルバック、台帳、そして請求書が1枚にまとまることが重要な場合はモデルAPIを使います。GPUクラウド vs モデルAPIと比較してください。
GPUの買いすぎをどう避ければよいですか?
正確なワークロードをベンチマークし、受理された出力を測定し、アイドル時間と運用を含め、小規模または管理された代替案を先に試すことで、買いすぎを避けられます。トラフィック、モデル選択、利用率が実証されてから、予約または購入してください。
結論
このAI GPU選定ガイドは、アクセラレータの順位付けではありません。GPUの意思決定を説明可能にするためのものです。ワークロードから始め、ビジネスに合った指標を選び、メモリ適合を検証し、スループットとテールレイテンシーをテストし、運用コストと障害による損失を含め、契約する前にモデル/APIの選択肢と比較してください。
多くのチームにとっての正解はハイブリッドです。真にハードウェア制御を必要とするワークロードにはGPUを使い、それ以外のオーバーフロー、最先端モデル、フェイルバック、使用台帳、そしてサービングスタックを運用すべきでないチームには、Flatkeyが管理するモデル/APIアクセスを使います。勝てるGPU選択とは、不要なインフラをチームに抱え込ませることなく、適切なコストで受理された作業を提供できるものです。


