
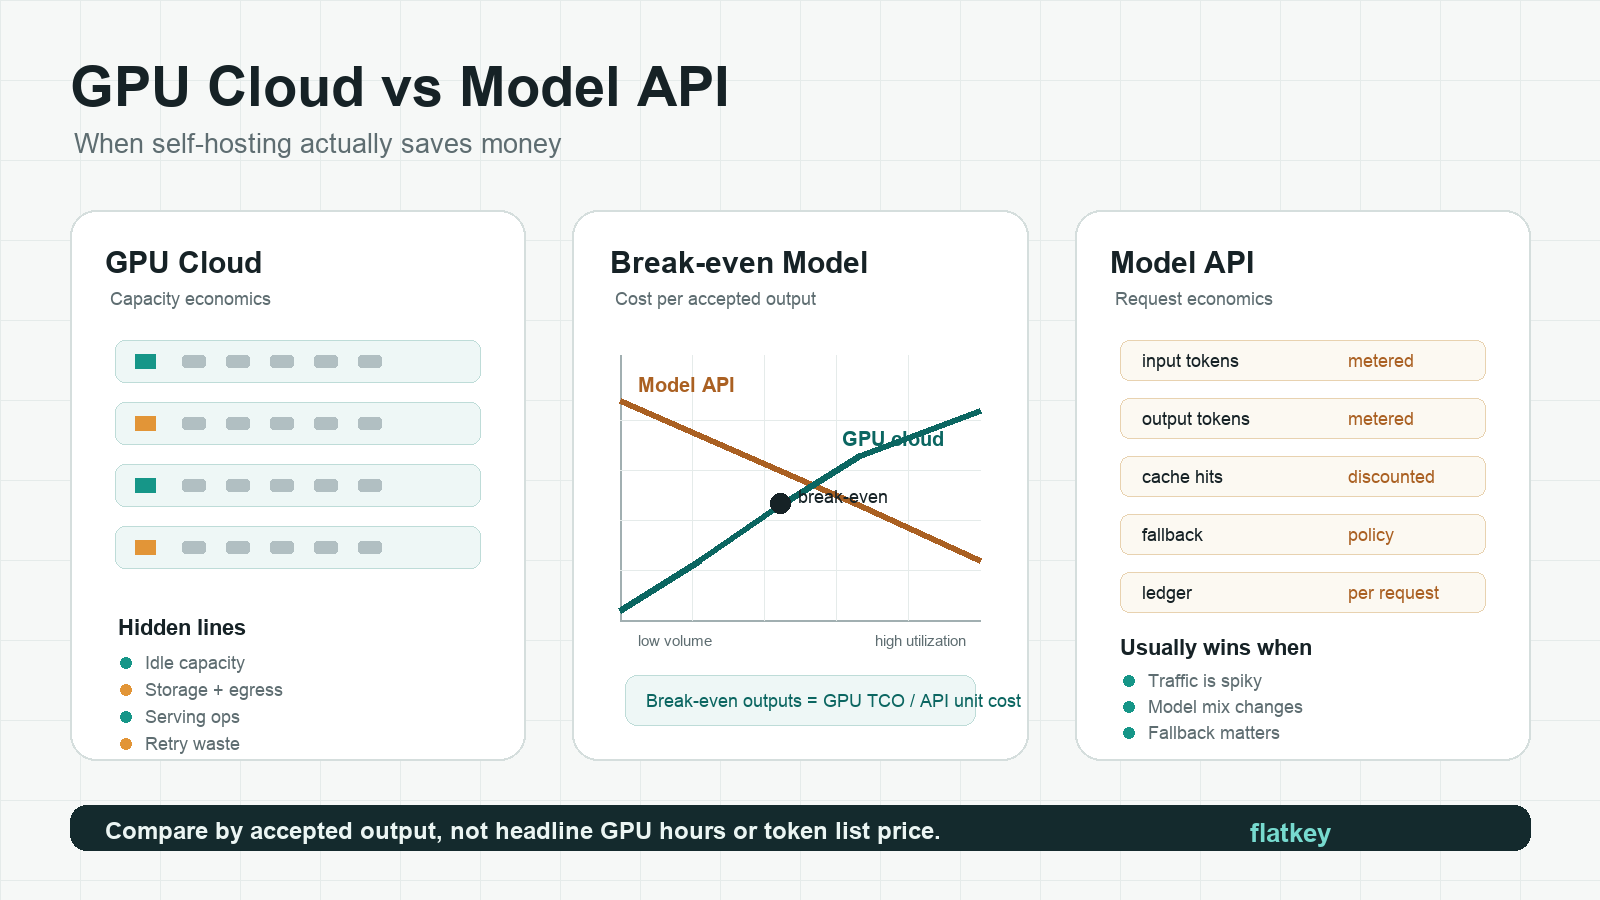
ほとんどのチームは、GPUクラウドとモデルAPIの比較をするのが遅すぎます。GPUを借りて、サービングスタックをデプロイし、バッチ処理を調整し、プラットフォームサポートを採用し、それからようやくマネージドなモデルAPIと請求額を比較します。その時点では、比較はすでに、投下した労力のある経路に有利に偏っています。
より良い問いは、もっとシンプルです。GPUレイヤーを制御する必要があるのか、それとも受け入れ可能な最低コストで信頼できるモデル出力が必要なのか、です。
エンタープライズAIチームにとって、GPUクラウドがコスト削減につながるのは、需要が継続的で、モデル選定が安定しており、有効利用率が高く、推論を運用できるエンジニアリングチームがある場合です。モデルAPIの方が通常安くなるのは、トラフィックがスパikyである、モデル選定が頻繁に変わる、リトライやフェイルオーバーがハードウェア制御より重要である、または自前運用できない最先端モデルが必要な場合です。
Flatkeyの実践ルール: GPUクラウドとモデルAPIの比較は、GPUの時間単価やトークンの一覧価格だけではなく、受け入れられた出力あたりのコストで行ってください。
GPUクラウド vs モデルAPI: ひと目で分かる答え
スプレッドシートを作る前に、この表を使ってください。
| 状況 | 通常最初に選ぶもの | 理由 |
|---|---|---|
| 初期プロダクト、プロンプト変更が多い、需要が不確実 | モデルAPI | トラフィック、品質、モデル適合性を学習している間、遊休GPUを避けられます。 |
| 単一の安定したオープンモデルでの高ボリュームなバッチ推論 | GPUクラウド | 継続的な利用によってサービングスタックのコストを償却できます。 |
| 予測不能なバーストがある顧客向けチャット | モデルAPIまたはハイブリッド | オートスケーリング、フォールバック、そして遊休容量がないことの方が、単価そのものより重要なことが多いです。 |
| 独自重み、カスタムカーネル、厳格なデータローカリティ | GPUクラウド | ビジネス要件は、単なるコストではなく制御です。 |
| 複数ベンダーのモデルルーティング、最先端モデル、または頻繁なモデル切り替え | モデルAPI | モデル変更ごとにサービング基盤を作り直す必要がありません。 |
| 実績ある利用率を伴う長期の安定ワークロード | 予約済みGPUクラウド、専有GPUクラスター、またはコロケーションGPU | 需要が実証された後なら、コミットメントによって実効的な容量コストを下げられます。 |
このガイドの残りでは、遊休時間、リトライ、運用、品質フィルターを隠さずにGPUクラウドとモデルAPIを比較するための、コピー可能なモデルを示します。
本当に重要なコスト単位
以下は比較しないでください:
- GPUの時間単価 vs トークン価格。
- クラウド見積もり vs 最高ケースのベンチマーク。
- モデルAPIの一覧価格 vs 100%稼働の自前運用クラスター。
代わりに、次のいずれかの分母で比較してください:
| ワークロード | 最適な分母 |
|---|---|
| LLMチャットまたはエージェント | 受け入れられた応答、受け入れられたタスク、または受け入れられた出力トークンあたりのコスト |
| バッチ分類または抽出 | 受け入れられたレコードあたりのコスト |
| コード生成 | 受け入れられたパッチ、または完了したコーディングタスクあたりのコスト |
| 画像生成 | 品質フィルター通過後の受け入れられた画像あたりのコスト |
| 動画生成 | 受け入れられた秒数、または受け入れられたクリップあたりのコスト |
| ファインチューニングまたはトレーニング | 完了した実行1回あたりのコスト |
ほとんどの推論チームでは:
effective_unit_cost =
  all_in_monthly_cost
  / accepted_outputs_after_retries_quality_filters_and_failures
ここで、GPUクラウドとモデルAPIの比較が逆転することがよくあります。自前運用のエンドポイントはベンチマーク上のスループットが非常に高く見えても、利用率が低い、モデルが品質チェックに落ちる、あるいはエンジニアがスタックの健全性維持に時間を使いすぎると、負けることがあります。
モデルAPIのコストモデル
モデルAPIは、請求が通常、リクエスト、トークン、画像、動画秒数、またはツール呼び出し単位で計測されるため、シンプルに見えます。しかし、公平なモデルAPIの試算には、公開された単価以上のものが必要です。
このモデルを使ってください:
monthly_model_api_cost =
  input_token_cost
  + cached_input_or_context_cost
  + output_token_cost
  + tool_or_media_cost
  + retry_and_fallback_cost
  + gateway_or_router_cost
  + observability_and_finops_cost
その後、正規化します:
model_api_cost_per_accepted_output =
  monthly_model_api_cost
  / accepted_outputs
確認すべき項目:
| コスト項目 | 確認内容 |
|---|---|
| 入力トークンと出力トークン | 公式プロバイダーの料金ページ、モデルID、コンテキストウィンドウ、出力上限、確認日。 |
| キャッシュ済み入力 | プロバイダーがプロンプトキャッシュまたはキャッシュヒット割引をサポートしているか、そして実際にワークロードがコンテキストを再利用しているか。 |
| バッチ料金 | バッチまたは非同期処理がレイテンシ要件に合うか。 |
| リトライ | レート制限によるリトライ、一時的エラー、品質チェック失敗、フォールバック要求。 |
| ルーター/ゲートウェイ層 | ゲートウェイ料金、使用台帳、モデル許可リスト、サブキー予算、請求ワークフロー。 |
| 運用 | 統合、監視、プロバイダー障害対応、財務突合。 |
現在の数値は、コピーされた料金表ではなく公式ソースページを使ってください。まずは OpenAI API pricing、Anthropic pricing、Google Gemini API pricing、そして利用しているゲートウェイまたはルーターの最新料金ページを確認してください。
Flatkeyにとって、モデルAPI側は、公式モデルとツール全体で1つのキー、1つの残高、1つの利用台帳で済むことを意味します。実際のコスト問題が単一のモデル呼び出しではなく、散在するキー、複数の請求書、チームごとの予算制御、プロバイダー間のフォールバックである場合、そこが重要になります。
GPUクラウドのコストモデル
GPUクラウドはGPUの時間単価だけではありません。本番の自前ホスティング型モデルAPIには、キャパシティコスト、サービングソフトウェア、ストレージ、ネットワーキング、監視、稼働維持作業、そしてアイドル時のキャパシティが含まれます。
次のモデルを使います:
monthly_gpu_cloud_cost =
  gpu_compute_hours
  + storage_and_snapshot_cost
  + bandwidth_and_egress_cost
  + load_balancing_and_network_cost
  + serving_stack_cost
  + observability_and_logging_cost
  + platform_engineering_cost
  + support_plan_or_managed_service_cost
  + idle_capacity_cost
  + retry_failure_and_redeployment_waste
次に正規化します:
self_hosted_cost_per_accepted_output =
  monthly_gpu_cloud_cost
  / accepted_outputs
把握すべき項目:
| コスト項目 | なぜ答えが変わるのか |
|---|---|
| GPUのモデルとメモリ | H100、H200、B200、A100、L40S、RTXクラスのGPUは、メモリ、スループット、供給、価格の曲線がそれぞれ異なります。 |
| 製品モード | オンデマンド、スポット、予約、マーケットプレイス、サーバーレスGPU、専用クラスタ、ベアメタルでは、信頼性の特性が異なります。 |
| 利用率 | GPUがアイドル状態のままだと、安い自前ホスティングのエンドポイントでもすぐに不利になります。 |
| サービングスタック | vLLM、SGLang、TensorRT-LLM、NIM、または独自サーバーには、実運用のサポートが必要です。 |
| ストレージとモデル読み込み | 大きな重み、スナップショット、ボリューム、繰り返しのプルは、無視できないコストになることがあります。 |
| ネットワーキング | エグレス、プライベートリンク、パブリックIP、ロードバランシングは、単位経済性を変え得ます。 |
| 障害 | OOMエラー、プリエンプション、不正なコンテナ、コールドスタートは、承認済み出力あたりのコストを押し上げます。 |
現在の各プロバイダーのページを基準点として使います: AWS EC2 pricing、AWS P5 instances、Google Cloud GPU pricing、RunPod pricing、Lambda GPU Cloud、Vast.ai pricing。
すべてのGPU価格はタイムスタンプ付きとして扱ってください。マーケットプレイスの供給、リージョンごとの उपलब्ध性、確約見積もりは、あなたが読んでいる記事よりも速く変わることがあります。
損益分岐点の式
これが、GPUクラウド vs モデルAPIの判断が、意見ベースではなく財務ベースになるポイントです。
最もシンプルな損益分岐モデルは次のとおりです:
break_even_outputs =
  monthly_gpu_cloud_cost
  / model_api_cost_per_accepted_output
ワークロードが break_even_outputs より多くの承認済み出力を生むなら、自前ホスティングでコストを節約できる可能性があります。少ないなら、モデルAPIのほうが安い可能性が高いです。
同じ考え方を利用率で表すこともできます:
required_utilization =
  monthly_gpu_cloud_cost
  / equivalent_model_api_cost_at_expected_volume
この式が有効なのは、ワークロードが安定している場合に限られます。月ごとにボリューム、モデル、コンテキスト長、品質目標が変わるなら、モデルAPI側には、利用率の式では捉えられないオプション価値があります。
実例: なぜGPUの時間単価は誤解を招くのか
あるチームが、安定したオープンモデルを自前ホストするかどうかを判断しているとします。
| 入力 | 例の値 |
|---|---|
| 総額のGPUクラウドコスト | 月額 $24,000 |
| 承認済み出力数 | 月間 3,000万承認済み出力 |
| 自前ホスティングの承認済み出力あたりコスト | $0.0008 |
| モデルAPIの承認済み出力あたりコスト | $0.0012 |
| 同じボリュームでの月間モデルAPIコスト | $36,000 |
| 見かけ上の自前ホスティング節約額 | 月額 $12,000 |
この基本ケースでは、GPUクラウドのほうが安く見えます。
では、前提条件を厳しく見直してみましょう。
| 変化 | 影響 |
|---|---|
| 有効利用率が35%低下する | 固定されたGPUプールで処理できる承認済み作業が減るため、自前ホストの単価が上がります。 |
| リトライまたは品質失敗率が2倍になる | どちらの経路も高くなりますが、自前ホスティングではキャパシティの無駄も吸収します。 |
| 製品がより大きなモデルに切り替わる | 既存GPUにシャーディング、より多いメモリ、新しいサービングスタックが必要になる場合があります。 |
| 需要がスパikyになる | モデルAPIは需要に応じてスケールできますが、GPUプールはピークに合わせてサイズを決めるか、キューを許容する必要があります。 |
もし下振れケースで節約分が消えるなら、自前ホスティングは実際には安くありません。それはキャパシティへの賭けです。
GPUクラウドが実際にコストを下げるのはいつか
GPUクラウドは、次の多くが当てはまるときにコストを下げられます:
- 需要継続的な需要があり、断続的なバーストではない。
- モデルファミリーが数日ではなく数か月安定している。
- モデルがオープンウェイトである、またはその他の方法で自前ホスティング可能である。
- キューのギャップや障害を除いた後でも、ワークロードの有効な稼働率が高い。
- レイテンシ目標を自分のサービングスタックで満たせる。
- vLLM、SGLang、TensorRT-LLM、NIM、または別のスタックを安定して運用できる。
- GPU使用率、メモリ圧迫、p95/p99レイテンシ、エラー率、リトライ増幅をチームが監視できる。
- モデルの読み込み、キャッシュウォームアップ、シャットダウン自動化、ロールアウトの安全性に関する計画がある。
- 見積もりにストレージ、エグレス、サポート、可用性の前提が含まれている。
- Finance が、各リクエストが到着する前にキャパシティへ資金を出すことに納得している。
これは、大量のバッチ推論、社内向け抽出パイプライン、安定したサポートボット、ドメイン特化のオープンモデル、そしてカスタム重みやデータの局所性が重要なワークロードでよく見られます。
GPU側のより深い計画については、Flatkey のガイド GPUレンタル価格、LLM推論に最適なGPU、GPUクラスターのレンタル、GPUクラスターのTCOを参照してください。
モデルAPIのほうが安いままである場合
モデルAPIは、通常、次の条件が当てはまるときに安くなり続けます:
- トラフィックがバースト的、季節的、またはまだ不明である。
- アプリが複数の最先端モデルを必要とする。
- モデルの変化がインフラ計画より速い。
- チームがハードウェアの制御よりも、フェイルオーバー、レート制限処理、請求書、使用量ログ、予算管理を必要としている。
- アイドル時間を相殺できるほどGPUを稼働させ続けられない。
- サービング層を運用するプラットフォームチームがいない。
- ワークロードに、クローズドモデル、マルチモーダル生成、独自のプロバイダー機能、または進化の速いモデルリリースが含まれる。
- 調達が、プールされたインフラ請求ではなく、リクエストごとの按分を求めている。
ここでは、GPUクラウド対モデルAPIの比較は価格だけの話ではありません。モデルAPIは、統合作業の時間、調達の複雑さ、障害の表面積を減らせます。
Flatkey は、多くの公式モデルに対して1つの OpenAI互換ルート、1つの前払い残高、1つの請求書、サブキーごとの予算、モデルの許可リスト、リクエスト単位の使用記録、上流チャネル横断のフェイルオーバーを求めるチームにとって、この判断のモデルAPI側に適しています。関連ガイドとして、AIモデル価格比較、AI API価格比較、AIゲートウェイ価格、AI API支出管理を参照してください。
ハイブリッドが実際の答えであることが多い
多くのエンタープライズAIチームは、1つの普遍的な答えに固定すべきではありません。ハイブリッドモデルのほうが、しばしばより妥当です:
| ワークロード区分 | より適した既定値 |
|---|---|
| 安定した大規模オープンウェイト推論 | GPUクラウド |
| 最先端モデルの推論やコーディング | モデルAPI |
| キューに入れられるバッチジョブ | GPUクラウド、スポット、または予約キャパシティ |
| 顧客向けのバースト | モデルAPIまたはハイブリッドのオーバーフロー |
| 独自重み | GPUクラウド |
| モデル探索 | モデルAPI |
| インフラ制御が必要な規制対象デプロイ | 専用GPUクラウド、プライベートGPUクラウド、コロケーション、またはオンプレミス |
ハイブリッドのパターンは次のとおりです:
- 未知で変動の大きいワークロードはモデルAPIにルーティングする。
- 安定したワークロードをGPUクラウドでベンチマークする。
- 実績あるボリュームとモデル安定性が確認できたワークロードだけを自前ホスティングへ移す。
- オーバーフロー、モデル更新、プロバイダー多様化のために、モデルAPIのフォールバックを維持する。
その進め方なら、最も高くつく失敗、つまり後で形が変わるワークロードのためにGPUキャパシティを購入してしまうことを避けられます。
切り替え前のベンチマーク計画
少なくとも1つの代表的な期間について、同じトラフィックを両方の経路で流してください。
| 指標 | GPUクラウド経路 | モデルAPI経路 |
|---|---|---|
| 受理された出力 | ||
| 入力トークンまたはレコード数 | ||
| 出力トークンまたは結果数 | ||
| p50 / p95 / p99 レイテンシ | ||
| 最初のトークンまでの時間 | ||
| エラー率 | ||
| リトライ率 | ||
| 品質却下率 | ||
| アイドルキャパシティ | N/A | |
| スタッフ工数 | ||
| ストレージとエグレス | ||
| 総コスト | ||
| 受理された出力あたりのコスト |
次に、次の点を確認してください:
- アイドル時間を考慮しても、GPUクラウドはなお勝つか?
- スタッフ工数を含めても、なお勝つか?
- リトライと品質フィルタを含めても、なお勝つか?
- モデルが変わっても、なお勝つか?
- トラフィックが30%減っても、なお勝つか?
- p95レイテンシを改善する必要があっても、なお勝つか?
下振れケースで答えが yes なら、自前ホスティングには本格的な調達プロセスを検討する価値があります。
調達チェックリスト
GPUクラウドの場合:
- どのGPU、メモリ容量、CPU、RAM、ディスク、インターコネクト、ネットワーク帯域が正確に含まれていますか?
- 容量はオンデマンド、スポット、マーケットプレイス、セキュアクラウド、予約、専有、またはベアメタルのどれですか?
- どのストレージ、スナップショット、egress、パブリックIP、ロードバランサー、サポート、可観測性のコストが除外されていますか?
- ホスト障害、プリエンプション、メンテナンス、または容量不足の間はどうなりますか?
- 提供元は、契約前に実際のベンチマークを実行できますか?
- 最小契約期間、段階的な移行パス、および解約コストは何ですか?
モデルAPIの場合:
- どの正確なモデルID、コンテキストウィンドウ、出力上限、料金単位が使われていますか?
- キャッシュヒット、バッチジョブ、画像/動画単位、ツール呼び出しは別料金ですか?
- レート制限とフォールバック手段は何ですか?
- 再試行、失敗したプロバイダ呼び出し、品質リジェクトはどのようにカウントされますか?
- 財務部門は、チーム、キー、モデル、環境、顧客ごとに使用量をエクスポートできますか?
- どのデータ保持、コンプライアンス、SLA条件が適用されますか?
ソースのチェックリスト
現在の入力の出発点として、次の公式ページを使用してください:
| ソースの種類 | 確認するページ |
|---|---|
| モデルAPIの価格 | OpenAI API pricing, Anthropic pricing, Google Gemini API pricing |
| GPUクラウドの価格 | AWS EC2 pricing, AWS P5 instances, Google Cloud GPU pricing, RunPod pricing, Lambda GPU Cloud, Vast.ai pricing |
| サービングフレームワーク | vLLM OpenAI-compatible server, SGLang documentation |
| GPU仕様 | NVIDIA H100, NVIDIA H200, NVIDIA DGX B200 |
| FinOps構造 | FinOps FOCUS |
| Flatkeyのコスト文脈 | Flatkey pricing, Flatkey Compute, Flatkey Compute price index |
よくある質問
GPUクラウドは常にモデルAPIより安いですか?
いいえ。GPUクラウドが安くなるのは、アイドル容量、ストレージ、egress、サービング運用、再試行の無駄、スタッフの工数を相殺できるだけの有効稼働率が高い場合に限られます。モデルAPIは、トークン単価が高く見えても、バースト的または変化の大きいワークロードではより安くなることがあります。
LLMの自前ホスティングはいつコストを節約できますか?
モデルが安定しており、ボリュームが高く、稼働率が予測可能で、チームがサービングスタックを運用でき、かつ最悪ケースを想定した場合でも、受理済み出力1件あたりのGPUクラウドの総コストがモデルAPIのコストを下回るときです。
GPUクラウドとモデルAPIの価格はどう比較すべきですか?
受理済み出力あたりのコストで比較してください。トークン、GPU時間、ストレージ、帯域幅、アイドル時間、再試行、失敗率、品質フィルタ、エンジニアリング工数、サポート、財務オペレーションを含めます。GPUの時間単価とトークンの一覧価格だけを比較してはいけません。
GPUクラウド推論の最大の隠れコストは何ですか?
最大の隠れコストは通常、アイドル容量、エンジニアリング運用、ストレージとegress、失敗したデプロイ、OOM(メモリ不足)再試行、十分に検証されていないサービング変更です。これらのコストは、表向きのGPU時間単価には現れません。
モデルAPIの最大の隠れコストは何ですか?
最大の隠れコストは通常、再試行、フォールバック呼び出し、長いプロンプト、キャッシュされていないコンテキスト、出力の多い応答、ツールやメディアの呼び出し、分散したプロバイダアカウント、弱い使用量帰属です。リクエスト単位の台帳は、こうしたコストを可視化するのに役立ちます。
エンタープライズAIチームはハイブリッドアーキテクチャを使うべきですか?
多くの場合、はい。探索、最先端モデル、バースト、フォールバックにはモデルAPIを使ってください。安定した高ボリュームのワークロードだけを、ベンチマークで低い受理コストが証明されてからGPUクラウドへ移行します。オーバーフローとモデル変更に備えて、API経路は維持してください。
要点
GPUクラウド vs モデルAPIは哲学的な決断ではありません。GPUクラウド vs モデルAPIは、ワークロード経済の判断です。
容量を十分に稼働させられ、モデルが安定しており、ハードウェアの制御が実際の優位性を生むならGPUクラウドを選んでください。柔軟性、複数プロバイダへのアクセス、より速いモデル変更、リクエスト単位のガバナンスが、理論上のハードウェア節約より価値があるならモデルAPIを選んでください。
最も安全な進め方は段階的です。まずモデルAPIから始め、ワークロードをベンチマークし、損失ケースを踏まえて損益分岐点の計算が成り立つ場合にのみ安定した部分をGPUクラウドへ移し、フォールバックと将来のモデル変更のためにAPI経路を残してください。
本番AIワークロードについてGPUクラウドとモデルAPIを比較しているなら、FlatkeyはAPI側で、1つのキー、1つの残高、公式モデルルート、利用台帳、予算、請求書を提供し、チームがどのワークロードが本当に専用GPU容量に値するかを見極めるのを支援します。


