
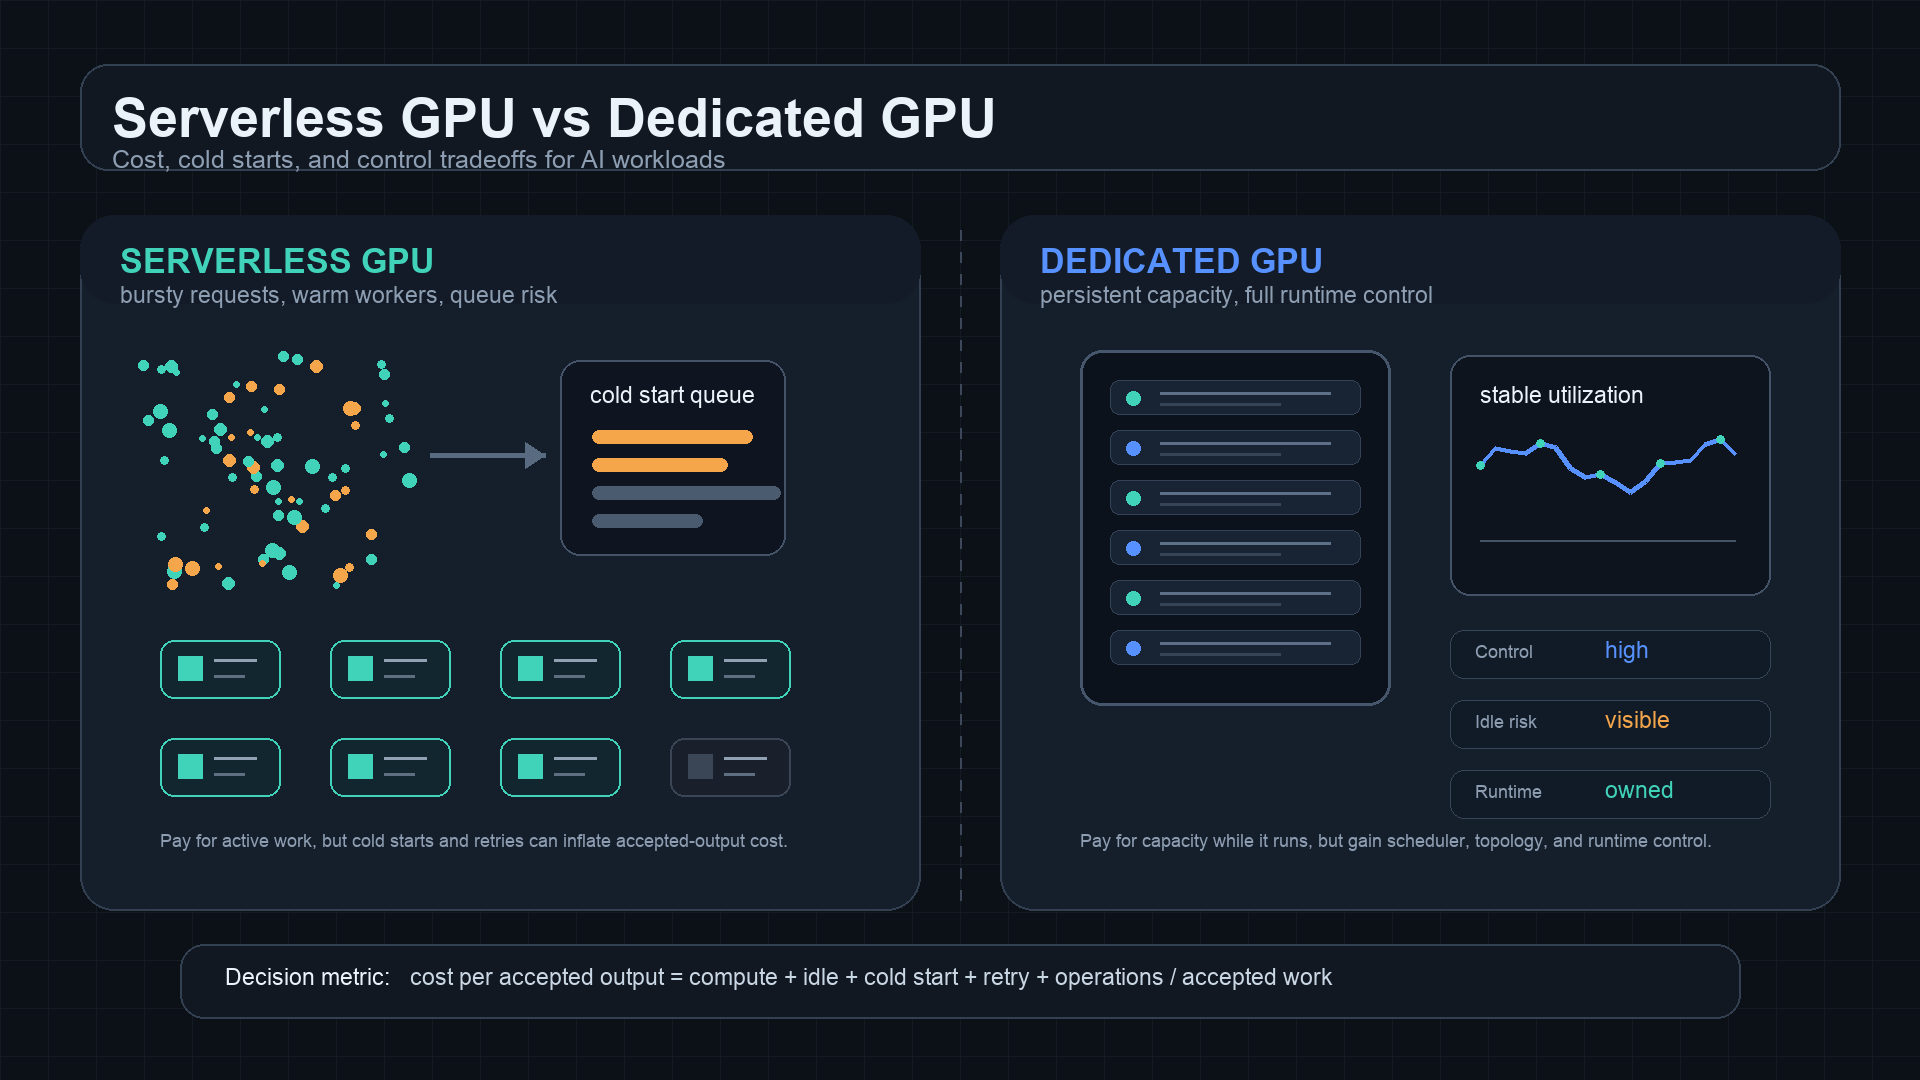
サーバーレスGPU vs 専用GPU: コスト、コールドスタート、制御
サーバーレスGPUと専用GPU容量のどちらを選ぶかは、ほとんどの場合ワークロードの形状の問題です。トラフィックがバースト的である場合、実験の負荷が不均一である場合、またはチームがアイドル状態のハードウェアを避けたい場合には、サーバーレスGPUが魅力的です。需要が安定している場合、起動レイテンシが重要な場合、またはチームがドライバ、スケジューラ、ネットワーキング、モデルキャッシュ、配信ランタイムを制御したい場合には、専用GPUが魅力的です。
間違いは、サーバーレスGPUのリクエスト価格と専用GPUの時間単価を、同じものを表しているかのように比較することです。実際には違います。サーバーレスエンドポイントには、コールドスタート、キュー遅延、同時実行数の制限、再試行コスト、リクエストごとのオーバーヘッドが隠れていることがあります。専用GPUには、アイドル時間、予約容量リスク、ストレージ、サポート、プラットフォームエンジニアリング作業が隠れていることがあります。
独立開発者や小規模AIチームにとっての実践的なルールは次のとおりです:
serverless GPU vs dedicated GPU should be compared by cost per accepted output,
not by the lowest visible GPU rate.
そもそも直接GPUを借りる必要があるかまだ判断しているなら、Flatkeyの GPUクラウド vs モデルAPI、GPUレンタル価格、クラウドGPUの隠れたコスト のガイドも読んでください。この記事では、GPUをすでに評価対象に含めた後のサーバーレスGPU vs 専用GPUの選択に焦点を当てます。
サーバーレスGPU vs 専用GPU: ひとことで言うと
この表を最初のフィルターとして使ってください。
| 判断ポイント | サーバーレスGPUが通常適する場合 | 専用GPUが通常適する場合 |
|---|---|---|
| トラフィックのパターン | バースト的、キュー処理、実験的、または不均一 | 安定、高ボリューム、低レイテンシ重視、または容量計画済み |
| 課金の形 | 提供元によるが、主にワーカーが稼働する時やリクエストが実行される時に支払い | インスタンス、Pod、ノード、クラスタ、または予約が存在する間は支払い |
| 起動リスク | コールドスタート、モデル読み込み、コンテナのプル、ワーカーのウォームアップ、キュー遅延 | ウォームアップ後はコールドスタートの影響が少ないが、アイドル容量も課金対象 |
| 運用上の制御 | ホスト、スケジューラ、ランタイム、トポロジー、キャッシュに対する制御は小さい | ドライバ、配信スタック、キャッシュ、トポロジー、可観測性に対する制御は大きい |
| 信頼性モデル | エンドポイント制限とコールド経路の可能性を伴う、プロバイダー管理のスケーリング | チーム管理の稼働率、自動スケーリング、フェイルオーバー、パッチ適用、インシデント対応 |
| 最初の用途として最適 | デモ、画像/動画ジョブ、バッチ推論、断続的なAPI、プロトタイプ | 安定した推論エンドポイント、長時間稼働サービス、カスタムランタイム、マルチノード処理 |
最善の答えは、段階的であることが多いです:
- 未知の需要にはサーバーレスGPUから始める。
- コールドスタート、キュー遅延、再試行率、受理済み出力あたりのコストを測定する。
- 安定していて高ボリュームなワークロードだけを専用GPU容量に移す。
- 製品が多数のモデルを必要とする場合やハードウェア制御を必要としない場合は、モデルAPIの経路を開いたままにしておく。
この順序は、ワークロードが本当に専用GPUを十分に使い続けられるか分からないうちに、専用GPUを予約するよりも安全です。
実践上の「サーバーレスGPU」とは何か
サーバーレスGPUとは通常、提供元が長時間稼働するサーバーの所有を抽象化することを意味します。モデル、コンテナ、関数、またはエンドポイントをパッケージ化すると、プラットフォームがリクエスト到着時にGPUワーカーを起動し、需要に応じてワーカーを増減させることがあります。
プロバイダーごとの実装はさまざまです。RunPodはServerlessをエンドポイントとワーカーを中心に説明しており、サーバーレスの価格はPodの価格とは別です。ModalはGPU関数、コールドスタート、コンテナのライフサイクルを文書化しています。Google Cloud RunはGPU付きサービスをサポートしており、独自のCloud Run料金モデルがあります。Replicateのデプロイは、設定可能な本番推論エンドポイントを公開します。これらは同一製品ではないため、出典の確認が重要です。
購入者の視点では、サーバーレスGPU容量は次のような場合に有用です:
- リクエスト量が少ない、バースト的、またはまだ把握途中である。
- ユーザー体験を損なわずにジョブをキュー待ちさせられる。
- コールドスタートが許容できる、または目立たなくできる。
- チームがインフラの所有を減らしたい。
- ワークロードが、常時ウォームなサービスではなく繰り返し可能なジョブとしてパッケージ化されている。
- 事業として、固定月額の容量賭けよりも使用量に応じた支出を好む。
見えにくいトレードオフは、サーバーレスGPUが物理法則をなくすわけではないということです。モデルの重みは依然として読み込む必要があります。コンテナも依然として起動する必要があります。GPUにも依然として空き容量が必要です。キュー遅延も依然としてユーザーに影響します。再試行にも依然として費用がかかります。
実践上の「専用GPU」とは何か
専用GPU容量とは、一定期間、稼働中のインスタンス、Pod、サーバー、ノード、またはクラスタを自分で制御することを意味します。オンデマンド、予約、コミット、ベアメタル、マーケットプレイス容量、またはプライベートクラスタである場合があります。共通する点は、GPUがリクエスト時のみ起動されるのではなく、あなたのワークロードに割り当てられることです。
専用GPU容量は次のような場合に有用です:
- エンドポイントはウォームな状態を維持する必要がある。
- トラフィックが予測可能で、GPUを十分に稼働させ続けられる。
- カスタムドライバ、CUDAバージョン、カーネル、モデルサーバー、またはネットワークが必要である。
- 一貫したベンチマーク条件が必要である。
- コールドスタートがレイテンシやユーザー体験を損なう。
- ワークロードがマルチノードで、トポロジーの影響を受けやすい、またはデータローカリティに敏感である。
- vLLM、SGLang、TensorRT-LLM、Triton、Ray Serve、Kubernetes、Slurm、またはカスタムのサービング基盤を直接運用したい。
見えにくいトレードオフは、アイドル容量です。専用GPUが月に730時間稼働していても、有用な作業をしているのが180時間だけなら、表示されている時間単価は実際の有効稼働時間あたりの価格ではありません。アイドル時間もワークロードコストの一部です。
比較を公平にするコスト式
両者で同じ分母を使います:
accepted output あたりのコスト =
  compute
  + storage
  + bandwidth
  + idle time
  + cold start waste
  + retry and failed-job waste
  + support
  + engineering overhead
  / accepted outputs, records, tokens, images, clips, or jobs
サーバーレスGPUの場合:
serverless GPU cost per accepted output =
  billed worker/request cost
  + cold start and queue waste
  + failed request and retry cost
  + storage and artifact transfer
  + platform integration overhead
  / accepted outputs
専用GPUの場合:
dedicated GPU cost per accepted output =
  running GPU capacity cost
  + storage and networking
  + idle capacity
  + serving stack operations
  + support and incident work
  + failure and redeploy waste
  / accepted outputs
ここで、サーバーレスGPUと専用GPUの比較はしばしば逆転します。サーバーレスは秒単価では高く見えても、アイドルGPUを避けられるなら全体では安くなることがあります。専用GPUは月額では高く見えても、ワークロードがアクセラレータを十分に稼働させ、コールドスタートの無駄を避けられるなら、全体では安くなることがあります。
コールドスタートはサーバーレスGPUの税金
コールドスタートは、サーバーレスGPUにおける最重要リスクです。コールドスタートには次のようなものが含まれます:
- GPU容量を見つけること。
- コンテナイメージを取得またはマウントすること。
- 依存関係を読み込むこと。
- モデル重みをロードすること。
- モデルをGPUメモリへ移すこと。
- カーネルやコンパイル経路をウォームアップすること。
- キャッシュを再構築すること。
- 先にキューに入ったリクエストの後ろで待つこと。
Modal のコールドスタートに関するドキュメントは、コンテナ起動作業、インポート、アプリケーション初期化を分けて説明している点で参考になります。細かな仕組みはプロバイダごとに異なりますが、教訓は共通です。起動時間はユーザー体験とコストモデルの一部です。
コールドスタートが特に問題になるのは次のような場合です:
| ワークロード | コールドスタートが問題になる理由 |
|---|---|
| 対話型チャットやエージェント | ユーザーは最初のトークンまでの遅延に気づく。 |
| リアルタイム画像編集 | 後続のリクエストが速くても、最初のリクエストは壊れているように感じられることがある。 |
| Webhook やユーザー向けAPI | 上流のタイムアウトにより、コールドスタートが失敗ジョブになることがある。 |
| 厳格なSLAのあるバッチキュー | キュー遅延が納期ウィンドウを破る可能性がある。 |
| 大規模モデル | 重みのロードがリクエスト経路の大半を占めることがある。 |
アプリケーションがこの遅延を許容できるなら、サーバーレスGPUが最適解であることは十分にあります。たとえば、オフラインの画像ジョブ、夜間の評価キュー、非同期バッチ推論、社内向けの実験は、顧客向けチャットよりもウォームアップを受け入れやすいことが多いです。
専用GPUはコールドスタートの代わりにアイドルリスクを負う
専用GPUは通常、サービスをウォームに保てるため、コールドスタートの影響を減らせます。モデル重みはロードされたままで、キャッシュはホットなまま、リクエストルーティングも既知のエンドポイントに当てられます。
しかし、専用容量には別の税金があります:
idle waste share =
  1 - useful GPU-active time / billable running time
有効なGPU稼働率が30%なら、表示上の時間単価が低くても、最終的には高くつくことがあります。専用GPUは技術的にはいつでも使える状態でも、経済的にはアイドルなのです。
専用GPUが最も適しているのは、次を証明できる場合です:
- ベースラインのリクエスト量。
- バッチングとキューイング後も高いGPU利用率。
- 安定したモデル選定。
- 予測可能なメモリ要件。
- チームが運用できるサービングスタック。
- ローリングデプロイ、監視、アラート、フォールバックの計画。
これらの前提が不明なら、サーバーレスGPUやモデルAPIを使うほうが、最初の一歩としてはよりシンプルです。
制御: 専用GPUがもたらすもの
専用GPU容量を選ぶ最も強い理由は、必ずしも価格ではありません。制御です。
専用容量によって、チームは次の点をより細かく決められます:
- GPUのモデル、メモリ、台数。
- リージョンとデータローカリティ。
- CUDA、ドライバ、カーネル、イメージの各バージョン。
- vLLM、SGLang、TensorRT-LLM、Triton、Ray Serve、またはカスタムランタイム設定。
- 継続的バッチ処理、KVキャッシュの挙動、量子化、speculative decoding、スケジューラ調整。
- ローカルモデルキャッシュと事前ロード済み重み。
- ネットワークトポロジー、プライベートリンク、VPC設計、ロードバランサー、インバースト。
- 可観測性、トレース、ログ、インシデント対応。
この制御は、所有する価値を正当化できるほどワークロードが重要な場合には価値があります。必要なのが信頼できるモデル出力だけなら、これは高くつきます。
これは、Flatkey のLLM推論に最適なGPU、vLLMデプロイガイド、およびvLLM vs SGLangの記事で扱っているのと同じ境界です。ランタイム自体をチューニングしているなら、専用GPUのキャパシティが適切なレイヤーかもしれません。複数のモデルにまたがる製品機能を提供しているなら、マネージドAPIの経路のほうが速い場合があります。
ワークロード判断マトリクス
スプレッドシートを作る前に、このマトリクスを使ってください。
| ワークロード | より適した出発点 | 理由 |
|---|---|---|
| 需要が未知の新しいAI製品機能 | サーバーレスGPUまたはモデルAPI | トラフィックが分かる前に遊休キャパシティを購入するのを避けられる。 |
| 非同期の画像生成キュー | サーバーレスGPU | キュー遅延は許容できる場合があり、突発的な増加に常時稼働GPUは不要。 |
| 短いデモまたはプロトタイプ | サーバーレスGPU | 素早いセットアップと使用量ベースの課金は、通常ランタイム制御より重要です。 |
| 高ボリュームで安定したLLM推論 | 専用GPU | 継続的な利用で配信スタックのコストを償却できます。 |
| レイテンシに敏感な顧客向けエンドポイント | 専用GPUまたはモデルAPI | コールドスタートやキュー遅延は隠しにくいです。 |
| 重みの読み込みが遅い大規模モデル | 専用GPU | 重みを温めたまま維持するほうが、サーバーレスの起動を繰り返すより有利な場合があります。 |
| 定期的な評価スイート | サーバーレスGPU、スポットGPU、またはバッチ型モデルAPI | ジョブは再試行可能で、キューの後ろで実行できます。 |
| カスタムCUDAカーネルまたはランタイム研究 | 専用GPU | チームには低レベルの制御が必要です。 |
| マルチノード学習または分散推論 | 専用クラスタ | トポロジー、ネットワークファブリック、障害ドメインが支配的になります。 |
| 多くのフロンティアモデルを必要とする製品 | モデルAPIまたはゲートウェイ | GPUを直接所有しても、複数ベンダーのモデルアクセスは解決できません。 |
より広いキャパシティプランニングには、Flatkey のオンデマンド vs スポットGPU、GPUクラスタTCO、およびGPUクラスタレンタルガイドを組み合わせてください。
サーバーレスGPUのコストの落とし穴
チームがこれらの項目を見落とすと、サーバーレスGPUの経済性は期待外れになることがあります。
| 落とし穴 | 起こること | 対策 |
|---|---|---|
| 遅いモデル読み込み | 各コールドワーカーが、有用な処理が始まる前に課金対象の時間を消費する | 成果物を事前にパッケージ化し、イメージを小さくし、重みをキャッシュし、ウォームアップを別々に測定する |
| タイムアウトの不一致 | コールドスタートが上流のタイムアウトと再試行を引き起こす | 現実的なタイムアウト、非同期キュー、冪等なジョブIDを設定する |
| キューの不透明さ | ユーザーは遅延を目にするが、ダッシュボードには完了したリクエストしか表示されない | キュー待ち時間、コールドスタート時間、ワーカーのアクティブ時間、受理済み出力までのレイテンシを追跡する |
| 大きなGPUでの小さなジョブ | リクエストごとのオーバーヘッドが有用な計算を支配する | 処理をバッチ化するか、より小さいモデル/APIルートを使う |
| バースト時の同時実行制限 | 公開時のウィンドウでリクエストが滞留する | 公開前にエンドポイントの同時実行を負荷テストする |
| 再試行の増幅 | 失敗したジョブが課金対象の試行回数を増やす | 試行した出力ではなく、受理された出力を追跡する |
| データ転送 | 入力、重み、出力が繰り返し移動する | 成果物をワーカーの近くに置き、一時ファイルを期限切れにする |
調達上の問いは、「プロバイダーがサーバーレスGPUをサポートしているか?」ではありません。「ワーカーがコールドで、キューが満杯で、再試行が発生したとき、受理済み出力あたりのコストはどうなるか?」です。
専用GPUのコストの落とし穴
専用GPUの経済性は、逆方向で期待を裏切ることがあります。
| 落とし穴 | 起こること | 対策 |
|---|---|---|
| アイドルなエンドポイント | まれなリクエストのためにGPUがウォームなまま維持される | オートスケールし、ワークロードを統合し、低ボリュームではサーバーレス/モデルAPIを使う |
| 過剰なメモリ割り当て | 大きなGPUで、より小さなハードウェアに収まるワークロードを実行する | 導入前にモデルのメモリとスループットをベンチマークする |
| 予約の不一致 | 契約が、実際には現れない需要を前提にする | ローンチ予測ではなく、測定済みのベースラインに対して予約する |
| 配信スタックの所有 | エンジニアが製品機能ではなくランタイムを保守する | TCOにプラットフォーム作業を含める |
| 隠れたクラウド費用項目 | ストレージ、egress、サポート、ネットワークがGPU料金の外にある | GPUクラウドの隠れコストを含むワークシートを使う |
| モデルの入れ替わり | 新しいモデルファミリーがメモリ、精度、またはランタイム要件を変える | 出口経路を開いたままにしておく |
| インシデントの負担 | 稼働率はチームの問題になる | アラート、フォールバック、プロバイダーサポートの範囲を定義する |
専用GPUの制御は、チームがそれを活用できる場合にのみ価値があります。ワークロードが十分に安定しておらずチューニングできないなら、その追加の制御は運用上の負担になる可能性があります。
計算例: なぜ利用率によって答えが変わるのか
あるチームが非同期のメディア生成機能を運用していると仮定します。正確な料金は仮のものです。購入前に、確認済みのプロバイダー価格に置き換えてください。
| 項目 | Serverless GPU | Dedicated GPU |
|---|---|---|
| 月間の受付ジョブ数 | 120,000 | 120,000 |
| 記載上の計算リソース | 使用量に応じた形 | 固定の月間容量 |
| コールドスタートとキューの無駄 | 高い | 低い |
| アイドル容量 | 低い | 高い |
| 実行時制御 | 低い | 高い |
| 最適なリスク | 需要が不明 | 需要が安定している |
ジョブの大半が短いバーストで到着し、残りの時間は静かであれば、アイドル状態の専用容量を避けられるため、Serverless GPU のほうが有利かもしれません。ジョブが一日を通して安定して到着し、モデルのウォームアップ経路が遅い場合は、ワーカーが温かい状態を保ち、スループットを調整しやすいため、Dedicated GPU のほうが有利かもしれません。
次に、厳しいレイテンシ要件を持つ顧客向け LLM 推論にワークロードを変えてみましょう。軽いトラフィックでは serverless のほうが安く見えても、コールドスタート経路とキュー遅延が製品リスクを生むため、判断が逆転することがあります。その場合は、Dedicated GPU か、確立されたレイテンシ制御を備えたマネージドのモデル API のほうが安全かもしれません。
重要なのは、どちらか一方のモデルが常に勝つわけではないということです。Serverless GPU と Dedicated GPU は、測定されたワークロード形状に基づいて決めるべきです。
選択前のベンチマーク計画
代表的なテスト期間で、同じワークロードを両方の経路に流してみてください。以下の指標を追跡します。
| 指標 | Serverless GPU の経路 | Dedicated GPU の経路 |
|---|---|---|
| 受理された出力 | 品質フィルタ後の成功出力数を数える | 同じ分母 |
| 試行された出力 | 失敗および再試行されたジョブを含める | 失敗および再試行されたジョブを含める |
| p50 / p95 / p99 レイテンシ | キュー時間とコールドスタート時間を含める | ルーティング時間とバッチ処理時間を含める |
| 実用的な作業開始までの時間 | ワーカー起動、モデル読み込み、ウォームアップ | デプロイ開始、モデル読み込み、ロールアウト |
| コールドスタート比率 | コールドなワーカーに当たったリクエストの割合 | ウォームアップ後は通常より低い |
| キュー待ち | エンドポイントのキュー遅延と同時実行圧力 | スケジューラのキューとバッチ待ち |
| GPU 利用率 | 公開されていればワーカーの稼働時間 | GPU の計算およびメモリ利用率 |
| アイドルコスト | 通常は低いが、最低料金は確認する | 主要なコストリスク |
| 再試行率 | タイムアウト、ワーカーエラー、容量エラー | OOM、デプロイ、ランタイム、ホストエラー |
| 工数 | 統合とエンドポイントのデバッグ | プラットフォーム運用とインシデント対応 |
テストには、コールド条件、ウォーム条件、バーストトラフィック、通常トラフィック、障害復旧を含めるべきです。ウォームなスループットだけを測るベンチマークは、serverless GPU vs dedicated GPU の判断ではありません。それは一部だけの速度テストです。
プロバイダーのソースチェックリスト
固定された料金表ではなく、公式ページをソースチェックリストとして使ってください。支出を承認する当日に再確認します。
| プロバイダー/カテゴリ | 確認すべき公式ソース | 収集する内容 |
|---|---|---|
| RunPod Serverless | RunPod Serverless overview, RunPod Serverless pricing | エンドポイントモデル、ワーカー動作、課金基準、コールドスタート挙動、ストレージ、ネットワーク、同時実行数、ログ、制限 |
| RunPod Pods / dedicated style | RunPod Pods overview, RunPod Pods pricing, RunPod pricing | GPU モデル、secure/community モード、pod 課金、ストレージ、ネットワークボリューム、稼働期待値 |
| Modal | Modal GPU docs, Modal cold starts, Modal pricing | GPU タイプ、関数ライフサイクル、コールドスタート制御、コンテナイメージ戦略、アクティブ使用課金 |
| Google Cloud Run with GPUs | Cloud Run GPU configuration, Cloud Run pricing | GPU サービスの制約、最小インスタンス、同時実行、CPU/メモリ/GPU 課金、リクエスト遅延への影響 |
| Google Compute Engine GPUs | Compute Engine GPU pricing | GPU タイプ、リージョン、VM コスト、ディスク、ネットワーク、予約、確約利用割引 |
| AWS EC2 GPU instances | Amazon EC2 pricing | オンデマンド、スポット、Savings Plans、Reserved Instances、キャパシティブロック、ストレージ、データ転送、サポート |
| Lambda Cloud | Lambda GPU Cloud | インスタンスタイプ、可用性、オンデマンド/予約条件、ストレージ、ネットワーク、サポート範囲 |
| Replicate deployments | Replicate deployments docs | デプロイ設定、スケーリング動作、ハードウェアオプション、最小/最大インスタンス、本番エンドポイントへの適合性 |
この記事では、ソースチェックリストを2026年10月13日に確認しました。
導入を決める前の調達上の質問
serverless GPU vs dedicated GPU を選ぶ前に、以下を確認してください。
| 質問 | 重要な理由 |
|---|---|
| 受理された出力の分母は何ですか? | リクエスト試行数と成功したビジネス成果を比較してしまうことを防ぎます。 |
| エンドポイントはどのくらいの頻度でコールドになりますか? | 断続的なワークロードでは、コールドスタートがレイテンシとコストを支配することがあります。 |
| モデルの読み込みにはどのくらい時間がかかりますか? | 大きな重みはサーバーレスの節約効果を打ち消す可能性があります。 |
| バースト時の同時実行では何が起こりますか? | サーバーレスのキューと専用のオートスケーラーの両方で負荷試験が必要です。 |
| 専用GPUのアイドル率はどのくらいですか? | 遊休容量は主要な固定費の漏れです。 |
| ジョブは安全に再試行できますか? | サーバーレスやスポット風のワークフローには冪等性が必要です。 |
| カスタムランタイム制御は必要ですか? | そうでないなら、専用GPUを持つ必要はないかもしれません。 |
| ストレージ、エグレス、ログ、サポートは含まれていますか? | GPUコンピュートは請求書の一部にすぎません。 |
| ワークロードをモデルAPIに移せますか? | 利用率が低い、または複数モデルを扱う製品では、GPU運用を正当化できない場合があります。 |
| モデルが変わった場合の出口は何ですか? | モデルアーキテクチャが変化すると、ハードウェアへのコミットメントはリスクになります。 |
最適な調達パッケージには、ベンチマーク結果、受理された出力あたりのコストのワークシート、そしてチームが使用量に応じたサーバーレスGPU容量か、制御された専用GPU容量のいずれかを必要とする明確な理由が含まれます。
モデルAPIが両方に勝る場合
サーバーレスGPUと専用GPUのどちらも、GPUレイヤーで運用することが有益であることを前提にしています。場合によってはそうではありません。
管理型のモデルAPIやゲートウェイのほうが適しているのは、次のような場合です:
- 需要が不明、または突発的に増減する。
- 製品が、1つの安定したセルフホストモデルではなく、複数のモデルを必要とする。
- チームが最先端モデルや独自モデルを必要とする。
- 信頼性、フォールバック、プロバイダーの多様性がホストの制御より重要である。
- 経理には利用台帳、予算、そして1つの請求書が必要である。
- エンジニアリング時間はGPU運用よりも製品の振る舞いに使うほうがよい。
Flatkeyはこの判断の側に適合します。OpenAI互換の単一ルート、1つのキー、1つの残高、1つの請求書、利用状況の可視化、そしてプロバイダーをまたいだ公式モデルエンドポイントへのアクセスをチームに提供します。サーバーレスGPU vs 専用GPUのワークシートで低い利用率、高いコールドスタートの無駄、または過大な運用オーバーヘッドが示された場合は、GPUインフラに踏み切る前に、AIモデルの価格比較、AI APIの価格比較、およびAI API支出管理を比較してください。
最終的な推奨
サーバーレスGPU vs 専用GPUの判断には、次の順序を使ってください:
- プロトタイプ、突発的なジョブ、非同期キュー、未知の需要にはサーバーレスGPUを使う。
- コールドスタート、キュー待ち時間、再試行率、受理された出力あたりのコストを測定する。
- 安定して高ボリュームでレイテンシに敏感なワークロードは、利用率が証明された後にのみ専用GPU容量へ移行する。
- モデル選択が頻繁に変わる、ハードウェアの制御が不要、またはチームがより明確な請求とフォールバックを必要とする場合は、モデルAPIの経路を開いたままにする。
サーバーレスGPU vs 専用GPUは、万能の勝者総取りの選択ではありません。サーバーレスGPUは柔軟性と低いアイドルリスクをもたらします。専用GPUは制御性とウォームな容量をもたらします。正しい答えは、レイテンシ、信頼性、運用リスクを実際に管理できる場所に置きつつ、チームにとって受理された出力あたりのコストを最小にするものです。
よくある質問
サーバーレスGPUは専用GPUより安いですか?
トラフィックが低い、突発的である、または不確実で、専用GPUが遊休状態になりやすい場合は、サーバーレスGPUのほうが安くなります。利用率が高く、モデルがウォームに保たれ、チームが配信スタックを効率的に運用できる場合は、専用GPUのほうが安くなります。
サーバーレスGPUには常にコールドスタートがありますか?
すべてのリクエストがコールドになるわけではなく、プロバイダーはウォーム容量、最小ワーカー、イメージ最適化、スケーリングに関してさまざまな制御を提供しています。しかし、大きなモデルやコンテナが実用的になるまでにかなりの時間を要する可能性があるため、コールドスタートはサーバーレスGPU評価における主要なリスクです。
サーバーレスGPUから専用GPUに移行すべきタイミングはいつですか?
安定した需要、高い利用率、許容できないコールドスタート遅延、カスタムランタイム制御の必要性、または運用とアイドル時間を含めた受理された出力あたりのコスト優位性を証明できたときに移行してください。
専用GPUはLLM推論に向いていますか?
専用GPUは、特にvLLM、SGLang、TensorRT-LLM、バッチ処理、キャッシュ挙動、モデル読み込みを調整できる場合、安定した高ボリュームのLLM推論により適していることがあります。低ボリューム、マルチモデル、または急速に変化する製品では、モデルAPIのほうがよりシンプルで安価な場合があります。
最初に何を測定すべきですか?
受理された出力、コールドスタートの割合、キュー待ち時間、p95/p99レイテンシ、再試行率、実効GPU利用率、アイドルコスト、ストレージ/エグレス、そしてエンジニアリング工数を測定してください。これらの指標が、サーバーレスGPU vs 専用GPUの判断を妥当なものにします。


