
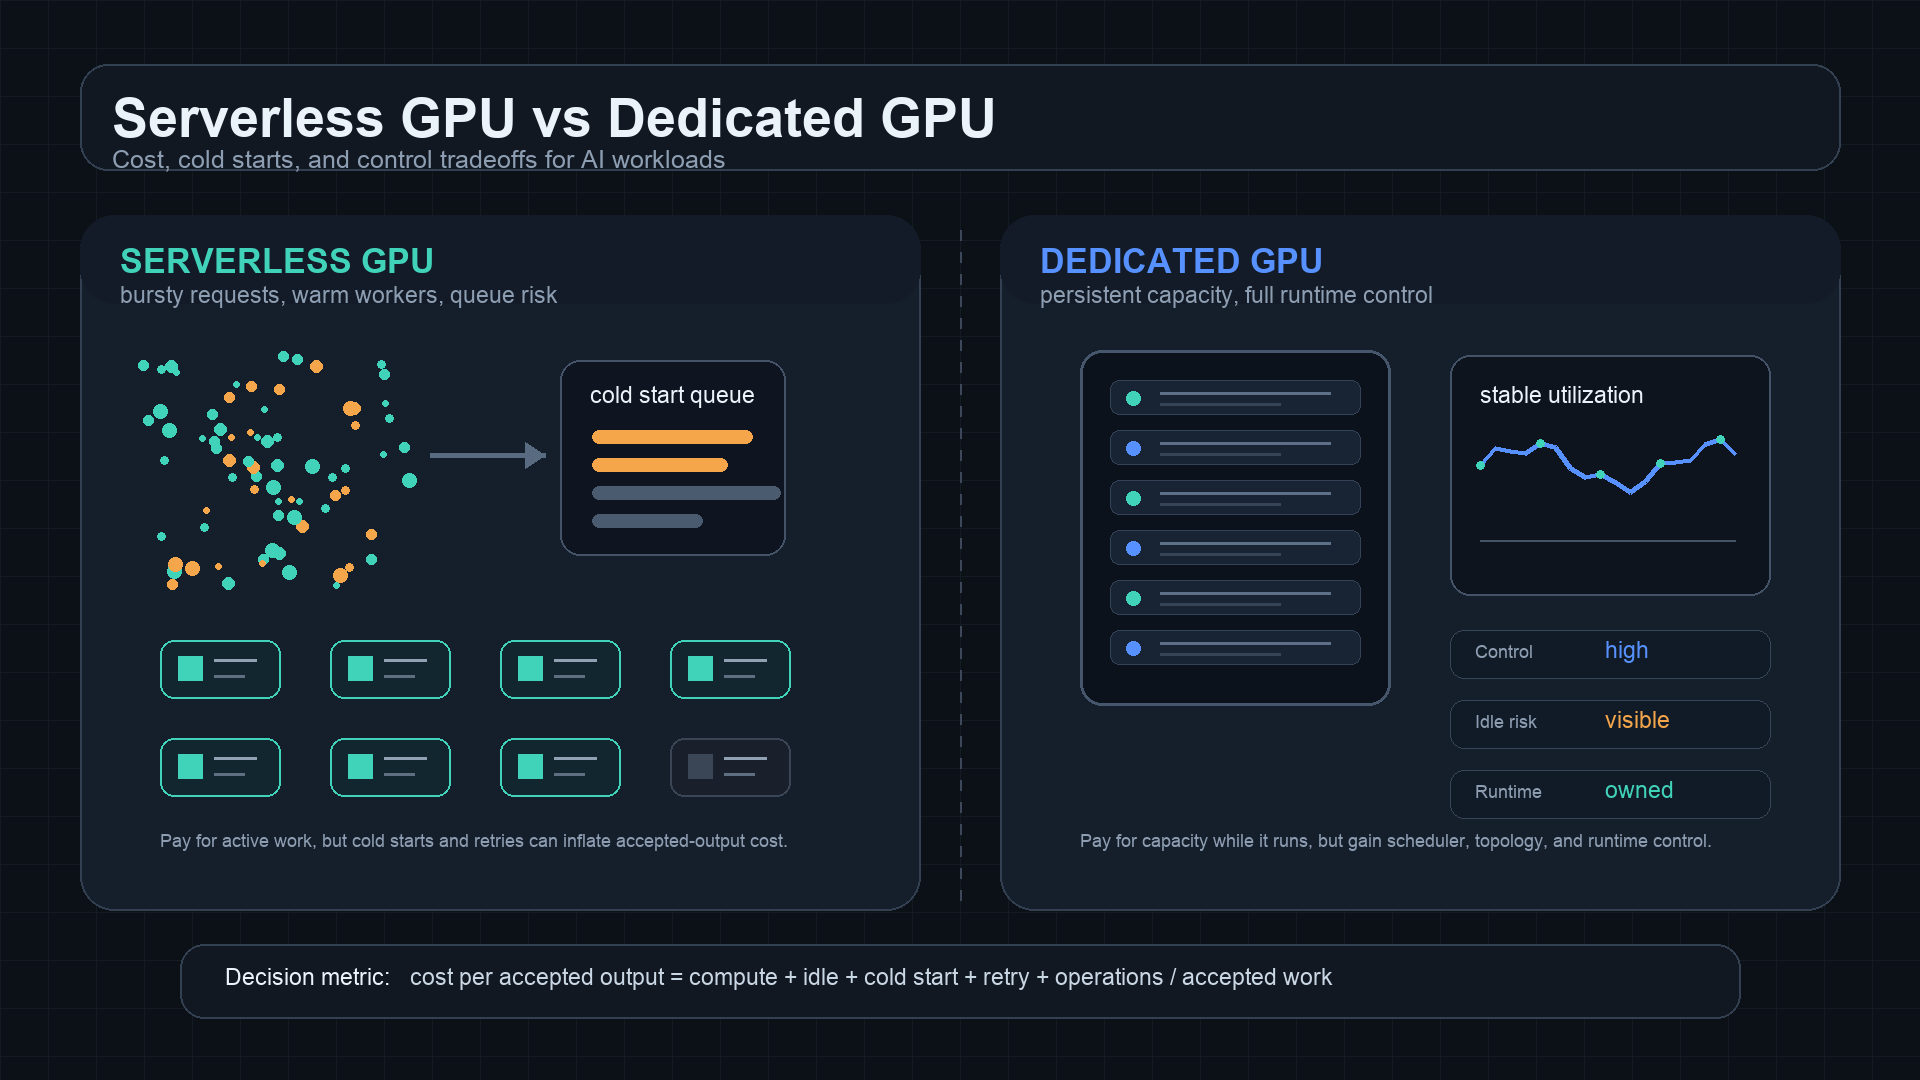
GPU serverless vs GPU dedicado: custo, cold starts e controle
Escolher entre capacidade de GPU serverless e dedicada é, na maior parte, uma questão de padrão de carga de trabalho. GPUs serverless são atraentes quando o tráfego é em picos, os experimentos são irregulares ou a equipe quer evitar hardware ocioso. GPUs dedicadas são atraentes quando a demanda é estável, a latência de inicialização importa ou a equipe precisa de controle sobre drivers, schedulers, rede, caches de modelo e runtimes de serving.
O erro é comparar o preço de uma requisição de GPU serverless com o preço por hora de uma GPU dedicada como se descrevessem a mesma coisa. Não descrevem. Um endpoint serverless pode ocultar cold starts, atraso na fila, limites de concorrência, custo de repetição e overhead por requisição. Uma GPU dedicada pode ocultar tempo ocioso, risco de capacidade reservada, armazenamento, suporte e trabalho de engenharia de plataforma.
Para desenvolvedores independentes e pequenas equipes de IA, a regra prática é:
serverless GPU vs dedicated GPU deve ser comparado pelo custo por saída aceita,
não pela menor tarifa de GPU visível.
Se você ainda está decidindo se o aluguel direto de GPU é necessário, leia também os guias da Flatkey sobre cloud GPU vs API de modelo, preços de aluguel de GPU e custos ocultos de cloud GPU. Este artigo foca na escolha entre GPU serverless vs GPU dedicado depois que GPUs já estão no conjunto de avaliação.
GPU serverless vs GPU dedicado: a resposta rápida
Use esta tabela como primeiro filtro.
| Decision point | Serverless GPU usually fits | Dedicated GPU usually fits |
|---|---|---|
| Traffic pattern | Bursty, queued, experimental, or uneven | Steady, high-volume, latency-sensitive, or capacity-planned |
| Billing shape | Pay mainly when workers run or requests execute, depending on provider | Pay while the instance, pod, node, cluster, or reservation exists |
| Startup risk | Cold starts, model loading, container pull, worker warmup, and queue delay | Less cold-start exposure after warmup, but idle capacity is billable |
| Operational control | Lower control over host, scheduler, runtime, topology, and caching | More control over drivers, serving stack, caches, topology, and observability |
| Reliability model | Provider-managed scaling with endpoint limits and possible cold paths | Team-managed uptime, autoscaling, failover, patches, and incident response |
| Best first use | Demos, image/video jobs, batch inference, sporadic APIs, prototypes | Stable inference endpoints, long-running services, custom runtimes, multi-node work |
A melhor resposta costuma ser em etapas:
- Comece com GPU serverless para demanda desconhecida.
- Meça cold starts, atraso na fila, taxa de retry e custo por saída aceita.
- Migre apenas cargas de trabalho estáveis e de alto volume para capacidade de GPU dedicada.
- Mantenha um caminho de API de modelo aberto quando o produto precisar de muitos modelos ou não precisar de controle de hardware.
Essa sequência é mais segura do que reservar GPUs dedicadas antes de saber se a carga de trabalho consegue mantê-las ocupadas.
O que "GPU serverless" significa na prática
GPU serverless normalmente significa que o provedor abstrai a posse de servidores de longa execução. Você empacota um modelo, container, função ou endpoint; a plataforma inicia workers de GPU quando as requisições chegam; e a plataforma pode escalar workers para cima ou para baixo com base na demanda.
As implementações dos provedores variam. A RunPod descreve Serverless em torno de endpoints e workers, com preço serverless separado do preço de pods. A Modal documenta funções GPU, cold starts e ciclo de vida de containers. O Google Cloud Run suporta serviços com GPUs e tem seu próprio modelo de preços do Cloud Run. As implantações da Replicate expõem endpoints de inferência de produção configuráveis. Esses não são produtos idênticos, então a checklist da origem importa.
Do ponto de vista do comprador, a capacidade de GPU serverless é útil quando:
- O volume de requisições é baixo, em picos ou ainda está sendo descoberto.
- Os jobs podem esperar em fila sem prejudicar a experiência do usuário.
- Cold starts são aceitáveis ou podem ser mascarados.
- A equipe quer menos responsabilidade de infraestrutura.
- A carga de trabalho é empacotada como jobs repetíveis em vez de um serviço permanentemente aquecido.
- O negócio prefere gastos proporcionais ao uso em vez de uma aposta fixa de capacidade mensal.
O trade-off oculto é que GPU serverless não remove a física. Os pesos do modelo ainda precisam ser carregados. Os containers ainda precisam iniciar. As GPUs ainda precisam de capacidade disponível. O atraso na fila ainda afeta os usuários. Os retries ainda custam dinheiro.
O que "GPU dedicada" significa na prática
Capacidade de GPU dedicada significa que você controla uma instância, pod, servidor, nó ou cluster em execução por um período de tempo. Pode ser sob demanda, reservada, comprometida, bare metal, capacidade de marketplace ou um cluster privado. A característica comum é que a GPU é alocada para sua carga de trabalho em vez de ser iniciada apenas em torno de uma requisição.
A capacidade de GPU dedicada é útil quando:
- O endpoint precisa permanecer aquecido.
- O tráfego é suficientemente previsível para manter a GPU ocupada.
- Você precisa de drivers personalizados, versões do CUDA, kernels, servidores de modelo ou rede.
- Você precisa de condições de benchmark consistentes.
- Um cold start quebraria a latência ou a experiência do usuário.
- A carga de trabalho é multinó, sensível à topologia ou sensível à localidade dos dados.
- Você quer operar diretamente o vLLM, SGLang, TensorRT-LLM, Triton, Ray Serve, Kubernetes, Slurm ou uma infraestrutura personalizada de serving.
A compensação oculta é a capacidade ociosa. Se uma GPU dedicada funciona por 730 horas em um mês, mas realiza trabalho útil por apenas 180 horas, o preço horário listado não é o verdadeiro preço por hora útil. As horas ociosas fazem parte do custo da carga de trabalho.
A fórmula de custo que torna a comparação justa
Use um único denominador para ambos os lados:
custo por saída aceita =
  computação
  + armazenamento
  + largura de banda
  + tempo ocioso
  + desperdício de cold start
  + desperdício de retries e jobs com falha
  + suporte
  + overhead de engenharia
  / saídas, registros, tokens, imagens, clipes ou jobs aceitos
Para GPU serverless:
custo de GPU serverless por saída aceita =
  custo cobrado de worker/requisição
  + desperdício de cold start e fila
  + custo de requisições com falha e retries
  + armazenamento e transferência de artefatos
  + overhead de integração da plataforma
  / saídas aceitas
Para GPU dedicada:
custo de GPU dedicada por saída aceita =
  custo de capacidade de GPU em execução
  + armazenamento e rede
  + capacidade ociosa
  + operações da stack de serving
  + suporte e trabalho com incidentes
  + desperdício de falhas e redeploys
  / saídas aceitas
É aqui que as comparações entre GPU serverless vs GPU dedicado muitas vezes se invertem. O serverless pode parecer caro por segundo, mas mais barato no geral se evitar GPUs ociosas. O dedicado pode parecer caro por mês, mas mais barato no geral se a carga mantiver o acelerador ocupado e evitar desperdício de cold start.
Cold starts são o imposto da GPU serverless
Cold starts são o risco mais importante da GPU serverless. Um cold start pode incluir:
- Encontrar capacidade de GPU.
- Fazer pull ou montar uma imagem de container.
- Importar dependências.
- Carregar os pesos do modelo.
- Mover o modelo para a memória da GPU.
- Esquentar kernels ou caminhos de compilação.
- Reconstruir caches.
- Aguardar atrás de requisições já enfileiradas anteriormente.
A documentação de cold start da Modal é útil porque separa o trabalho de inicialização do container, imports e inicialização da aplicação. A mecânica exata varia por provedor, mas a lição é geral: o tempo de inicialização faz parte da experiência do usuário e do modelo de custo.
Cold starts importam mais quando:
| Carga de trabalho | Por que cold starts prejudicam |
|---|---|
| Chat interativo ou agentes | Os usuários percebem a latência alta do primeiro token. |
| Edição de imagem em tempo real | A primeira requisição pode parecer quebrada, mesmo que as seguintes sejam rápidas. |
| Webhooks ou APIs voltadas ao usuário | Timeouts upstream podem transformar cold starts em jobs com falha. |
| Filas batch com SLA rígido | O atraso na fila pode violar janelas de entrega. |
| Modelos grandes | O carregamento dos pesos pode dominar o caminho da requisição. |
A GPU serverless ainda pode ser a escolha certa se a aplicação conseguir absorver esse atraso. Por exemplo, jobs offline de imagem, filas de avaliação noturna, inferência batch assíncrona e experimentos internos geralmente toleram melhor o aquecimento do que chat voltado ao cliente.
GPUs dedicadas trocam cold starts por risco de ociosidade
GPUs dedicadas normalmente reduzem a exposição a cold starts porque o serviço pode permanecer aquecido. Os pesos do modelo permanecem carregados, os caches continuam quentes e o roteamento das requisições pode atingir um endpoint conhecido.
Mas a capacidade dedicada cria um imposto diferente:
fração de desperdício ocioso =
  1 - tempo útil ativo da GPU / tempo faturável em execução
Se a fração útil de tempo ativo da GPU for 30%, uma taxa horária listada menor ainda pode se tornar cara. A GPU dedicada pode estar tecnicamente pronta, mas financeiramente ociosa.
GPUs dedicadas funcionam melhor quando você consegue provar:
- Volume base de requisições.
- Alta utilização da GPU após batching e enfileiramento.
- Escolha estável de modelo.
- Necessidades previsíveis de memória.
- Uma stack de serving que a equipe consiga operar.
- Um plano para deploys progressivos, monitoramento, alertas e fallback.
Se esses insumos forem desconhecidos, GPU serverless ou uma API de modelo geralmente é o primeiro passo mais simples.
Controle: o que as GPUs dedicadas devolvem
O argumento mais forte a favor da capacidade de GPU dedicada nem sempre é o preço. É o controle.
A capacidade dedicada dá à equipe mais poder de decisão sobre:
- Modelo, memória e quantidade de GPU.
- Região e localidade dos dados.
- Versões de CUDA, driver, kernel e imagem.
- Configurações de runtime do vLLM, SGLang, TensorRT-LLM, Triton, Ray Serve ou personalizadas.
- Batching contínuo, comportamento do KV cache, quantização, speculative decoding e ajuste do scheduler.
- Caches locais do modelo e pesos pré-carregados.
- Topologia de rede, links privados, design de VPC, balanceadores de carga e ingress.
- Observabilidade, traces, logs e resposta a incidentes.
Esse controle é valioso quando a carga de trabalho é importante o suficiente para justificar a propriedade. É caro quando a equipe só precisa de saídas confiáveis do modelo.
Este é o mesmo limite abordado nos artigos da Flatkey sobre melhor GPU para inferência de LLM, guia de implantação do vLLM e vLLM vs SGLang. Se você está ajustando o próprio runtime, a capacidade de GPU dedicada pode ser a camada certa. Se você está entregando recursos de produto em vários modelos, um caminho com API gerenciada pode ser mais rápido.
Matriz de decisão de workload
Use esta matriz antes de montar uma planilha.
| Workload | Melhor ponto de partida | Por quê |
|---|---|---|
| Novo recurso de produto de IA com demanda desconhecida | GPU serverless ou API de modelo | Evita comprar capacidade ociosa antes que o tráfego seja conhecido. |
| Fila assíncrona de geração de imagens | GPU serverless | O atraso da fila pode ser aceitável, e picos não exigem GPUs sempre ativas. |
| Demonstração ou protótipo curto | GPU serverless | Configuração rápida e cobrança baseada no uso geralmente importam mais do que o controle do runtime. |
| Inferência de LLM estável e de alto volume | GPU dedicada | Utilização sustentada pode amortizar a stack de serving. |
| Endpoint de cliente sensível à latência | GPU dedicada ou API de modelo | Cold starts e atraso na fila são mais difíceis de esconder. |
| Modelo grande com carregamento lento de pesos | GPU dedicada | Manter os pesos aquecidos pode ser melhor do que iniciar repetidamente em serverless. |
| Suite periódica de avaliação | GPU serverless, GPU spot ou API de modelo em batch | Os jobs são passíveis de retry e podem rodar atrás de uma fila. |
| Kernels CUDA personalizados ou pesquisa de runtime | GPU dedicada | A equipe precisa de controle de baixo nível. |
| Treinamento multinó ou inferência distribuída | Cluster dedicado | Topologia, rede e domínios de falha dominam. |
| Produto que precisa de muitos modelos de fronteira | API de modelo ou gateway | Ter a GPU diretamente não resolve o acesso a modelos de múltiplos provedores. |
Para um planejamento de capacidade mais amplo, combine isso com os guias da Flatkey sobre GPU sob demanda vs spot, TCO de cluster de GPU e aluguel de cluster de GPU.
Armadilhas de custo da GPU serverless
A economia da GPU serverless pode decepcionar quando as equipes ignoram estes campos.
| Armadilha | O que acontece | Controle |
|---|---|---|
| Carregamento lento do modelo | Cada worker frio gasta tempo cobrável antes de começar o trabalho útil | Empacote artefatos antecipadamente, reduza imagens, faça cache de pesos, meça o warmup separadamente |
| Descompasso de timeout | Cold starts acionam timeouts upstream e retries | Defina timeouts realistas, filas assíncronas, IDs de job idempotentes |
| Opacidade da fila | Os usuários veem atraso, mas os dashboards mostram apenas solicitações concluídas | Acompanhe tempo de espera na fila, tempo de cold start, tempo de atividade do worker e latência de saída aceita |
| Jobs pequenos em GPUs grandes | O overhead por solicitação domina o compute útil | Faça batch do trabalho ou use um modelo menor/rota de API |
| Limites de concorrência em picos | As solicitações se acumulam durante janelas de lançamento | Teste a concorrência do endpoint sob carga antes do lançamento |
| Amplificação de retries | Jobs com falha multiplicam tentativas cobradas | Acompanhe saídas aceitas, não saídas tentadas |
| Transferência de dados | Entradas, pesos e saídas se movem repetidamente | Mantenha os artefatos próximos dos workers e expire arquivos temporários |
A pergunta de procurement não é "o provedor suporta GPU serverless?" É "o que acontece com o custo por saída aceita quando os workers estão frios, as filas estão cheias e os retries acontecem?"
Armadilhas de custo da GPU dedicada
A economia da GPU dedicada pode decepcionar na direção oposta.
| Armadilha | O que acontece | Controle |
|---|---|---|
| Endpoint ocioso | A GPU permanece aquecida para solicitações raras | Faça autoscale, consolide workloads ou use serverless/API de modelo para baixo volume |
| Memória superdimensionada | Uma GPU grande executa um workload que caberia em hardware menor | Meça memória e throughput do modelo antes de assumir o compromisso |
| Descompasso de reserva | O contrato assume uma demanda que nunca aparece | Reserve com base na linha de base medida, não nas previsões de lançamento |
| Propriedade da stack de serving | Engenheiros mantêm o runtime em vez de recursos de produto | Inclua o trabalho de plataforma no TCO |
| Linhas ocultas da nuvem | Storage, egress, suporte e rede ficam fora da taxa da GPU | Use uma planilha completa de custos ocultos de GPU cloud |
| Rotatividade de modelos | Nova família de modelos muda memória, precisão ou necessidades de runtime | Mantenha caminhos de saída abertos |
| Fardo de incidentes | Disponibilidade passa a ser problema da sua equipe | Defina alertas, fallback e escopo de suporte do provedor |
O controle da GPU dedicada só é valioso quando a equipe consegue usá-lo. Se o workload não for estável o suficiente para ajustes, o controle extra pode virar atrito operacional.
Exemplo prático: por que a resposta muda com a utilização
Suponha que uma equipe execute um recurso assíncrono de geração de mídia. As taxas exatas são hipotéticas; substitua-as por preços verificados do provedor antes de comprar.
| Campo | GPU serverless | GPU dedicado |
|---|---|---|
| Jobs aceitos por mês | 120,000 | 120,000 |
| Compute listado | Modelado pelo uso | Capacidade mensal fixa |
| Cold start e desperdício de fila | Maior | Menor |
| Capacidade ociosa | Menor | Maior |
| Controle de runtime | Menor | Maior |
| Melhor risco | A demanda é desconhecida | A demanda é estável |
Se a maioria dos jobs chega em rajadas curtas e o restante do dia é tranquilo, a GPU serverless pode vencer porque evita capacidade dedicada ociosa. Se os jobs chegam de forma contínua ao longo do dia e o modelo tem um caminho de aquecimento lento, a GPU dedicada pode vencer porque os workers permanecem quentes e o throughput é mais fácil de ajustar.
Agora mude a carga de trabalho para inferência de LLM voltada ao cliente com latência rigorosa. A decisão pode se inverter mesmo que a serverless pareça mais barata com tráfego baixo, porque caminhos de cold start e atraso de fila criam risco para o produto. Nesse caso, GPU dedicada ou uma API de modelo gerenciada com controles de latência já estabelecidos pode ser mais segura.
A questão não é que um modelo sempre vence. O ponto é que GPU serverless vs GPU dedicado deve ser decidido pela forma medida da carga de trabalho.
Plano de benchmark antes de escolher
Execute a mesma carga de trabalho pelos dois caminhos por uma janela de teste representativa. Acompanhe estas métricas.
| Métrica | Caminho GPU serverless | Caminho GPU dedicado |
|---|---|---|
| Outputs aceitos | Conte os outputs bem-sucedidos após filtros de qualidade | Mesmo denominador |
| Outputs tentados | Inclua jobs com falha e reprocessados | Inclua jobs com falha e reprocessados |
| Latência p50 / p95 / p99 | Inclua tempo de fila e de cold start | Inclua tempo de roteamento e batching |
| Tempo até o primeiro trabalho útil | Inicialização do worker, carregamento do modelo, warmup | Início do deploy, carregamento do modelo, rollout |
| Participação de cold start | Percentual de requests que atingem workers frios | Normalmente menor após o warmup |
| Tempo de espera na fila | Atraso de fila do endpoint e pressão de concorrência | Fila do agendador e espera de batch |
| Utilização da GPU | Tempo ativo do worker, se exposto | Utilização de compute e memória da GPU |
| Custo ocioso | Normalmente menor, mas verifique mínimos | Principal risco de custo |
| Taxa de retry | Timeout, erros de worker, erros de capacidade | OOM, deploy, runtime, erros de host |
| Horas de engenharia | Integração e depuração do endpoint | Operações da plataforma e trabalho de incidentes |
O teste deve incluir condições frias, condições quentes, tráfego em rajadas, tráfego normal e recuperação de falhas. Um benchmark que mede apenas throughput quente não é uma decisão entre GPU serverless vs GPU dedicado; é um teste de velocidade parcial.
Checklist de fontes do provedor
Use páginas oficiais como checklists de fonte, não tabelas de preços congeladas. Refaça a verificação no dia em que aprovar o gasto.
| Provedor/categoria | Fonte oficial a verificar | O que capturar |
|---|---|---|
| RunPod Serverless | Visão geral do RunPod Serverless, Preços do RunPod Serverless | Modelo de endpoint, comportamento do worker, base de cobrança, comportamento de cold start, storage, networking, concorrência, logs, limites |
| RunPod Pods / estilo dedicado | Visão geral do RunPod Pods, Preços do RunPod Pods, Preços do RunPod | Modelo de GPU, modo secure/community, cobrança do pod, storage, volume de rede, expectativas de uptime |
| Modal | Documentação de GPU do Modal, Cold starts do Modal, Preços do Modal | Tipo de GPU, ciclo de vida da função, controles de cold start, estratégia de imagem de container, cobrança por uso ativo |
| Google Cloud Run com GPUs | Configuração de GPU do Cloud Run, Preços do Cloud Run | Restrições do serviço GPU, min instances, concorrência, cobrança de CPU/memória/GPU, impacto na latência de requests |
| Google Compute Engine GPUs | Preços de GPU do Compute Engine | Tipo de GPU, região, custo da VM, disco, rede, reservas, descontos por uso comprometido |
| Instâncias GPU AWS EC2 | Preços do Amazon EC2 | On-Demand, Spot, Savings Plans, Reserved Instances, capacity blocks, storage, transferência de dados, suporte |
| Lambda Cloud | Lambda GPU Cloud | Tipo de instância, disponibilidade, termos on-demand/reserved, storage, networking, escopo de suporte |
| Deployments do Replicate | Documentação de deployments do Replicate | Configurações de deployment, comportamento de escalonamento, opções de hardware, instâncias mínimas/máximas, adequação ao endpoint de produção |
Para este artigo, a checklist de fontes foi revisada em 13 de outubro de 2026.
Perguntas de procurement antes de você se comprometer
Pergunte isso antes de escolher GPU serverless vs GPU dedicado.
| Pergunta | Por que isso importa |
|---|---|
| Qual é o denominador de saídas aceitas? | Evita comparar tentativas de requisição com resultados de negócio bem-sucedidos. |
| Com que frequência o endpoint ficará frio? | Cold starts podem dominar a latência e o custo em cargas de trabalho esporádicas. |
| Quanto tempo leva o carregamento do modelo? | Pesos grandes podem anular a economia do serverless. |
| O que acontece na concorrência em pico? | Tanto as filas serverless quanto os autoscalers dedicados precisam de testes de estresse. |
| Qual é a taxa de ociosidade da GPU dedicada? | Capacidade ociosa é a principal fuga de custo fixo. |
| Os jobs podem ser reexecutados com segurança? | Fluxos de trabalho serverless e do tipo spot precisam de idempotência. |
| Precisamos de controle personalizado de runtime? | Se não, a posse de GPU dedicada pode ser desnecessária. |
| Armazenamento, egress, logs e suporte estão incluídos? | O compute de GPU é apenas uma parte da fatura. |
| A carga de trabalho pode migrar para uma API de modelo? | Produtos de baixa utilização ou com vários modelos podem não justificar operações de GPU. |
| Qual é o caminho de saída se o modelo mudar? | Compromissos de hardware se tornam arriscados quando a arquitetura do modelo muda. |
O melhor pacote de compras inclui um resultado de benchmark, uma planilha de custo por saída aceita e um motivo claro para a equipe precisar de capacidade de GPU serverless moldada pelo uso ou de capacidade dedicada de GPU controlada.
Quando uma API de modelo supera ambas
Tanto GPU serverless quanto GPU dedicada presumem que operar na camada de GPU é útil. Às vezes não é.
Uma API de modelo gerenciada ou gateway pode ser melhor quando:
- A demanda é desconhecida ou em picos.
- O produto precisa de vários modelos, não de um único modelo estável auto-hospedado.
- A equipe precisa de modelos de fronteira ou proprietários.
- Confiabilidade, fallback e diversidade de provedores importam mais do que controle do host.
- Finanças precisa de razão analítica de uso, orçamentos e uma única fatura.
- O tempo de engenharia é melhor gasto no comportamento do produto do que em operações de GPU.
Flatkey se encaixa nesse lado da decisão. Ele oferece às equipes um caminho compatível com OpenAI, uma chave, um saldo, uma fatura, visibilidade de uso e acesso a endpoints oficiais de modelos em vários provedores. Se a planilha de GPU serverless vs GPU dedicada mostrar baixa utilização, desperdício alto de cold start ou overhead operacional demais, compare esse caminho com comparação de preços de modelos de IA, comparação de preços de APIs de IA e gestão de gastos com APIs de IA antes de se comprometer com infraestrutura de GPU.
Recomendação final
Use esta sequência para decisões de GPU serverless vs GPU dedicada:
- Use GPU serverless para protótipos, jobs em rajadas, filas assíncronas e demanda desconhecida.
- Meça cold starts, atraso na fila, taxa de retry e custo por saída aceita.
- Migre cargas de trabalho estáveis, de alto volume e sensíveis à latência para capacidade dedicada de GPU somente depois que a utilização for comprovada.
- Mantenha aberta uma rota de API de modelo quando a escolha do modelo mudar com frequência, quando o controle de hardware não for necessário ou quando a equipe precisar de faturamento e fallback mais limpos.
GPU serverless vs GPU dedicada não é uma escolha universal de vencedor leva tudo. GPU serverless compra flexibilidade e menor risco de ociosidade. GPU dedicada compra controle e capacidade mais quente. A resposta certa é aquela que dá à sua equipe o menor custo por saída aceita, ao mesmo tempo em que coloca latência, confiabilidade e risco operacional onde você realmente pode gerenciá-los.
Perguntas frequentes
GPU serverless é mais barata do que GPU dedicada?
GPU serverless é mais barata quando o tráfego é baixo, em rajadas ou incerto o suficiente para que GPUs dedicadas fiquem ociosas. GPU dedicada é mais barata quando a utilização é alta, o modelo permanece quente e a equipe consegue operar a stack de serving com eficiência.
GPU serverless sempre tem cold starts?
Nenhuma requisição estará fria o tempo todo, e os provedores oferecem controles diferentes para capacidade quente, workers mínimos, otimização de imagem e escalonamento. Mas cold starts são um risco central na avaliação de GPU serverless porque modelos grandes e contêineres podem levar tempo significativo para se tornarem úteis.
Quando devo migrar de GPU serverless para GPU dedicada?
Migre quando puder comprovar demanda estável, alta utilização, latência de cold start inaceitável, necessidade de controle personalizado de runtime ou uma vantagem de custo por saída aceita depois de contabilizar operações e tempo ocioso.
GPU dedicada é melhor para inferência de LLM?
GPU dedicada pode ser melhor para inferência de LLM estável e de alto volume, especialmente quando você ajusta vLLM, SGLang, TensorRT-LLM, batching, comportamento de cache e carregamento do modelo. Para produtos de baixo volume, com vários modelos ou em rápida mudança, uma API de modelo pode ser mais simples e barata.
O que devo medir primeiro?
Meça saídas aceitas, participação de cold starts, espera na fila, latência p95/p99, taxa de retry, utilização útil da GPU, custo ocioso, storage/egress e horas de engenharia. Essas métricas tornam a decisão de GPU serverless vs GPU dedicada defensável.


