
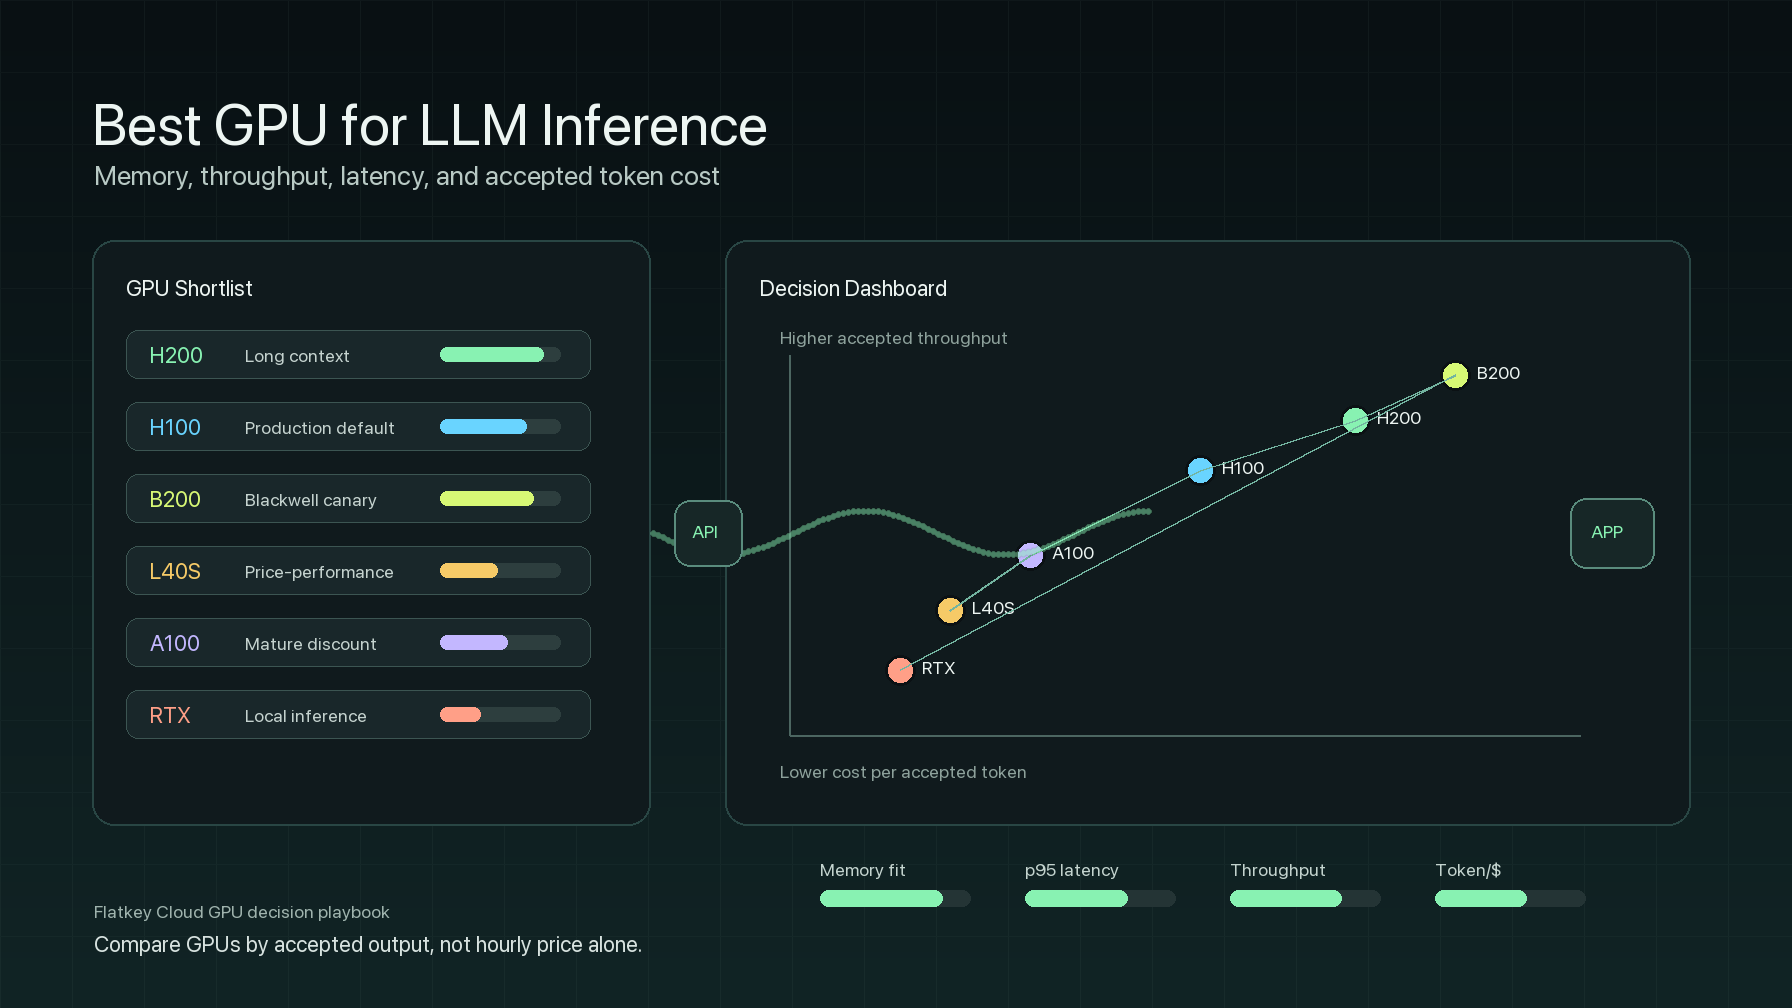
A melhor GPU para inferência de LLM é a GPU que atende ao seu mix real de prompts ao menor custo aceito, enquanto cumpre as metas de memória, latência e confiabilidade. Nem sempre é a GPU mais recente, a listagem horária mais barata ou a placa com a captura de benchmark mais alta.
Para a maioria das equipes de IA empresarial, a resposta curta é:
- Escolha H200 quando a memória for o gargalo: serving de classe 70B, RAG de contexto longo, alta concorrência ou um KV cache que empurre a H100 perto demais do limite.
- Escolha H100 quando você precisar de um padrão de produção maduro, com forte suporte de software, ampla disponibilidade em nuvem e bom rendimento sem migrar para a nova capacidade Blackwell.
- Escolha B200, GB200 ou sistemas Blackwell mais novos quando sua stack puder explorar a precisão e a topologia da era Blackwell, e o provedor puder comprovar disponibilidade real, preço e suporte operacional.
- Escolha L40S ou A100 quando o custo-benefício importar mais do que a latência de pico, o modelo couber sem dificuldades e sua carga de trabalho seja batch, interna ou de contexto moderado.
- Escolha RTX 4090, RTX 5090 ou GPUs de workstation para inferência local de LLM, desenvolvimento, demos e pequenas cargas privadas, não para serving empresarial multi-tenant.
- Use uma API de modelo ou um roteador em vez de alugar GPUs quando o tráfego for em rajadas, a escolha do modelo mudar com frequência ou operar a stack de serving não for o diferencial.
Este guia explica como escolher a melhor GPU para inferência de LLM por memória, rendimento, latência e custo por token. Ele também inclui uma matriz de decisão, um plano de benchmark e uma planilha de tokens por dólar que você pode reutilizar antes de alugar ou comprar capacidade.
Melhor GPU para inferência de LLM: matriz de decisão rápida
| Carga de trabalho | Melhor GPU para começar | Por que normalmente se encaixa | Pontos de atenção |
|---|---|---|---|
| chat 7B-13B, ferramentas internas, protótipos | L40S, RTX 4090, RTX 5090, A100 40GB ou capacidade de nuvem da classe L4 | Um custo horário menor pode importar mais do que a velocidade de pico do acelerador quando o modelo é pequeno e a concorrência é moderada. | Não extrapole a latência de uma demo local para o tráfego de produção p95/p99. |
| inferência 30B-34B | L40S, A100 80GB, H100 PCIe/SXM | Memória suficiente para configurações práticas de serving, com um piso de custo menor do que H200 ou B200. | Contexto longo e alta concorrência podem levar a carga de trabalho para o território da H100/H200. |
| inferência de classe 70B | H100, H200 ou A100/H100 multi-GPU | A H100 é a base madura; a H200 é atraente quando memória e pressão de KV cache reduzem a quantidade de GPUs necessária. | Quantização, paralelismo de tensor e política de batch definem o custo real. |
| RAG de contexto longo | H200 primeiro, depois H100 NVL/SXM ou B200, se disponível | KV cache e prefill de prompt podem tornar a capacidade e a largura de banda de memória mais importantes do que o preço horário bruto. | Faça benchmark com comprimentos de contexto reais, não apenas prompts curtos. |
| inferência em batch de alto rendimento | A100, L40S, H100 ou H100 spot/marketplace | Rendimento por dólar frequentemente supera a menor latência quando os jobs podem enfileirar. | Inclua retries, interrupções, cold starts e custo de armazenamento. |
| chat com clientes sensível à latência | H100, H200 ou B200, dependendo do tamanho do modelo | GPUs de data center mais novas têm melhor suporte à stack de serving, largura de banda e folga para concorrência. | Latência p95 e p99 importam mais do que a média de tokens/seg. |
| inferência local de LLM | RTX 4090, RTX 5090, placas de workstation RTX PRO / classe RTX 6000 | Placas locais são úteis para desenvolvimento privado, testes offline e modelos pequenos. | Placas de consumo não substituem a confiabilidade gerenciada de multi-tenant. |
| produção regulada ou empresarial | H100/H200/B200 em um provedor com suporte, rede, isolamento e controles de auditoria | A camada operacional pode ser mais importante do que o nome da GPU. | Verifique SLA, política de substituição, rede, armazenamento e observabilidade. |
A regra prática: a melhor GPU para inferência de LLM muda quando mudam o tamanho do modelo, o comprimento do contexto, a concorrência, a precisão, o framework de serving e o preço. Faça a GPU merecer a carga de trabalho.
Por que a memória geralmente decide a primeira lista curta
A inferência de LLM usa memória da GPU para mais do que os pesos do modelo. Um servidor de produção também precisa de KV cache, overhead de runtime, buffers de batching, adapters, overhead do tokenizer/servidor e, às vezes, speculative decoding ou buffers de saída estruturada.
Use este modelo de memória de primeira passada:
required_vram =
  model_weights
  + KV_cache_for_target_context_and_concurrency
  + runtime_overhead
  + safety_margin
O KV cache é o motivo pelo qual um modelo que cabe em uma demo curta pode falhar em produção. Prompts longos, lotes maiores, mais requisições concorrentes e limites de saída maiores aumentam a pressão de memória. O melhor custo-benefício de GPU para inferência de LLM muitas vezes é a GPU que evita um shard extra, evita uma tentativa após falta de memória ou permite manter um batch maior sem prejudicar a latência p95.
A capacidade de memória também muda as operações:
| Condição de memória | O que isso significa para o serving de LLM |
|---|---|
| Folga de sobra | Você pode ajustar batch size, comprimento de contexto e concorrência sem risco imediato de OOM. |
| Perto do limite | Quantização, batches menores, contexto mais curto ou paralelismo de tensor tornam-se obrigatórios. |
| Acima do limite | Você precisa de mais GPUs, de uma GPU com mais memória, de um modelo menor, de menor precisão ou de uma rota via API. |
A NVIDIA lista o H200 com 141GB de memória HBM3e e 4.8TB/s de largura de banda de memória. As páginas da NVIDIA para o H100 posicionam o H100 como a base madura de Hopper, enquanto as páginas da AWS P5 mostram famílias de instâncias H100 e H200 com até 8 GPUs por nó e largura de banda GPU-to-GPU NVSwitch. Para o trabalho de compra, o ponto importante não é uma única linha de especificação. É saber se a memória extra reduz a contagem de GPUs, simplifica o sharding ou melhora o rendimento aceito.
Rendimento: tokens por segundo não é suficiente
Tokens/sec brutos são úteis, mas não são a métrica do comprador. Para um serviço em produção, meça o trabalho aceito:
accepted_output_rendimento =
  accepted output tokens or accepted responses
  / wall-clock benchmark duration
Depois normalize pelo custo:
token_per_dollar =
  accepted output tokens per hour
  / effective hourly cost
Essa é a métrica central por trás das buscas por melhor GPU para inferência de LLM token/s/usd. Uma GPU mais barata pode vencer quando permanece bem utilizada e a meta de latência é mais flexível. Uma GPU mais cara pode vencer quando aumenta o batch size, reduz réplicas, evita falhas de memória ou mantém a latência p95/p99 dentro do objetivo de nível de serviço.
Divida o rendimento em duas fases:
| Fase | O que estressa a GPU | O que medir |
|---|---|---|
| Prefill | Comprimento do prompt, trabalho de atenção, movimentação de memória, reutilização de cache | tempo até o primeiro token, tokens do prompt/sec, espera na fila |
| Decode | Comprimento da saída, escalonamento de batch, largura de banda do cache KV | tokens de saída/sec, latência entre tokens, tempo de conclusão p95/p99 |
Para RAG de contexto longo e tráfego de agentes, o prefill pode dominar. Para chat em streaming com respostas longas, o decode pode dominar. Para classificação em batch, requisições aceitas por minuto podem importar mais do que a latência de streaming.
Latência: escolha para p95 e p99, não para velocidade média
A melhor GPU para inferência de LLM sob um SLA voltado ao usuário é a GPU que mantém a latência de cauda sob carga. A latência média esconde enfileiramento, vizinhos ruidosos, falhas de cache, cold starts e novas tentativas após OOM.
Acompanhe estas métricas em cada teste de GPU:
able>| Métrica | Por que importa |
|---|---|
| Tempo até o primeiro token | Responsividade percebida pelo usuário e eficiência do prefill. |
| Latência entre tokens | Qualidade do streaming e velocidade do decode. |
| Latência ponta a ponta | Tempo total de conclusão da tarefa. |
| Latência p95 e p99 | Saúde real do SLO em produção. |
| Espera na fila | Se o servidor já está sobrecarregado antes mesmo de a geração começar. |
| Taxa de OOM e de retry | Se o benchmark é estável o suficiente para orientar a compra. |
| Utilização da GPU e utilização da largura de banda HBM | Se a GPU é o gargalo ou se o pipeline está esperando em outro lugar. |
Se a cotação do H200 for 1,4x a cotação de um H100 e ele fornecer 1,8x de rendimento de saída aceita para a sua carga de trabalho, o H200 pode vencer. Se custar 2,2x e melhorar o p95 em apenas 10%, o H100 provavelmente vence. Se um L40S for muito mais barato e atender ao alvo de latência para um modelo de 13B, o L40S pode ser a melhor GPU para custo-benefício de inferência de LLM para esse cenário.
Melhor GPU para inferência local de LLM
A melhor GPU para inferência local de LLM é uma questão diferente da melhor GPU de serving corporativo. A inferência local geralmente valoriza preço de compra, consumo de energia na mesa, VRAM, privacidade e conveniência para desenvolvedores. O serving em produção valoriza disponibilidade, observabilidade, política de substituição, interconexão, isolamento multi-tenant e suporte.
Para uso local:
- RTX 4090 e RTX 5090 são opções fortes para desenvolvimento local de modelos pequenos e quantizados, porque oferecem alto desempenho de GPU de consumo e VRAM suficiente para muitos experimentos.
- GPUs de workstation da classe RTX PRO / RTX 6000 são melhores quando você precisa de mais VRAM, drivers de workstation ou suporte profissional.
- Memória unificada da Mac ou inferência em CPU pode ser útil para testes, mas não deve ser tratada como benchmark de serving em GPU.
- Rigs locais com múltiplas GPUs podem funcionar para pesquisa, mas raramente igualam as operações de um data center em nuvem, a menos que sua equipe seja responsável por energia, refrigeração, rede, monitoramento e recuperação de falhas.
Use GPUs locais para validar prompts, qualidade, quantização e comportamento da aplicação. Use GPUs em nuvem ou em data center para validar concorrência de produção, latência p95/p99, disponibilidade, custo por token aceito e processos de rollout.
GPU recomendada por modelo e padrão de serving
| Padrão de serving | Lista curta de GPUs | Por quê |
|---|---|---|
| Bot de suporte 7B/8B, contexto moderado | L40S, A100 40GB/80GB, H100 PCIe, RTX de classe local para desenvolvimento | O modelo é pequeno o suficiente para que um custo horário menor possa importar mais do que a memória de ponta. |
| Assistente privado 13B-34B | L40S, A100 80GB, H100 | Escolha com base na concorrência e no alvo de latência; o H100 é útil quando a latência de cauda importa. |
| Chat 70B com contexto moderado | H100, H200, 2x A100/H100 dependendo da precisão | Faça benchmark de quantização, paralelismo tensorial e política de batch. |
| RAG de longo contexto 70B | H200, H100 NVL/SXM, B200 quando disponível | A memória e a pressão sobre o KV cache podem dominar. |
| API corporativa multi-tenant | H100/H200/B200 em um provedor com suporte | Suporte, observabilidade, isolamento e política de substituição importam. |
| Inferência offline em lote | A100, L40S, H100 spot ou marketplace | Rendimento por dólar pode superar a menor latência. |
| Laptop ou desktop do desenvolvedor | RTX 4090, RTX 5090, RTX PRO/workstation | Ótimo para inferência local de LLM e desenvolvimento de prompts; não é uma resposta completa para produção. |
Plano de benchmark antes de alugar ou comprar
Não escolha a melhor GPU para inferência de LLM apenas com base em um benchmark genérico. Execute uma reprodução que se pareça com o seu produto.
- Congele a carga de trabalho. Registre o ID do modelo, a quantização, a precisão, a distribuição do comprimento dos prompts, a distribuição do comprimento das saídas, o contexto-alvo, a concorrência e as verificações de qualidade.
- Congele a stack de serving. Use a mesma versão do vLLM, SGLang, TensorRT-LLM, NIM ou servidor personalizado em todos os testes de GPU, quando possível.
- Congele a configuração de hardware. Capture o SKU da GPU, a quantidade de GPUs, PCIe/SXM/NVL, CPU, RAM, armazenamento, driver, versão do CUDA, rede e posicionamento.
- Execute três traços de tráfego. Chat curto, RAG de longo contexto e prompts em lote/offline revelam gargalos diferentes.
- Meça p50, p95, p99. A latência média não é suficiente para inferência voltada ao cliente.
- Acompanhe falhas. Conte OOMs, timeouts, evictions, falhas de cold start e amplificação de retries.
- Calcule o custo aceito. Divida o custo efetivo por tokens de saída aceitos, respostas aceitas ou tarefas concluídas.
- Execute pelo menos um dia de canário. Os preços de marketplace, a disponibilidade do provedor e o enfileiramento podem mudar durante janelas reais de tráfego.
Tabela mínima de benchmark:
| Métrica | GPU candidata A | GPU candidata B | GPU candidata C |
|---|---|---|---|
| Preço horário da GPU | |||
| Custo horário efetivo | |||
| Tokens de saída aceitos/hora | |||
| Custo por 1M de tokens de saída aceitos | |||
| Tempo até o primeiro token p95 | |||
| Latência ponta a ponta p95/p99 | |||
| Taxa de OOM ou de retry | |||
| Utilização média da GPU | |||
| Notas sobre operações |
Quando uma API de modelo supera alugar GPUs
A melhor GPU para inferência de LLM pode ser, na verdade, nenhuma locação de GPU. O controle direto da GPU é valioso quando você tem pesos proprietários, utilização sustentada, kernels personalizados, forte localidade de dados ou uma equipe de serving que consegue manter as GPUs ocupadas.
Use uma API de modelo ou um roteador quando:
- O tráfego é irregular.
- Você precisa de vários provedores de modelos, em vez de um único modelo open-weight fixo.
- A escolha do modelo muda com frequência.
- Você precisa mais de fallback do que de controle de bare-metal.
- O tempo ocioso da GPU excederia qualquer prêmio de API por token.
- Sua equipe quer registros de uso, limites de orçamento, faturas e governança de provedores sem operar um cluster de serving.
A Flatkey se encaixa nesse lado da decisão: uma chave, um saldo, uma fatura, mais de 300 modelos oficiais, mais de 1.000 ferramentas pay-per-call e registros de uso no nível da requisição. Se uma carga de trabalho não exigir pesos auto-hospedados, compare o custo da GPU por token aceito com rotas gerenciadas de modelo antes de se comprometer com um cluster de GPU.
Para decisões de custo relacionadas, veja os guias da Flatkey sobre preços de aluguel de GPU, H100 vs A100, H200 vs H100, aluguel de cluster de GPU, vLLM vs SGLang e comparação de preços de modelos de IA.
Recomendação final
A melhor GPU para inferência de LLM depende da carga de trabalho:
- Use H200 quando memória, contexto longo e pressão de cache KV determinarem o custo.
- Use H100 quando você precisar de um padrão de produção comprovado e a carga de trabalho se adequar.
- Use B200 ou GB200 quando houver capacidade Blackwell disponível, a stack de serving estiver pronta e seu benchmark comprovar o prêmio.
- Use L40S ou A100 quando custo-benefício superar a latência máxima.
- Use GPUs locais da classe RTX para desenvolvimento e inferência local de LLM, não para serving multi-tenant empresarial.
- Use Flatkey ou outra camada de API de modelo quando operar GPUs diretamente não for a vantagem do produto.
A métrica de compra não é "qual GPU é a mais rápida?" É custo por token aceito no nível de latência e confiabilidade que seu produto exige.
Perguntas frequentes
Qual é a melhor GPU para inferência de LLM?
A melhor GPU para inferência de LLM depende da carga de trabalho. A H200 costuma ser o ponto de partida mais forte para serving de 70B e de contexto longo limitado por memória. A H100 é o padrão de produção maduro. A L40S, a A100, a RTX 4090 ou a RTX 5090 podem ser melhores para modelos menores, jobs em lote ou inferência local quando atendem à meta de latência com menor custo.
Qual é a melhor GPU para custo-benefício na inferência de LLM?
A melhor GPU para custo-benefício na inferência de LLM é a GPU com o menor custo por token aceito ou resposta aceita, e não o menor preço por hora. Calcule o custo horário efetivo, tokens de saída aceitos por hora, latência p95/p99 e taxa de falha antes de escolher.
Como calculo a melhor GPU para inferência de LLM em token/s/usd?
Use os tokens de saída aceitos por hora divididos pelo custo horário efetivo. O custo efetivo deve incluir aluguel da GPU, armazenamento, largura de banda, tempo ocioso, retries, suporte e overhead de engenharia. Depois compare o mesmo modelo, precisão, comprimento de contexto e stack de serving entre GPUs.
H100 ou H200 é melhor para inferência de LLM?
A H200 geralmente é melhor quando capacidade de memória, largura de banda, contexto longo ou um KV cache maior alteram a forma do serving. A H100 geralmente é melhor quando o modelo se encaixa bem, a capacidade é mais barata ou mais fácil de obter, e o benchmark atende às metas de latência e rendimento.
A B200 é a melhor GPU para inferência de LLM?
Os sistemas B200 ou GB200 podem ser excelentes para inferência de LLM em grande escala quando o provedor tem capacidade real, o framework de serving suporta a precisão e a topologia que você pretende usar, e o benchmark comprova um custo aceito menor. Não compre capacidade Blackwell apenas com base em promessas de lançamento; teste seu tráfego.
Qual é a melhor GPU para inferência local de LLM?
Para inferência local de LLM, a RTX 4090 e a RTX 5090 são escolhas comuns de alto desempenho para desenvolvedores, enquanto placas RTX PRO ou da classe RTX 6000 são melhores quando você precisa de mais VRAM ou de suporte profissional para workstation. GPUs locais são melhores para desenvolvimento, privacidade e pequenos deployments, não para confiabilidade total de serving empresarial.
Fontes verificadas
- GPU NVIDIA H200: https://www.nvidia.com/en-us/data-center/h200/
- GPU NVIDIA H100 Tensor Core: https://www.nvidia.com/en-us/data-center/h100/
- GPU NVIDIA A100 Tensor Core: https://www.nvidia.com/en-us/data-center/a100/
- NVIDIA DGX B200: https://www.nvidia.com/en-us/data-center/dgx-b200/
- GPU NVIDIA L40S: https://www.nvidia.com/en-us/data-center/l40s/
- NVIDIA GeForce RTX 5090: https://www.nvidia.com/en-us/geforce/graphics-cards/50-series/rtx-5090/
- Preços do cloud GPU da RunPod: https://www.runpod.io/pricing
- Preços do cloud GPU da Lambda: https://lambda.ai/pricing
- Instâncias AWS EC2 P5: https://aws.amazon.com/ec2/instance-types/p5/
- Tipos de máquina com GPU do Google Cloud: https://docs.cloud.google.com/docs/compute-area/gpus
- Documentação do servidor compatível com OpenAI do vLLM: https://docs.vllm.ai/en/latest/serving/openai_compatible_server.html


