title: "Инференс и обучение ИИ: производительность, стоимость и компромиссы при развертывании" slug: ai-inference-vs-training canonical_url: https://flatkey.ai/blog/ai-inference-vs-training meta_title: "Инференс и обучение ИИ: стоимость, производительность и развертывание" meta_description: "Инференс и обучение ИИ: сравнение метрик производительности, факторов стоимости, требований к развертыванию и случаев, когда следует дообучать или обслуживать модель." category: "Стоимость, биллинг и эксплуатация"
Инференс и обучение ИИ: производительность, стоимость и компромиссы при развертывании
Инференс ИИ и обучение — это не выбор между двумя взаимозаменяемыми задачами для GPU. Обучение изменяет модель; инференс использует обученную модель для получения результата. Это различие меняет то, что вы измеряете, за что платите и как эксплуатируете рабочую нагрузку.
Для большинства продуктовых команд первый полезный вопрос — не «Какой GPU самый быстрый?». Он звучит так: Нам нужно создать или адаптировать поведение модели либо надежно предоставлять пользователям возможности готовой модели? Первое — задача обучения или дообучения. Второе — задача инференса и обслуживания модели.
Google Cloud описывает обучение как процесс оптимизации модели на данных, тогда как инференс применяет обученную модель к новым входным данным. Также проводится полезное различие между инференсом — вычислением — и обслуживанием — системой, которая предоставляет и эксплуатирует это вычисление для запросов. Прочитайте обзор инференса ИИ.
Инференс и обучение ИИ: краткий обзор
| Аспект | Обучение | Инференс |
|---|---|---|
| Основная цель | Обучить или адаптировать параметры модели | Получать прогнозы, классификации или сгенерированный результат на основе фиксированных параметров |
| Основной цикл | Прямой проход, расчет функции потерь, обратный проход, обновление оптимизатора | Обработка входных данных, прямой проход и — при генерации — декодирование токен за токеном |
| Входные данные | Исторические датасеты, метки или вознаграждения, наборы для оценки | Онлайн-запросы, пакетные задания или события приложения |
| Важное состояние | Веса модели, градиенты, состояние оптимизатора, активации, контрольные точки | Веса модели, состояние запроса, KV-кэш для многих нагрузок LLM, состояние маршрутизации и очередей |
| Главный вопрос о производительности | Как быстро и надежно модель может достичь требуемого качества? | Могут ли пользователи получить требуемое качество в рамках целевой задержки и доступности? |
| Основной риск затрат | Недоиспользованное время кластера, неудачные запуски, подготовка данных, низкая эффективность масштабирования | Простаивающие мощности, неэффективное пакетирование, длинные промпты, давление на кэш, хвостовая задержка и всплески трафика |
| Фокус эксплуатации | Воспроизводимость, происхождение данных, контрольные точки, распределенная коммуникация | Прием запросов, обслуживание модели, автомасштабирование, наблюдаемость, повторные попытки и плавная деградация |
Поэтому решение между инференсом и обучением ИИ следует начинать с бизнес-результата и формы рабочей нагрузки, а не со спецификации оборудования.
Что фактически меняется в вычислительном пути?
Обучение и инференс могут использовать одну архитектуру и один тип ускорителя, но выполняют разную работу и хранят разное состояние.
Обучение обновляет модель
Обычный шаг обучения выглядит так:
training batch → forward pass → loss → backward pass → gradient sync → optimizer update → checkpoint
Прямой проход оценивает результат. Обратный проход рассчитывает, как должны измениться параметры. Оптимизатор обновляет веса. В распределенной задаче рабочие процессы также должны координировать градиенты или другое состояние модели. Например, документация PyTorch по DistributedDataParallel поясняет, что во время обучения реплики синхронизируют градиенты между процессами. См. справочник PyTorch DDP.
Поэтому память при обучении — это не просто вопрос «помещается ли модель». Задаче также требуется место для активаций, градиентов, состояния оптимизатора, коммуникационных буферов и контрольных точек восстановления. Точное соотношение зависит от модели, точности, метода параллелизма, размера пакета и фреймворка.
Инференс использует модель
Инференс обычно выглядит так:
request → tokenize / preprocess → prefill → decode or predict → response
Веса остаются фиксированными для запроса. Для генеративной LLM сервер обрабатывает промпт на этапе prefill, а затем постепенно генерирует результат. Поэтому длина запроса, число одновременных последовательностей, память, выделенная под KV-кэш, и поведение очереди имеют ключевое значение при сравнении инференса и обучения ИИ.
Важная оговорка: один запрос инференса обычно дешевле полного шага обучения, но конечная точка в продакшене может выполнять миллионы запросов. Поэтому постоянно загруженная система инференса может иметь более высокую совокупную стоимость эксплуатации за весь срок службы, чем короткий запланированный запуск обучения.
Компромиссы производительности: оптимизация для другой системы показателей
Не используйте одно значение «токенов в секунду» для сравнения этих нагрузок. В каждом случае оно отвечает на разные вопросы.
Производительность обучения: время до надежной модели
Для обучения отслеживайте показатели, которые определяют, достигнет ли команда целевого качества в срок:
| Показатель | Почему это важно | Распространенный режим отказа |
|---|---|---|
| Время шага и число обработанных примеров или токенов в секунду | Показывает, насколько быстро продвигается эксперимент | Высокая номинальная пропускная способность скрывает худший результат по данным или качеству |
| Время до целевого качества | Связывает вычисления с фактической целью | Оптимизация скорости при стагнации метрики оценки |
| Эффективность масштабирования | Показывает, сокращают ли дополнительные GPU время выполнения достаточно, чтобы оправдать их использование | Коммуникации, загрузка данных или отстающие исполнители поглощают ожидаемый выигрыш |
| Время создания контрольных точек и восстановления | Ограничивает стоимость прерывания | Неудачный долгий запуск перезапускается со старой контрольной точки |
| Воспроизводимость и вариативность оценки | Делает результаты сопоставимыми между запусками | «Улучшение» нельзя повторить или связать с конкретным изменением |
Распределенное обучение добавляет к вычислительной задаче проблему сети и координации. Синхронизация градиентов является частью пути обучения, поэтому топология, перекрытие коммуникаций, шардинг данных и восстановление после сбоев могут быть не менее важны, чем заявленная пропускная способность ускорителя.
Производительность инференса: полезные ответы под нагрузкой
Инференс должен удовлетворять пользователя или нижестоящую систему, пока множество запросов конкурируют за одни и те же мощности. Для потоковых LLM практическая панель мониторинга включает:
| Показатель | Что он показывает |
|---|---|
| Время до первого токена (TTFT) | Как долго пользователь ждет, прежде чем увидит начало ответа |
| Межтокенная задержка (ITL) или время на выходной токен (TPOT) | Насколько плавно поступает сгенерированный результат после первого токена |
| Сквозная задержка | Сколько времени занимает полный запрос |
| Пропускная способность при SLO | Общий объем полезной работы при сохранении приемлемых TTFT и задержки на токен |
| Глубина очереди и доля отклоненных запросов | Насыщена ли емкость еще до начала работы модели |
| Доля ошибок и доля принятия качества результата | Являются ли быстрые ответы также полезными |
Текущая документация vLLM по бенчмаркам определяет TTFT как время от отправки запроса до получения первого потокового результата и различает ITL и TPOT. В примерах также предупреждается, что повторное использование кэша может создать впечатление более высокой пропускной способности по сравнению с нагрузкой без кэша. См. документацию по CLI бенчмарков vLLM.
Это предупреждение полезно в целом: тестируйте именно ту структуру запросов, которую действительно ожидаете. Длины промптов, ограничения на результат, возможность кэширования, конкурентность, потоковый режим и обработка ошибок могут изменить результат инференса сильнее, чем один лишь синтетический размер пакета.
MLCommons подчеркивает то же самое с точки зрения проектирования бенчмарков: системы инференса оцениваются как по целевым показателям качества, так и по ограничениям задержки или пропускной способности, зависящим от сценария. Ознакомьтесь с определениями бенчмарков MLPerf Inference.
Компромиссы стоимости: обучение — это проект, инференс — это сервис
Самый чистый способ сравнить стоимость инференса и обучения ИИ — отнести каждую нагрузку к единице, создающей ценность.
Модель затрат на обучение
Для проекта обучения или дообучения используйте модель уровня запуска:
cost per validated model version =
(accelerator time + storage + network + data preparation + experiment operations)
÷ validated model versions
Эта модель выявляет затраты, которые не видны при сравнении GPU-часов:
- Работа с данными: сбор, проверка прав, очистка, разметка, дедупликация и версионирование.
- Потери на экспериментах: запуски, которые завершаются сбоем, плохо сходятся или не могут быть воспроизведены.
- Простои и время восстановления: зарезервированные мощности, ожидающие данных, неисправного исполнителя или восстановления контрольной точки.
- Неэффективность масштабирования: больше ускорителей может сократить запуск, но не линейно, если узким местом становятся коммуникации или входные конвейеры.
- Работа по оценке и безопасности: модель не готова только потому, что завершился последний шаг обучения.
Если команде нужен лишь более удачный формат вывода, надежный вызов инструмента или доменный контекст, передаваемый во время запроса, обучение с нуля обычно является неверной первоначальной моделью затрат. Вместо этого начните с промптинга, поиска, проектирования рабочих процессов или ограниченного эксперимента по дообучению.
Модель затрат на инференс
Для онлайн-обслуживания используйте модель успешного результата:
cost per accepted response =
(serving capacity + storage + network + observability + support operations)
÷ accepted responses
Для пакетной задачи замените ответы принятыми записями, изображениями или документами. Цель остается той же: делить на полезный результат, а не на необработанные запросы или заявленные часы ускорителей.
Основными факторами затрат на инференс обычно являются:
- Форма трафика: всплесковый или равномерный спрос определяет, какой объем мощностей простаивает.
- Длина ввода и вывода: более длинные промпты и генерации потребляют больше вычислений и памяти на запрос.
- Конкурентность и пакетирование: большие пакеты могут повысить загрузку, но также могут увеличить ожидание отдельных пользователей.
- Поведение KV-кэша: для LLM емкость и повторное использование кэша влияют и на задержку, и на фактический запас памяти.
- Проектирование доступности: реплики, региональное размещение, повторные попытки и аварийное переключение защищают пользовательский опыт, но повышают операционные затраты.
- Выбор модели и точности: изменение модели или формата среды выполнения может одновременно изменить качество, потребность в памяти и скорость.
Командам, решающим, нужно ли вообще владеть мощностями для обслуживания, следует сравнивать самостоятельно размещаемую нагрузку с управляемым API модели, используя одно и то же определение принятого результата. Это позволяет не считать низкую цену GPU-часа победой, когда разработка, простаивающие мощности и работа по надежности являются более крупными статьями затрат. Следующий шаг этого решения рассмотрен в статье GPU-облако и API модели.
Компромиссы развертывания: кластеры против конечных точек
По умолчанию обучение и инференс не должны использовать одну операционную модель.
Для развертывания обучения нужна воспроизводимая платформа экспериментов
Среда обучения производственного уровня обычно требует:
- Версионированных данных и наборов оценки, чтобы результат можно было проследить до его входных данных.
- Воспроизводимой среды с зафиксированными кодом, зависимостями, конфигурацией модели и политикой seed.
- Топологии ускорителей и сети, соответствующей выбранной стратегии параллелизма.
- Хранилища контрольных точек и политики перезапуска, рассчитанных на прерывания, вытеснение и расследование.
- Отслеживания экспериментов, которое связывает гиперпараметры, метрики, артефакты и решения об утверждении.
- Шлюза продвижения, который проверяет качество, безопасность, стоимость и откат перед развертыванием.
Kubernetes может планировать ресурсы GPU с помощью плагинов устройств и меток от поставщиков, но это не отменяет необходимости планировать драйверы, возможности узлов, хранилище, распределенные коммуникации и оркестрацию рабочих нагрузок. Здесь Kubernetes документирует модель планирования GPU.
Для развертывания инференса нужен функционирующий сервис
У развертывания инференса другой контрольный список:
- Версионированный сервер модели с протестированными токенизатором, средой выполнения и контрактом запросов.
- Контроль допуска и ограничения емкости, чтобы перегрузка превращалась в контролируемую постановку в очередь или отсечение, а не в коллапс.
- Политика масштабирования с учетом запросов, которая учитывает конкурентность, длину промпта и время в очереди, а не только загрузку CPU.
- Элементы управления кэшированием и пакетированием, протестированные и по пропускной способности, и по хвостовой задержке.
- Наблюдаемость для TTFT, TPOT или ITL, сквозной задержки, глубины очереди, ошибок, насыщения и принятия результата.
- Поведение отката, маршрутизации и резервного сценария для регрессий модели или сбоев поставщика.
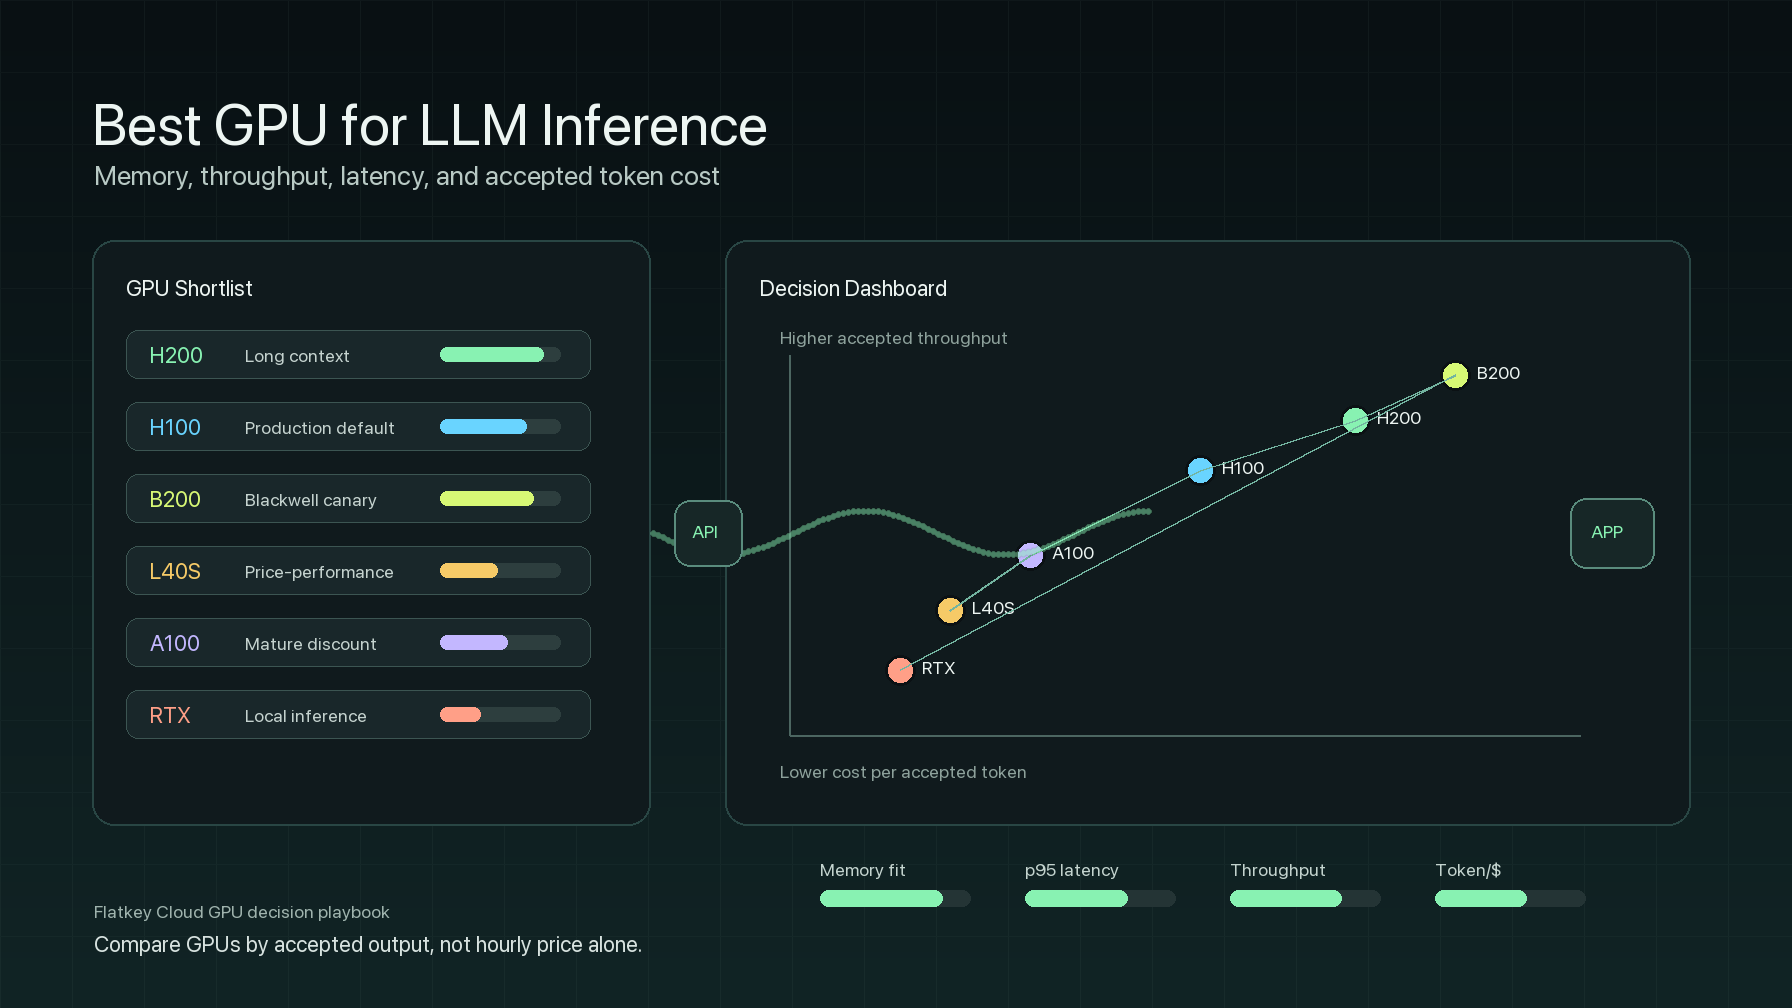
Если вы выбрали самостоятельное размещение, лучший GPU для инференса LLM зависит от размещения в памяти, формы запросов, целевой задержки и стоимости на принятый результат, а не от универсального победителя. Если сначала нужно выбрать операционную модель, сравните мощности бессерверных и выделенных GPU.
Дообучение — это промежуточный путь
Вопрос «инференс или обучение ИИ» часто скрывает третий вариант: дообучение.
Дообучение по-прежнему является обучением, поскольку обновляет параметры. Однако оно начинается с предварительно обученной модели и использует гораздо меньший, специализированный для задачи датасет, чем обучение с нуля. Это может быть уместно, когда промптинг и поиск не могут удовлетворить измеримое требование — например, строгое поведение структурированного вывода, повторяющееся специализированное преобразование или доменную задачу со стабильными размеченными примерами.
Считайте дообучение гипотезой, а не вариантом по умолчанию. До выделения мощностей определите базовую модель, отложенный набор оценки, порог приемки, путь отката и ожидаемое влияние на инференс. Дообучение, которое улучшает офлайн-метрику, но создает неприемлемую нагрузку по задержке, стоимости или сопровождению, не является улучшением для продакшена.
Практическое дерево решений
Используйте эту последовательность, чтобы превратить абстрактное обсуждение инфраструктуры в решение:
- Может ли предварительно обученная модель удовлетворить требование с помощью промптинга, использования инструментов, поиска или изменений рабочего процесса? Если да, начните с инференса.
- Есть ли постоянная, измеримая проблема на репрезентативных входных данных и качественный специализированный для задачи датасет? Если да, оцените ограниченный эксперимент по дообучению.
- Нужна ли вам новая фундаментальная возможность, есть ли защищаемый актив данных и можете ли вы финансировать данные, обучение, оценку и постоянное обслуживание? Только тогда оценивайте обучение с нуля.
- Нужен ли для инференса контроль на уровне оборудования, пользовательская среда выполнения, размещение данных или предсказуемая загрузка, оправдывающая эксплуатацию мощностей? Если да, оцените самостоятельное размещение. Если нет, используйте управляемый API модели как базовый вариант.
- Что произойдет, если спрос удвоится или версия модели даст регрессию? Опишите поведение масштабирования, резервного сценария и отката до того, как запуск превратит это в инцидент.
Это дерево решений намеренно консервативно. Обычно дешевле подтвердить потребность продукта с помощью инференса, прежде чем платить за организацию, необходимую для обучения и эксплуатации собственной модели.
Копируемый бриф рабочей нагрузки: решите до резервирования GPU
Используйте этот одностраничный бриф для каждой новой нагрузки. Он дает продуктовым, ML- и инфраструктурным командам общее определение готовности.
| Поле | Бриф обучения или дообучения | Бриф инференса |
|---|---|---|
| Результат для пользователя | Какую возможность или разрыв в качестве необходимо улучшить? | Какой ответ или автоматизацию должен получить пользователь? |
| Метрика успеха | Метрика качества на отложенном наборе, проверки безопасности, стоимость на валидированную версию | TTFT, задержка на токен или сквозная задержка, пропускная способность при SLO, доля принятых результатов |
| Контракт данных | Источник датасета, права, версия, метки или вознаграждения, разделение для оценки | Схема запросов, распределения промптов и результатов, граница конфиденциальности, возможность кэширования |
| Предположение о емкости | Количество GPU, размещение в памяти, параллелизм, периодичность контрольных точек, целевое восстановление | Размер модели, конкурентность, ограничения промпта/вывода, пакетирование, бюджет кэша, политика реплик |
| Граница затрат | Максимальная стоимость на валидированную версию модели | Максимальная стоимость на принятый ответ или пакетную запись |
| План отказов | Плохие данные, неудачный запуск, потерянный исполнитель, регрессия качества | Всплеск очереди, насыщение, неудачный выпуск модели, сбой вышестоящей системы, небезопасный результат |
| Критерий выхода | Продвинуть, пересмотреть или остановить на основе шлюза оценки | Масштабировать, маршрутизировать, откатить или изменить модель на основе SLO сервиса |
Ценность этого брифа не в самом шаблоне. Он заставляет команду сказать, покупает ли она возможности модели, надежность обслуживания или и то и другое. В этом и состоит реальный компромисс инференса и обучения ИИ.
Где подходит единый API моделей
Если ваш ответ — «инференс, но не владение оборудованием», начните с рассмотрения API модели как базового варианта сравнения. Flatkey предоставляет один ключ API и один баланс для доступа к более чем 300 официальным моделям и более чем 1 000 инструментам с оплатой за вызов, поэтому команда может отделить выбор модели и учет использования от решения об обслуживании на GPU. Изучите модели Flatkey.
Это не заменяет самостоятельное развертывание там, где необходим контроль, который дает эксплуатация среды выполнения. Но это дает практичную альтернативу для сравнения до того, как вы выделите мощности, стек обслуживания и ответственность дежурной команды.
Заключение: выберите операционную задачу, которая у вас действительно есть
Выбор между инференсом и обучением ИИ становится простым, когда вы называете операционную задачу:
- Выбирайте обучение, когда вам нужно создать или существенно адаптировать возможности модели и вы можете обеспечить данные, оценку, эксперименты и распределенные вычисления.
- Выбирайте инференс, когда обученная модель уже может выполнять задачу, а проблема состоит в предоставлении полезных результатов с приемлемой задержкой, надежностью и экономикой единицы.
- Выбирайте дообучение только тогда, когда измеренный разрыв и репрезентативный датасет оправдывают обновление предварительно обученной модели.
Прежде чем выбирать GPU, составьте бриф рабочей нагрузки, протестируйте реальную форму запросов или данных и определите порог качества и стоимости, при котором эту работу стоит эксплуатировать.
Часто задаваемые вопросы
В чем главное различие между инференсом ИИ и обучением?
Обучение использует данные и оптимизацию для обновления параметров модели. Инференс использует фиксированные параметры, чтобы преобразовать новый ввод в прогноз или сгенерированный результат. В продакшене обслуживание — это дополнительная работа по предоставлению и эксплуатации инференса как надежной системы.
Инференс всегда дешевле обучения?
Нет. Один запрос инференса обычно легче шага обучения, но конечная точка с большим объемом трафика или постоянной работой может за весь срок службы стоить больше, чем ограниченный проект обучения. Сравнивайте стоимость на валидированную версию модели для обучения и на принятый результат для инференса.
Дообучение — это обучение или инференс?
Дообучение — это обучение, поскольку оно обновляет параметры. Обычно это более узкая и менее дорогая альтернатива обучению модели с нуля. Получившейся модели все равно необходимо развертывание инференса для обслуживания запросов.
Какие метрики наиболее важны для сравнения инференса и обучения ИИ?
Для обучения сосредоточьтесь на качестве, времени до целевого качества, пропускной способности, эффективности масштабирования и восстановлении. Для онлайн-инференса LLM отслеживайте TTFT, TPOT или ITL, сквозную задержку, пропускную способность при выбранном SLO, очереди, ошибки и долю принятых результатов.
Может ли один парк GPU выполнять обучение и инференс?
Может, но совместные мощности часто создают конфликтующие приоритеты: обучение выигрывает от долгих эффективных задач, тогда как пользовательскому инференсу нужна предсказуемая задержка и запас для всплесков. Изолируйте нагрузки или определите явные правила планирования и вытеснения до совместного использования парка.