
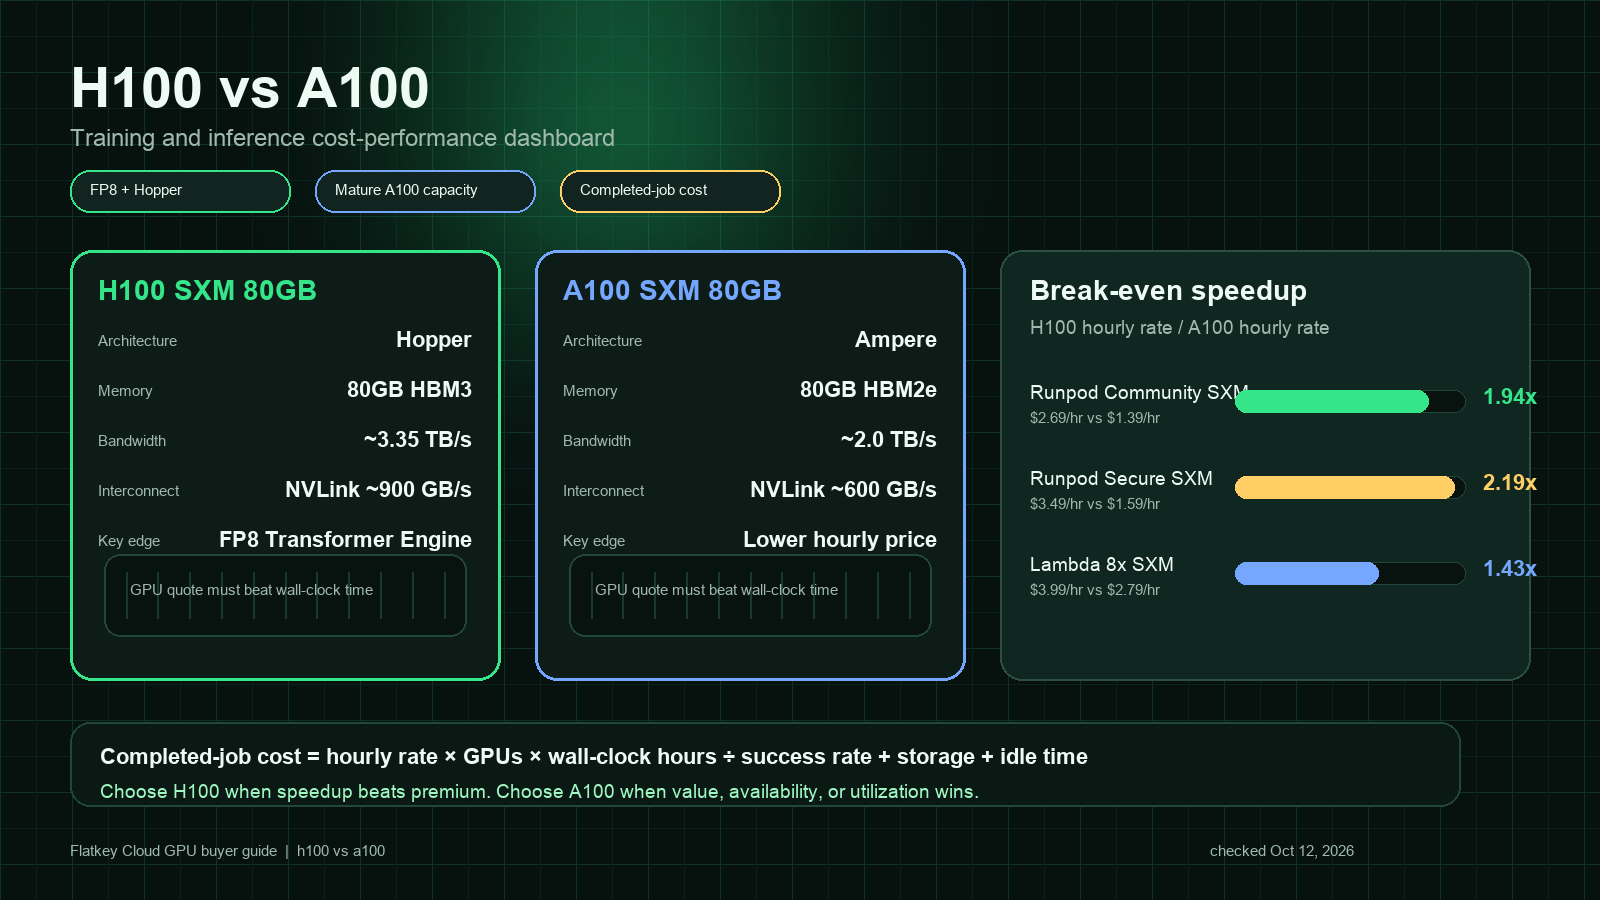
A resposta curta para H100 vs A100 é direta: escolha a H100 quando a carga de trabalho puder explorar recursos do Hopper, como o Transformer Engine FP8, maior largura de banda de memória, NVLink de quarta geração mais rápido e novos kernels de inferência. Escolha a A100 quando a tarefa for estável em memória, o throughput FP16/BF16 já for suficiente, a disponibilidade importar mais do que a velocidade máxima, ou a cotação horária da A100 for muito menor.
É por isso que a pergunta certa não é "Qual GPU é mais rápida?" A H100 é o acelerador mais novo e mais rápido. A pergunta do comprador é: a H100 conclui sua tarefa de treinamento ou inferência rápido o bastante para superar o prêmio de preço da A100?
Este guia compara NVIDIA H100 vs A100 para treinamento de IA, inferência de LLM, fine-tuning, tarefas em lote e aquisição de GPU na nuvem. Os preços mudam toda semana, então trate as linhas de preço público abaixo como exemplos de cotação verificados em 12 de outubro de 2026 e depois refaça o mesmo cálculo com sua lista de provedores.
Desempenho de H100 vs A100: tabela rápida de decisão
| Carga de trabalho | Normalmente escolha | Por quê |
|---|---|---|
| Treinamento de LLM de fronteira ou pré-treinamento distribuído em grande escala | H100 SXM | Transformer Engine FP8, maior largura de banda de memória, NVLink mais rápido e melhor margem de escala multi-GPU. |
| Fine-tuning de modelos de 7B a 70B | Depende | A H100 vence quando o tempo de treinamento importa; a A100 vence quando a execução não é limitada por throughput ou o orçamento é fixo. |
| Inferência de LLM sensível à latência | H100 | Melhor caminho de inferência para transformers, maior largura de banda e otimização mais recente da pilha de serving. |
| Inferência em lote com SLA relaxado | A100 | Preço horário menor pode vencer se a utilização for alta e o tempo de fila for aceitável. |
| Notebooks multiusuário, demonstrações e tarefas pequenas | A100 | Disponibilidade madura, menor custo e suporte a MIG fazem da A100 uma escolha padrão prática. |
| Cargas de trabalho limitadas por memória que caibam em 80 GB | Teste ambas | A H100 tem largura de banda muito maior, mas a A100 80 GB ainda pode ser mais barata por tarefa concluída. |
| Cargas CUDA legadas já otimizadas para Ampere | A100 primeiro | Menor risco de migração, a menos que o benchmarking da H100 prove um ganho significativo. |
Para a maioria das equipes que comparam h100 vs a100 performance, comece com uma regra de duas linhas:
- Se a tarefa é cara porque leva tempo demais, teste a H100 primeiro.
- Se a tarefa é cara porque a GPU fica ociosa, falha ou espera por dados, melhore a utilização antes de pagar por H100.
Diferenças principais de especificação
A diferença mais importante entre NVIDIA A100 vs H100 é a geração arquitetural. A A100 é baseada na NVIDIA Ampere. A H100 é baseada na NVIDIA Hopper e adiciona o Transformer Engine, aceleração tensorial FP8, NVLink mais novo e limites de energia SXM mais altos. A NVIDIA posiciona a H100 para IA em larga escala, HPC e cargas de trabalho com trilhões de parâmetros, enquanto a A100 continua sendo um acelerador de data center amplamente implantado para treinamento, inferência, analytics e HPC. Fontes: página de produto NVIDIA H100, página de produto NVIDIA A100 e line card de GPUs para data center da NVIDIA.
| Área | NVIDIA H100 SXM 80 GB | NVIDIA A100 SXM 80 GB | Implicação para o comprador |
|---|---|---|---|
| Arquitetura | Hopper | Ampere | A H100 é a geração mais nova otimizada para IA. |
| Memória | 80 GB HBM3 | 80 GB HBM2e | Mesma capacidade principal nos modelos comuns de 80 GB, mas a H100 tem memória mais rápida. |
| Largura de banda de memória | Até cerca de 3,35 TB/s | Até cerca de 2,0 TB/s | A H100 tem mais espaço para treinamento e inferência limitados por memória. |
| Precisão tensorial | Caminhos tensoriais FP8, FP16, BF16, TF32, FP64 | Caminhos tensoriais FP16, BF16, TF32, FP64 | O FP8 pode melhorar substancialmente o throughput de transformers quando a precisão se mantém. |
| Geração do NVLink | NVLink de quarta geração, até 900 GB/s de largura de banda GPU a GPU no SXM | NVLink de terceira geração, até 600 GB/s de largura de banda GPU a GPU no SXM | A H100 é mais forte para treinamento multi-GPU e paralelismo de modelos grandes. |
| MIG | Suportado | Suportado | Ambas podem particionar GPUs para utilização multiusuário. |
| Envelope típico de energia SXM | Mais alto | Mais baixo | A H100 pode exigir mais energia e refrigeração, mas pode terminar mais rápido. |
Esses números explicam por que uma comparação h100 gpu vs a100 muda conforme a carga de trabalho. Um modelo que consegue usar FP8 e kernels mais novos pode ver a H100 disparar à frente. Uma tarefa menor, limitada por pré-processamento em CPU, armazenamento ou rede, pode mostrar um ganho muito menor.
Fórmula de custo-benefício
Use o custo da tarefa concluída em vez do preço horário:
completed_job_cost =
  GPU_hourly_rate
  x number_of_GPUs
  x wall_clock_hours
  / success_rate
  + storage
  + network
  + idle_time
  + orchestration_overhead
Depois compare:
H100 must be at least this much faster to break even =
  H100_hourly_rate / A100_hourly_rate
Se a H100 custa 1,8x mais que a A100, ela precisa concluir a mesma tarefa aceita mais de 1,8x mais rápido para vencer no aluguel bruto da GPU. Se custa 1,4x mais, a barreira de equilíbrio é menor. É por isso que a seleção de GPU na nuvem deve sempre usar o SKU e a cotação exatos: H100 SXM, H100 PCIe, H100 NVL, A100 SXM 80 GB e A100 PCIe 40 GB não são intercambiáveis.
Para uma planilha mais ampla sobre custos ocultos, veja o guia da Flatkey sobre preços de aluguel de GPU.
Exemplos de preços de GPU em nuvem pública verificados em 12 de outubro de 2026
A tabela abaixo não é um índice universal de preços. É um instantâneo de exemplos públicos que mostram o quão ampla pode ser a variação.
| Página do provedor | Exemplo de H100 | Exemplo de A100 | O que isso mostra |
|---|---|---|---|
| Preços da Runpod | H100 SXM: Community Cloud US$ 2,69/h, Secure Cloud US$ 3,49/h; H100 PCIe: Community Cloud US$ 1,99/h, Secure Cloud US$ 2,89/h | A100 SXM: Community Cloud US$ 1,39/h, Secure Cloud US$ 1,59/h; A100 PCIe: Community Cloud US$ 1,19/h, Secure Cloud US$ 1,59/h | Mercado e ambientes seguros podem ter pontos de equilíbrio diferentes. |
| Preços da Lambda | linha de cluster 8x H100 SXM: US$ 3,99/GPU/h; linha de H100 SXM individual: US$ 4,29/GPU/h; linha de H100 PCIe individual: US$ 3,29/GPU/h | linha de 8x A100 SXM 80 GB: US$ 2,79/GPU/h; linha de A100 SXM 40 GB individual: US$ 1,99/GPU/h | Tamanho do cluster, tamanho da memória e configuração do nó importam tanto quanto o nome da GPU. |
| Preços da Massed Compute | A página lista tarifas e configurações de GPU sob demanda | A página lista tarifas e configurações de GPU sob demanda | Sempre verifique quantidade, memória, armazenamento e detalhes da instância antes de comparar. |
Com base nesses exemplos, um comprador que compare desempenho a100 vs h100 não deve assumir um prêmio fixo. Em uma cotação, a H100 PCIe pode ficar próxima o suficiente da A100 para que a H100 seja fácil de justificar. Em outra, a A100 pode ser barata o bastante para que uma execução mais lenta ainda vença.
Comparação de treinamento
Para treinamento, a H100 geralmente é a primeira GPU a testar quando:
- Você treina modelos transformer e pode usar com segurança precisão mista FP8.
- O job é grande o suficiente para que a velocidade do kernel e a velocidade de interconexão dominem a sobrecarga de configuração.
- Você usa paralelismo de modelo multinó ou multi-GPU.
- Você tem um prazo rígido em que um tempo total de execução menor vale mais do que o prêmio por hora.
- Sua equipe consegue manter as GPUs altamente utilizadas com dados preparados, checkpoints estáveis e novas tentativas automatizadas.
A A100 ainda pode ser a melhor compra para treinamento quando:
- O modelo cabe claramente em 80 GB e não se beneficia muito de FP8.
- Você faz fine-tuning em vez de pré-treinamento.
- Você executa muitos experimentos em que a profundidade da fila importa mais do que a execução única mais rápida.
- Seu código, drivers, stack CUDA e monitoramento já estão estáveis na A100.
- Você está comprando capacidade reservada e o desconto da A100 é alto.
O hábito importante de aquisição é comparar custo por execução de treinamento aceita, e não apenas tokens por segundo. Uma execução rápida na H100 que falha tarde por instabilidade de checkpoint, dados ou treinamento distribuído pode sair mais cara do que uma execução mais lenta na A100 que conclui de forma confiável.
Comparação de inferência
Para inferência, a H100 muitas vezes vence quando o caminho de serving é otimizado para kernels modernos de LLM:
- Solicitações de contexto longo pressionam a largura de banda de memória e o movimento do KV-cache.
- Serving com alta concorrência se beneficia de otimização de kernel mais nova.
- SLAs de latência são apertados o suficiente para que menor latência p95 ou p99 tenha valor de negócio.
- O modelo usa FP8 ou caminhos de quantização que sua stack de serving valida.
- Você consegue agrupar solicitações suficientes para manter a GPU ocupada.
A A100 muitas vezes vence quando:
- Lotes podem ser executados durante a noite.
- O volume de solicitações é irregular e deixaria H100s caras ociosas.
- O modelo é pequeno o bastante para que uma camada de GPU mais barata seja a verdadeira vencedora.
- Você está servindo ferramentas internas estáveis em vez de tráfego crítico para receita.
- Você pode encaminhar o excedente para uma API de modelo gerenciada em vez de manter capacidade dedicada ociosa.
Para serving de LLM, o desempenho h100 vs a100 também depende da camada de software: vLLM, TensorRT-LLM, SGLang, NVIDIA NIM, formato de quantização, política de batching, configurações de KV-cache e distribuição do comprimento dos prompts. Não compre H100 com base apenas em um benchmark genérico. Reproduza sua própria mistura de prompts.
Um plano prático de benchmark
Execute o mesmo benchmark em cada SKU candidata. Mantenha os critérios de aceitação fixos.
| Etapa | O que medir | Por que isso importa |
|---|---|---|
| 1. Fixar a carga de trabalho | Modelo, comprimento da sequência, tamanho do lote, precisão, conjunto de dados, política de retry | Evita uma comparação falsa de maçãs com maçãs. |
| 2. Medir throughput | Tokens/s de treinamento, amostras/s ou tokens/s de inferência | Mostra a velocidade bruta. |
| 3. Medir latência | p50, p95, p99, time-to-first-token, velocidade de decodificação | Captura o desempenho visível para o usuário. |
| 4. Acompanhar utilização | Utilização da GPU, largura de banda de memória, espera de CPU, espera de armazenamento, espera de rede | Revela se a escolha da GPU é, de fato, o gargalo. |
| 5. Acompanhar falhas | Reinícios de job, OOMs, erros de kernel, interrupções spot | Converte tarifas horárias baratas em custo real concluído. |
| 6. Calcular custo aceito | Custo por execução concluída, saída aceita ou milhão de tokens servidos | Este é o número que a área de compras deve comparar. |
Replay mínimo de inferência:
100 prompts curtos
100 prompts médios
100 prompts de contexto longo
mesmo modelo
mesma precisão
mesma versão do servidor
mesmos tokens máximos
mesma escada de concorrência
mesmas verificações de qualidade
Reprodução mínima de treinamento:
mesmo checkpoint
mesma partição do conjunto de dados
mesmo tamanho global alvo de batch
mesmas configurações do otimizador
mesma política de precisão
mesmo intervalo de checkpoint
mesmo método de recuperação de falhas
Quão mais rápido o H100 precisa ser?
Use sua cotação e então calcule o speedup de ponto de equilíbrio.
| Exemplo de cotação | Preço do H100 | Preço do A100 | Prêmio de preço do H100 | Interpretação do ponto de equilíbrio |
|---|---|---|---|---|
| Runpod Community H100 SXM vs A100 SXM | $2.69/hr | $1.39/hr | 1.94x | O H100 precisa terminar mais de 1.94x mais rápido antes que custos ocultos para vencer no aluguel da GPU. |
| Runpod Secure H100 SXM vs A100 SXM | $3.49/hr | $1.59/hr | 2.19x | O H100 precisa de um grande speedup ou de uma forte razão de latência/negócio. |
| Lambda 8x H100 SXM vs 8x A100 SXM 80 GB | $3.99/GPU/hr | $2.79/GPU/hr | 1.43x | O H100 pode vencer com um speedup muito menor. |
| Lambda single H100 PCIe vs single A100 SXM 40 GB | $3.29/hr | $1.99/hr | 1.65x | A comparação mistura SKUs; diferenças de memória e interconexão precisam ser consideradas. |
É aqui que muitas comparações de desempenho a100 vs h100 dão errado. Um benchmark que diz "H100 é 2x mais rápido" não é suficiente. Você precisa saber se a sua cotação do H100 é 1.4x, 1.9x ou 2.2x a cotação do A100, e se o job realmente conclui com sucesso nessa velocidade.
Checklist de compras
Antes de escolher H100 ou A100, peça aos fornecedores:
- SKU exata da GPU: SXM, PCIe, NVL, tamanho de memória e política de MIG.
- Formato do nó: quantidade de GPUs, CPU, RAM, NVMe local, rede e interconexão.
- Tecido de rede para clusters: NVLink/NVSwitch dentro do nó, InfiniBand ou Ethernet entre nós, política de oversubscription.
- Preço e desempenho do armazenamento: SSD local, volume persistente, armazenamento de objetos, snapshot e tempo de restauração.
- Política de egress e banda.
- Unidade de cobrança: por segundo, por minuto ou por hora.
- Política de interrupção para capacidade spot ou de marketplace.
- Restrições de região e conformidade.
- SLA de suporte e processo de substituição.
- Termos de reserva e regras de cancelamento.
Para treinamento distribuído, o formato do nó pode decidir o resultado. Oito H100s atrás de um NVSwitch robusto e de um bom tecido de rede não são comparáveis a oito GPUs isoladas conectadas por um caminho de rede fraco.
Quando o H100 vale o prêmio
Normalmente vale a pena pagar pelo H100 quando pelo menos dois destes pontos são verdadeiros:
- A carga de trabalho é intensa em transformers e foi validada com FP8 ou kernels otimizados para Hopper.
- O tempo de treinamento bloqueia lançamentos, entrega ao cliente ou a iteração de pesquisa.
- A latência p95 ou p99 da inferência afeta receita ou retenção de usuários.
- O trabalho usa fortemente comunicação entre múltiplas GPUs.
- O provedor oferece um prêmio do H100 moderado em relação ao A100.
- Sua equipe consegue manter alta a utilização.
O H100 é mais difícil de justificar quando:
- A GPU fica ociosa por grande parte da hora.
- Carregamento de dados, pré-processamento em CPU ou I/O de rede é o gargalo.
- Sua stack de serving não está ajustada.
- O modelo é pequeno o suficiente para L40S, RTX PRO ou uma API gerenciada.
- A capacidade do A100 está fortemente descontada.
Quando o A100 ainda é a escolha pragmática
O A100 continua sendo um padrão prático para muitas equipes de IA porque é maduro, amplamente disponível e ainda muito forte para treinamento e inferência. Ele é especialmente útil quando você precisa de capacidade previsível para:
- Jobs de fine-tuning.
- Geração de embeddings.
- Inferência em lote.
- Ferramentas internas de IA.
- Notebooks de pesquisa.
- Ambientes multi-tenant usando MIG.
- Cargas legadas de CUDA já validadas em Ampere.
Se uma execução no A100 custa metade e termina apenas 20% mais devagar, o A100 vence. Se custa 30% menos, mas leva 2x mais tempo, o H100 provavelmente vence. A conta muda novamente se a capacidade do A100 for mais fácil de reservar ou se o tempo de espera do H100 atrasar o projeto.
Onde o Flatkey se encaixa
Alugar GPU nem sempre é a forma mais barata de executar IA. Para algumas cargas de trabalho, uma API de modelo gerenciada é mais barata porque você paga por solicitação bem-sucedida em vez de manter uma GPU ocupada. Para outras, a capacidade dedicada de GPU é melhor porque você tem volume constante, modelos personalizados, necessidades estritas de latência ou requisitos de controle de dados.
O Flatkey ajuda as equipes a comparar esses caminhos pelo lado da aplicação: uma chave de API, um saldo, um livro-razão de uso e roteamento de modelos entre endpoints oficiais de modelos. Use aluguel de GPU quando a carga de trabalho exigir capacidade dedicada. Use uma rota de API de modelo quando a carga de trabalho for intermitente, operacionalmente mais simples ou mais barata por tarefa aceita.
FAQ H100 vs A100
O H100 é mais rápido que o A100?
Sim. O H100 é a GPU mais nova da geração Hopper e tem grandes vantagens em cargas de trabalho orientadas a transformers, largura de banda de memória, suporte a FP8 e interconexão mais nova. A decisão real é saber se ele é rápido o suficiente para superar o prêmio de preço do H100 para a sua carga de trabalho.
O A100 ainda é bom para inferência de LLM?
Sim. O A100 ainda é uma GPU de inferência capaz, especialmente para serving em lote, ferramentas internas, embeddings e cargas de trabalho em que os requisitos de latência são moderados. O H100 é mais forte para serving de transformers de alto throughput e sensíveis à latência quando a stack de software está ajustada.
Devo comparar H100 SXM com A100 PCIe?
Só se essas forem as cotações reais que você pode comprar. Para comparação técnica, mantenha o formato e a memória o mais próximos possível: H100 SXM vs A100 SXM, H100 PCIe vs A100 PCIe, 80 GB vs 80 GB quando disponível.
O FP8 torna a H100 automaticamente melhor?
Não. O FP8 ajuda apenas quando o modelo e a stack de software conseguem usá-lo sem perda de qualidade inaceitável. Valide a qualidade da saída, a convergência e a estabilidade antes de presumir economias com FP8.
Qual é melhor para fine-tuning?
Para trabalhos de fine-tuning pequenos e médios, a A100 pode ser mais custo-efetiva. Para trabalhos maiores, prazos apertados ou stacks de treinamento que se beneficiam da largura de banda e dos caminhos FP8 da H100, a H100 pode vencer.
Qual é a melhor métrica para H100 vs A100?
Use custo por resultado aceito: execução de treinamento concluída, checkpoint de modelo aceito, um milhão de tokens atendidos, lote bem-sucedido ou resposta dentro do limite de latência. O preço por hora sozinho é incompleto.
Conclusão
Para h100 vs a100, a H100 é a escolha de desempenho e a A100 costuma ser a escolha de valor. A H100 vence quando os recursos do Hopper reduzem o tempo de execução o suficiente para superar o prêmio por hora. A A100 vence quando a carga de trabalho é estável, a utilização é imperfeita, a diferença de preço é grande ou a latência não é a restrição.
Antes de reservar qualquer GPU, faça benchmark do seu próprio modelo, reproduza seu próprio tráfego e calcule o custo do trabalho concluído. Essa é a única comparação H100 vs A100 que resiste à análise de aquisição.


