title: "Suy luận AI và huấn luyện: Đánh đổi về hiệu năng, chi phí và triển khai" slug: ai-inference-vs-training canonical_url: https://flatkey.ai/blog/ai-inference-vs-training meta_title: "Suy luận AI và huấn luyện: Chi phí, hiệu năng & triển khai" meta_description: "Giải thích về suy luận AI và huấn luyện: so sánh các chỉ số hiệu năng, yếu tố chi phí, yêu cầu triển khai và thời điểm nên tinh chỉnh hoặc phục vụ mô hình." category: "Chi phí, thanh toán và vận hành"
Suy luận AI và huấn luyện: Đánh đổi về hiệu năng, chi phí và triển khai
Suy luận AI và huấn luyện không phải là hai loại tác vụ GPU có thể hoán đổi cho nhau. Huấn luyện thay đổi một mô hình; suy luận sử dụng mô hình đã được huấn luyện để tạo ra kết quả. Sự khác biệt đó thay đổi những gì bạn đo lường, những khoản bạn phải trả và cách bạn vận hành khối lượng công việc.
Với phần lớn nhóm sản phẩm, câu hỏi hữu ích đầu tiên không phải là “GPU nào nhanh nhất?” mà là: Chúng ta cần tạo ra hoặc điều chỉnh hành vi của mô hình, hay cần phục vụ người dùng bằng một mô hình đủ năng lực một cách đáng tin cậy? Trường hợp đầu là bài toán huấn luyện hoặc tinh chỉnh. Trường hợp sau là bài toán suy luận và phục vụ mô hình.
Google Cloud mô tả huấn luyện là quá trình tối ưu hóa mô hình từ dữ liệu, còn suy luận là áp dụng mô hình đã huấn luyện cho đầu vào mới. Tài liệu này cũng đưa ra sự phân biệt hữu ích giữa suy luận—phép tính toán—và phục vụ mô hình—hệ thống cung cấp và vận hành phép tính đó để xử lý các yêu cầu. Đọc tổng quan của Google Cloud về suy luận AI.
Tổng quan về suy luận AI và huấn luyện
| Khía cạnh | Huấn luyện | Suy luận |
|---|---|---|
| Mục đích chính | Học hoặc điều chỉnh các tham số của mô hình | Tạo dự đoán, kết quả phân loại hoặc nội dung được sinh ra từ các tham số cố định |
| Chu trình cốt lõi | Lượt truyền xuôi, tính hàm mất mát, lượt truyền ngược, cập nhật bằng bộ tối ưu hóa | Xử lý đầu vào, lượt truyền xuôi và—khi sinh nội dung—giải mã từng token |
| Dữ liệu đầu vào | Tập dữ liệu lịch sử, nhãn hoặc phần thưởng, tập đánh giá | Yêu cầu trực tiếp, tác vụ theo lô hoặc sự kiện ứng dụng |
| Trạng thái cần quan tâm | Trọng số mô hình, gradient, trạng thái bộ tối ưu hóa, giá trị kích hoạt, checkpoint | Trọng số mô hình, trạng thái yêu cầu, bộ nhớ đệm KV cho nhiều khối lượng công việc LLM, trạng thái định tuyến và hàng đợi |
| Câu hỏi hiệu năng chính | Mô hình có thể đạt chất lượng yêu cầu nhanh và đáng tin cậy đến mức nào? | Người dùng có thể nhận được chất lượng yêu cầu trong giới hạn độ trễ và mục tiêu tính sẵn sàng đề ra không? |
| Rủi ro chi phí chính | Thời gian sử dụng cụm không hiệu quả, các lượt chạy thất bại, chuẩn bị dữ liệu, hiệu quả mở rộng thấp | Công suất nhàn rỗi, ghép lô kém, prompt dài, áp lực lên bộ nhớ đệm, độ trễ đuôi và lưu lượng tăng đột biến |
| Trọng tâm vận hành | Khả năng tái lập, nguồn gốc dữ liệu, lưu checkpoint, giao tiếp phân tán | Kiểm soát tiếp nhận yêu cầu, phục vụ mô hình, tự động mở rộng, khả năng quan sát, thử lại và suy giảm dịch vụ có kiểm soát |
Đó là lý do quyết định giữa suy luận AI và huấn luyện nên bắt đầu từ kết quả kinh doanh và đặc điểm khối lượng công việc, chứ không phải mã SKU phần cứng.
Những gì thực sự thay đổi trong luồng tính toán?
Huấn luyện và suy luận có thể chạy cùng một kiến trúc trên cùng loại bộ tăng tốc, nhưng chúng thực hiện các công việc và duy trì những trạng thái khác nhau.
Huấn luyện cập nhật mô hình
Một bước huấn luyện thông thường diễn ra như sau:
training batch → forward pass → loss → backward pass → gradient sync → optimizer update → checkpoint
Lượt truyền xuôi ước tính đầu ra. Lượt truyền ngược tính toán cách các tham số cần thay đổi. Bộ tối ưu hóa cập nhật các trọng số. Trong một tác vụ phân tán, các worker cũng phải phối hợp gradient hoặc trạng thái khác của mô hình. Ví dụ, tài liệu DistributedDataParallel của PyTorch giải thích rằng các bản sao đồng bộ gradient giữa các tiến trình trong quá trình huấn luyện. Xem tài liệu tham khảo PyTorch DDP.
Đó là lý do yêu cầu bộ nhớ khi huấn luyện không chỉ đơn giản là “mô hình vừa với bộ nhớ”. Tác vụ còn cần không gian cho các giá trị kích hoạt, gradient, trạng thái bộ tối ưu hóa, bộ đệm giao tiếp và checkpoint phục hồi. Thành phần cụ thể phụ thuộc vào mô hình, độ chính xác số, phương pháp song song hóa, kích thước lô và framework.
Suy luận sử dụng mô hình
Suy luận thường diễn ra như sau:
request → tokenize / preprocess → prefill → decode or predict → response
Các trọng số được giữ cố định trong suốt quá trình xử lý yêu cầu. Với LLM tạo sinh, máy chủ xử lý prompt trong giai đoạn prefill rồi tạo đầu ra từng phần. Điều đó khiến độ dài yêu cầu, số lượng chuỗi đồng thời, bộ nhớ dành cho bộ nhớ đệm KV và hành vi xếp hàng trở thành những yếu tố trọng tâm khi so sánh suy luận AI và huấn luyện.
Một lưu ý quan trọng: một yêu cầu suy luận thường ít tốn kém hơn một bước huấn luyện đầy đủ, nhưng một endpoint sản xuất có thể xử lý hàng triệu yêu cầu. Vì vậy, tổng chi phí vận hành trong suốt vòng đời của một hệ thống suy luận hoạt động liên tục có thể lớn hơn chi phí của một lượt huấn luyện ngắn, được lên lịch.
Đánh đổi về hiệu năng: tối ưu theo các thước đo khác nhau
Đừng dùng một con số “token mỗi giây” duy nhất để so sánh các khối lượng công việc này. Chỉ số đó trả lời những câu hỏi khác nhau trong từng trường hợp.
Hiệu năng huấn luyện: thời gian để có một mô hình đáng tin cậy
Đối với huấn luyện, hãy theo dõi các thước đo quyết định liệu nhóm có đạt được mục tiêu chất lượng đúng tiến độ hay không:
| Thước đo | Tại sao quan trọng | Vấn đề thường gặp |
|---|---|---|
| Thời gian mỗi bước và số mẫu hoặc token được xử lý mỗi giây | Cho biết tốc độ tiến triển của thử nghiệm | Thông lượng thô cao hơn che khuất kết quả dữ liệu hoặc chất lượng kém hơn |
| Thời gian đạt chất lượng mục tiêu | Liên kết tài nguyên tính toán với mục tiêu thực tế | Tối ưu tốc độ trong khi chỉ số đánh giá không cải thiện |
| Hiệu quả mở rộng | Cho biết việc bổ sung GPU có giảm đủ thời gian chạy để biện minh cho chi phí hay không | Giao tiếp, tải dữ liệu hoặc các worker chậm làm mất đi lợi ích kỳ vọng |
| Thời gian lưu checkpoint và phục hồi | Giới hạn chi phí do gián đoạn | Một lượt chạy dài bị lỗi phải khởi động lại từ checkpoint cũ |
| Khả năng tái lập và biến thiên trong đánh giá | Giúp so sánh kết quả giữa các lượt chạy | Một “cải thiện” không thể tái lập hoặc quy cho một thay đổi cụ thể |
Huấn luyện phân tán đặt ra bài toán mạng và điều phối bên cạnh bài toán tính toán. Đồng bộ gradient là một phần của luồng huấn luyện, vì vậy cấu trúc liên kết, việc chồng lấp giao tiếp với tính toán, phân mảnh dữ liệu và phục hồi lỗi có thể quan trọng không kém thông lượng công bố của bộ tăng tốc.
Hiệu năng suy luận: phản hồi hữu ích khi chịu tải
Suy luận phải đáp ứng người dùng hoặc hệ thống phía sau trong khi nhiều yêu cầu cùng tranh chấp một nguồn công suất. Đối với LLM truyền đầu ra theo luồng, một bảng điều khiển thực tế bao gồm:
| Thước đo | Chỉ số cho biết điều gì |
|---|---|
| Thời gian đến token đầu tiên (TTFT) | Người dùng phải chờ bao lâu trước khi thấy phản hồi bắt đầu xuất hiện |
| Độ trễ giữa các token (ITL) hoặc thời gian cho mỗi token đầu ra (TPOT) | Đầu ra được sinh ra liên tục và mượt mà đến mức nào sau token đầu tiên |
| Độ trễ đầu cuối | Toàn bộ yêu cầu mất bao lâu để hoàn tất |
| Thông lượng tại một SLO | Tổng khối lượng công việc hữu ích được xử lý trong khi TTFT và độ trễ mỗi token vẫn ở mức chấp nhận được |
| Độ dài hàng đợi và tỷ lệ từ chối | Công suất có bị bão hòa trước khi mô hình bắt đầu xử lý hay không |
| Tỷ lệ lỗi và tỷ lệ đầu ra đạt yêu cầu chất lượng | Liệu các phản hồi nhanh có đồng thời là phản hồi hữu ích hay không |
Tài liệu benchmark hiện tại của vLLM định nghĩa TTFT là khoảng thời gian từ lúc gửi yêu cầu đến khi nhận được phần đầu ra truyền theo luồng đầu tiên, đồng thời phân biệt ITL với TPOT. Các ví dụ trong tài liệu cũng cảnh báo rằng việc tái sử dụng bộ nhớ đệm có thể khiến thông lượng trông tốt hơn so với khối lượng công việc không dùng bộ nhớ đệm. Xem tài liệu CLI benchmark của vLLM.
Cảnh báo đó có giá trị rộng hơn: hãy benchmark theo cơ cấu yêu cầu mà bạn thực sự dự kiến. Độ dài prompt, giới hạn đầu ra, khả năng lưu vào bộ nhớ đệm, mức đồng thời, hành vi truyền theo luồng và cách xử lý lỗi có thể làm thay đổi kết quả suy luận nhiều hơn so với chỉ riêng kích thước lô tổng hợp.
MLCommons cũng đưa ra quan điểm tương tự từ góc độ thiết kế benchmark: các hệ thống suy luận được đánh giá dựa trên cả mục tiêu chất lượng lẫn các ràng buộc về độ trễ hoặc thông lượng theo từng kịch bản. Xem các định nghĩa benchmark MLPerf Inference.
Đánh đổi về chi phí: huấn luyện là một dự án; suy luận là một dịch vụ
Cách rõ ràng nhất để so sánh chi phí suy luận AI và huấn luyện là phân bổ từng khối lượng công việc theo đơn vị tạo ra giá trị.
Mô hình chi phí huấn luyện
Đối với một dự án huấn luyện hoặc tinh chỉnh, hãy sử dụng mô hình theo lượt chạy:
cost per validated model version =
(accelerator time + storage + network + data preparation + experiment operations)
÷ validated model versions
Mô hình này làm rõ những chi phí mà phép so sánh theo giờ GPU bỏ sót:
- Công việc dữ liệu: thu thập, rà soát quyền sử dụng, làm sạch, gán nhãn, loại bỏ trùng lặp và quản lý phiên bản.
- Lãng phí trong thử nghiệm: các lượt chạy thất bại, hội tụ kém hoặc không thể tái lập.
- Thời gian nhàn rỗi và phục hồi: công suất đã đặt trước nhưng phải chờ dữ liệu, worker gặp lỗi hoặc quá trình khôi phục checkpoint.
- Hiệu quả mở rộng thấp: thêm bộ tăng tốc có thể rút ngắn thời gian chạy, nhưng không theo tỷ lệ tuyến tính khi giao tiếp hoặc pipeline đầu vào trở thành nút thắt.
- Công việc đánh giá và an toàn: một mô hình chưa sẵn sàng chỉ vì bước huấn luyện cuối cùng đã hoàn tất.
Nếu một nhóm chỉ cần định dạng đầu ra tốt hơn, một lệnh gọi công cụ đáng tin cậy hoặc ngữ cảnh chuyên ngành được cung cấp tại thời điểm yêu cầu, huấn luyện từ đầu thường không phải là mô hình chi phí nên chọn trước tiên. Thay vào đó, hãy bắt đầu bằng prompt, truy xuất, thiết kế quy trình làm việc hoặc một thử nghiệm tinh chỉnh có phạm vi giới hạn.
Mô hình chi phí suy luận
Đối với phục vụ trực tuyến, hãy sử dụng mô hình dựa trên kết quả thành công:
cost per accepted response =
(serving capacity + storage + network + observability + support operations)
÷ accepted responses
Đối với tác vụ theo lô, hãy thay số phản hồi bằng số bản ghi, hình ảnh hoặc tài liệu được chấp nhận. Mục tiêu vẫn như nhau: chia cho đầu ra hữu ích, không phải số yêu cầu thô hay số giờ bộ tăng tốc được quảng cáo.
Các yếu tố chính chi phối chi phí suy luận thường là:
- Đặc điểm lưu lượng: nhu cầu tăng đột biến hay ổn định quyết định lượng công suất nhàn rỗi.
- Độ dài đầu vào và đầu ra: prompt và nội dung được sinh ra càng dài thì mỗi yêu cầu càng tiêu thụ nhiều tài nguyên tính toán và bộ nhớ.
- Mức đồng thời và ghép lô: lô lớn hơn có thể cải thiện mức sử dụng tài nguyên, nhưng cũng có thể khiến từng người dùng phải chờ lâu hơn.
- Hoạt động của bộ nhớ đệm KV: đối với LLM, dung lượng và khả năng tái sử dụng bộ nhớ đệm ảnh hưởng đến cả độ trễ lẫn phần bộ nhớ dự phòng thực tế.
- Thiết kế tính sẵn sàng: các bản sao, bố trí theo khu vực, thử lại và chuyển đổi dự phòng bảo vệ trải nghiệm người dùng nhưng làm tăng chi phí vận hành.
- Lựa chọn mô hình và độ chính xác số: thay đổi mô hình hoặc định dạng runtime có thể đồng thời làm thay đổi chất lượng, nhu cầu bộ nhớ và tốc độ.
Đối với các nhóm đang quyết định liệu có nên tự sở hữu công suất phục vụ hay không, hãy so sánh khối lượng công việc tự lưu trữ với API mô hình được quản lý bằng cùng một định nghĩa về đầu ra được chấp nhận. Điều này tránh coi giá mỗi giờ GPU thấp là một lợi thế khi chi phí kỹ thuật, công suất nhàn rỗi và công việc đảm bảo độ tin cậy còn lớn hơn. Để xem nhánh tiếp theo trong quyết định đó, hãy đọc GPU cloud và API mô hình.
Đánh đổi khi triển khai: cụm và endpoint
Không nên mặc định dùng chung một mô hình vận hành cho huấn luyện và suy luận.
Triển khai huấn luyện cần một nền tảng thử nghiệm có thể tái lập
Một môi trường huấn luyện đạt chuẩn sản xuất thường cần:
- Dữ liệu và tập đánh giá được quản lý phiên bản để có thể truy vết kết quả về các đầu vào.
- Môi trường có thể tái lập với phiên bản mã, các phần phụ thuộc và cấu hình mô hình được cố định, cùng chính sách seed rõ ràng.
- Cấu trúc liên kết bộ tăng tốc và mạng phù hợp với chiến lược song song hóa đã chọn.
- Bộ lưu trữ checkpoint và chính sách khởi động lại được tính toán phù hợp để xử lý gián đoạn, thu hồi tài nguyên và điều tra sự cố.
- Theo dõi thử nghiệm để liên kết siêu tham số, chỉ số, tạo phẩm và quyết định phê duyệt.
- Bước kiểm duyệt đưa vào triển khai để xác thực chất lượng, an toàn, chi phí và khả năng quay lui trước khi triển khai.
Kubernetes có thể lập lịch tài nguyên GPU bằng các plugin thiết bị và nhãn của nhà cung cấp, nhưng không loại bỏ nhu cầu lập kế hoạch cho trình điều khiển, năng lực của node, lưu trữ, giao tiếp phân tán và điều phối khối lượng công việc. Kubernetes mô tả mô hình lập lịch GPU tại đây.
Triển khai suy luận cần một dịch vụ vận hành
Triển khai suy luận có danh sách kiểm tra khác:
- Máy chủ mô hình được quản lý phiên bản với tokenizer, runtime và giao ước yêu cầu đã được kiểm thử.
- Kiểm soát tiếp nhận và giới hạn công suất để tình trạng quá tải dẫn đến xếp hàng hoặc từ chối bớt yêu cầu có kiểm soát, thay vì sụp đổ hệ thống.
- Chính sách mở rộng dựa trên đặc điểm yêu cầu có tính đến mức đồng thời, độ dài prompt và thời gian chờ trong hàng đợi—không chỉ dựa vào mức sử dụng CPU.
- Kiểm soát bộ nhớ đệm và ghép lô được kiểm thử theo cả thông lượng lẫn độ trễ đuôi.
- Khả năng quan sát đối với TTFT, TPOT hoặc ITL, độ trễ đầu cuối, độ dài hàng đợi, lỗi, mức bão hòa và tỷ lệ đầu ra được chấp nhận.
- Cơ chế quay lui, định tuyến và phương án dự phòng khi chất lượng mô hình suy giảm hoặc nhà cung cấp gặp sự cố.
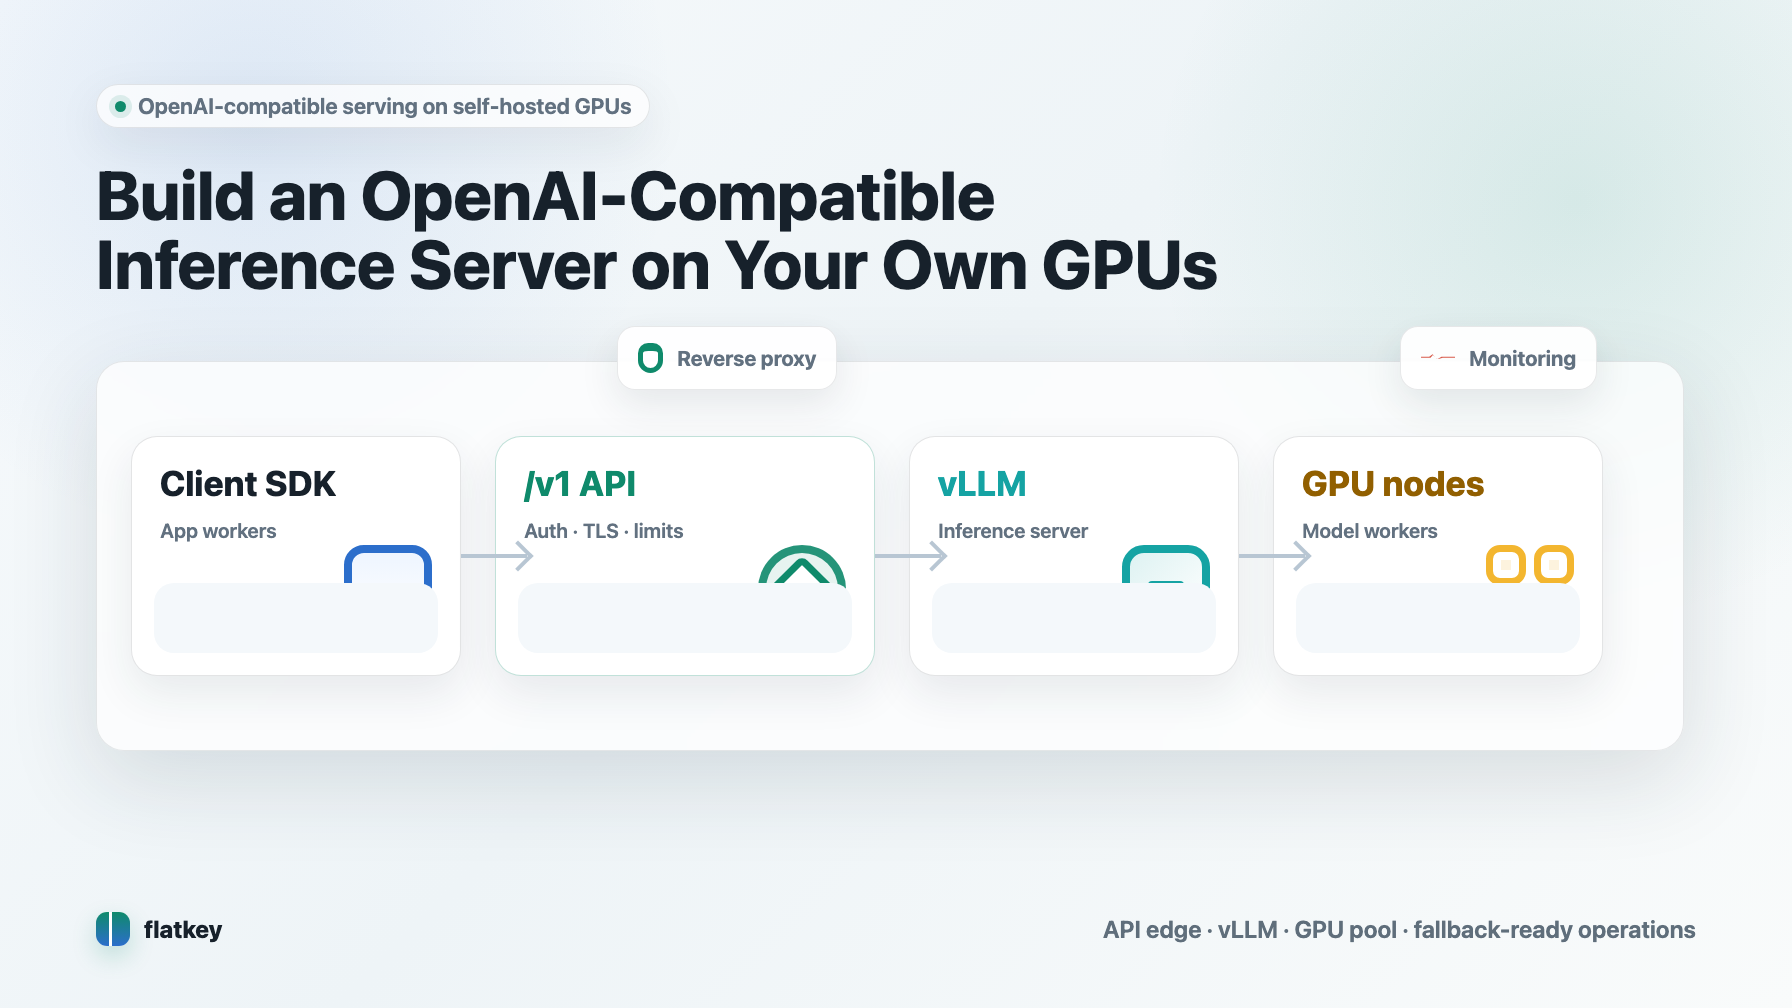
Nếu đã chọn tự lưu trữ hệ thống phục vụ, GPU tốt nhất cho suy luận LLM phụ thuộc vào khả năng đáp ứng bộ nhớ, đặc điểm yêu cầu, mục tiêu độ trễ và chi phí trên mỗi đầu ra được chấp nhận—không có lựa chọn tối ưu chung cho mọi trường hợp. Nếu trước tiên cần chọn mô hình vận hành, hãy so sánh công suất GPU serverless và GPU chuyên dụng.
Tinh chỉnh là phương án trung gian
Câu hỏi về suy luận AI và huấn luyện thường che khuất một lựa chọn thứ ba: tinh chỉnh.
Tinh chỉnh vẫn là huấn luyện vì quá trình này cập nhật các tham số. Nhưng nó bắt đầu từ một mô hình đã được huấn luyện trước và sử dụng tập dữ liệu chuyên biệt cho tác vụ nhỏ hơn nhiều so với huấn luyện từ đầu. Điều này có thể phù hợp khi prompt và truy xuất không đáp ứng được một yêu cầu có thể đo lường—chẳng hạn như hành vi tạo đầu ra có cấu trúc nghiêm ngặt, một phép chuyển đổi chuyên biệt được lặp lại hoặc một tác vụ chuyên ngành với các ví dụ có nhãn ổn định.
Hãy xem tinh chỉnh là một giả thuyết, không phải lựa chọn mặc định. Xác định mô hình cơ sở, tập đánh giá giữ riêng, ngưỡng chấp nhận, phương án quay lui và tác động dự kiến đến suy luận trước khi phân bổ công suất. Một lượt tinh chỉnh cải thiện điểm số ngoại tuyến nhưng tạo ra gánh nặng không thể chấp nhận về độ trễ, chi phí hoặc bảo trì thì không phải là cải tiến cho môi trường sản xuất.
Cây quyết định thực tế
Hãy sử dụng trình tự này để biến một cuộc thảo luận trừu tượng về hạ tầng thành quyết định:
- Một mô hình đã được huấn luyện trước có thể đáp ứng yêu cầu thông qua prompt, sử dụng công cụ, truy xuất hoặc thay đổi quy trình làm việc không? Nếu có, hãy bắt đầu với suy luận.
- Bạn có một vấn đề tồn tại dai dẳng, đo lường được trên các đầu vào đại diện và một tập dữ liệu chuyên biệt cho tác vụ có chất lượng cao không? Nếu có, hãy đánh giá một thử nghiệm tinh chỉnh có phạm vi giới hạn.
- Bạn có cần một năng lực nền tảng mới, có một tài sản dữ liệu có thể bảo vệ và có thể chi trả cho dữ liệu, huấn luyện, đánh giá và phục vụ liên tục không? Chỉ khi đó mới nên đánh giá phương án huấn luyện từ đầu.
- Đối với suy luận, bạn có cần quyền kiểm soát ở cấp phần cứng, runtime tùy chỉnh, khả năng lựa chọn nơi đặt dữ liệu hoặc mức sử dụng có thể dự đoán để biện minh cho việc vận hành công suất riêng không? Nếu có, hãy đánh giá phương án tự lưu trữ. Nếu không, hãy dùng API mô hình được quản lý làm phương án cơ sở.
- Điều gì xảy ra khi nhu cầu tăng gấp đôi hoặc chất lượng của một phiên bản mô hình suy giảm? Hãy xác định cách mở rộng, sử dụng phương án dự phòng và quay lui trước khi việc ra mắt biến tình huống đó thành sự cố.
Cây quyết định này được thiết kế theo hướng thận trọng. Thông thường, chứng minh nhu cầu sản phẩm bằng suy luận trước sẽ ít tốn kém hơn so với đầu tư vào bộ máy cần thiết để huấn luyện và vận hành một mô hình tùy chỉnh.
Bản tóm tắt khối lượng công việc có thể sao chép: quyết định trước khi đặt trước GPU
Hãy dùng bản tóm tắt một trang này cho mọi khối lượng công việc mới. Nó giúp các nhóm sản phẩm, ML và hạ tầng có chung một định nghĩa về trạng thái “sẵn sàng”.
| Trường thông tin | Tóm tắt huấn luyện hoặc tinh chỉnh | Tóm tắt suy luận |
|---|---|---|
| Kết quả cho người dùng | Cần cải thiện năng lực hoặc khoảng thiếu hụt chất lượng nào? | Người dùng cần nhận được phản hồi hoặc kết quả tự động hóa nào? |
| Chỉ số thành công | Chỉ số chất lượng trên tập giữ riêng, kiểm tra an toàn, chi phí trên mỗi phiên bản được xác thực | TTFT, độ trễ mỗi token hoặc đầu cuối, thông lượng tại SLO, tỷ lệ đầu ra được chấp nhận |
| Giao ước dữ liệu | Nguồn tập dữ liệu, quyền sử dụng, phiên bản, nhãn hoặc phần thưởng, phần dữ liệu dành cho đánh giá | Lược đồ yêu cầu, phân bố prompt và đầu ra, ranh giới quyền riêng tư, khả năng lưu vào bộ nhớ đệm |
| Giả định về công suất | Số lượng GPU, khả năng đáp ứng bộ nhớ, phương pháp song song hóa, tần suất lưu checkpoint, mục tiêu phục hồi | Kích thước mô hình, mức đồng thời, giới hạn prompt/đầu ra, ghép lô, ngân sách bộ nhớ đệm, chính sách bản sao |
| Giới hạn chi phí | Chi phí tối đa trên mỗi phiên bản mô hình được xác thực | Chi phí tối đa trên mỗi phản hồi hoặc bản ghi theo lô được chấp nhận |
| Kế hoạch xử lý sự cố | Dữ liệu lỗi, lượt chạy thất bại, mất worker, chất lượng suy giảm | Hàng đợi tăng đột biến, bão hòa, bản phát hành mô hình lỗi, sự cố hệ thống thượng nguồn, đầu ra không an toàn |
| Tiêu chí kết thúc | Đưa vào triển khai, điều chỉnh hoặc dừng dựa trên bước kiểm duyệt đánh giá | Mở rộng, định tuyến, quay lui hoặc thay đổi mô hình dựa trên SLO của dịch vụ |
Giá trị của bản tóm tắt này không nằm ở chính biểu mẫu. Nó buộc nhóm phải xác định liệu mình đang đầu tư vào năng lực mô hình, độ tin cậy của dịch vụ hay cả hai. Đó là sự đánh đổi thực sự giữa suy luận AI và huấn luyện.
Vai trò của API mô hình hợp nhất
Nếu câu trả lời của bạn là “suy luận, nhưng không muốn sở hữu phần cứng”, hãy bắt đầu bằng cách xem API mô hình là phương án cơ sở để so sánh. Flatkey cung cấp một khóa API và một số dư để truy cập hơn 300 mô hình chính thức và hơn 1.000 công cụ trả phí theo lượt gọi, nhờ đó nhóm có thể tách việc lựa chọn mô hình và hạch toán mức sử dụng khỏi quyết định phục vụ bằng GPU. Khám phá các mô hình của Flatkey.
Điều đó không thay thế việc triển khai tự lưu trữ khi bạn cần quyền kiểm soát đi kèm với việc vận hành runtime. Nó cung cấp một phương án thực tế để đối chiếu trước khi bạn cam kết đầu tư vào công suất, bộ công nghệ phục vụ và trách nhiệm trực vận hành.
Kết luận: chọn đúng bài toán vận hành mà bạn thực sự gặp phải
Việc lựa chọn giữa suy luận AI và huấn luyện trở nên rõ ràng khi bạn xác định đúng bài toán vận hành:
- Chọn huấn luyện khi bạn cần tạo mới hoặc điều chỉnh đáng kể năng lực mô hình và có thể đáp ứng các yêu cầu về dữ liệu, đánh giá, thử nghiệm và tính toán phân tán.
- Chọn suy luận khi một mô hình đã được huấn luyện có thể thực hiện công việc và thách thức là cung cấp kết quả hữu ích với độ trễ, độ tin cậy và hiệu quả kinh tế trên mỗi đơn vị ở mức chấp nhận được.
- Chỉ chọn tinh chỉnh khi có khoảng thiếu hụt đã được đo lường và tập dữ liệu đại diện đủ để biện minh cho việc cập nhật một mô hình đã được huấn luyện trước.
Trước khi chọn GPU, hãy lập bản tóm tắt khối lượng công việc, benchmark theo đặc điểm yêu cầu hoặc dữ liệu thực tế, đồng thời xác định ngưỡng chất lượng và chi phí để việc vận hành trở nên xứng đáng.
Câu hỏi thường gặp
Sự khác biệt chính giữa suy luận AI và huấn luyện là gì?
Huấn luyện sử dụng dữ liệu và quá trình tối ưu hóa để cập nhật các tham số mô hình. Suy luận sử dụng các tham số cố định để chuyển đầu vào mới thành dự đoán hoặc nội dung được sinh ra. Trong môi trường sản xuất, phục vụ mô hình là phần công việc bổ sung để cung cấp và vận hành suy luận như một hệ thống đáng tin cậy.
Suy luận có luôn rẻ hơn huấn luyện không?
Không. Một yêu cầu suy luận đơn lẻ thường nhẹ hơn một bước huấn luyện, nhưng một endpoint có lưu lượng lớn hoặc luôn hoạt động có thể tốn kém hơn trong suốt vòng đời so với một dự án huấn luyện có phạm vi giới hạn. Hãy so sánh chi phí trên mỗi phiên bản mô hình được xác thực đối với huấn luyện và trên mỗi đầu ra được chấp nhận đối với suy luận.
Tinh chỉnh là huấn luyện hay suy luận?
Tinh chỉnh là huấn luyện vì nó cập nhật các tham số. Đây thường là phương án có phạm vi hẹp hơn và chi phí thấp hơn so với huấn luyện mô hình từ đầu. Mô hình thu được vẫn cần được triển khai suy luận để phục vụ các yêu cầu.
Những chỉ số nào quan trọng nhất khi so sánh suy luận AI và huấn luyện?
Đối với huấn luyện, hãy tập trung vào chất lượng, thời gian đạt chất lượng mục tiêu, thông lượng, hiệu quả mở rộng và khả năng phục hồi. Đối với suy luận LLM trực tuyến, hãy theo dõi TTFT, TPOT hoặc ITL, độ trễ đầu cuối, thông lượng tại SLO đã chọn, tình trạng xếp hàng, lỗi và tỷ lệ đầu ra được chấp nhận.
Cùng một cụm GPU có thể chạy cả huấn luyện và suy luận không?
Có thể, nhưng công suất dùng chung thường tạo ra những ưu tiên xung đột: huấn luyện ưu tiên các tác vụ dài và hiệu quả, trong khi suy luận phục vụ người dùng đòi hỏi độ trễ có thể dự đoán và công suất dự phòng cho các đợt tăng tải. Hãy cách ly các khối lượng công việc hoặc xác định rõ quy tắc lập lịch và thu hồi tài nguyên trước khi dùng chung một cụm.