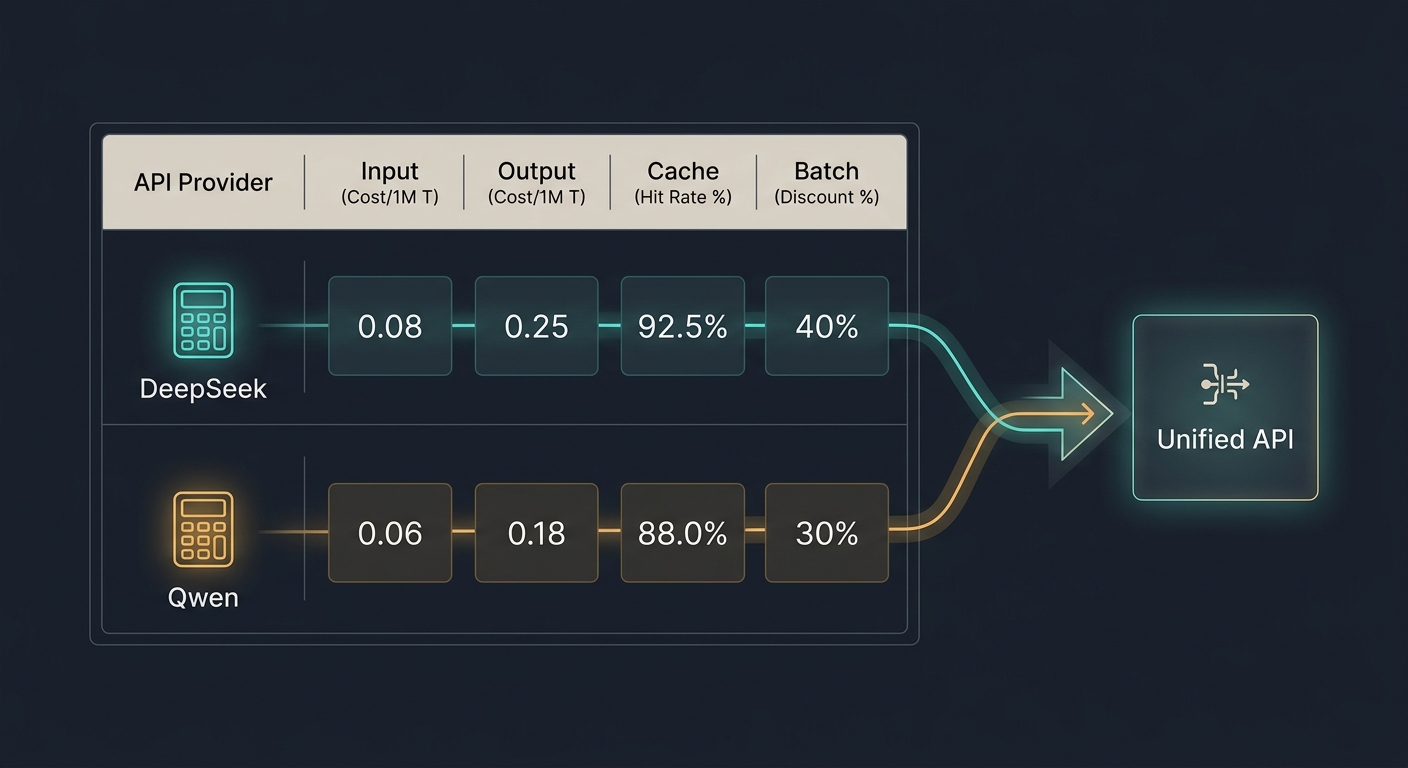
Se você está escolhendo entre a DeepSeek API e a Qwen API para um produto sensível a orçamento, não comece por um preço de token destacado. Comece pela forma da sua carga de trabalho.
Um guia útil DeepSeek API vs Qwen API para fluxos de trabalho sensíveis a custos: Guia de custos 2026 precisa comparar pelo menos seis coisas: tokens de entrada, tokens de saída, acertos de cache, falhas de cache, elegibilidade para batch e o custo operacional de mudar as rotas depois.
Este guia foi verificado com base na documentação oficial dos provedores em 23 de setembro de 2026. Ele foi escrito para indie hackers e pequenas equipes de produtos de IA que precisam do menor custo confiável por tarefa aceita, não de um benchmark para exibição.
A versão curta:
- Escolha Qwen primeiro para chat simples de alto volume, jobs assíncronos em lote e fluxos de trabalho que podem usar a inferência em lote do Qwen ou regras implícitas/explicitadas de cache.
- Escolha DeepSeek primeiro quando você quiser um endpoint global mais simples no formato OpenAI, linhas explícitas de tokens de pico/fora de pico, contabilização automática de acertos e falhas de cache, ou quando a qualidade do DeepSeek Flash já for boa o suficiente para o seu produto.
- Use um roteador e um livro-razão de uso quando a economia esperada de tokens for pequena o suficiente para que a configuração do provedor, o comportamento de tentativas, saldos fragmentados ou o trabalho de migração possam anular o desconto.
DeepSeek API vs Qwen API para fluxos de trabalho sensíveis a custos: a tabela de decisão
| Padrão de fluxo de trabalho | Sinal de custo atual | Primeira família de modelo para testar | O que pode mudar a resposta |
|---|---|---|---|
| Chat curto sem cache | As linhas da família Qwen Flash podem ser menores na matemática de preço de tabela | Qwen | Comprimento da saída, região, snapshot exato do Qwen, taxa de passagem de qualidade |
| Avaliação ou rotulagem assíncrona | A inferência em lote do Qwen cobra 50% da inferência em tempo real para requisições bem-sucedidas | Qwen | Elegibilidade para batch, tolerância ao tempo de resposta, descontos de cache não suportados em batch |
| Contexto longo repetido | Ambos os provedores têm mecânicas de cache; o DeepSeek expõe diretamente linhas de acerto/falha, e o Qwen tem modos de cache explícito e implícito | Teste ambos | Taxa real de acerto de cache, sobrecarga de criação de cache, campos de cache específicos do provedor |
| Saída com muito raciocínio | O vencedor depende de se Qwen Plus, Qwen Max, DeepSeek Flash ou DeepSeek Pro atende ao nível de qualidade | Sem vencedor padrão | Tokens de pensamento, tentativas, comprimento da resposta, taxa de aceitação |
| Configuração direta e simples | O DeepSeek publica uma única URL base no formato OpenAI; a configuração do Qwen é específica por região/workspace | DeepSeek | Necessidades de região de dados, compras, presença existente na Alibaba Cloud |
| Troca frequente de modelo | A economia de tokens pode ser perdida com a integração e a sobrecarga de cobrança | Camada de roteamento compartilhada | Disponibilidade do modelo, plano de rollback, logs unificados |
Essa tabela não é um ranking de qualidade. Ela é uma ferramenta de triagem de custos. A comparação certa é custo por tarefa aceita, não custo por um milhão de tokens de entrada.
O que mudou desde o monitoramento de preços de julho de 2026
O monitoramento de preços anterior da Flatkey para esta URL usava DeepSeek V4 Flash e V4 Pro como base e tratava o Qwen Flash como a linha Qwen de baixo custo durável. As páginas atuais dos provedores tornam a comparação mais nuançada.
DeepSeek agora informa aos usuários da API para usar deepseek-flash como nome do modelo. A documentação diz que nomes legados como deepseek-v4-flash ainda são aceitos, mas as requisições são atendidas por DeepSeek-V4.1-Flash e cobradas pelo preço do Flash. A DeepSeek também publica preços de pico e fora de pico, então um fluxo de trabalho que roda nos fins de semana ou fora das janelas de pico UTC pode ter um perfil de custo diferente de um fluxo de trabalho que roda durante o horário de pico.
O Alibaba Cloud Model Studio agora expõe várias linhas da família Qwen Flash em diferentes versões de modelo e regiões de implantação, incluindo qwen3.8-flash, qwen3.7-flash e qwen-flash. A mesma página também separa preços regionais e escopo de implantação, então um único preço do Qwen não é suficiente para aprovação. O ID exato do modelo e a região importam.
Para um guia de custos de 2026, isso significa que a primeira instrução é simples: normalize por ID exato do modelo, região, regra de cache e modo de execução antes de comparar provedores.
Snapshot atual de preços do fornecedor original
Todos os preços abaixo são preços públicos de tabela por um milhão de tokens, conforme vistos na documentação do fornecedor original em 23 de setembro de 2026. Não os trate como contrato. Verifique a página do provedor e sua conta antes de mover tráfego.
Linhas de preços da API DeepSeek
A página de preços da DeepSeek lista deepseek-flash e deepseek-v4-pro, ambos com comprimento de contexto de 1M e saída máxima de 384K.
| Modelo | Entrada com cache-hit, fora de pico | Entrada com cache-miss, fora de pico | Saída, fora de pico | Entrada com cache-hit, pico | Entrada com cache-miss, pico | Saída, pico |
|---|---|---|---|---|---|---|
deepseek-flash | $0.003 | $0.15 | $0.60 | $0.006 | $0.30 | $1.20 |
deepseek-v4-pro | $0.022 | $0.66 | $1.98 | $0.044 | $1.32 | $3.96 |
A DeepSeek também publica:
- URL base no formato OpenAI:
https://api.deepseek.com - URL base no formato Anthropic:
https://api.deepseek.com/anthropic - cache de contexto automático
prompt_cache_hit_tokenseprompt_cache_miss_tokensno uso- horário de pico das 01:00-04:00 e 06:00-10:00 UTC, de segunda a sexta-feira, excluindo feriados públicos chineses
A vantagem prática é a clareza. Você pode calcular separadamente a entrada com cache-hit, a entrada com cache-miss e a saída sem precisar adivinhar quais tokens de entrada receberam desconto.
Linhas de preços da API Qwen
A página de preços do Alibaba Cloud Model Studio lista muitas linhas do Qwen. As linhas mais relevantes da família Flash para fluxos de trabalho de texto sensíveis a custos incluem:
| Linha do modelo | Sinal de preço de tabela de exemplo | Por que isso importa |
|---|---|---|
qwen3.8-flash | As linhas incluem $0.15 de entrada e $0.47 de saída em uma linha internacional visível; outras regiões mostram números diferentes | Família Flash mais recente; verifique a região e a rota exata |
qwen3.7-flash | As linhas incluem $0.030 de entrada e $0.130 de saída em uma linha internacional visível; outras regiões mostram números diferentes | Muitas vezes é um candidato com preço de tabela muito baixo se a qualidade for suficiente |
qwen-flash | As linhas incluem $0.05 de entrada e $0.40 de saída em uma linha internacional visível; outras regiões podem diferir | Linha de base durável para tarefas simples de baixo custo |
qwen-plus | As linhas incluem $0.40 de entrada e $1.20 de saída em uma linha visível | Útil quando a qualidade do Flash não é suficiente |
qwen3.7-plus | As linhas incluem $0.40 de entrada e $1.60 de saída em uma linha visível | Útil para tarefas de raciocínio ou geração mais difíceis |
qwen3.8-max / qwen3.7-max | As linhas incluem preços de entrada e saída materialmente mais altos | Teste apenas quando Plus/Flash não passarem nos critérios de qualidade |
A Qwen também publica:
- interfaces de chat compatíveis com OpenAI
- URLs base específicas por região/workspace
- chaves de API que devem corresponder à região do endpoint
- inferência em lote para modelos suportados a 50% do preço da inferência em tempo real para solicitações bem-sucedidas
- modos de cache de contexto explícitos e implícitos, com campos de tokens de cache hit no uso
A vantagem prática é a área de desconto. Se sua carga de trabalho puder ser executada de forma assíncrona ou conseguir atingir de forma confiável o cache da Qwen, o preço efetivo da Qwen pode ser muito menor do que a linha simples de tempo real.
Três cálculos de carga de trabalho
Estes exemplos comparam apenas a estrutura de cobrança. Eles não afirmam qualidade, latência, confiabilidade ou comportamento de segurança equivalentes.
Cenário 1: chat curto sem cache
Suponha:
- 10.000 solicitações
- 1.000 tokens de entrada por solicitação
- 500 tokens de saída por solicitação
- sem acertos de cache
- sem modo em lote
| Rota | Cálculo | Custo estimado de tokens ao preço de tabela |
|---|---|---|
Linha de exemplo de qwen-flash | 10M de entrada a $0.05 + 5M de saída a $0.40 | $2.50 |
Linha de exemplo de qwen3.8-flash | 10M de entrada a $0.15 + 5M de saída a $0.47 | $3.85 |
deepseek-flash, fora de pico | 10M de entrada sem cache a $0.15 + 5M de saída a $0.60 | $4.50 |
deepseek-flash, pico | 10M de entrada sem cache a $0.30 + 5M de saída a $1.20 | $9.00 |
Para chat curto sem cache, a Qwen é a primeira candidata em custo. A DeepSeek ainda pode vencer se sua taxa de aprovação de qualidade for maior, se precisar de menos tentativas ou se a simplicidade operacional importar mais do que a diferença bruta de tokens.
Cenário 2: contexto longo repetido
Suponha:
- 10.000 solicitações
- 10.000 tokens de entrada por solicitação
- 1.000 tokens de saída por solicitação
- 90% dos tokens de entrada atingem o cache após o aquecimento
- sem modo em lote
| Rota | Suposição de cache | Custo estimado de tokens ao preço de tabela |
|---|---|---|
deepseek-flash, fora de pico | 90M de entrada com hit a $0.003, 10M de entrada com miss a $0.15, 10M de saída a $0.60 | $7.77 |
deepseek-flash, pico | 90M de entrada com hit a $0.006, 10M de entrada com miss a $0.30, 10M de saída a $1.20 | $15.54 |
linha de exemplo qwen-flash com entrada de cache implícito de 20% | 90M de entrada em cache a $0.01, 10M de entrada normal a $0.05, 10M de saída a $0.40 | $5.40 |
É aqui que a antiga regra prática pode falhar. A DeepSeek expõe linhas muito claras de cache-hit e cache-miss, mas a documentação atual de cache da Qwen diz que muitos modelos de cache implícito cobram a entrada em cache como uma porcentagem da entrada normal, ao mesmo tempo em que observa exceções específicas por modelo. Se sua carga de trabalho depende de economia de cache, não aprove nenhum dos provedores apenas com base em uma planilha. Registre os tokens reais de cache-hit da resposta da API.
Cenário 3: avaliação em lote
Assuma o mesmo formato de chat curto do Cenário 1, mas o trabalho pode aguardar o processamento assíncrono em lote e usa um modelo de lote Qwen compatível.
| Rota | Cálculo | Custo estimado de tokens ao preço de tabela |
|---|---|---|
linha de exemplo em tempo real qwen-flash | Igual ao Cenário 1 | $2.50 |
qwen-flash elegível para lote | 50% do custo de tokens da solicitação em tempo real bem-sucedida | $1.25 |
deepseek-flash, tempo real fora de pico | Igual ao Cenário 1 | $4.50 |
Para conjuntos de avaliação, rotulagem de dados noturna, enriquecimento offline e testes de regressão, a inferência em lote da Qwen costuma ser o primeiro caminho de custo a verificar. A compensação está na latência e na mecânica: trabalhos em lote precisam de entrada JSONL, um único modelo por arquivo, polling, tratamento de arquivo de resultados e verificações de aceitação.
A calculadora que os indie hackers devem usar
Use isto antes de trocar de modelo:
accepted task cost =
  cache_miss_input_tokens * cache_miss_input_rate
  + cache_hit_input_tokens * cache_hit_input_rate
  + output_tokens * output_rate
  - verified_batch_discount
  + retry_tokens
  + fallback_tokens
  + migration_operating_cost
----------------------------------------------------
  accepted_tasks
Depois, acompanhe estes campos para cada rota candidata:
| Campo | Por que isso importa |
|---|---|
| ID exato do modelo | Aliases dinâmicos e snapshots datados podem se comportar de forma diferente |
| Região e endpoint | As chaves da API Qwen são vinculadas à região; incompatibilidade de endpoint pode causar falhas de autenticação |
| Modo de execução | Tempo real, lote, cache e fallback do roteador usam diferentes premissas de cobrança |
| Tokens de entrada | Prompts longos tornam o cache e o corte do prompt importantes |
| Tokens de saída | A saída frequentemente domina os custos de geração e raciocínio |
| Tokens de cache hit | As premissas de cache não representam economia até que os logs provem isso |
| Número de tentativas | Um modelo mais barato que faz mais tentativas pode custar mais |
| Taxa de tarefas aceitas | Falhas de qualidade são custo oculto |
| Horário de execução | As taxas de pico/fora de pico da DeepSeek podem mudar o custo do mesmo trabalho |
| Trabalho de migração | O trabalho de SDK, endpoint, região, logging e rollback tem custo real |
Diferenças de configuração da API que afetam o custo
A configuração da DeepSeek é operacionalmente simples. Para chamadas compatíveis com OpenAI, a URL base é https://api.deepseek.com, com nomes de modelo atuais como deepseek-flash e deepseek-v4-pro. Para muitas equipes pequenas, essa simplicidade importa porque o tempo de configuração também é custo.
A configuração da Qwen tem mais opções. O Model Studio oferece chamadas compatíveis com OpenAI, mas a URL base varia por região e workspace. A documentação afirma que as chaves de API ficam vinculadas à região em que foram criadas, e uma chave de uma região pode falhar ao ser usada com o endpoint de outra região. Isso não é um impeditivo, mas entra na comparação de custos.
Se você está operando um produto pequeno, o trabalho oculto muitas vezes se parece com isto:
- Adicionar uma URL base da Qwen com awareness de região.
- Criar chaves de API na região correta.
- Testar o ID exato do modelo Qwen nessa região.
- Confirmar se a inferência em lote é suportada para esse modelo.
- Confirmar se o cache explícito ou implícito se aplica.
- Confirmar se os campos de uso relatam tokens em cache.
- Adicionar roteamento de rollback se a rota falhar nas portas de qualidade ou latência.
É por isso que um roteador com uma única chave pode ser útil até mesmo para uma equipe focada em custo. A Flatkey oferece às equipes um único ponto de entrada compatível com OpenAI, um único saldo, uma única fatura, descoberta de modelos e revisão de uso entre provedores. Ainda é necessário verificar a disponibilidade e os preços dos modelos antes da produção, mas a comparação operacional fica mais limpa porque a cobrança e as evidências das requisições ficam em um só lugar.
Quando a DeepSeek é a melhor opção de custo
A DeepSeek é o melhor primeiro teste quando:
- Você quer um único endpoint direto e simples do provedor.
- Sua carga de trabalho pode rodar em janelas fora de pico.
- O prompt tem prefixos repetidos e os tokens de cache hit da DeepSeek aparecem de forma confiável.
- A qualidade do
deepseek-flashé suficiente para a tarefa. - Você precisa de linhas claras de preço para cache hit, cache miss e saída na mesma tabela de preços.
- Sua equipe prefere evitar a gestão de chaves por região/workspace.
O aviso importante é o custo de saída. A DeepSeek Flash pode ser muito atraente quando os cache hits de entrada são altos, mas respostas longas ainda pagam tarifas de saída. Se o modelo produzir respostas prolixas ou precisar de novas tentativas, a economia no preço de tabela pode desaparecer.
Quando a Qwen é a melhor opção de custo
Qwen é o melhor primeiro teste quando:
- Você pode usar uma linha barata da família Flash na região de que precisa.
- Sua carga de trabalho pode ser executada por inferência em lote.
- Seus prompts podem usar cache implícito ou explícito.
- Você já usa a Alibaba Cloud ou precisa de famílias específicas de modelos Qwen.
- Você precisa de um conjunto mais amplo de snapshots do Qwen para trade-offs entre qualidade e custo.
- Você consegue lidar com operações de endpoint e chave de API vinculadas à região.
O aviso é a complexidade. O Qwen tem muitas linhas, regiões, versões de modelo e exceções de cache. Você precisa de uma revisão de rota salva, não apenas de um preço copiado de uma tabela.
Modelo de revisão de rota de 30 minutos
Copie isto antes de alterar o tráfego de produção:
decision_date: 2026-09-23
workflow: ""
current_route:
  provider: ""
  model_id: ""
  region: ""
  endpoint: ""
candidate_routes:
  - provider: deepseek
    model_id: deepseek-flash
    execution_mode: realtime
    pricing_checked_url: https://api-docs.deepseek.com/quick_start/pricing
    cache_fields_to_log:
      - prompt_cache_hit_tokens
      - prompt_cache_miss_tokens
  - provider: qwen
    model_id: ""
    region: ""
    execution_mode: realtime_or_batch
    pricing_checked_url: https://docs.modelstudio.console.alibabacloud.com/en/model-studio/model-pricing
    cache_fields_to_log:
      - cached_tokens
acceptance_gate:
  sample_size: 100
  minimum_quality_pass_rate: ""
  maximum_retry_rate: ""
  maximum_p95_latency: ""
  maximum_cost_per_accepted_task: ""
rollback:
  owner: ""
  fallback_model_id: ""
  spend_limit: ""
  review_date: ""
Recomendação prática
Para a maioria dos fluxos de trabalho indie sensíveis a custos, comece com esta ordem:
- Teste a linha mais barata da família Qwen Flash disponível na região necessária.
- Se a carga de trabalho for assíncrona, teste a inferência em lote do Qwen.
- Se o prompt tiver contexto repetido, meça os campos de cache do Qwen e os campos de cache do DeepSeek lado a lado.
- Teste
deepseek-flashdurante janelas de menor movimento se a configuração simples ou a qualidade do DeepSeek for importante. - Use Plus, Max ou DeepSeek Pro somente depois que a rota mais barata falhar no teste de aceitação.
- Encaminhe por um gateway compartilhado quando troca, fallback ou prova de faturamento se tornarem parte do custo operacional.
Não aprove a rota que é mais barata por token de entrada. Aprove a rota que é mais barata por tarefa aceita depois que evidências de qualidade, retries, cache, lote e rollback forem registradas.
Perguntas frequentes
O DeepSeek é mais barato que o Qwen em 2026?
Não universalmente. Nos exemplos atuais, o Qwen costuma vencer em chat simples sem cache e em trabalhos que podem ser em lote, enquanto o DeepSeek continua atraente para configuração direta simples, contabilidade explícita de cache, tráfego fora de pico e cargas de trabalho em que deepseek-flash passa na qualidade com menos retries.
O Qwen batch inference é sempre mais barato?
Não. A inferência em lote do Qwen pode cobrar requisições bem-sucedidas a 50% da inferência em tempo real para modelos suportados, mas jobs em lote são assíncronos e não são elegíveis para algumas promoções ou descontos de cache. Use-o para jobs offline, não para chamadas de produto sensíveis à latência.
Devo comparar o DeepSeek Pro com o Qwen Flash?
Somente se ambos passarem pelo mesmo gate de qualidade. Para um guia de custos, compare o modelo mais barato que satisfaça a tarefa. Se o Qwen Flash falhar, mas o DeepSeek Flash passar, a linha mais barata listada do Qwen é irrelevante.
O cache garante economia?
Não. A DeepSeek diz que os cache hits dependem da correspondência de unidades de prefixo em cache e não são garantidos. A documentação da Qwen também diz que a probabilidade de hit de cache implícito não é garantida e deve ser verificada por meio dos campos de uso. Trate as economias de cache como economias medidas, não prometidas.
Onde a Flatkey se encaixa?
A Flatkey é útil quando a própria troca de modelo passa a ser um custo. Com uma única rota compatível com OpenAI, um único saldo, uma única fatura e logs de uso, você pode comparar DeepSeek, Qwen e outras rotas de modelo sem espalhar chaves e comprovantes de cobrança entre provedores.
Resposta final
A conclusão correta de DeepSeek API vs Qwen API para fluxos de trabalho sensíveis a custos: Guia de custos 2026 não é "DeepSeek é mais barata" nem "Qwen é mais barata." É:
Use a Qwen primeiro para fluxos de trabalho simples, de baixo custo, passíveis de cache e em lote. Use a DeepSeek primeiro quando a configuração simples, o agendamento fora de pico, a contabilização direta de cache hits ou a qualidade da DeepSeek Flash proporcionarem o menor custo por tarefa aceita. Use a Flatkey quando o custo de troca, de registro e de comprovação de cobrança começar a importar tanto quanto o preço por token.