
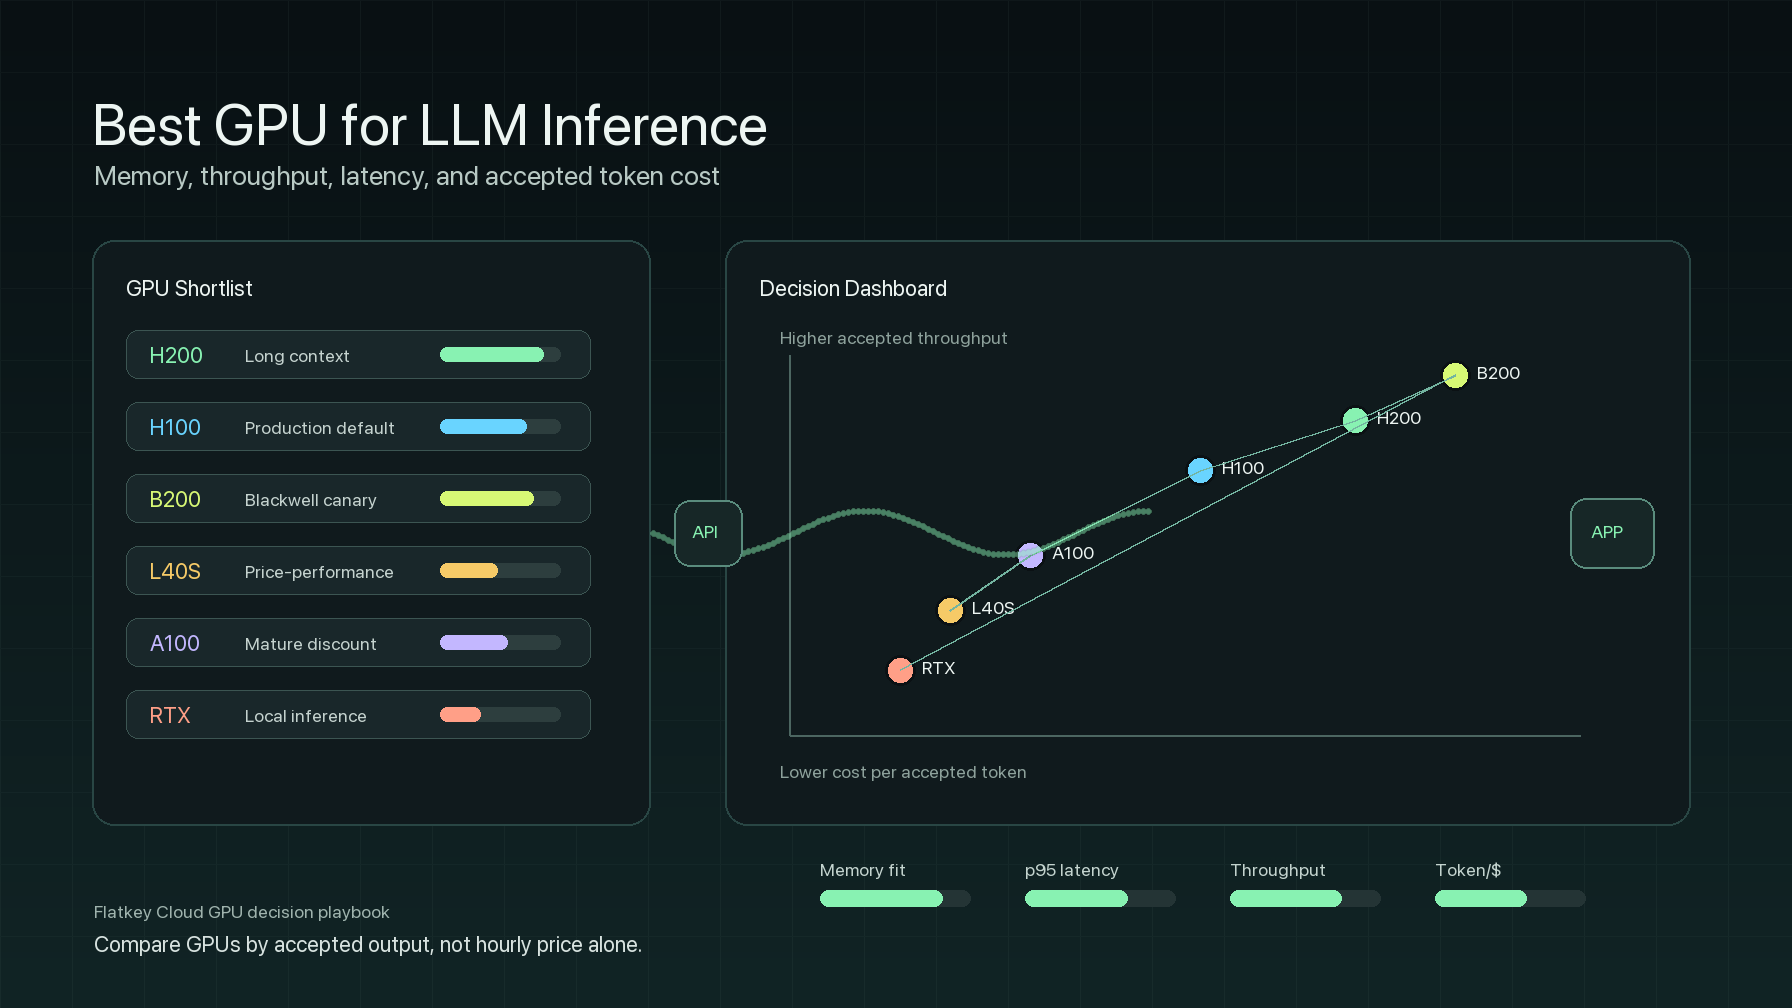
Лучшая GPU для инференса LLM — это та GPU, которая удовлетворяет вашему реальному набору промптов при минимально приемлемой стоимости, одновременно выполняя требования к памяти, задержке и надежности. Это не всегда новейшая GPU, не всегда самый дешевый почасовой тариф и не всегда плата с самым высоким результатом бенчмарка.
Для большинства корпоративных AI-команд краткий ответ такой:
- Выбирайте H200, когда узким местом является память: serving для моделей класса 70B, RAG с длинным контекстом, высокая конкуренция или KV cache, который подводит H100 слишком близко к пределу.
- Выбирайте H100, когда вам нужен зрелый production-стандарт с сильной поддержкой ПО, широкой доступностью в облаке и хорошей пропускной способностью без перехода на новую емкость Blackwell.
- Выбирайте B200, GB200 или более новые системы Blackwell, когда ваш стек может использовать точность и топологию эпохи Blackwell, а провайдер может подтвердить реальную доступность, цену и операционную поддержку.
- Выбирайте L40S или A100, когда соотношение цена/производительность важнее пиковой задержки, модель помещается без проблем, а ваша нагрузка batch-овая, внутренняя или со средним контекстом.
- Выбирайте RTX 4090, RTX 5090 или workstation GPU для локального инференса LLM, разработки, демо и небольших частных нагрузок, а не для многопользовательского enterprise serving.
- Используйте API модели или роутер вместо аренды GPU, когда трафик приходит всплесками, выбор модели часто меняется или эксплуатация стека serving не является вашим конкурентным преимуществом.
Это руководство объясняет, как выбрать лучшую GPU для инференса LLM по памяти, пропускной способности, задержке и стоимости за токен. Оно также включает матрицу решений, план бенчмарка и таблицу токенов на доллар, которую вы можете повторно использовать перед арендой или покупкой мощности.
Лучшая GPU для инференса LLM: быстрая матрица решений
| Нагрузка | Лучшая GPU для старта | Почему обычно подходит | На что обратить внимание |
|---|---|---|---|
| chat 7B-13B, внутренние инструменты, прототипы | L40S, RTX 4090, RTX 5090, A100 40GB или облачная емкость класса L4 | Более низкая почасовая стоимость может быть важнее пиковой скорости ускорителя, когда модель небольшая, а конкуренция умеренная. | Не переносите задержку локального демо на production-трафик p95/p99. |
| инференс 30B-34B | L40S, A100 80GB, H100 PCIe/SXM | Достаточно памяти для практических конфигураций serving при более низком минимальном пороге стоимости, чем у H200 или B200. | Длинный контекст и высокая конкуренция могут сместить нагрузку в зону H100/H200. |
| инференс класса 70B | H100, H200 или много-GPU конфигурация A100/H100 | H100 — зрелая база; H200 привлекает, когда память и давление KV cache уменьшают число необходимых GPU. | Квантизация, tensor parallelism и политика batching определяют реальную стоимость. |
| RAG с длинным контекстом | Сначала H200, затем H100 NVL/SXM или B200, если доступно | KV cache и prefill промпта могут сделать емкость и пропускную способность памяти важнее, чем грубая почасовая цена. | Бенчмарк должен использовать реальные длины контекста, а не только короткие промпты. |
| batch-инференс с высокой пропускной способностью | A100, L40S, H100 или H100 spot/marketplace | Пропускная способность на доллар часто важнее минимальной задержки, когда задания можно ставить в очередь. | Учитывайте повторные попытки, прерывания, cold starts и стоимость хранения. |
| чат с клиентами, чувствительный к задержке | H100, H200 или B200, в зависимости от размера модели | Более новые дата-центровые GPU лучше поддерживают стек serving, пропускную способность и запас для конкуренции. | Задержка p95 и p99 важнее, чем средний tokens/сек. |
| локальный инференс LLM | RTX 4090, RTX 5090, workstation-платы RTX PRO / класса RTX 6000 | Локальные платы полезны для приватной разработки, офлайн-тестирования и небольших моделей. | Потребительские платы не заменяют управляемую надежность multi-tenant. |
| регулируемое или корпоративное производство | H100/H200/B200 у провайдера с поддержкой, сетью, изоляцией и аудитными контролями | Операционный слой может быть важнее, чем название GPU. | Проверьте SLA, политику замены, сеть, хранение и наблюдаемость. |
Практическое правило: лучшая GPU для инференса LLM меняется вместе с размером модели, длиной контекста, конкуренцией, точностью, фреймворком serving и ценой. Сделайте так, чтобы GPU действительно соответствовала нагрузке.
Почему память обычно определяет первый короткий список
Инференс LLM использует память GPU не только для весов модели. Production-серверу также нужны KV cache, overhead рантайма, буферы batching, адаптеры, overhead токенизатора/сервера и, иногда, speculative decoding или буферы структурированного вывода.
Используйте эту первую модель памяти:
required_vram =
  model_weights
  + KV_cache_for_target_context_and_concurrency
  + runtime_overhead
  + safety_margin
KV cache — это причина, по которой модель, помещающаяся в короткую демо-версию, может не справиться в продакшене. Длинные промпты, большие батчи, большее число одновременных запросов и более высокие лимиты на выходной текст увеличивают давление на память. Лучшая GPU по соотношению цены и качества для инференса LLM часто — это та GPU, которая позволяет избежать дополнительного shard, предотвратить попытку после нехватки памяти или поддерживать больший batch без ущерба для p95-латентности.
Объём памяти также меняет операционную модель:
| Состояние памяти | Что это значит для serving LLM |
|---|---|
| С запасом | Можно настраивать batch size, длину контекста и параллелизм без немедленного риска OOM. |
| Почти на пределе | Квантование, меньшие батчи, более короткий контекст или tensor parallelism становятся обязательными. |
| За пределом | Нужны дополнительные GPU, GPU с большим объёмом памяти, модель меньшего размера, более низкая точность или маршрут через API. |
NVIDIA указывает H200 с 141GB памяти HBM3e и пропускной способностью памяти 4.8TB/s. Страницы NVIDIA для H100 позиционируют H100 как зрелую основу Hopper, а страницы AWS P5 показывают семейства инстансов H100 и H200 с до 8 GPU на узел и пропускной способностью GPU-to-GPU NVSwitch. Для закупки важен не один параметр в таблице характеристик. Важно, снижает ли дополнительная память число GPU, упрощает ли sharding или повышает ли принимаемый throughput.
Пропускная способность: tokens per second недостаточно
Сырые tokens/sec полезны, но это не метрика покупателя. Для продакшен-сервиса измеряйте принятый объём работы:
accepted_output_rendimento =
  accepted output tokens or accepted responses
  / wall-clock benchmark duration
Затем нормализуйте по стоимости:
token_per_dollar =
  accepted output tokens per hour
  / effective hourly cost
Это центральная метрика, лежащая в основе поисков лучшая GPU для инференса LLM token/s/usd. Более дешёвая GPU может победить, если она остаётся хорошо загруженной и требования к задержке более гибкие. Более дорогая GPU может победить, если она увеличивает batch size, сокращает число реплик, предотвращает сбои из-за нехватки памяти или удерживает p95/p99 latency в пределах целевого SLA.
Разделите throughput на две фазы:
| Фаза | Что нагружает GPU | Что измерять |
|---|---|---|
| Prefill | Длина промпта, работа attention, перемещение памяти, повторное использование cache | время до первого токена, tokens промпта/сек, ожидание в очереди |
| Decode | Длина выхода, масштабирование batch, пропускная способность KV cache | tokens выхода/сек, задержка между токенами, p95/p99 время завершения |
Для длинноконтекстного RAG и агентского трафика может доминировать prefill. Для streaming-чата с длинными ответами может доминировать decode. Для пакетной классификации число принятых запросов в минуту может быть важнее, чем задержка стриминга.
Задержка: выбирайте по p95 и p99, а не по средней скорости
Лучшая GPU для инференса LLM в рамках SLA, ориентированного на пользователя, — это GPU, которая удерживает хвостовую задержку под нагрузкой. Средняя задержка скрывает очередь, шумных соседей, сбои cache, cold starts и повторные попытки после OOM.
Отслеживайте эти метрики в каждом тесте GPU:
| Метрика | Почему это важно |
|---|---|
| Время до первого токена | Воспринимаемая пользователем отзывчивость и эффективность prefill. |
| Задержка между токенами | Качество streaming и скорость decode. |
| End-to-end latency | Общее время завершения задачи. |
| p95 и p99 latency | Реальное состояние SLO в продакшене. |
| Ожидание в очереди | Перегружен ли сервер ещё до начала генерации. |
| Частота OOM и retry | Достаточно ли стабилен бенчмарк, чтобы на его основе принимать решение о покупке. |
| Загрузка GPU и использование пропускной способности HBM | Является ли GPU узким местом или pipeline ждёт в другом месте. |
Если котировка H200 составляет 1,4x котировки H100, а он обеспечивает 1,8x приемлемой выходной пропускной способности для вашей рабочей нагрузки, H200 может победить. Если он стоит 2,2x и улучшает p95 лишь на 10%, вероятно, победит H100. Если L40S намного дешевле и соответствует целевому уровню задержки для модели 13B, L40S может быть лучшей GPU по соотношению цена/качество для инференса LLM в этом сценарии.
Лучшая GPU для локального инференса LLM
Лучшая GPU для локального инференса LLM — это отдельный вопрос от лучшей GPU для корпоративного serving. Локальный инференс обычно ценит цену покупки, энергопотребление на рабочем столе, VRAM, конфиденциальность и удобство для разработчиков. Production serving ценит доступность, наблюдаемость, политику замены, межсоединение, изоляцию multi-tenant и поддержку.
Для локального использования:
- RTX 4090 и RTX 5090 — сильные варианты для локальной разработки небольших и квантизированных моделей, потому что они обеспечивают высокую производительность потребительских GPU и достаточный объем VRAM для многих экспериментов.
- GPU для рабочих станций класса RTX PRO / RTX 6000 лучше, когда вам нужно больше VRAM, драйверы для рабочих станций или профессиональная поддержка.
- Unified memory у Mac или инференс на CPU может быть полезен для тестирования, но не следует рассматривать это как benchmark serving на GPU.
- Локальные конфигурации с несколькими GPU могут работать для исследований, но редко сопоставимы с операциями облачного дата-центра, если только ваша команда не отвечает за питание, охлаждение, сеть, мониторинг и восстановление после сбоев.
Используйте локальные GPU для проверки промптов, качества, квантизации и поведения приложения. Используйте облачные GPU или GPU в дата-центре для проверки production-конкурентности, задержки p95/p99, доступности, стоимости за принятый токен и процессов rollout.
Рекомендуемая GPU по модели и шаблону serving
| Шаблон serving | Короткий список GPU | Почему |
|---|---|---|
| Саппорт-бот 7B/8B, умеренный контекст | L40S, A100 40GB/80GB, H100 PCIe, локальные RTX для разработки | Модель достаточно мала, чтобы более низкая почасовая стоимость могла быть важнее, чем топовая память. |
| Приватный ассистент 13B-34B | L40S, A100 80GB, H100 | Выбирайте в зависимости от конкурентности и целевой задержки; H100 полезен, когда важна хвостовая задержка. |
| Chat 70B с умеренным контекстом | H100, H200, 2x A100/H100 в зависимости от точности | Проведите benchmark квантизации, tensor parallelism и политики batch. |
| RAG с длинным контекстом 70B | H200, H100 NVL/SXM, B200 при наличии | Могут доминировать память и давление на KV cache. |
| Корпоративный multi-tenant API | H100/H200/B200 у провайдера с поддержкой | Важны поддержка, наблюдаемость, изоляция и политика замены. |
| Пакетный offline-инференс | A100, L40S, H100 spot или marketplace | Пропускная способность на доллар может быть важнее минимальной задержки. |
| Ноутбук или desktop разработчика | RTX 4090, RTX 5090, RTX PRO/workstation | Отлично подходит для локального инференса LLM и разработки промптов; это не полноценный ответ для production. |
План benchmark перед арендой или покупкой
Не выбирайте лучшую GPU для инференса LLM только на основе общего benchmark. Запустите воспроизведение, похожее на ваш продукт.
- Заморозьте рабочую нагрузку. Зафиксируйте ID модели, квантизацию, точность, распределение длины промптов, распределение длины выходов, целевой контекст, конкурентность и проверки качества.
- Заморозьте serving-стек. Используйте одну и ту же версию vLLM, SGLang, TensorRT-LLM, NIM или пользовательского сервера во всех тестах GPU, где это возможно.
- Заморозьте конфигурацию hardware. Зафиксируйте SKU GPU, количество GPU, PCIe/SXM/NVL, CPU, RAM, хранилище, драйвер, версию CUDA, сеть и размещение.
- Запустите три профиля трафика. Короткий chat, RAG с длинным контекстом и batch/offline prompts выявляют разные узкие места.
- Измеряйте p50, p95, p99. Средняя задержка недостаточна для клиент-ориентированного инференса.
- Отслеживайте сбои. Подсчитывайте OOM, timeouts, evictions, сбои cold start и усиление retries.
- Рассчитайте стоимость принятых результатов. Разделите эффективную стоимость на принятые выходные токены, принятые ответы или выполненные задачи.
- Запустите как минимум один день canary. Цены marketplace, доступность провайдера и очереди могут меняться в реальных окнах трафика.
Минимальная таблица benchmark:
| Метрика | GPU-кандидат A | GPU-кандидат B | GPU-кандидат C |
|---|---|---|---|
| Почасовая цена GPU | |||
| Эффективная почасовая стоимость | |||
| Принятые выходные токены/час | |||
| Стоимость за 1M принятых выходных токенов | |||
| Время до первого токена p95 | |||
| Сквозная задержка p95/p99 | |||
| Частота OOM или retry | |||
| Средняя загрузка GPU | |||
| Примечания по эксплуатации |
Когда API модели превосходит аренду GPU
Лучшая GPU для инференса LLM на самом деле может оказаться вообще без аренды GPU. Прямой контроль над GPU ценен, когда у вас есть собственные веса, стабильная загрузка, кастомные ядра, сильная локальность данных или команда serving-инфраструктуры, которая умеет поддерживать GPU загруженными.
Используйте API модели или роутер, когда:
- Трафик нерегулярный.
- Вам нужны несколько провайдеров моделей, а не одна фиксированная open-weight-модель.
- Выбор модели часто меняется.
- Вам важнее fallback, чем контроль над bare-metal.
- Время простоя GPU превысило бы любую наценку API за токен.
- Ваша команда хочет журналы использования, бюджетные лимиты, счета и управление провайдерами без эксплуатации serving-кластера.
Flatkey подходит именно под эту сторону решения: один ключ, один баланс, один счет, более 300 официальных моделей, более 1 000 pay-per-call инструментов и журналы использования на уровне запроса. Если нагрузка не требует саморазмещаемых весов, сравните стоимость GPU на принятую токен-единицу с управляемыми маршрутами моделей, прежде чем связывать себя GPU-кластером.
Для связанных с затратами решений см. гайды Flatkey о ценах аренды GPU, H100 vs A100, H200 vs H100, аренде GPU-кластера, vLLM vs SGLang и сравнении цен на AI-модели.
Итоговая рекомендация
Лучшая GPU для инференса LLM зависит от нагрузки:
- Используйте H200, когда память, длинный контекст и давление со стороны KV-кэша определяют стоимость.
- Используйте H100, когда вам нужен проверенный производственный стандарт и нагрузка ему соответствует.
- Используйте B200 или GB200, когда доступна емкость Blackwell, стек serving-инфраструктуры готов, а ваш бенчмарк подтверждает наценку.
- Используйте L40S или A100, когда соотношение цены и качества важнее минимальной задержки.
- Используйте локальные GPU класса RTX для разработки и локального инференса LLM, а не для многопользовательского enterprise-serving.
- Используйте Flatkey или другой слой API модели, когда прямое управление GPU не является преимуществом продукта.
Покупательская метрика — не «какая GPU самая быстрая?». Это стоимость за принятый токен на уровне задержки и надежности, которые требуются вашему продукту.
Часто задаваемые вопросы
Какая GPU лучше всего подходит для инференса LLM?
Лучшая GPU для инференса LLM зависит от нагрузки. H200 часто является наиболее сильной отправной точкой для serving 70B и длинного контекста, ограниченных памятью. H100 — зрелый производственный стандарт. L40S, A100, RTX 4090 или RTX 5090 могут быть лучше для меньших моделей, пакетных задач или локального инференса, когда они достигают целевой задержки при меньшей стоимости.
Какая GPU лучше всего по соотношению цена/качество для инференса LLM?
Лучшая GPU по соотношению цена/качество для инференса LLM — это GPU с наименьшей стоимостью за принятый токен или принятый ответ, а не с самой низкой ценой за час. Перед выбором рассчитайте эффективную почасовую стоимость, количество принятых выходных токенов в час, p95/p99 задержку и частоту ошибок.
Как рассчитать лучшую GPU для инференса LLM в token/s/usd?
Используйте количество принятых выходных токенов в час, деленное на эффективную почасовую стоимость. Эффективная стоимость должна включать аренду GPU, хранилище, пропускную способность, простой, повторные попытки, поддержку и инженерные накладные расходы. Затем сравнивайте один и тот же модельный профиль, точность, длину контекста и стек serving-инфраструктуры между GPU.
H100 или H200 лучше для инференса LLM?
H200 обычно лучше, когда объем памяти, пропускная способность, длинный контекст или более крупный KV cache меняют характер serving. H100 обычно лучше, когда модель хорошо помещается, мощность дешевле или ее проще получить, а бенчмарк соответствует целям по задержке и производительности.
B200 — это лучшая GPU для инференса LLM?
Системы B200 или GB200 могут быть превосходны для масштабного инференса LLM, когда у провайдера есть реальная емкость, serving-фреймворк поддерживает нужную вам точность и топологию, а бенчмарк подтверждает более низкую принятую стоимость. Не покупайте емкость Blackwell только на основе обещаний запуска; тестируйте свой трафик.
Какая GPU лучше всего подходит для локального инференса LLM?
Для локального инференса LLM RTX 4090 и RTX 5090 — распространенный высокопроизводительный выбор для разработчиков, тогда как карты RTX PRO или класса RTX 6000 лучше, когда вам нужно больше VRAM или профессиональная поддержка для рабочей станции. Локальные GPU лучше подходят для разработки, приватности и небольших deployments, а не для полной надежности enterprise-serving.
Проверенные источники
- GPU NVIDIA H200: https://www.nvidia.com/en-us/data-center/h200/
- GPU NVIDIA H100 Tensor Core: https://www.nvidia.com/en-us/data-center/h100/
- GPU NVIDIA A100 Tensor Core: https://www.nvidia.com/en-us/data-center/a100/
- NVIDIA DGX B200: https://www.nvidia.com/en-us/data-center/dgx-b200/
- GPU NVIDIA L40S: https://www.nvidia.com/en-us/data-center/l40s/
- NVIDIA GeForce RTX 5090: https://www.nvidia.com/en-us/geforce/graphics-cards/50-series/rtx-5090/
- Цены на облачные GPU RunPod: https://www.runpod.io/pricing
- Цены на облачные GPU Lambda: https://lambda.ai/pricing
- Экземпляры AWS EC2 P5: https://aws.amazon.com/ec2/instance-types/p5/
- Типы машин с GPU в Google Cloud: https://docs.cloud.google.com/docs/compute-area/gpus
- Документация OpenAI-совместимого сервера vLLM: https://docs.vllm.ai/en/latest/serving/openai_compatible_server.html


