
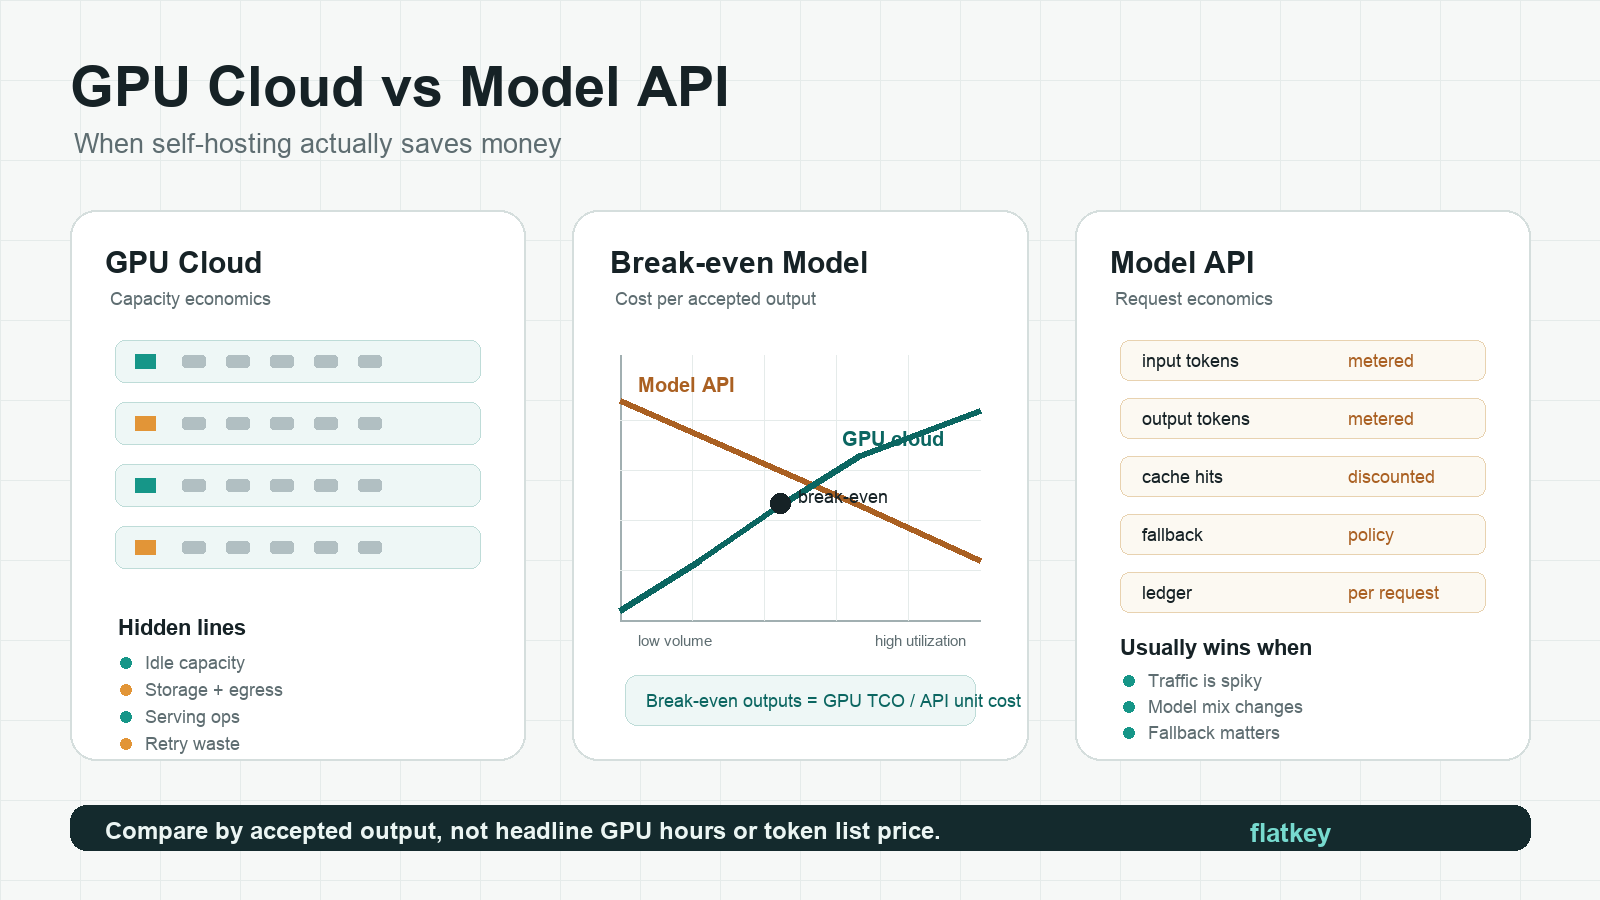
Большинство команд задают вопрос «GPU cloud vs model API» слишком поздно. Они арендуют GPU, разворачивают стек обслуживания, настраивают batching, нанимают платформенную поддержку и только потом сравнивают счёт с управляемым model API. К этому моменту сравнение уже смещено в пользу того пути, в который они уже вложили усилия.
Лучший вопрос проще: вам нужен контроль над слоем GPU или вам нужны надёжные выходные данные модели по минимально приемлемой стоимости?
Для enterprise AI-команд GPU cloud начинает экономить деньги, когда у вас устойчивый спрос, стабильный выбор модели, высокая полезная загрузка и инженерная команда для запуска inference. Model API обычно дешевле, когда трафик носит всплесковый характер, выбор модели часто меняется, retries и failover важнее, чем контроль над железом, или вам нужны frontier-модели, которые нельзя self-hosting'ом развернуть у себя.
Практическое правило Flatkey: сравнивайте GPU cloud vs model API по стоимости за принятый результат, а не только по почасовой ставке GPU или списочной цене токенов.
GPU cloud vs model API: краткий ответ
Используйте эту таблицу, прежде чем строить таблицу расчётов.
| Ситуация | Обычно стоит начать с | Почему |
|---|---|---|
| Ранний продукт, меняющиеся промпты, неопределённый спрос | Model API | Вы избегаете простаивающих GPU, пока изучаете трафик, качество и соответствие модели. |
| Пакетный inference в больших объёмах на одной стабильной open-модели | GPU cloud | Устойчивая загрузка может амортизировать стек обслуживания. |
| Чат для клиентов с непредсказуемыми всплесками | Model API или гибрид | Autoscaling, fallback и отсутствие простаивающей мощности часто важнее, чем голая цена за единицу. |
| Proprietary weights, custom kernels, строгая локальность данных | GPU cloud | Бизнес-требование — контроль, а не только стоимость. |
| Маршрутизация запросов между несколькими провайдерами, frontier-модели или частая замена моделей | Model API | Вы избегаете перестраивания инфраструктуры обслуживания при каждой смене модели. |
| Долгосрочная стабильная нагрузка с доказанной утилизацией | Reserved GPU cloud, dedicated GPU cluster или colocated GPUs | Обязательства могут снизить эффективную стоимость мощности после подтверждения спроса. |
Остальная часть этого руководства даёт копируемую модель для сравнения GPU cloud vs model API без скрытия простоя, retries, операций или фильтров качества.
Единица затрат, которая действительно важна
Не сравнивайте:
- почасовую ставку GPU и цену за токен.
- оценку cloud и лучший сценарий бенчмарка.
- списочную цену model API и полностью загруженный self-hosted кластер.
Вместо этого сравнивайте один из этих знаменателей:
| Нагрузка | Лучший знаменатель |
|---|---|
| LLM chat или agents | Стоимость за принятый ответ, принятый task или принятый output token |
| Пакетная классификация или извлечение | Стоимость за принятый record |
| Генерация кода | Стоимость за принятый patch или завершённую coding task |
| Генерация изображений | Стоимость за принятое изображение после фильтров качества |
| Генерация видео | Стоимость за принятую секунду или принятый clip |
| Fine-tuning или training | Стоимость за завершённый запуск |
Для большинства inference-команд:
effective_unit_cost =
  all_in_monthly_cost
  / accepted_outputs_after_retries_quality_filters_and_failures
Именно здесь многие сравнения GPU cloud vs model API меняют результат. Self-hosted endpoint может показывать отличную пропускную способность в бенчмарке и всё равно проигрывать, если загрузка низкая, модель не проходит проверки качества или инженеры тратят слишком много времени на поддержание стека в рабочем состоянии.
Модель стоимости model API
Model API выглядит просто, потому что счёт обычно измеряется по запросам, токенам, секундам видео, изображениям или вызовам инструментов. Но справедливая модель model API всё равно требует большего, чем опубликованная цена за единицу.
Используйте такую модель:
monthly_model_api_cost =
  input_token_cost
  + cached_input_or_context_cost
  + output_token_cost
  + tool_or_media_cost
  + retry_and_fallback_cost
  + gateway_or_router_cost
  + observability_and_finops_cost
Затем нормализуйте:
model_api_cost_per_accepted_output =
  monthly_model_api_cost
  / accepted_outputs
Что учитывать:
| Статья затрат | Что проверить |
|---|---|
| Input и output tokens | Официальную страницу pricing провайдера, model ID, размер context window, лимит output и дату проверки. |
| Cached input | Поддерживает ли провайдер prompt caching или скидки за cache-hit и действительно ли ваша нагрузка повторно использует контекст. |
| Batch pricing | Подходит ли batch или async processing под ваше требование по latency. |
| Retries | Повторы при rate-limit, временные ошибки, проваленные проверки качества и fallback-запросы. |
| Router/gateway layer | Любую fee за gateway, usage ledger, model allowlist, budget на sub-key или workflow выставления счетов. |
| Operations | Интеграцию, мониторинг, обработку статуса провайдера и финансовую сверку. |
Используйте актуальные значения с официальных страниц источников, а не скопированные таблицы тарифов. Начните с OpenAI API pricing, Anthropic pricing, Google Gemini API pricing и текущей страницы pricing вашего gateway или router.
Для Flatkey сторона model API — это один ключ, один баланс и один журнал использования для официальных моделей и инструментов. Это важно, когда реальная проблема затрат — не один вызов модели, а разрозненные ключи, несколько счетов, контроль бюджета по командам и fallback между провайдерами.
Модель затрат GPU cloud
GPU cloud — это не только почасовая цена GPU. Production self-hosted model API включает стоимость вычислительных мощностей, software для обслуживания, хранилища, сети, мониторинга, работы по обеспечению uptime и простаивающих мощностей.
Используйте эту модель:
monthly_gpu_cloud_cost =
  gpu_compute_hours
  + storage_and_snapshot_cost
  + bandwidth_and_egress_cost
  + load_balancing_and_network_cost
  + serving_stack_cost
  + observability_and_logging_cost
  + platform_engineering_cost
  + support_plan_or_managed_service_cost
  + idle_capacity_cost
  + retry_failure_and_redeployment_waste
Затем нормализуйте:
self_hosted_cost_per_accepted_output =
  monthly_gpu_cloud_cost
  / accepted_outputs
Что нужно учитывать:
| Статья затрат | Почему это меняет ответ |
|---|---|
| Модель GPU и объем памяти | H100, H200, B200, A100, L40S и GPUs класса RTX имеют разные объемы памяти, throughput, доступность и кривые цен. |
| Режим продукта | On-demand, spot, reserved, marketplace, serverless GPU, dedicated cluster и bare metal имеют разные профили надежности. |
| Утилизация | Более дешевый self-hosted endpoint быстро теряет преимущество, если GPU простаивает. |
| Serving stack | vLLM, SGLang, TensorRT-LLM, NIM или custom servers требуют реальной операционной поддержки. |
| Хранение и загрузка модели | Большие веса, snapshots, volumes и повторные загрузки могут стать существенными. |
| Сеть | Egress, private links, public IPs и load balancing могут изменить unit economics. |
| Сбои | Ошибки out-of-memory, preemptions, плохие контейнеры и cold starts увеличивают стоимость одного принятого результата. |
Используйте актуальные страницы провайдеров как контрольные точки: цены AWS EC2, AWS P5 instances, цены Google Cloud GPU, цены RunPod, Lambda GPU Cloud и цены Vast.ai.
Считайте каждую цену GPU помеченной временем. Доступность на marketplace, региональная доступность и committed quotes могут меняться быстрее, чем статья, которую вы читаете.
Формула break-even
Именно здесь решение GPU cloud vs model API становится финансовым, а не основанным на мнениях.
Самая простая модель break-even:
break_even_outputs =
  monthly_gpu_cloud_cost
  / model_api_cost_per_accepted_output
Если ваш workload производит больше принятых результатов, чем break_even_outputs, self-hosting может сэкономить деньги. Если меньше — model API, вероятно, дешевле.
Вы можете выразить ту же идею через utilization:
required_utilization =
  monthly_gpu_cloud_cost
  / equivalent_model_api_cost_at_expected_volume
Эта формула полезна только если workload стабилен. Если объем, модель, длина контекста или целевой уровень качества меняются каждый месяц, сторона model API имеет option value, который формула utilization не учитывает.
Пример расчета: почему почасовая цена GPU может вводить в заблуждение
Предположим, команда решает, стоит ли self-hosting стабильной open model.
| Входной параметр | Пример значения |
|---|---|
| Полная стоимость GPU cloud | $24,000 в месяц |
| Объем принятых результатов | 30 миллионов принятых результатов в месяц |
| Стоимость self-hosting на один принятый результат | $0.0008 |
| Стоимость model API на один принятый результат | $0.0012 |
| Ежемесячная стоимость model API при том же объеме | $36,000 |
| Видимая экономия от self-hosting | $12,000 в месяц |
В этом базовом сценарии GPU cloud выглядит дешевле.
Теперь подвергнем предположения стресс-тесту.
| Изменение | Эффект |
|---|---|
| Полезная утилизация падает на 35% | Unit cost self-hosted растет, потому что фиксированный пул GPU выполняет меньше принятых задач. |
| Частота retry или quality-fail удваивается | Оба варианта становятся дороже, но self-hosting также поглощает потери мощности. |
| Продукт переходит на более крупную модель | Существующим GPU может потребоваться sharding, больше памяти или новый serving stack. |
| Спрос становится скачкообразным | Model API может масштабироваться вместе со спросом; пул GPU нужно либо размерить под пики, либо принять очереди. |
Если худший сценарий сводит экономию на нет, self-hosting на самом деле не дешевле. Это ставка на мощность.
Когда GPU cloud действительно экономит деньги
GPU cloud может экономить деньги, когда большинство из этих условий выполняются:
- У вас устойчивый спрос, а не occasional bursts.
- Семейство моделей стабильно в течение месяцев, а не дней.
- Модель с открытыми весами или иным образом доступна для self-hosting.
- Нагрузка имеет высокую полезную утилизацию после очередей и сбоев.
- Целевые показатели latency могут быть достигнуты вашим serving stack.
- Вы можете надежно запускать vLLM, SGLang, TensorRT-LLM, NIM или другой стек.
- Команда может отслеживать GPU utilization, memory pressure, p95/p99 latency, error rate и retry amplification.
- У вас есть план для загрузки модели, warming cache, автоматизации shutdown и безопасного rollout.
- В quote включены storage, egress, support и допущения по availability.
- Финансовый отдел готов финансировать capacity до того, как каждый запрос поступит.
Это типично для высокообъемного batch inference, внутренних extraction pipelines, стабильных support bots, доменных open models и workloads, где важны custom weights или locality данных.
Для более глубокого планирования на стороне GPU используйте руководства Flatkey о ценах аренды GPU, лучшей GPU для LLM inference, аренде GPU-кластера и TCO GPU-кластера.
Когда model API остаются дешевле
Model API обычно остаются дешевле, когда верно следующее:
- Трафик носит всплесковый, сезонный характер или пока неизвестен.
- Приложению нужны несколько frontier models.
- Модель меняется быстрее, чем ваш план инфраструктуры.
- Команде больше нужны fallback, обработка rate limits, счета, usage logs и бюджетные ограничения, чем контроль над железом.
- Вы не можете достаточно загрузить GPUs, чтобы компенсировать idle time.
- У вас нет platform team, готовой эксплуатировать serving layer.
- Нагрузка включает закрытые модели, multimodal generation, proprietary provider capabilities или быстро выходящие новые модели.
- Закупки хотят атрибуцию по каждому запросу, а не общий счет за инфраструктуру.
Именно здесь сравнение GPU cloud и model API — это не только вопрос цены. Model API может сократить время интеграции, сложность закупок и площадь инцидентов.
Flatkey подходит для этой стороны решения, когда командам нужен один OpenAI-compatible маршрут для многих официальных моделей, один prepaid balance, один invoice, бюджеты на sub-key, model allowlists, записи об использовании на уровне запросов и failover между upstream channels. См. связанные руководства о сравнении цен на AI models, сравнении цен на AI API, ценах AI gateway и управлении расходами на AI API.
Гибридный подход часто и есть правильный ответ
Многим enterprise AI-командам не следует пытаться навязать один универсальный ответ. Гибридная модель часто более обоснована:
| Часть нагрузки | Лучший базовый вариант |
|---|---|
| Стабильный высокообъемный inference на open-weight моделях | GPU cloud |
| Reasoning или coding на frontier model | Model API |
| Batch jobs, которые можно поставить в очередь | GPU cloud, spot или reserved capacity |
| Всплески для клиентских сценариев | Model API или гибридный overflow |
| Proprietary weights | GPU cloud |
| Исследование моделей | Model API |
| Регулируемое развертывание с контролем инфраструктуры | Выделенный GPU cloud, private GPU cloud, colocation или on-premises |
Гибридный шаблон таков:
- Направляйте неизвестные и переменные workloads через model API.
- Сравнивайте стабильные workloads на GPU cloud.
- Переносите в self-hosting только workloads с доказанным объемом и стабильностью модели.
- Оставляйте model API как fallback для overflow, обновлений модели и разнообразия провайдеров.
Этот путь позволяет избежать самой дорогой ошибки: покупки GPU capacity для нагрузки, которая позже изменит характер.
План бенчмарка перед переключением
Прогоните один и тот же трафик через оба пути как минимум в одном репрезентативном окне.
| Метрика | Путь GPU cloud | Путь model API |
|---|---|---|
| Принятые результаты | ||
| Input tokens или записи | ||
| Output tokens или результаты | ||
| p50 / p95 / p99 latency | ||
| Time to first token | ||
| Error rate | ||
| Retry rate | ||
| Quality rejection rate | ||
| Idle capacity | N/A | |
| Staff hours | ||
| Storage and egress | ||
| Total cost | ||
| Cost per accepted output |
Затем спросите:
- GPU cloud все еще выигрывает после учета idle time?
- Он все еще выигрывает после учета времени сотрудников?
- Он все еще выигрывает после учета retries и quality filters?
- Он все еще выигрывает, если модель изменится?
- Он все еще выигрывает, если трафик упадет на 30%?
- Он все еще выигрывает, если p95 latency должна улучшиться?
Если ответ «да» даже в downside case, self-hosting заслуживает серьезного пути закупки.
Чеклист закупок
Для GPU cloud:
- Какие именно GPU, объем памяти, CPU, RAM, диск, интерконнект и пропускная способность сети включены?
- Это capacity on-demand, spot, marketplace, secure cloud, reserved, dedicated или bare metal?
- Какие расходы на хранилище, snapshot, egress, public IP, load balancer, поддержку и observability не включены?
- Что происходит при сбое хоста, preemption, обслуживании или нехватке capacity?
- Может ли провайдер запустить ваш реальный benchmark до заключения обязательств?
- Каков минимальный срок, путь наращивания и стоимость выхода?
Для model APIs:
- Какие именно model IDs, context windows, output caps и pricing units используются?
- Кеш-хиты, batch jobs, image/video units и tool calls тарифицируются отдельно?
- Какие действуют rate limits и варианты fallback?
- Как учитываются retries, failed provider calls и quality rejections?
- Может ли finance экспортировать usage по команде, ключу, модели, окружению и клиенту?
- Какие применяются условия хранения данных, compliance и SLA?
Список источников
Используйте эти официальные страницы как отправную точку для актуальных данных:
| Тип источника | Страницы для проверки |
|---|---|
| Model API pricing | OpenAI API pricing, Anthropic pricing, Google Gemini API pricing |
| GPU cloud pricing | AWS EC2 pricing, AWS P5 instances, Google Cloud GPU pricing, RunPod pricing, Lambda GPU Cloud, Vast.ai pricing |
| Serving frameworks | vLLM OpenAI-compatible server, SGLang documentation |
| GPU specifications | NVIDIA H100, NVIDIA H200, NVIDIA DGX B200 |
| FinOps structure | FinOps FOCUS |
| Flatkey cost context | Flatkey pricing, Flatkey Compute, Flatkey Compute price index |
Часто задаваемые вопросы
Всегда ли GPU cloud дешевле, чем model API?
Нет. GPU cloud дешевле только тогда, когда полезная загрузка достаточно высока, чтобы компенсировать простаивающие мощности, хранение, egress, операционные расходы на serving, потери на retries и время сотрудников. Model API может быть дешевле для всплесковых или меняющихся нагрузок, даже если цена за токен выглядит выше.
Когда self-hosting LLM действительно экономит деньги?
Self-hosting экономит деньги, когда модель стабильна, объем высокий, загрузка предсказуема, команда может поддерживать serving stack, а полная стоимость GPU cloud на принятый результат ниже стоимости model API при неблагоприятных допущениях.
Как сравнивать цены GPU cloud и model API?
Сравнивайте стоимость за принятый результат. Учитывайте токены, GPU-часов, хранение, bandwidth, простой, retries, rate отказов, quality filters, инженерное время, поддержку и финансовые операции. Не сравнивайте только почасовую цену GPU с прайсом за токен.
Какая самая большая скрытая стоимость inference в GPU cloud?
Самые большие скрытые расходы обычно связаны с простаивающими мощностями, инженерными операциями, хранением и egress, неудачными деплоями, retries из-за нехватки памяти и недостаточно протестированными изменениями serving. Эти затраты не видны в основной почасовой ставке GPU.
Какая самая большая скрытая стоимость model APIs?
Самые большие скрытые расходы обычно связаны с retries, fallback-запросами, длинными prompt'ами, не закешированным контекстом, ответами с большим объемом output, tool или media calls, разрозненными аккаунтами провайдеров и слабой атрибуцией использования. Ledger на уровне запроса помогает выявить эти затраты.
Стоит ли корпоративным AI-командам использовать гибридную архитектуру?
Часто да. Используйте model APIs для исследований, frontier-моделей, всплесков нагрузки и fallback. Переносите в GPU cloud только стабильные high-volume нагрузки после того, как benchmark докажет меньшую стоимость за принятый результат. Сохраняйте API-путь для overflow и изменений модели.
Итог
GPU cloud vs model API — это не философский выбор. GPU cloud vs model API — это решение по экономике нагрузки.
Выбирайте GPU cloud, когда можете загрузить мощности, модель стабильна, а контроль над hardware дает реальное преимущество. Выбирайте model API, когда гибкость, доступ к нескольким провайдерам, более быстрые изменения моделей и управление на уровне запроса важнее, чем теоретическая экономия на оборудовании.
Самый безопасный путь — поэтапный: начните с model API, проведите benchmark нагрузки, переносите стабильные части в GPU cloud только тогда, когда расчеты точки безубыточности выдерживают неблагоприятные сценарии, и сохраняйте API-маршрут для fallback и будущих изменений модели.
Если вы сравниваете GPU cloud и model API для production AI workload, Flatkey может помочь на стороне API с одним ключом, одним балансом, официальными model routes, ledgers использования, бюджетами и счетами, пока ваша команда доказывает, какие workloads действительно заслуживают выделенной GPU capacity.


