
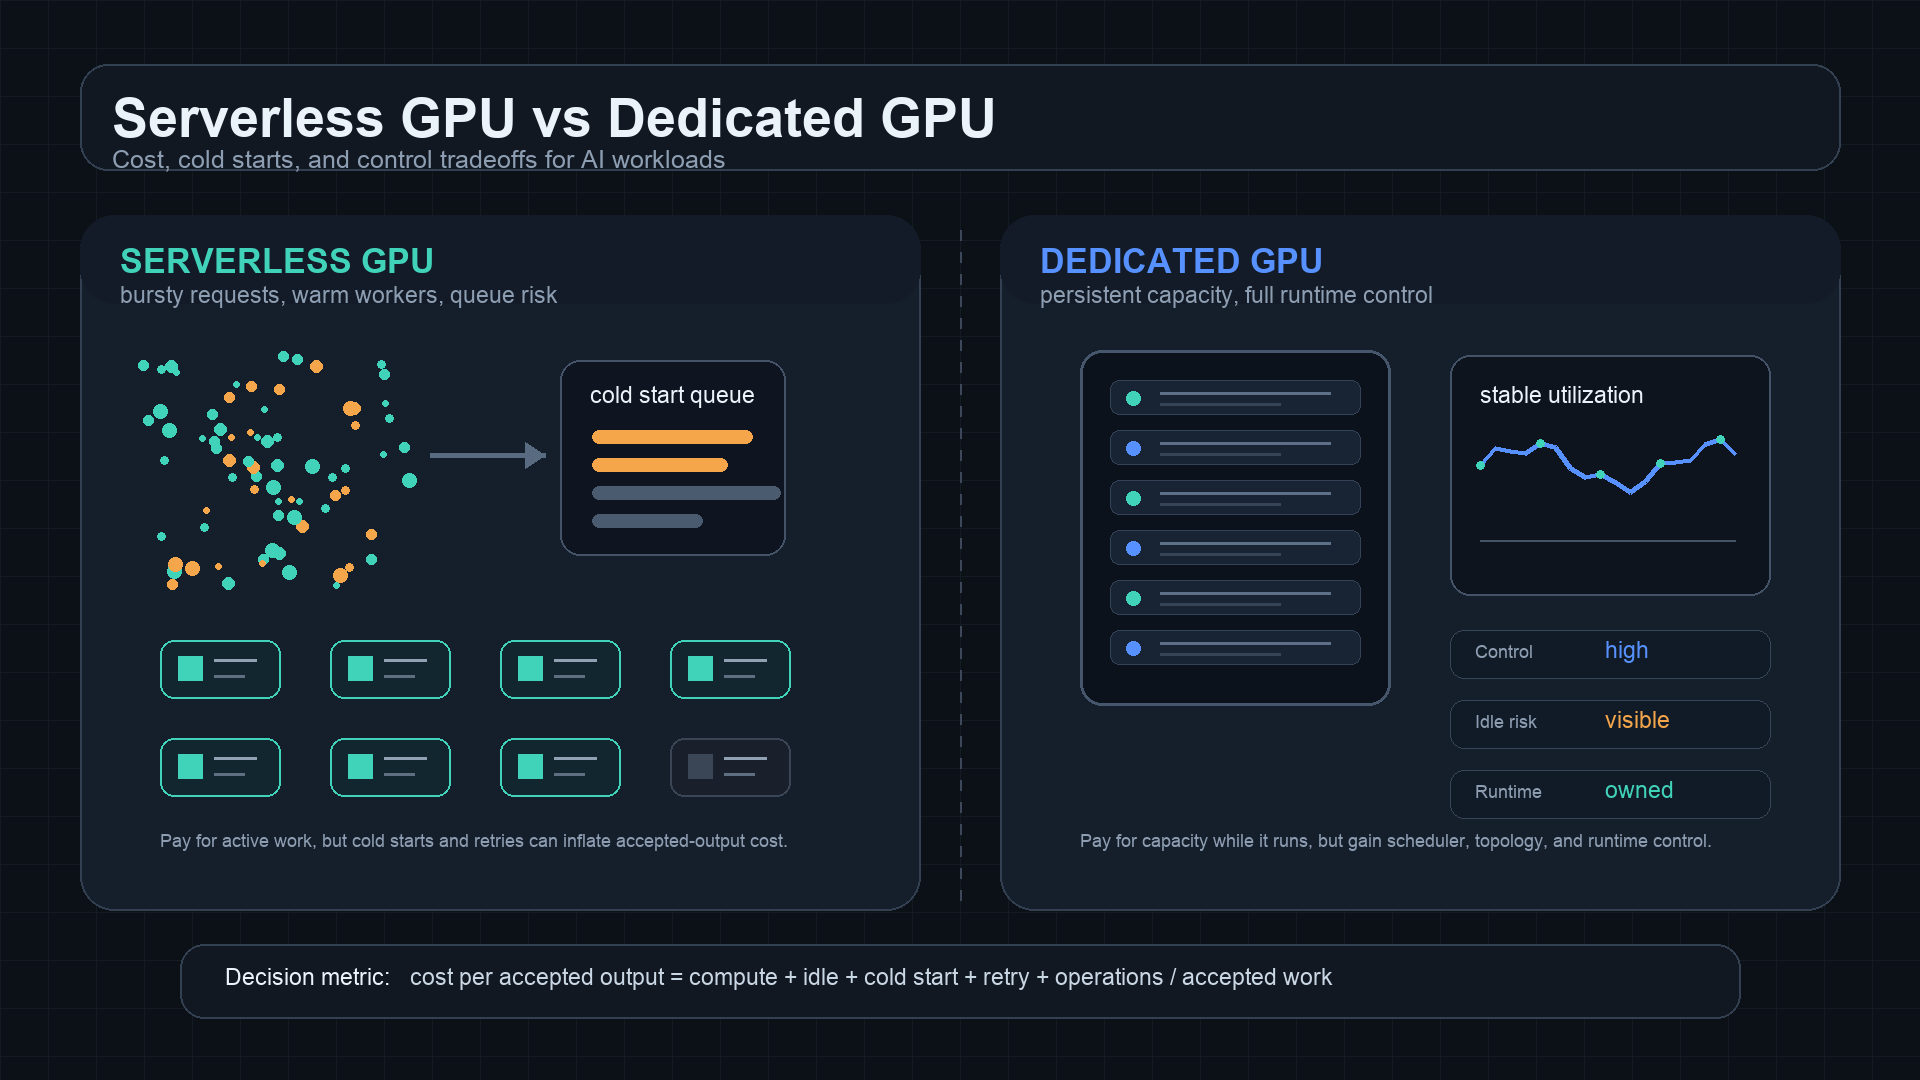
Serverless GPU vs Dedicated GPU: Стоимость, cold start и контроль
Выбор между serverless GPU и выделенной GPU-мощностью — это в первую очередь вопрос характера нагрузки. Serverless GPUs привлекательны, когда трафик носит всплесковый характер, эксперименты идут неравномерно или команде хочется избежать простоя оборудования. Выделенные GPUs привлекательны, когда спрос стабилен, важна задержка запуска или команде нужен контроль над драйверами, планировщиками, сетью, кешами моделей и runtime для обслуживания.
Ошибка — сравнивать цену запроса к serverless GPU с почасовой ценой выделенной GPU так, будто речь идет об одном и том же. Это не так. Serverless endpoint может скрывать cold starts, задержку в очереди, ограничения по конкуренции запросов, стоимость повторных попыток и накладные расходы на каждый запрос. Выделенная GPU может скрывать простой, риск зарезервированной мощности, хранилище, поддержку и работу platform engineering.
Для независимых разработчиков и небольших AI-команд практическое правило такое:
serverless GPU vs dedicated GPU следует сравнивать по стоимости одного принятого результата,
а не по самой низкой видимой ставке GPU.
Если вы все еще решаете, нужен ли вообще прямой арендуемый GPU, также прочитайте руководства Flatkey: GPU cloud vs model API, GPU rental prices и cloud GPU hidden costs. Эта статья фокусируется на выборе между serverless GPU и выделенной GPU уже после того, как GPUs включены в набор для оценки.
Serverless GPU vs dedicated GPU: быстрый ответ
Используйте эту таблицу как первый фильтр.
| Точка принятия решения | Serverless GPU обычно подходит | Выделенная GPU обычно подходит |
|---|---|---|
| Паттерн трафика | Всплесковый, очередной, экспериментальный или неравномерный | Стабильный, с высоким объемом, чувствительный к задержке или с заранее спланированной мощностью |
| Формат биллинга | Оплата в основном тогда, когда работают workers или выполняются запросы, в зависимости от провайдера | Оплата, пока существует instance, pod, node, cluster или reservation |
| Риск запуска | Cold starts, загрузка модели, pull контейнера, прогрев worker и задержка в очереди | Меньше exposure к cold start после прогрева, но простои оплачиваются |
| Операционный контроль | Меньше контроля над host, scheduler, runtime, topology и caching | Больше контроля над drivers, serving stack, caches, topology и observability |
| Модель надежности | Масштабирование под управлением провайдера с лимитами endpoint и возможными cold paths | Uptime под управлением команды, autoscaling, failover, патчи и реагирование на инциденты |
| Лучшее первое применение | Демо, задачи с изображениями/видео, batch inference, спорадические API, прототипы | Стабильные inference endpoints, долгоживущие сервисы, custom runtimes, multi-node workloads |
Лучший ответ часто выглядит как поэтапный процесс:
- Начните с serverless GPU при неизвестном спросе.
- Измерьте cold starts, задержку в очереди, rate повторных попыток и cost одного принятого результата.
- Переносите в выделенную GPU-мощность только стабильные и высокообъемные workloads.
- Сохраняйте доступный путь через model API, когда продукту нужно много моделей или не нужен контроль над оборудованием.
Этот подход безопаснее, чем резервировать выделенные GPUs до того, как станет ясно, сможет ли нагрузка постоянно держать их занятыми.
Что на практике означает "serverless GPU"
Serverless GPU обычно означает, что провайдер абстрагирует владение долгоживущими серверами. Вы упаковываете модель, контейнер, функцию или endpoint; платформа запускает GPU workers при поступлении запросов; и платформа может масштабировать workers вверх или вниз в зависимости от спроса.
Реализации у провайдеров различаются. RunPod описывает Serverless через endpoints и workers, с отдельным serverless pricing по сравнению с pod pricing. Modal документирует GPU functions, cold starts и lifecycle контейнера. Google Cloud Run поддерживает services с GPUs и имеет собственную модель Cloud Run pricing. Развертывания Replicate предоставляют настраиваемые production inference endpoints. Это не идентичные продукты, поэтому важен чек-лист источника.
С точки зрения покупателя serverless GPU-мощность полезна, когда:
- Объем запросов низкий, всплесковый или еще только выясняется.
- Задачи могут подождать в очереди без ущерба для пользовательского опыта.
- Cold starts допустимы или их можно скрыть.
- Команде нужно меньше владеть инфраструктурой.
- Нагрузка упакована как повторяемые задачи, а не как постоянно прогретый сервис.
- Бизнес предпочитает расходы, зависящие от использования, а не фиксированную ставку на месячную мощность.
Скрытый компромисс в том, что serverless GPU не отменяет физику. Весам модели все равно нужно загружаться. Контейнерам все равно нужно запускаться. GPU все равно нужна доступная мощность. Задержка в очереди все равно влияет на пользователей. Повторные попытки все равно стоят денег.
Что на практике означает "dedicated GPU"
Выделенная GPU-мощность означает, что вы контролируете запущенный instance, pod, server, node или cluster в течение определенного периода времени. Это может быть on-demand, reserved, committed, bare metal, marketplace capacity или private cluster. Общая особенность состоит в том, что GPU выделяется под вашу нагрузку, а не запускается только вокруг конкретного запроса.
Выделенная GPU-мощность полезна, когда:
- Эндпоинт должен оставаться «тёплым».
- Трафик достаточно предсказуем, чтобы загружать GPU работой.
- Вам нужны собственные драйверы, версии CUDA, ядра, model servers или сеть.
- Вам нужны стабильные условия бенчмарков.
- Cold start нарушил бы задержку или пользовательский опыт.
- Нагрузка является multi-node, чувствительной к topology или чувствительной к data locality.
- Вы хотите напрямую управлять vLLM, SGLang, TensorRT-LLM, Triton, Ray Serve, Kubernetes, Slurm или собственной инфраструктурой serving.
Скрытый компромисс — простаивающая мощность. Если dedicated GPU работает 730 часов в месяц, но делает полезную работу только 180 часов, указанная почасовая цена — это не реальная цена полезного часа. Часы простоя входят в стоимость нагрузки.
Формула стоимости, которая делает сравнение честным
Используйте один и тот же знаменатель для обеих сторон:
cost per accepted output =
  compute
  + storage
  + bandwidth
  + idle time
  + cold start waste
  + retry and failed-job waste
  + support
  + engineering overhead
  / accepted outputs, records, tokens, images, clips, or jobs
Для serverless GPU:
serverless GPU cost per accepted output =
  billed worker/request cost
  + cold start and queue waste
  + failed request and retry cost
  + storage and artifact transfer
  + platform integration overhead
  / accepted outputs
Для dedicated GPU:
dedicated GPU cost per accepted output =
  running GPU capacity cost
  + storage and networking
  + idle capacity
  + serving stack operations
  + support and incident work
  + failure and redeploy waste
  / accepted outputs
Именно здесь сравнения serverless GPU vs dedicated GPU часто меняются местами. Serverless может выглядеть дорогим на секунду, но в итоге быть дешевле, если он избавляет от простаивающих GPU. Dedicated может выглядеть дорогим в месяц, но в итоге быть дешевле, если нагрузка постоянно загружает ускоритель и избегает потерь на cold start.
Cold start — это налог serverless GPU
Cold start — это самый важный риск serverless GPU. Cold start может включать:
- Поиск доступной GPU-мощности.
- Загрузку или подключение контейнерного образа.
- Импорт зависимостей.
- Загрузку весов модели.
- Перемещение модели в память GPU.
- Прогрев kernels или путей компиляции.
- Пересборку кэшей.
- Ожидание позади более ранних запросов в очереди.
Документация Modal по cold-start полезна, потому что она разделяет запуск контейнера, импорты и инициализацию приложения. Точные механики различаются у разных провайдеров, но вывод общий: время запуска — это часть пользовательского опыта и модели затрат.
Cold start особенно важен, когда:
| Нагрузка | Почему cold start мешает |
|---|---|
| Интерактивный чат или агенты | Пользователи замечают медленную задержку до первого токена. |
| Редактирование изображений в реальном времени | Первый запрос может восприниматься как сломанный, даже если последующие быстрые. |
| Webhook'и или API, видимые пользователю | Тайм-ауты upstream могут превращать cold start в сбои задач. |
| Пакетные очереди со строгим SLA | Задержка в очереди может нарушить окна доставки. |
| Большие модели | Загрузка весов может доминировать в пути запроса. |
Serverless GPU всё равно может быть правильным выбором, если приложение может выдержать такую задержку. Например, офлайн-задачи с изображениями, ночные очереди оценивания, асинхронный batch inference и внутренние эксперименты часто лучше переносят прогрев, чем чат, ориентированный на клиента.
Dedicated GPUs меняют cold start на риск простоя
Dedicated GPUs обычно уменьшают воздействие cold start, потому что сервис может оставаться тёплым. Веса модели остаются загруженными, кэши — прогретыми, а маршрутизация запросов может попадать на известный endpoint.
Но выделенная мощность создаёт другой налог:
idle waste share =
  1 - useful GPU-active time / billable running time
Если полезная доля GPU-active составляет 30%, более низкая указанная почасовая ставка всё равно может оказаться дорогой. Dedicated GPU может быть технически готова, но финансово простаивать.
Dedicated GPUs лучше всего работают, когда вы можете доказать:
- Базовый объём запросов.
- Высокую загрузку GPU после batching и queueing.
- Стабильный выбор модели.
- Предсказуемые требования к памяти.
- Serving stack, которым команда может управлять.
- План для rolling deploys, мониторинга, алертов и fallback.
Если эти входные данные неизвестны, serverless GPU или model API часто являются более простым первым шагом.
Контроль: что возвращают dedicated GPUs
Самый сильный аргумент в пользу dedicated GPU capacity — не всегда цена. Это контроль.
Выделенная мощность даёт команде больше влияния на:
- Модель GPU, объём памяти и количество.
- Регион и data locality.
- Версии CUDA, драйверов, kernel и образа.
- Параметры vLLM, SGLang, TensorRT-LLM, Triton, Ray Serve или собственного runtime.
- Continuous batching, поведение KV cache, quantization, speculative decoding и настройку scheduler.
- Локальные кэши модели и предварительно загруженные веса.
- Сетевую топологию, private links, дизайн VPC, load balancers и ingress.
- Observability, traces, логи и реагирование на инциденты.
Этот контроль ценен, когда нагрузка достаточно важна, чтобы оправдать владение. Он дорог, когда команде нужны только надёжные выходные данные модели.
Эта же граница рассматривается в статьях Flatkey лучший GPU для инференса LLM, руководство по развертыванию vLLM и vLLM vs SGLang. Если вы настраиваете сам runtime, выделенная GPU-мощность может быть правильным уровнем. Если вы выводите на рынок продуктовые функции на множестве моделей, путь через managed API может оказаться быстрее.
Матрица принятия решений по нагрузке
Используйте эту матрицу до того, как собирать таблицу в spreadsheet.
| Нагрузка | Лучшая отправная точка | Почему |
|---|---|---|
| Новая AI-функция продукта с неизвестным спросом | Serverless GPU или API модели | Позволяет избежать покупки простаивающей мощности до того, как станет известен трафик. |
| Асинхронная очередь генерации изображений | Serverless GPU | Задержка в очереди может быть приемлемой, а всплески не требуют постоянно включённых GPU. |
| Короткий демо-ролик или прототип | Serverless GPU | Быстрая настройка и биллинг по характеру использования обычно важнее, чем контроль runtime. |
| Стабильный LLM-инференс с большим объёмом | Dedicated GPU | Устойчивая загрузка может амортизировать serving stack. |
| Чувствительная к задержке конечная точка для клиентов | Dedicated GPU или API модели | Cold start и задержку в очереди труднее скрыть. |
| Большая модель с медленной загрузкой весов | Dedicated GPU | Поддержание весов в «тёплом» состоянии может быть лучше, чем повторный serverless startup. |
| Периодический набор для оценки | Serverless GPU, spot GPU или batch API модели | Задания можно повторять, и они могут выполняться за очередью. |
| Пользовательские CUDA-ядра или исследования runtime | Dedicated GPU | Команде нужен низкоуровневый контроль. |
| Многоузловое обучение или распределённый инференс | Выделенный кластер | Топология, сетевой fabric и домены отказа выходят на первый план. |
| Продукт, которому нужны многие frontier-модели | API модели или gateway | Прямое владение GPU не решает доступ к моделям нескольких провайдеров. |
Для более широкого планирования мощностей сочетайте это с руководствами Flatkey по GPU по модели on-demand vs spot, TCO GPU-кластера и аренде GPU-кластера.
Подводные камни стоимости Serverless GPU
Экономика Serverless GPU может разочаровать, если команды игнорируют эти поля.
| Подводный камень | Что происходит | Контроль |
|---|---|---|
| Медленная загрузка модели | Каждый холодный worker тратит оплачиваемое время до начала полезной работы | Предварительно упакуйте артефакты, уменьшите образы, кэшируйте веса, отдельно измеряйте warmup |
| Несоответствие таймаутов | Cold start вызывает таймауты upstream и повторные попытки | Задайте реалистичные таймауты, асинхронные очереди, идемпотентные job ID |
| Непрозрачность очереди | Пользователи видят задержку, но дашборды показывают только завершённые запросы | Отслеживайте ожидание в очереди, время cold start, активное время worker и задержку accepted-output |
| Малые задачи на больших GPU | Накладные расходы на каждый запрос доминируют над полезными вычислениями | Пакетируйте работу или используйте меньшую модель/маршрут API |
| Ограничения всплесков по concurrency | Запросы скапливаются во время окон запуска | Проведите нагрузочное тестирование concurrency endpoint до запуска |
| Усиление повторных попыток | Неудачные задания множат оплачиваемые попытки | Отслеживайте принятые результаты, а не предпринятые результаты |
| Передача данных | Входы, веса и выходы многократно перемещаются | Держите артефакты близко к worker и удаляйте временные файлы по истечении срока |
Вопрос закупки не в том, «поддерживает ли провайдер serverless GPU?» Вопрос в том, «что происходит со стоимостью на принятый выход, когда worker'ы холодные, очереди заполнены, а повторные попытки происходят?»
Подводные камни стоимости Dedicated GPU
Экономика Dedicated GPU может разочаровать и в противоположную сторону.
| Подводный камень | Что происходит | Контроль |
|---|---|---|
| Простаивающая конечная точка | GPU остаётся тёплой ради редких запросов | Автомасштабируйте, консолидируйте нагрузки или используйте serverless/API модели при малом объёме |
| Избыточное выделение памяти | Большая GPU обслуживает нагрузку, которая помещается на более компактном hardware | Перед принятием решения проведите бенчмарк памяти модели и throughput |
| Несоответствие резервирования | Контракт предполагает спрос, который так и не появляется | Резервируйте по измеренной базовой нагрузке, а не по прогнозам запуска |
| Владение serving stack | Инженеры поддерживают runtime вместо продуктовых функций | Учитывайте платформенную работу в TCO |
| Скрытые строки облака | Хранилище, egress, support и сеть находятся вне ставки GPU | Используйте полный worksheet по скрытым затратам GPU cloud |
| Смена моделей | Новая семейство моделей меняет требования к памяти, точности или runtime | Сохраняйте открытыми пути выхода |
| Нагрузка от инцидентов | Uptime становится проблемой вашей команды | Определите алерты, fallback и объём поддержки провайдера |
Контроль над Dedicated GPU ценен только тогда, когда команда может его использовать. Если нагрузка недостаточно стабильна для настройки, дополнительный контроль может превратиться в операционную нагрузку.
Практический пример: почему ответ меняется в зависимости от загрузки
Предположим, команда запускает асинхронную функцию генерации медиа. Точные ставки гипотетические; перед покупкой замените их на проверенные цены провайдера.
| Поле | Serverless GPU | Dedicated GPU |
|---|---|---|
| Принятые задания в месяц | 120,000 | 120,000 |
| Указанный compute | Зависит от нагрузки | Фиксированная ежемесячная ёмкость |
| Cold start и потери в очереди | Выше | Ниже |
| Простаивающая ёмкость | Ниже | Выше |
| Контроль времени выполнения | Ниже | Выше |
| Основной риск | Спрос неизвестен | Спрос стабилен |
Если большинство заданий приходит короткими всплесками, а остальная часть дня спокойная, serverless GPU может оказаться выгоднее, потому что он избегает простаивающей выделенной ёмкости. Если задания приходят равномерно в течение всего дня и у модели медленный путь прогрева, dedicated GPU может оказаться выгоднее, потому что воркеры остаются прогретыми, а throughput проще настраивать.
Теперь измените нагрузку на LLM inference для клиентов со строгими требованиями к задержке. Решение может поменяться даже если serverless выглядит дешевле при низком трафике, потому что пути cold-start и задержка в очереди создают продуктовый риск. В таком случае dedicated GPU или managed model API с устоявшимися средствами контроля latency может быть безопаснее.
Смысл не в том, что одна модель всегда побеждает. Смысл в том, что серверный GPU vs выделенный GPU следует выбирать на основе измеренной формы нагрузки.
План бенчмарка перед выбором
Прогоните одну и ту же нагрузку через оба варианта в течение репрезентативного тестового окна. Отслеживайте эти метрики.
| Метрика | Путь serverless GPU | Путь dedicated GPU |
|---|---|---|
| Принятые результаты | Подсчитывайте успешные результаты после фильтров качества | Тот же знаменатель |
| Попытки получения результатов | Включайте неудачные и повторно отправленные задания | Включайте неудачные и повторно отправленные задания |
| Задержка p50 / p95 / p99 | Включайте время в очереди и cold-start | Включайте время маршрутизации и пакетирования |
| Время до первой полезной работы | Запуск воркера, загрузка модели, прогрев | Старт развёртывания, загрузка модели, rollout |
| Доля cold start | Процент запросов, попавших на холодные воркеры | Обычно ниже после прогрева |
| Ожидание в очереди | Задержка очереди endpoint и давление concurrency | Очередь scheduler и ожидание batch |
| Использование GPU | Активное время воркера, если доступно | Использование вычислений и памяти GPU |
| Стоимость простоя | Обычно ниже, но проверьте минимумы | Основной риск стоимости |
| Частота повторов | Timeout, ошибки воркера, ошибки ёмкости | OOM, deploy, runtime, ошибки хоста |
| Часы инженеров | Интеграция и отладка endpoint | Операции платформы и работа с инцидентами |
Тест должен включать холодные условия, тёплые условия, всплески трафика, обычный трафик и восстановление после сбоев. Бенчмарк, который измеряет только тёплый throughput, не является решением для serverless GPU vs dedicated GPU; это лишь частичный тест скорости.
Чек-лист источников по провайдерам
Используйте официальные страницы как чек-листы источников, а не зафиксированные прайс-листы. Перепроверяйте их в день, когда утверждаете расходы.
| Провайдер/категория | Официальный источник для проверки | Что зафиксировать |
|---|---|---|
| RunPod Serverless | Обзор RunPod Serverless, Цены RunPod Serverless | Модель endpoint, поведение worker, база тарификации, поведение cold-start, хранилище, сеть, concurrency, логи, лимиты |
| RunPod Pods / dedicated style | Обзор RunPod Pods, Цены RunPod Pods, Цены RunPod | Модель GPU, secure/community mode, тарификация pod, хранилище, сетевой объём, ожидания по uptime |
| Modal | Документация Modal по GPU, Cold starts в Modal, Цены Modal | Тип GPU, жизненный цикл функции, управление cold-start, стратегия образа контейнера, тарификация активного использования |
| Google Cloud Run with GPUs | Настройка GPU в Cloud Run, Цены Cloud Run | Ограничения GPU-сервиса, min instances, concurrency, тарификация CPU/memory/GPU, влияние на задержку запросов |
| Google Compute Engine GPUs | Цены GPU в Compute Engine | Тип GPU, регион, стоимость VM, диск, сеть, reservations, committed use discounts |
| AWS EC2 GPU instances | Цены Amazon EC2 | On-Demand, Spot, Savings Plans, Reserved Instances, capacity blocks, хранилище, передача данных, support |
| Lambda Cloud | Lambda GPU Cloud | Тип инстанса, доступность, условия on-demand/reserved, хранилище, сеть, объём поддержки |
| Replicate deployments | Документация Replicate deployments | Параметры deployment, поведение масштабирования, варианты hardware, минимальное/максимальное число инстансов, пригодность для production endpoint |
Для этой статьи чек-лист источников был проверен 13 октября 2026.
Вопросы по закупке перед тем, как принять решение
Задайте их перед выбором serverless GPU vs dedicated GPU.
| Вопрос | Почему это важно |
|---|---|
| Каков знаменатель для принятых результатов? | Позволяет не сравнивать попытки запросов с успешными бизнес-результатами. |
| Как часто endpoint будет холодным? | Cold start могут доминировать в задержке и стоимости для нерегулярных нагрузок. |
| Сколько времени занимает загрузка модели? | Большие веса могут свести на нет экономию serverless. |
| Что происходит при пиковом параллелизме? | И serverless-очереди, и dedicated autoscaler требуют стресс-тестов. |
| Каков коэффициент простоя у dedicated GPU? | Неиспользуемая мощность — главный источник фиксированных затрат. |
| Можно ли безопасно повторять задания? | Для serverless и spot-подобных рабочих процессов нужна идемпотентность. |
| Нужен ли нам контроль над кастомным runtime? | Если нет, владение dedicated GPU может быть излишним. |
| Включены ли хранилище, egress, логи и поддержка? | GPU-вычисления — это лишь одна часть счёта. |
| Можно ли перенести нагрузку на model API? | Продукты с низкой загрузкой или несколькими моделями могут не оправдывать эксплуатацию GPU. |
| Каков путь выхода, если модель изменится? | Аппаратные обязательства становятся рискованными, когда меняется архитектура модели. |
Лучший пакет для закупки включает результат бенчмарка, таблицу cost-per-accepted-output и чёткое обоснование того, почему команде нужна либо serverless GPU capacity, ориентированная на потребление, либо controlled dedicated GPU capacity.
Когда model API лучше обоих вариантов
И serverless GPU, и dedicated GPU предполагают, что работа на уровне GPU полезна. Иногда это не так.
Управляемый model API или gateway может быть лучше, когда:
- Спрос неизвестен или имеет всплески.
- Продукту нужны несколько моделей, а не одна стабильная self-hosted модель.
- Команде нужны frontier или proprietary модели.
- Надёжность, fallback и разнообразие провайдеров важнее контроля над хостом.
- Финансам нужны журналы использования, бюджеты и один счёт.
- Время инженеров лучше потратить на поведение продукта, а не на GPU operations.
Flatkey подходит для этой стороны решения. Он даёт командам один OpenAI-compatible маршрут, один ключ, один баланс, один счёт, видимость использования и доступ к официальным model endpoints у разных провайдеров. Если таблица serverless GPU vs dedicated GPU показывает низкую загрузку, большие потери на cold start или слишком высокие операционные накладные расходы, сравните этот путь с сравнением цен на AI модели, сравнением цен на AI API и управлением расходами на AI API перед тем, как инвестировать в GPU-инфраструктуру.
Итоговая рекомендация
Используйте такую последовательность для решений serverless GPU vs dedicated GPU:
- Используйте serverless GPU для прототипов, всплесков нагрузки, асинхронных очередей и неопределённого спроса.
- Измеряйте cold start, задержку в очереди, частоту повторов и cost per accepted output.
- Переводите стабильные, высоконагруженные, чувствительные к задержке рабочие нагрузки на dedicated GPU capacity только после подтверждения высокой утилизации.
- Сохраняйте маршрут через model API, если выбор модели часто меняется, контроль над оборудованием не нужен или команде нужны более простое биллинг-учёт и fallback.
Serverless GPU vs dedicated GPU — это не универсальный выбор с одним победителем. Serverless GPU даёт гибкость и снижает риск простоя. Dedicated GPU даёт контроль и более тёплую capacity. Правильный ответ — тот, который обеспечивает вашей команде минимальную стоимость за принятый результат, при этом размещая задержку, надёжность и операционный риск там, где вы действительно можете ими управлять.
Часто задаваемые вопросы
Serverless GPU дешевле, чем dedicated GPU?
Serverless GPU дешевле, когда трафик низкий, всплесковый или неопределённый настолько, что dedicated GPU простаивали бы. Dedicated GPU дешевле, когда утилизация высокая, модель остаётся тёплой, а команда может эффективно обслуживать стек.
У serverless GPU всегда бывают cold start?
Не каждый запрос будет холодным, и провайдеры предлагают разные механизмы для тёплой capacity, минимального числа workers, оптимизации образов и масштабирования. Но cold start — это ключевой риск при оценке serverless GPU, потому что большим моделям и контейнерам может требоваться заметное время, чтобы стать полезными.
Когда следует перейти с serverless GPU на dedicated GPU?
Переходите, когда сможете доказать стабильный спрос, высокую утилизацию, неприемлемую задержку cold start, необходимость в контроле кастомного runtime или преимущество по cost-per-accepted-output после учёта операций и простоя.
Лучше ли dedicated GPU для LLM inference?
Dedicated GPU может быть лучше для стабильного LLM inference с высоким объёмом, особенно если вы настроите vLLM, SGLang, TensorRT-LLM, batching, поведение cache и загрузку модели. Для продуктов с низким объёмом, несколькими моделями или быстрыми изменениями model API может быть проще и дешевле.
Что следует измерить в первую очередь?
Измерьте принятые результаты, долю cold start, ожидание в очереди, p95/p99 latency, частоту повторов, полезную утилизацию GPU, стоимость простоя, storage/egress и часы инженеров. Эти метрики делают решение serverless GPU vs dedicated GPU обоснованным.


