
Надёжность и маршрутизация
Последние статьи в категории Надёжность и маршрутизация.
Доступ к Claude API вне одно-региональных конфигураций: руководство с приоритетом комплаенса
Руководство с приоритетом комплаенса по доступу к Claude API в разных регионах: прямой Anthropic, Bedrock, Vertex AI, шлюзы, тестирование, наблюдаемость и утверждённый failover.
Seedance 2.0 API в 2026: доступ, цены и резервная маршрутизация
Актуальное руководство по доступу к Seedance 2.0 API, проверке цен, асинхронным задачам и безопасной резервной маршрутизации между меняющимися версиями видеомоделей.
Контрольный список для production с Seedance API для команд text-to-video
Практический контрольный список для работы с заданиями Seedance text-to-video: надежные очереди, нормализованные статусы, безопасные повторные попытки, хранилище и контроль затрат.
Gemini API для ИИ-агентов: чек-лист интеграции в продакшен
Чек-лист для продакшен-агентов на базе Gemini: стабильные endpoints, управляемая смена моделей, безопасность инструментов, retries, fallback-маршрутизация и прозрачность затрат.
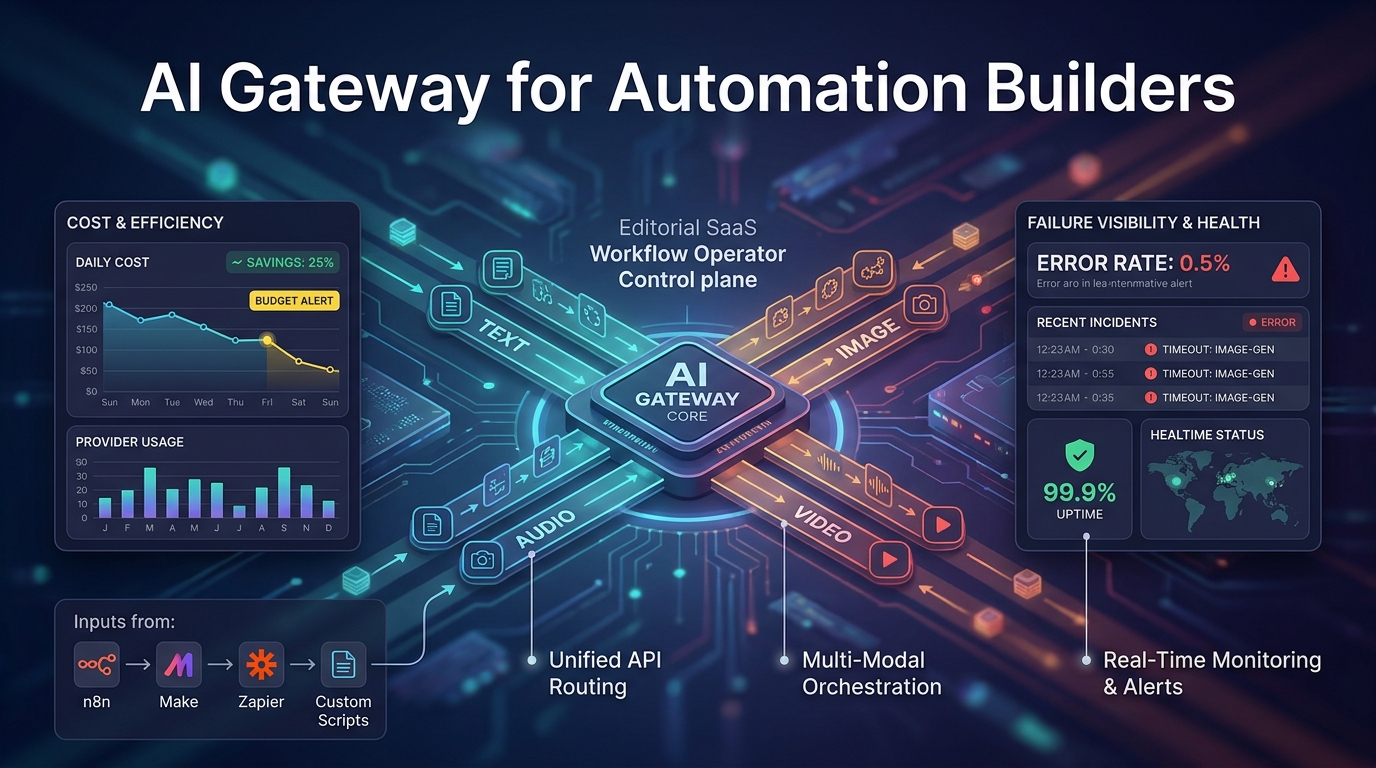
AI Gateway для создателей автоматизаций: fallback-маршрутизация, прозрачность затрат и один базовый URL
Почему разработчикам автоматизаций нужен один AI Gateway для стабильных базовых URL, более безопасной fallback-маршрутизации и более простого анализа затрат во workflows с большим объёмом запросов.

Тестирование качества резервных моделей: когда более дешёвые или быстрые модели не являются эквивалентными
Практический план тестирования качества резервных моделей, чтобы доказать, что более дешёвые или быстрые резервные модели сохраняют качество, стоимость, инструменты, политику и наблюдаемость до маршрутизации в production.

Пуллинг аккаунтов с несколькими upstream: проверки надежности перед совместным использованием трафика моделей
Производственный чек-лист для безопасного пуллинга аккаунтов с несколькими upstream в аккаунтах AI-моделей: проверки состояния, квоты, подтверждение биллинга и правила маршрутизации с fail-closed.

LLM-роутер: как работает маршрутизация моделей, стратегии и безопасный canary-релиз (2026)
Полное руководство по LLM-роутерам: принцип работы, отличие от LLM-шлюза, пять стратегий (правила, каскады, классификаторы), реальная экономия за счет разницы в ценах, рабочий код и пошаговый план canary-релиза.

Стратегия организации очередей для AI API: защита пользовательских процессов во время сбоев у провайдера
Практическое руководство по обеспечению надежности для защиты пользовательских рабочих процессов с ИИ с помощью каналов очередей, противодавления, резервных контрактов, правил для "мертвых писем" и доказательств маршрутизации.

Таксономия ошибок LLM-шлюза: разделение сбоев аутентификации, квот, провайдера и безопасности
Руководство по обеспечению надежности в продакшене для классификации сбоев LLM-шлюза по категориям: аутентификация, квоты, провайдер, запрос, безопасность и отмена, перед повторной попыткой или переключением на резервный вариант.

Превышен лимит запросов к API: что это значит и как исправить (2026)
Что означает ошибка API rate limit exceeded, как ведущие API применяют лимиты в 2026 году и как устранить проблему: Retry-After, экспоненциальная задержка с примерами на Python и Node, ограничители частоты, кеширование, очереди и повышение уровня обслуживания.

Стратегия тайм-аутов для API ИИ: бюджеты на соединение, чтение, потоковую передачу и очередь
Настройте бюджеты тайм-аутов для API ИИ в продакшене для соединения, чтения, потоковой передачи, очереди, повторных попыток, резервных вариантов и наблюдаемости, прежде чем инциденты станут дорогостоящими.
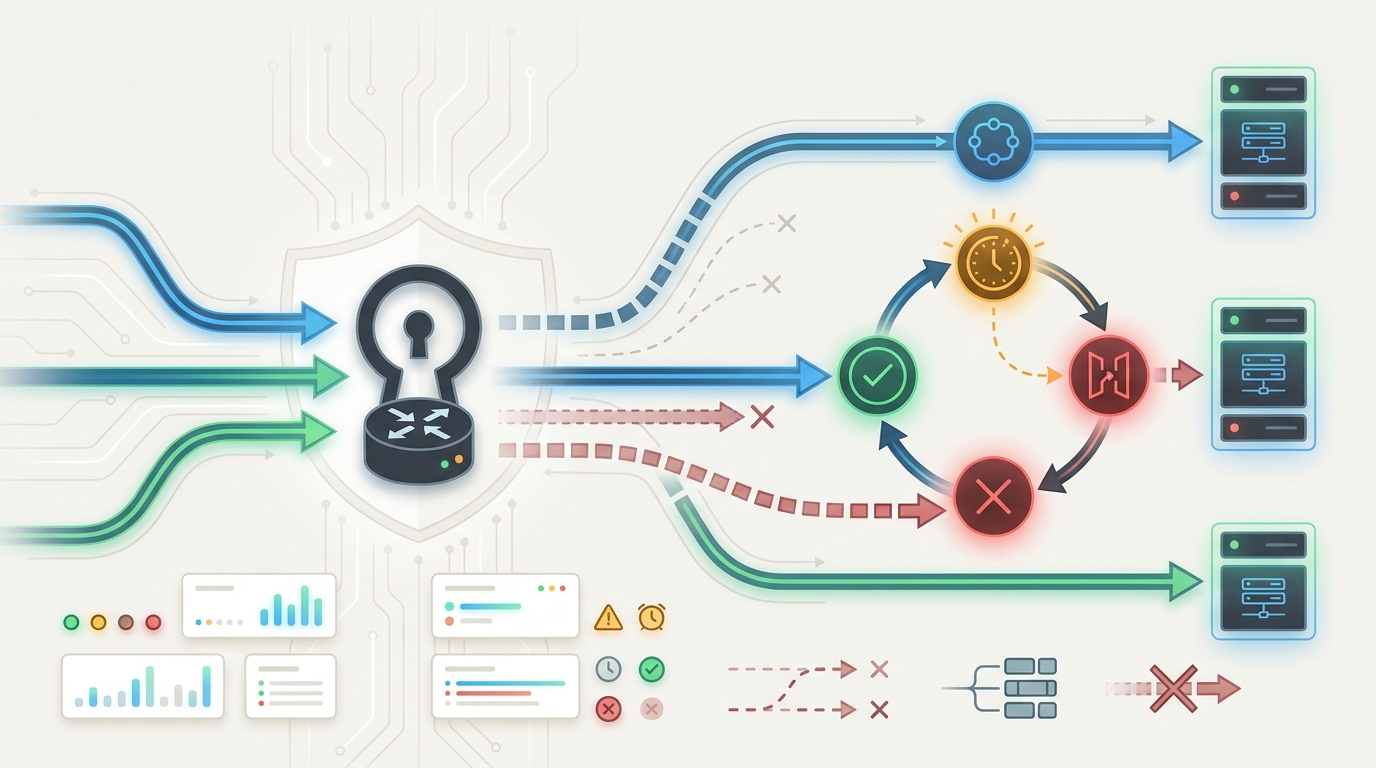
Автоматические выключатели для LLM API-шлюзов: защита приложений от циклов сбоев провайдера
Используйте автоматический выключатель в LLM API-шлюзе, чтобы остановить циклы сбоев провайдера, классифицировать ошибки, защитить повторные попытки и направлять запросы на резервный путь, в очередь или в режим fail closed.
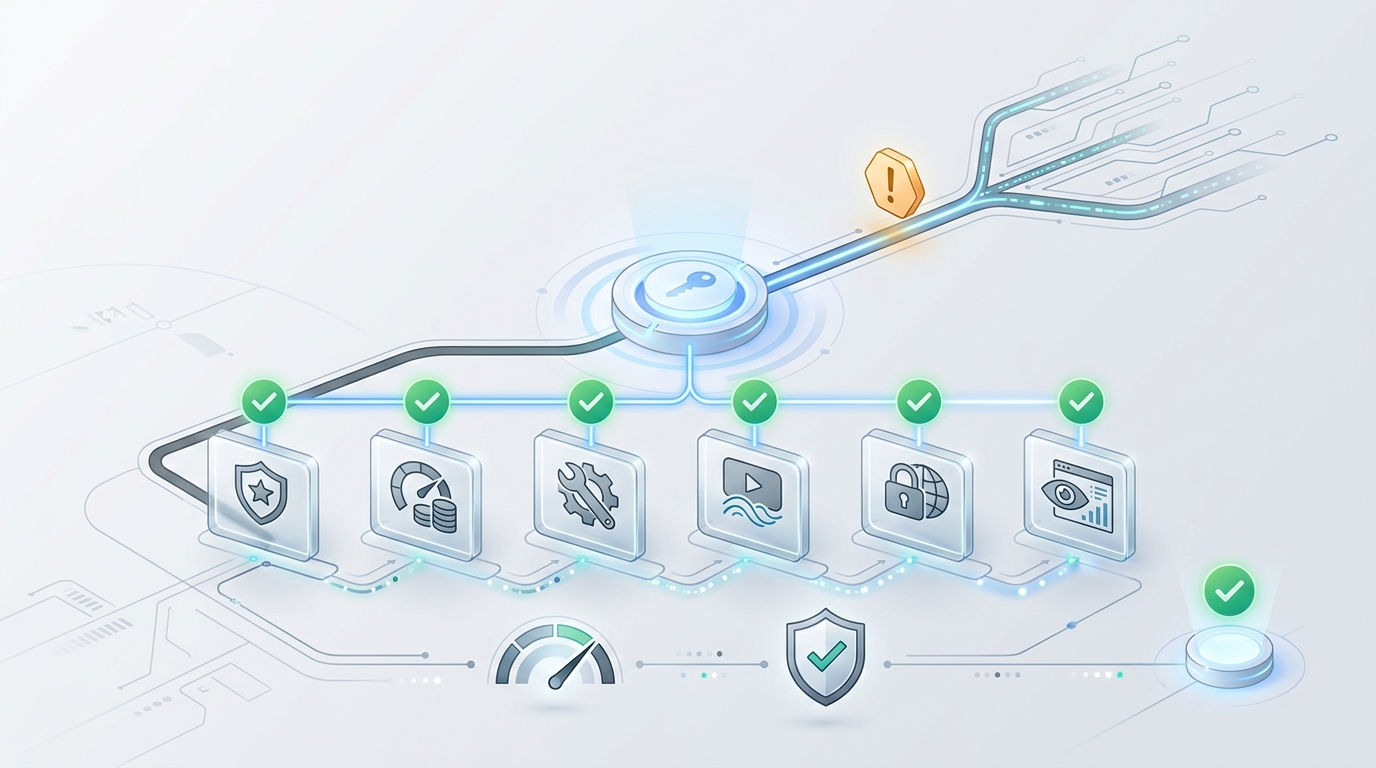
Контрольный список для fallback-модели: качество, стоимость, инструменты и границы соответствия
Используйте этот контрольный список для fallback-модели, чтобы оценить качество, стоимость, инструменты, потоковую передачу, соответствие требованиям, логи и откат перед автоматическим fallback в AI gateway.
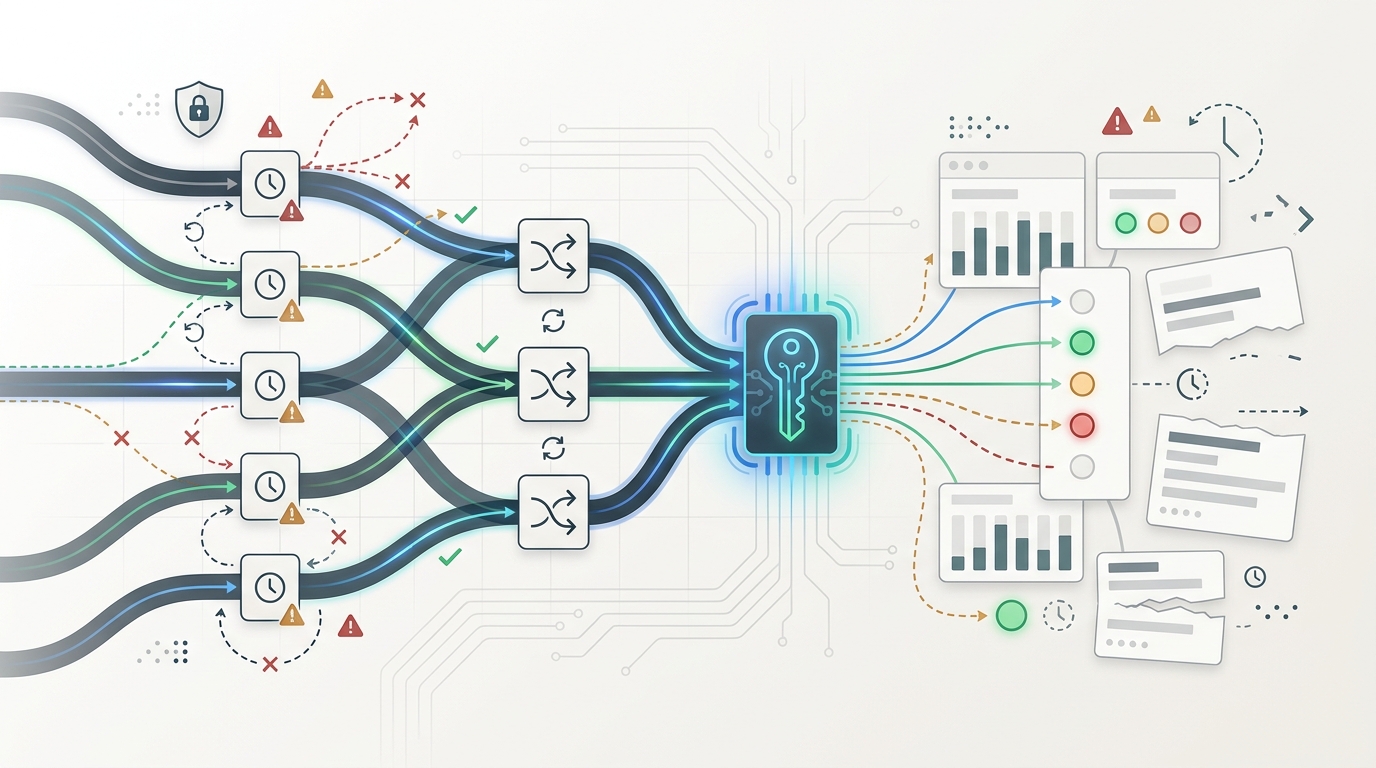
Надежность streaming AI API: SSE, таймауты и отказы на уровне router
Используйте тесты надежности streaming AI API, чтобы до запуска в production выявлять зависания SSE, таймауты proxy, частичные ответы, риски retries и пробелы в router failover.
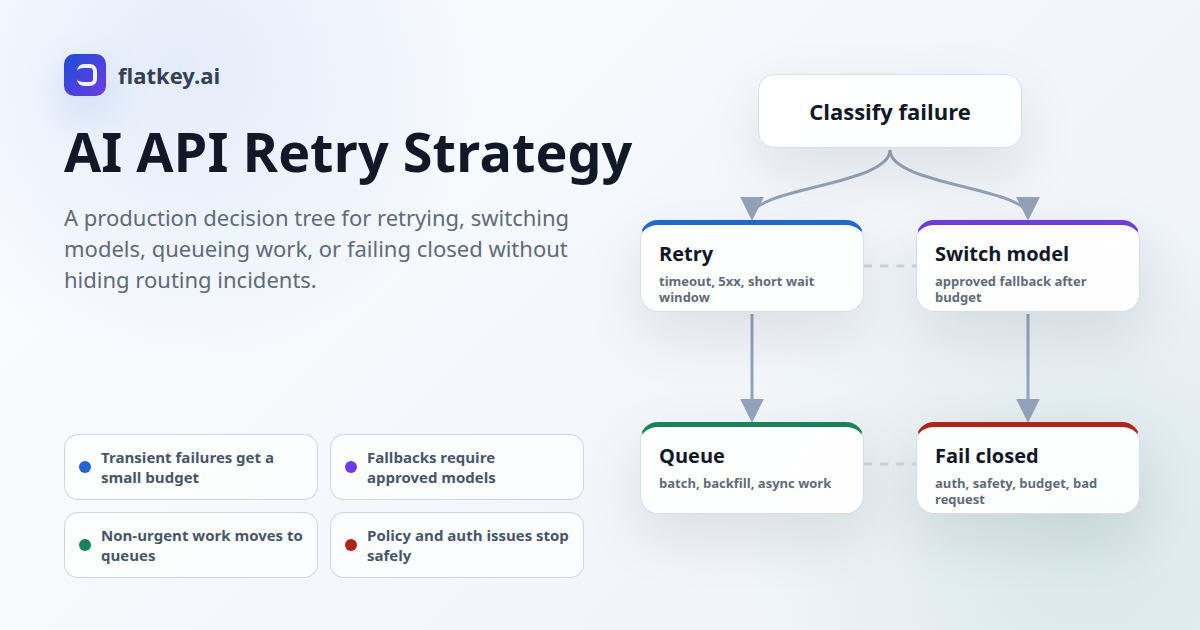
Стратегия повторных попыток для AI API: когда повторять, переключать модели, ставить в очередь или завершать с ошибкой
Используйте стратегию повторных попыток для AI API, чтобы решать, когда повторять запрос, переключать модели, ставить работу в очередь или завершать с ошибкой, не скрывая инциденты с квотами, авторизацией или маршрутизацией.
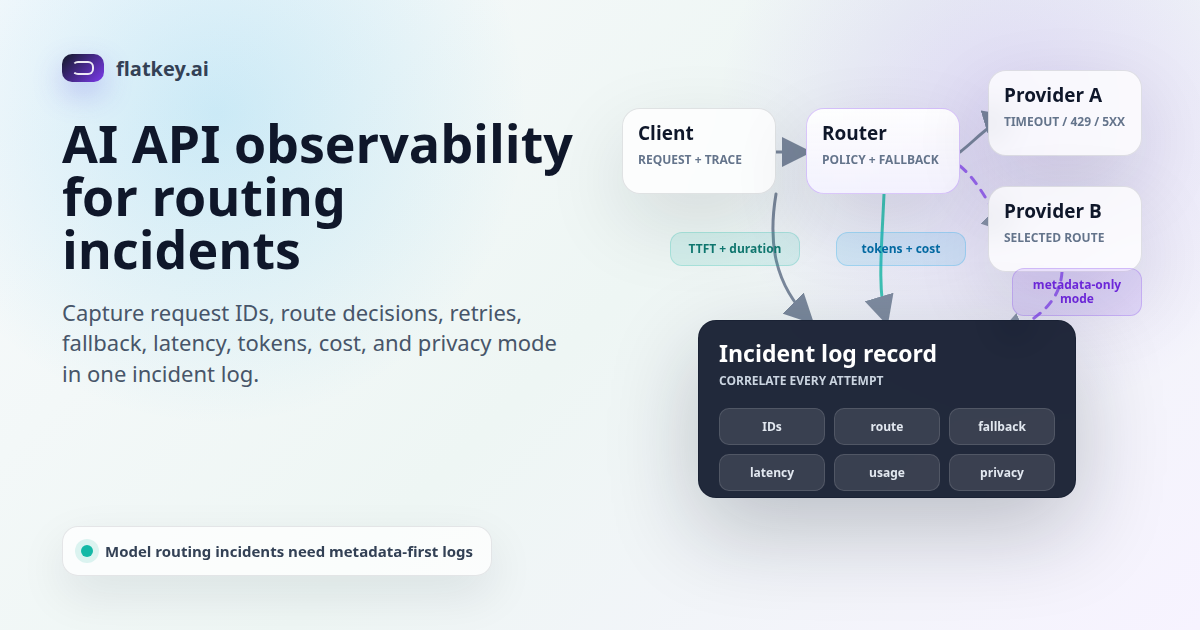
Платформы наблюдаемости ИИ: что они делают и как выбрать (2026)
Платформы наблюдаемости ИИ записывают промпты, токены, затраты, шаги агентов и оценки качества. Сравните Langfuse, LangSmith, Arize, Datadog, Helicone, Braintrust и Logfire по функциям и ценам на октябрь 2026 года, с примерами кода OpenTelemetry.
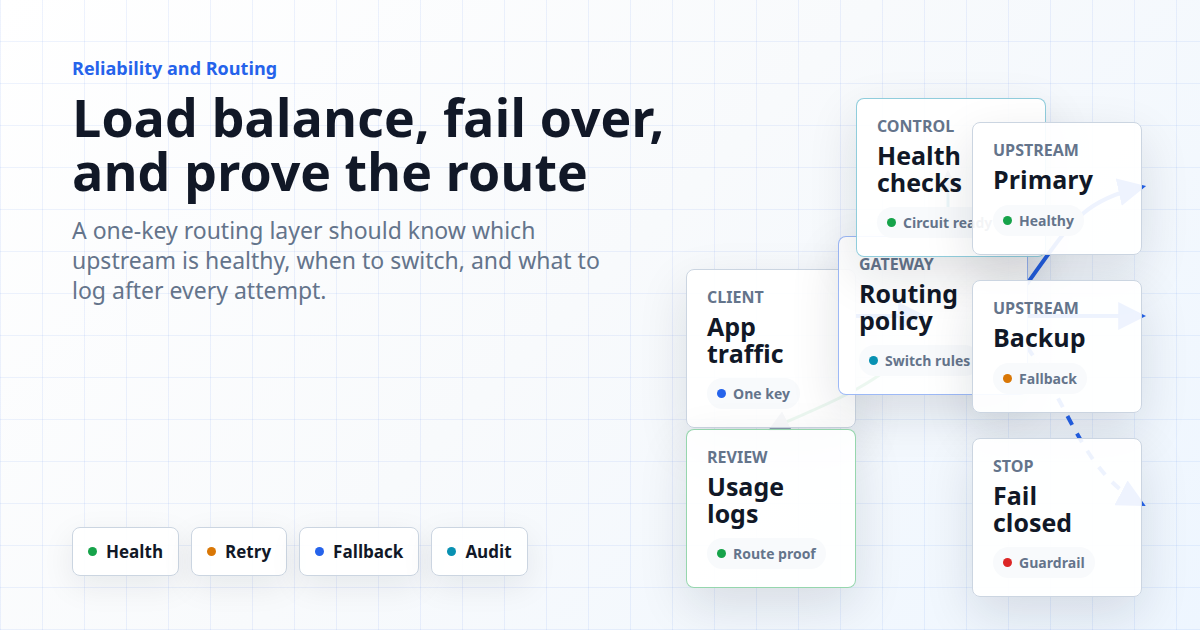
Балансировка нагрузки и отказоустойчивость AI API за одним ключом
Планируйте балансировку нагрузки и отказоустойчивость AI API с правилами маршрутизации, проверками состояния, путями повторных попыток, журналами использования, квотами, тестами отката и шлюзами с одним ключом.
Запускайте быстрее с единым AI-шлюзом.
Используйте flatkey.ai, чтобы управлять моделями, ключами, биллингом и наблюдаемостью на одной API-платформе.
Начать