Платформы наблюдаемости ИИ: что они делают и как выбрать (2026)
Платформа наблюдаемости ИИ (AI observability) записывает каждый вызов модели, шаг агента и вызов инструмента в вашем приложении (промпт, ответ, токены, стоимость, задержку и ошибки), чтобы вы могли отлаживать, оценивать и контролировать расходы в продакшене. Ведущие варианты на октябрь 2026 года: Langfuse, LangSmith, Arize (Phoenix и AX), Datadog LLM Observability, Helicone, Braintrust и Pydantic Logfire; большинство из них принимает трассировки OpenTelemetry. Выбирайте исходя из того, где должны храниться ваши данные, как вы оцениваете качество и сколько готовы платить за трассировку.
В этом руководстве объясняется, что такое наблюдаемость ИИ, какие сигналы собирать, как основные платформы соотносятся по функциям и опубликованным ценам и как инструментировать приложение менее чем за 30 строк кода. Цены взяты с официальных страниц тарифов каждого поставщика по состоянию на 24 октября 2026 года.
Что такое наблюдаемость ИИ?
Наблюдаемость ИИ — это практика сбора трассировок, метрик, логов и оценок качества из ИИ-систем, позволяющая в любой момент ответить на три вопроса: Что сделала модель? Был ли ответ хорошим? Сколько это стоило? Она расширяет классический мониторинг приложений, который отслеживает доступность и задержку, сигналами, важными только для языковых моделей:
- Входы и выходы: промпт, извлечённый контекст и сгенерированный ответ.
- Расход токенов и стоимость: входные, выходные и кэшированные токены по запросу, пользователю и функции.
- Трассировки агентов: каждый шаг рассуждения, вызов инструмента и повтор в многошаговом выполнении.
- Качество: оценки автоматических оценщиков, отзывы пользователей и отметки о галлюцинациях или нарушениях политик.
- Метаданные модели и провайдера: какая модель ответила, по какому маршруту и с какими параметрами.
Традиционный мониторинг сообщит, что запрос выполнялся 9 секунд. Наблюдаемость ИИ объяснит, что он выполнялся 9 секунд, потому что агент трижды вызвал инструмент поиска, второй вызов модели получил ошибку 429, а резервная модель выдала ответ, не прошедший вашу проверку обоснованности (groundedness).
Мониторинг, наблюдаемость и оценка: в чём разница
| Практика | На какой вопрос отвечает | Типичный результат |
|---|---|---|
| Мониторинг | Работает ли система и укладывается ли в пороги? | Дашборды, алерты по задержке и доле ошибок |
| Наблюдаемость | Почему именно этот запрос повёл себя так? | Трассировки с промптами, вызовами инструментов, токенами и метаданными |
| Оценка | Корректен ли, безопасен и полезен ли результат? | Оценки по тестам, LLM-судьям или ручной проверке |
Современная платформа наблюдаемости ИИ объединяет все три подхода. Рамочная программа NIST по управлению рисками ИИ также подчёркивает необходимость постоянного измерения и мониторинга развёрнутых ИИ-систем, поэтому многие команды по управлению (governance) теперь требуют такие записи.
Открытый стандарт: соглашения OpenTelemetry GenAI
Для сбора ИИ-телеметрии больше не нужен проприетарный SDK. OpenTelemetry определяет семантические соглашения для генеративного ИИ, задающие стандартные атрибуты вызовов моделей. На октябрь 2026 года эти соглашения поддерживаются в отдельном репозитории semantic-conventions-genai и по-прежнему имеют статус «Development», поэтому некоторые названия ещё могут измениться.
| Атрибут | Значение |
|---|---|
gen_ai.operation.name |
Операция, например chat или embeddings (обязательный) |
gen_ai.provider.name |
Провайдер, например openai или anthropic (обязательный) |
gen_ai.request.model |
Модель, запрошенная вашим кодом |
gen_ai.response.model |
Модель, которая фактически ответила |
gen_ai.usage.input_tokens / gen_ai.usage.output_tokens |
Количество токенов |
gen_ai.response.finish_reasons |
Причина остановки генерации |
gen_ai.conversation.id |
Группирует реплики одного диалога |
Один раз инструментируйте код с этими атрибутами — и сможете отправлять те же трассировки в Langfuse, Arize Phoenix, Datadog, Logfire, Grafana Tempo или любой другой OTLP-совместимый бэкенд. Передача контекста между сервисами выполняется по стандарту W3C Trace Context.
Сравнение платформ наблюдаемости ИИ
| Платформа | Развёртывание | Сильные стороны | Опубликованная стартовая цена (окт. 2026) |
|---|---|---|---|
| Langfuse | Открытый код (self-host) или облако | Трассировка, управление промптами, оценки; ядро под лицензией MIT | Hobby бесплатно (50 тыс. единиц/мес.); Core $29/мес.; Pro $199/мес. |
| LangSmith | Облако, гибрид или self-host в Enterprise | Глубокая интеграция с LangChain и LangGraph, оценки | Developer $0/место (5 тыс. базовых трассировок); Plus $39/место |
| Arize Phoenix и AX | Phoenix с открытым кодом; AX в облаке | Нативная трассировка OTel, оценки, анализ дрейфа | Phoenix бесплатно при self-host; AX Pro $50/мес. (50 тыс. спанов) |
| Datadog LLM Observability | Облако (часть Datadog) | Связывает трассировки LLM с APM, логами и инфраструктурой | По использованию; расчёт через Datadog |
| Helicone | Облако или self-host | Логирование через прокси одной строкой настройки, кэширование | Hobby бесплатно (10 тыс. запросов); Pro $79/мес.; Team $799/мес. |
| Braintrust | Облако | Процесс, ориентированный на оценку, эксперименты, скоринг | Starter $0 (1 ГБ обработки, 10 тыс. оценок); Pro $249/мес. |
| Pydantic Logfire | Облако | Универсальная OTel-наблюдаемость с сильной поддержкой Python и агентов | Personal бесплатно (10 млн записей/мес.); Team $49/мес. |
Как читать эту таблицу:
- Данные должны оставаться в вашей среде? Начните с Langfuse или Arize Phoenix — оба можно развернуть у себя.
- Уже платите за Datadog? Его продукт LLM Observability держит ИИ-трассировки рядом с вашим APM и логами.
- Работаете на LangChain или LangGraph? LangSmith требует минимальной настройки.
- Главный приоритет — оценка качества? Braintrust и LangSmith лидируют по экспериментам и процессам скоринга.
- Нужно обойтись без изменений кода? Инструменты-прокси вроде Helicone или логи вашего ИИ-шлюза собирают трафик на сетевом уровне.
На что смотреть при выборе платформы наблюдаемости ИИ
Используйте этот чек-лист во время пробного периода:
- Поддержка OpenTelemetry. Может ли платформа принимать трассировки OTLP с атрибутами
gen_ai.*и можно ли экспортировать данные обратно? - Трассировка агентов и инструментов. Показывает ли она вложенные спаны для каждого шага, вызова инструмента и повтора, а не только финальный вызов модели?
- Учёт затрат. Рассчитывает ли она стоимость каждого запроса по токенам и вашим реальным ценам, включая кэшированные токены и скидки на пакетную обработку?
- Оценки. Можно ли запускать автоматические проверки (LLM-судья, регулярные выражения, эталонные ответы) на продакшен-трассировках и получать алерты при падении оценок?
- Контроль приватности. Можно ли маскировать или хешировать промпты, задавать сроки хранения и ограничивать доступ к исходному содержимому?
- Единица тарификации. Поставщики берут плату за трассировку, спан, «единицу», ГБ или место. Перед сравнением оцените свой месячный объём в каждой единице.
- Self-hosting. Если речь о регулируемых данных, убедитесь, что есть вариант с развёртыванием у себя, и узнайте стоимость его эксплуатации.
Инструментирование вызова LLM на Python с OpenTelemetry
Этот пример записывает один chat completion со стандартными атрибутами GenAI и экспортирует его в любой OTLP-эндпоинт (Langfuse, Phoenix, Logfire или локальный коллектор). Модели вызываются через OpenAI-совместимый эндпоинт, поэтому один и тот же код работает с GPT, Claude, Gemini или DeepSeek.
pip install openai opentelemetry-sdk opentelemetry-exporter-otlp
export OTEL_EXPORTER_OTLP_ENDPOINT="http://localhost:4318"   # your collector or vendor endpoint
export FLATKEY_API_KEY="sk-..."
import os, time
from openai import OpenAI
from opentelemetry import trace
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporter

provider = TracerProvider()
provider.add_span_processor(BatchSpanProcessor(OTLPSpanExporter()))
trace.set_tracer_provider(provider)
tracer = trace.get_tracer("support-bot")

client = OpenAI(api_key=os.environ["FLATKEY_API_KEY"],
                base_url="https://router.flatkey.ai/v1")

def answer(question: str, model: str = "claude-sonnet-5-5") -> str:
    with tracer.start_as_current_span(f"chat {model}") as span:
        span.set_attribute("gen_ai.operation.name", "chat")
        span.set_attribute("gen_ai.provider.name", "flatkey")
        span.set_attribute("gen_ai.request.model", model)
        t0 = time.time()
        r = client.chat.completions.create(
            model=model, max_tokens=300,
            messages=[{"role": "user", "content": question}])
        span.set_attribute("gen_ai.response.model", r.model)
        span.set_attribute("gen_ai.usage.input_tokens", r.usage.prompt_tokens)
        span.set_attribute("gen_ai.usage.output_tokens", r.usage.completion_tokens)
        span.set_attribute("gen_ai.response.finish_reasons", [r.choices[0].finish_reason])
        span.set_attribute("app.latency_ms", int((time.time() - t0) * 1000))
        return r.choices[0].message.content

print(answer("How do I reset my password?"))
provider.shutdown()  # flush spans before exit
В Node.js схема та же, с @opentelemetry/sdk-node:
import OpenAI from "openai";
import { trace } from "@opentelemetry/api";

const tracer = trace.getTracer("support-bot");
const client = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

export async function answer(question, model = "gpt-6.1-sol") {
  return tracer.startActiveSpan(`chat ${model}`, async (span) => {
    span.setAttributes({ "gen_ai.operation.name": "chat", "gen_ai.request.model": model });
    const r = await client.chat.completions.create({ model, messages: [{ role: "user", content: question }] });
    span.setAttributes({
      "gen_ai.response.model": r.model,
      "gen_ai.usage.input_tokens": r.usage.prompt_tokens,
      "gen_ai.usage.output_tokens": r.usage.completion_tokens,
    });
    span.end();
    return r.choices[0].message.content;
  });
}
Не помещайте тела промптов и ответов в атрибуты спанов, если это не разрешено вашей политикой конфиденциальности; многие команды вместо этого логируют хеш или обезличенную копию. В нашем руководстве по логированию payload описаны шаблоны маскирования.
Ваш ИИ-шлюз — тоже источник наблюдаемости
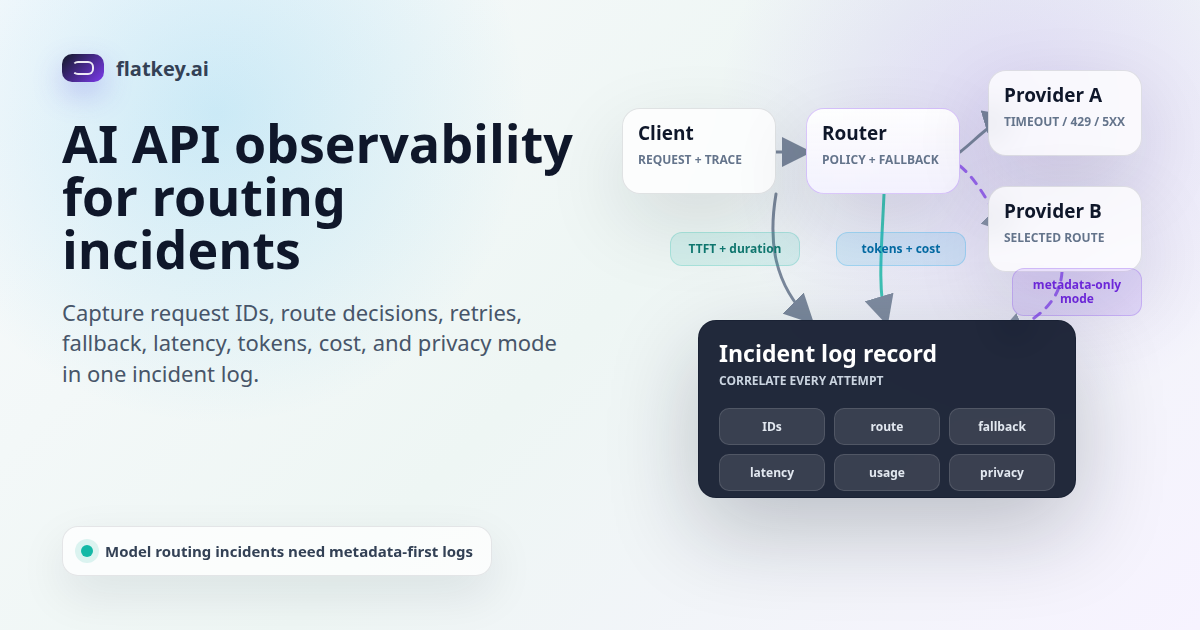
Если приложение вызывает модели через ИИ-шлюз или роутер, шлюз уже видит каждый запрос, поэтому начинать с него дешевле всего. Он собирает данные даже по сервисам, которые ещё не инструментированы. Например, логи использования Flatkey фиксируют для каждого вызова время, модель, входные и выходные токены, стоимость, замаскированный API-ключ и статус; их можно экспортировать в CSV или JSON, а также задавать месячные лимиты расходов и квоты по группам (документация Flatkey по использованию, октябрь 2026 года).
Практичная схема сочетает оба уровня:
| Уровень | Что он видит лучше всего | Пример использования |
|---|---|---|
| Логи шлюза | Каждый вызов модели, стоимость, статус, ошибки провайдера, фолбэки | Расходы по ключу или команде, доля 429 и 5xx, сбои провайдеров |
| Трассировки приложения | Бизнес-контекст, шаги агента, извлечение данных, вызовы инструментов | Почему запрос конкретного пользователя завершился ошибкой или плохим ответом |
| Оценки | Качество ответов во времени | Выявление регрессий после смены промпта или модели |
Свяжите оба уровня общим идентификатором запроса: передавайте trace ID в заголовке или поле метаданных при каждом вызове модели, чтобы переходить от строки лога шлюза к полной трассировке приложения. Рекомендуемый набор метрик см. в статье наблюдаемость LLM API: метрики, трассировки и затраты, а компоновку графиков — в KPI-дашборде ИИ-шлюза.
Метрики, которые важны в продакшене
| Метрика | Почему важна | Идея алерта |
|---|---|---|
| Задержка p50 / p95 по моделям | Пользователи ощущают хвостовую задержку | p95 выше SLO в течение 10 минут |
| Время до первого токена | Качество стриминга | Рост TTFT у одного провайдера |
| Доля ошибок по статусам (429, 5xx, таймаут) | Проблемы провайдера или квот | Доля 429 выше 2% |
| Доля фолбэков | Скрытые проблемы надёжности | Число фолбэков удвоилось за сутки |
| Стоимость на запрос и на пользователя | Контроль бюджета | Дневные расходы выше прогноза |
| Токены на запрос | Раздутые промпты и неконтролируемые агенты | Выполнения агентов сверх лимита токенов |
| Оценка качества | Регрессии качества | Падение оценки после деплоя |
Распределяйте затраты по командам и окружениям, чтобы у финансового отдела были ответы; схемы тегирования описаны в руководстве по атрибуции затрат и статье об учёте затрат по окружениям. План внедрения — в чек-листе внедрения наблюдаемости ИИ.
Частые вопросы
Что такое наблюдаемость ИИ?
Наблюдаемость ИИ — это сбор трассировок, метрик, логов и оценок качества из ИИ-приложений, позволяющий понять, что сделала модель или агент, был ли результат хорошим и сколько он стоил. Она добавляет к традиционному мониторингу промпты, токены, вызовы инструментов и оценки.
Какая платформа наблюдаемости ИИ лучшая?
Единственной лучшей платформы нет. Langfuse и Arize Phoenix подойдут командам, которым нужны открытый код и self-hosting, LangSmith — пользователям LangChain, Datadog — командам, уже работающим с Datadog, а Braintrust — процессам с упором на оценку. Протестируйте два варианта на собственных трассировках.
Есть ли бесплатная платформа наблюдаемости ИИ?
Да. На октябрь 2026 года бесплатны Langfuse Hobby (50 тыс. единиц в месяц), LangSmith Developer (5 тыс. базовых трассировок), Helicone Hobby (10 тыс. запросов), Braintrust Starter и Logfire Personal (10 млн записей), а Langfuse и Arize Phoenix можно развернуть у себя без платы за лицензию.
Чем мониторинг LLM отличается от наблюдаемости ИИ?
Мониторинг отслеживает заранее заданные пороги, например задержку и долю ошибок. Наблюдаемость позволяет детально исследовать любой отдельный запрос, включая промпты, вызовы инструментов, расход токенов и оценки качества.
Работает ли наблюдаемость ИИ с OpenTelemetry?
Да. Семантические соглашения OpenTelemetry GenAI определяют стандартные атрибуты, такие как gen_ai.request.model и gen_ai.usage.input_tokens, и большинство платформ принимает трассировки OTLP. На октябрь 2026 года соглашения всё ещё имеют статус Development.
Что такое наблюдаемость генеративного ИИ?
Это та же практика применительно к генеративным моделям: сбор промптов, выходных данных, затрат на токены, шагов агентов и результатов оценки, чтобы команды могли отлаживать и улучшать функции генеративного ИИ в продакшене.
Источники
- Семантические соглашения OpenTelemetry GenAI (октябрь 2026 года)
- Цены Langfuse, цены LangSmith, цены Arize, цены Helicone, цены Braintrust, цены Logfire (все проверены 24 октября 2026 года)
- Документация Datadog LLM Observability (октябрь 2026 года)
- Arize Phoenix на GitHub и Langfuse на GitHub
- Рамочная программа NIST по управлению рисками ИИ