
Блог flatkey.ai
Идеи, заметки о продукте и руководства по внедрению для команд, создающих продукты на AI API.
Архитектура ИИ-шлюзов
Последние статьи в категории Архитектура ИИ-шлюзов.
Читать дальшеМиграция базового URL и SDK
Последние статьи в категории Миграция базового URL и SDK.
Читать дальшеЗатраты, оплата и эксплуатация
Последние статьи в категории Затраты, оплата и эксплуатация.
Читать дальшеКорпоративный контроль и доверие
Последние статьи в категории Корпоративный контроль и доверие.
Читать дальшеСравнение шлюзов
Последние статьи в категории Сравнение шлюзов.
Читать дальшеРуководства по моделям и модальностям
Последние статьи в категории Руководства по моделям и модальностям.
Читать дальшеНадёжность и маршрутизация
Последние статьи в категории Надёжность и маршрутизация.
Читать дальшеИнтеграции инструментов
Последние статьи в категории Интеграции инструментов.
Читать дальше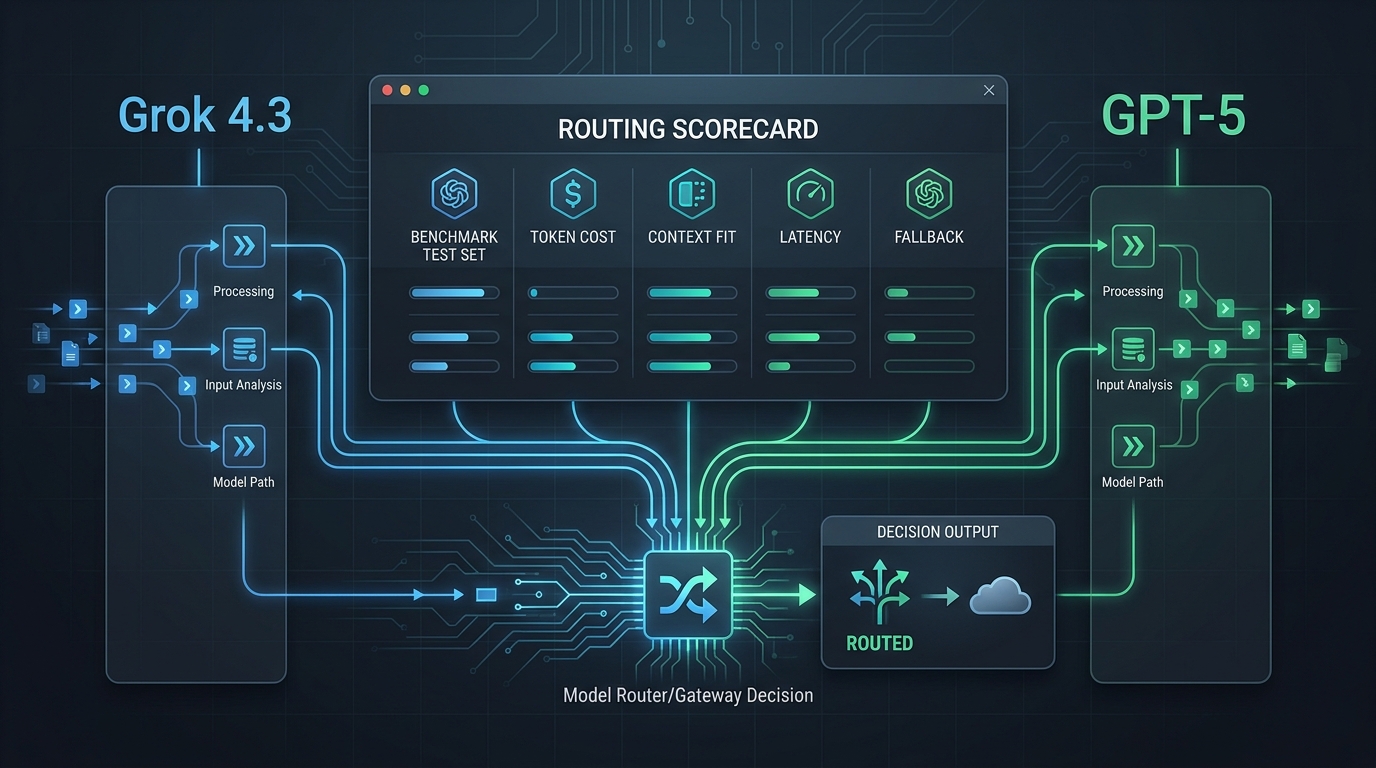
Grok 4.3 vs GPT-5: бенчмарки, цены и выбор модели для маршрутизации
Руководство по маршрутизации с опорой на источники для команд, сравнивающих Grok 4.3 и GPT-5 по ценам, контексту, методике бенчмарков, срокам миграции и необходимости использования шлюза.

Аренда GPU-сервера: архитектура, производительность и руководство по развёртыванию в облаке
Узнайте, как арендовать GPU-сервер с правильным распределением ресурсов, проверкой топологии, этапами развёртывания и приёмочными тестами перед резервированием мощностей.

Стоечный GPU-сервер: архитектура, производительность и руководство по облачному развертыванию
Практическое руководство по планированию, проверке и развертыванию стоечных GPU-мощностей для ИИ-нагрузок.

Руководство по API удаления PII (2026): сравнение AWS, Google Cloud, Azure и Presidio для LLM-приложений
API удаления PII находит и маскирует персональные данные в тексте. Сравниваем Amazon Comprehend, Google Sensitive Data Protection, Azure Language PII и Presidio: примеры кода, единицы тарификации, реальные результаты обнаружения и конвейер обезличивания для LLM.
Спекулятивное декодирование для инференса LLM: прирост пропускной способности и компромиссы
Практическое руководство по спекулятивному декодированию для инференса LLM: как оно работает, когда помогает, чем отличаются EAGLE и Medusa и что измерить перед внедрением.

Инференс и обучение ИИ: производительность, стоимость и компромиссы при развертывании
Инференс и обучение ИИ: сравнение метрик производительности, факторов стоимости, требований к развертыванию и случаев, когда стоит дообучать модель или запускать её в продакшене.

Что такое маршрутизация LLM? Правила, веса и политики с учетом затрат
Что такое маршрутизация LLM? Узнайте, как правила, взвешенные оценки, фильтры возможностей, резервные варианты и оценка делают API с несколькими моделями надежнее.

Развертывание vLLM Expert Parallel для DeepSeek и других моделей MoE
Разверните vLLM expert parallel для DeepSeek и других моделей MoE с правильными флагами, топологией, проверками бэкенда и тестами запуска.

vLLM Docker: архитектура, производительность и руководство по облачному развёртыванию
Руководство по развёртыванию vLLM Docker на облачных GPU: архитектура, OpenAI-совместимая настройка, оптимизация производительности, масштабирование на несколько GPU и проверка готовности к продакшену.

Единый API для ИИ-моделей: один ключ, endpoint и биллинг
Практическое руководство по единому API для консолидации доступа к моделям, ключей, endpoint’ов, использования, биллинга, маршрутизации и fallback без потери нативных возможностей провайдеров.
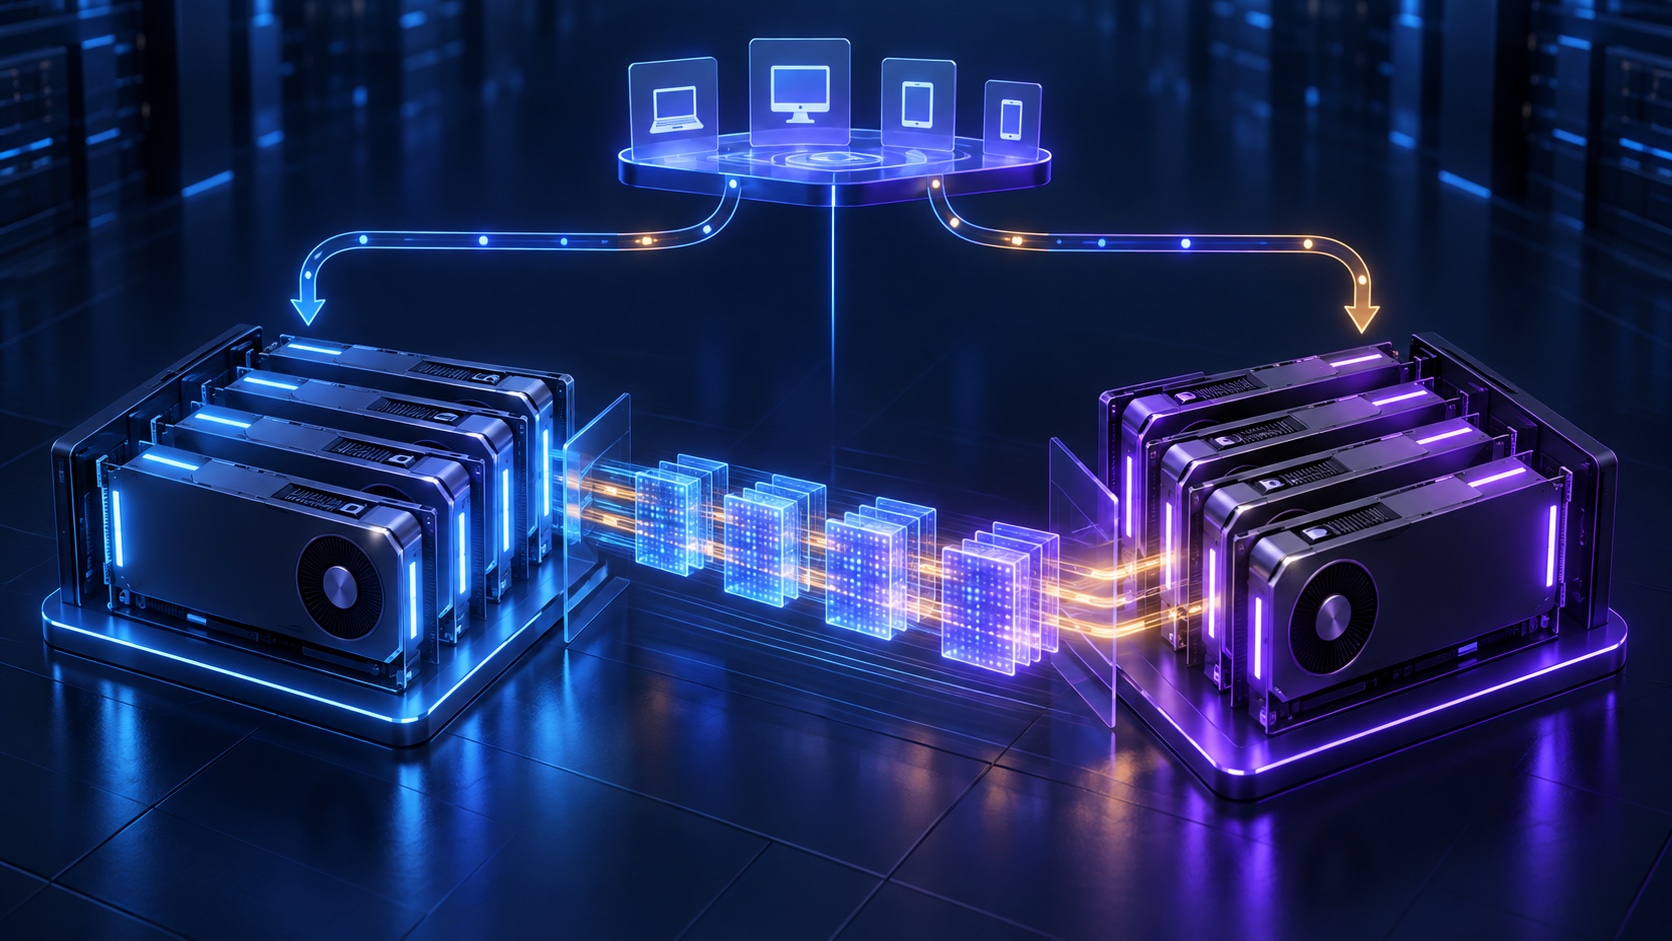
Дезагрегация prefill и decode в SGLang: архитектура и руководство по развертыванию
Разверните дезагрегацию prefill и decode в SGLang: отдельные пулы GPU, передача KV-кэша, метрики валидации, выбор топологии и проверки запуска.

Заметки по архитектуре

Стоимость self-hosted LLM на миллион токенов: воспроизводимая модель затрат на GPU
Воспроизводимая модель расчёта стоимости обслуживания self-hosted LLM на основе полной стоимости GPU-мощностей, принятой пропускной способности, загрузки и качества.

Perplexity AI API: доступ, цены, интеграция и руководство по продакшену
Практическое руководство с опорой на источники: как выбрать подходящий API-интерфейс Perplexity, правильно его интегрировать, оценить затраты и безопасно использовать в продакшене.

Базовый URL OpenAI API (2026): прямые и совместимые эндпоинты
Официальный базовый URL OpenAI API, распространённые пути эндпоинтов, настройка совместимости с Flatkey, примеры кода и исправления ошибок дублирования /v1 или 404.

Стоимость OpenAI API в 2026 году: таблица цен и калькулятор
Актуальное руководство по стоимости OpenAI API с таблицами цен GPT-6, копируемым калькулятором, примерами расчётов, скрытыми комиссиями и проверками оптимизации.

Как получить API-ключ OpenAI и исправить ошибку 401 «Недопустимый API-ключ»
Безопасная диагностика ошибок OpenAI 401 с недопустимым API-ключом: неверные эндпоинты, устаревшие секреты, отозванные ключи, настройки проектов и разрешённые IP-адреса.
Бесплатный API-ключ OpenAI? Лимиты, стоимость и компромиссы в продакшене
API-ключ OpenAI — это учётные данные, а не гарантированный бесплатный бюджет для продакшена. Перед запуском проверьте условия доступа, кредиты, лимиты, стоимость и контроль расходов.
Запускайте быстрее с единым AI-шлюзом.
Используйте flatkey.ai, чтобы управлять моделями, ключами, биллингом и наблюдаемостью на одной API-платформе.
Начать