Пояснение лимитов запросов к LLM: RPM, TPM и повторные попытки — это в первую очередь тема надежности продакшена, а уже потом настройка SDK. Лимиты определяют, сколько запросов, токенов, задач или одновременных генераций ваше приложение может пропустить через провайдера или gateway за заданный промежуток времени. Повторные попытки определяют, что происходит, когда лимит достигнут. Неправильная политика ретраев может превратить небольшой всплеск в длительный сбой.
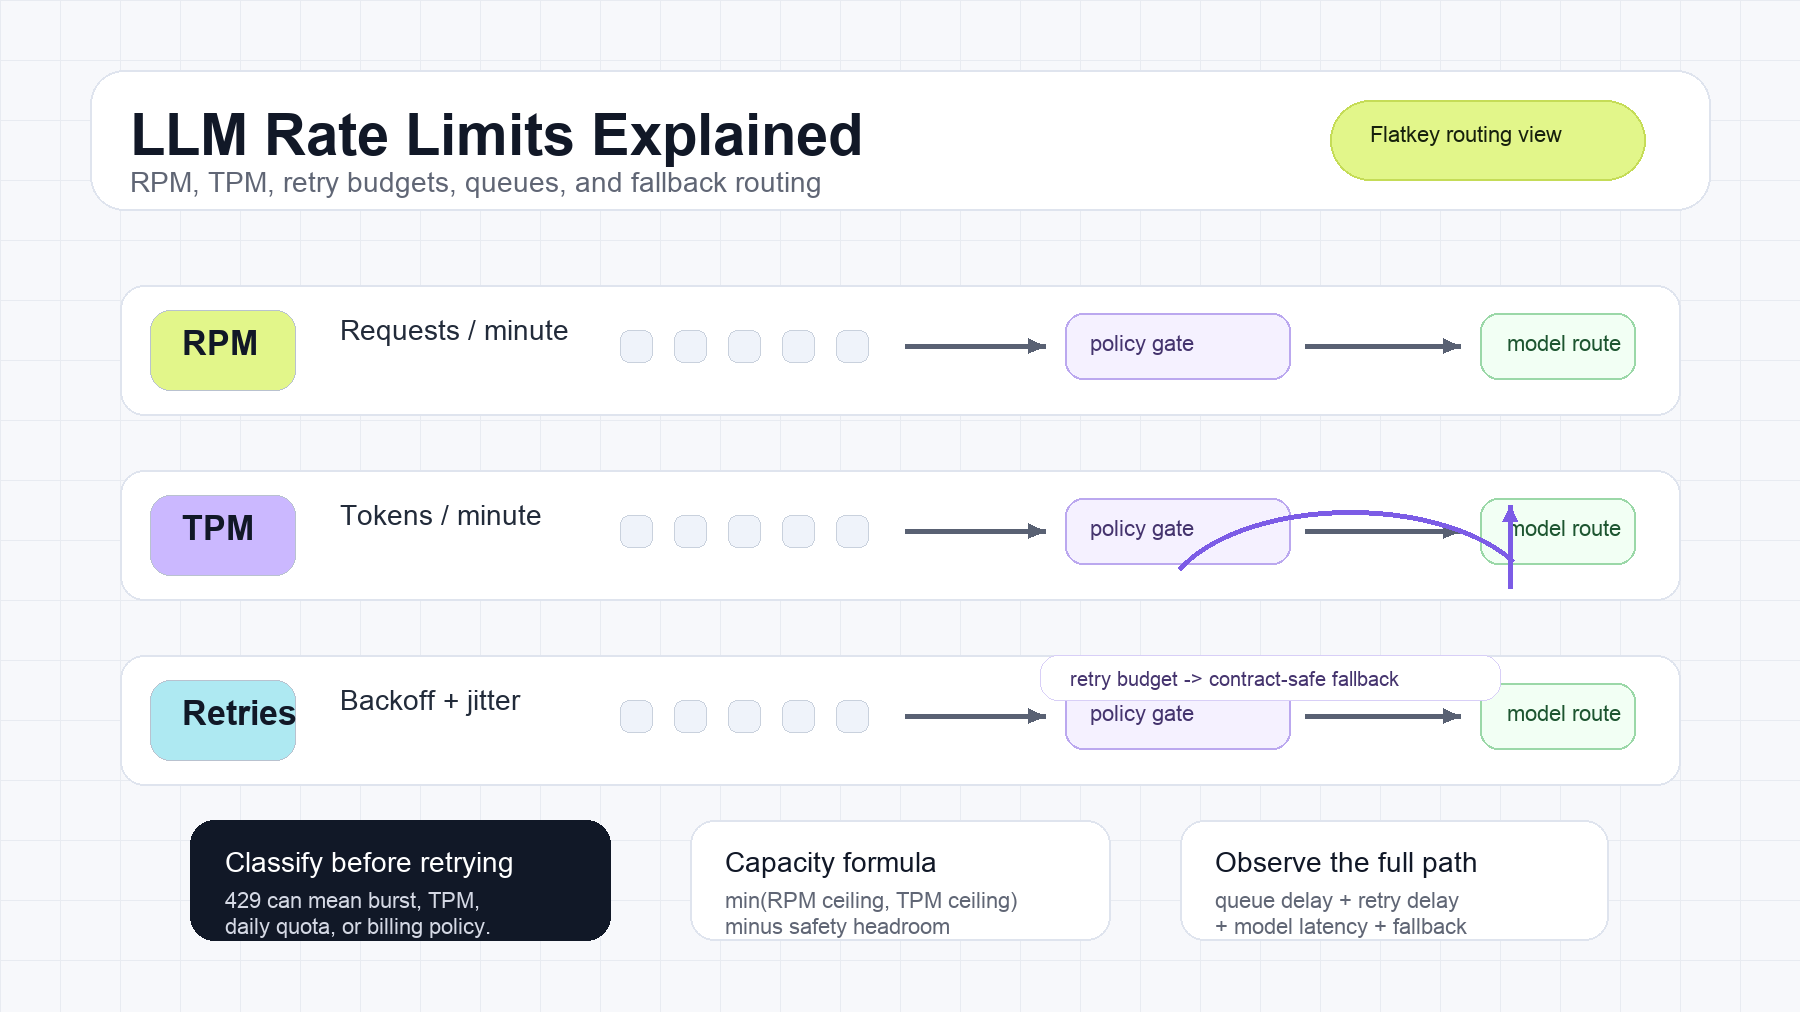
Практическое правило простое: RPM контролирует частоту запросов, TPM контролирует пропускную способность по токенам, concurrency контролирует объем выполняемой в данный момент работы, а повторные попытки расходуют ту же дефицитную емкость, если их не ограничить. Производственная система должна сначала определить, какой ресурс ограничен, а затем выбрать между регулированием темпа, постановкой в очередь, уменьшением числа токенов, короткими ретраями или маршрутизацией к другой совместимой по контракту модели.
Это руководство рассматривает Пояснение лимитов запросов к LLM: RPM, TPM и повторные попытки как операционный playbook для команд AI-продуктов и платформы. В нем рассматриваются термины, расчет емкости, политика повторных попыток, поля наблюдаемости и gateway-контроли в стиле Flatkey, которые не дают лимитам запросов к LLM API превратиться в инцидент для клиентов.
Пояснение лимитов запросов к LLM: RPM, TPM и повторные попытки — краткий ответ
Используйте эту таблицу, когда разбираете инцидент, связанный с лимитом запросов к LLM.
| Сигнал | Что он измеряет | Типичный симптом | Первый контроль |
|---|---|---|---|
| RPM | Запросы, принятые за минуту или за заданное провайдером окно | Многие небольшие вызовы завершаются с 429 |
Регулировать темп запросов, ставить всплески в очередь, пакетировать мелкие задачи |
| TPM | Токены входа и/или выхода, принятые за минуту или окно | Длинные промпты, длинные ответы или eval-запуски упираются в throttling | Резервировать токены, сокращать контекст, ограничивать длину вывода |
| RPD / TPD | Запросы или токены, принятые за день | Работа останавливается до сброса квоты | Остановить повторы, перенести выполнение, запросить более высокий тариф |
| Concurrency | Одновременно выполняющиеся запросы или задачи | Медленные генерации накапливаются даже при умеренном RPM | Ограничить число воркеров, добавить backpressure |
| Бюджет повторных попыток | Сколько дополнительной работы может потратить вызывающая сторона после сбоя | Шторм ретраев, завышенная задержка, дублирующиеся побочные эффекты | Ограничить число попыток, время выполнения и статусы, при которых возможен retry |
| Fallback route | Допустимая альтернативная модель или провайдер | Основной маршрут ограничен, но продукту все еще нужен результат | Маршрутизировать только если подходят возможности, политика и стоимость |
Пояснение лимитов запросов к LLM: RPM, TPM и повторные попытки сводится к одному операционному решению: не делайте blind retry. 429 — это не команда немедленно отправить тот же запрос еще раз. Это сигнал о том, что один из уровней емкости, политика квот, состояние биллинга или механизм защиты провайдера отклонил запрос.
Зачем существуют лимиты запросов
Провайдеры вводят лимиты запросов к LLM API, чтобы защищать общую емкость, предотвращать неконтролируемый рост нагрузки со стороны аккаунтов и поддерживать согласованность политики биллинга или сервисного уровня. OpenAI, Anthropic и Gemini документируют концепции лимитов запросов, но используют разные названия buckets, области действия, заголовки и панели мониторинга. OpenAI документирует rate limits и советует клиентам обрабатывать ошибки лимитов с помощью backoff. Anthropic документирует лимиты расходов на уровне организации и рабочего пространства, а также лимиты на уровне моделей, которые могут включать запросы и токены. Gemini документирует уровни с понятиями лимитов по запросам, токенам и дневным лимитам.
Эти ограничения со стороны провайдера необходимы, но они не являются полной продуктовой политикой. Обычно они отвечают на вопрос со стороны провайдера: «Может ли этот проект сейчас отправлять больше трафика?» Ваше приложение все равно должно отвечать на продуктовые вопросы:
- Какой клиент, рабочее пространство, команда или функция вызвали всплеск?
- Что именно было ограничено: запросы, входные токены, выходные токены, concurrency, дневная квота или расходы?
- Должна ли эта нагрузка подождать, деградировать, перейти на пониженный режим или быстро завершиться с ошибкой?
- Разрешен ли fallback route с точки зрения возможностей, политики данных, цены и контракта с клиентом?
- Усиливают ли повторные попытки проблему с лимитом?
Для смежных контролей квот см. также управление квотами AI API и управление расходами AI API.
RPM, TPM и concurrency — это разные лимиты
Команды часто воспринимают лимиты запросов как одно число. Это скрывает реальное узкое место.
RPM: запросов в минуту
RPM ограничивает число запросов, принятых в течение заданного провайдером окна времени. Небольшие промпты, health checks, циклы инструментов у агентов и задания с высокой степенью fan-out обычно сначала давят именно на RPM. Нагрузка может быть сильно ниже TPM и при этом все равно упираться в RPM, если она отправляет слишком много мелких вызовов.
TPM: токенов в минуту
TPM ограничивает пропускную способность по токенам. В зависимости от провайдера и модели лимит может учитывать входные токены, выходные токены, кэшированные токены или отдельные buckets для входа и выхода. Длинный retrieval-контекст, история диалога, многословные ответы, генерация нескольких кандидатов и параллельные evals обычно раньше упираются в TPM, чем в RPM.
Concurrency: работа в полете
Concurrency — это не RPM. Система может отправлять только 60 запросов в минуту и при этом иметь высокую concurrency, если каждая генерация занимает 20 секунд. Streaming и длительные tool calls делают это заметным. Ограничение пулов воркеров и глубины очереди обычно лучше, чем увеличение числа повторных попыток.
Дневные лимиты и лимиты расходов
Некоторые лимиты не восстанавливаются после короткой паузы. Суточные лимиты запросов, суточные лимиты токенов, месячные лимиты расходов и ограничения биллинга обычно должны останавливать повторные попытки. Правильное действие — перенести задачу на другое время, повысить тариф, скорректировать бюджет или сообщить пользователю, что мощность исчерпана.
Почему можно получить 429 ниже заявленного лимита
Опубликованный лимит вроде «1,000 RPM» редко означает, что клиент может отправить 1,000 запросов в первую секунду минуты. Провайдеры могут применять скользящие окна, token buckets, пулы моделей, правила всплесков для конкретного тарифа, ограничения ускорения или общие квоты проекта.
Запрос может получить 429 Too Many Requests даже тогда, когда локальный счётчик выглядит безопасным, потому что:
- Несколько воркеров, пользователей, сервисов или окружений разделяют один и тот же лимит аккаунта.
- Входные и выходные токены учитываются в разных корзинах.
- У одной модели пул уже, чем у другой модели.
- Повторные попытки после ранних сбоев всё ещё расходуют capacity запросов.
- Слишком резкий рост трафика выходит за рамки контроля ускорения.
- Активно правило для суточного лимита, расходов, рабочего пространства или уровня сервиса.
- Провайдер возвращает общий
429для нескольких политик capacity.
Поэтому Пояснение лимитов запросов к LLM: RPM, TPM и повторные попытки должно начинаться с классификации, а не с кода. Логируйте код статуса, тип ошибки провайдера, заголовки ответа, модель, аккаунт или проект, оценку токенов, фактические токены, номер попытки, задержку в очереди и идентификатор запроса провайдера, если он доступен.
Формула планирования capacity
Начните с независимых потолков для запросов и токенов, а затем работайте ниже максимума.
request_ceiling = RPM * safety_factor

token_ceiling = (TPM * safety_factor) / average_total_tokens_per_request

safe_requests_per_minute = min(request_ceiling, token_ceiling)
Используйте коэффициент запаса, например 0.70–0.90, в зависимости от разброса токенов, общих потребителей, поведения повторных попыток и того, насколько дорого обходятся пропущенные целевые значения задержки.
Пример:
RPM = 1,000
TPM = 2,000,000
average_total_tokens_per_request = 4,000
safety_factor = 0.80

request_ceiling = 1,000 * 0.80 = 800 requests/minute

token_ceiling = (2,000,000 * 0.80) / 4,000 = 400 requests/minute

safe_requests_per_minute = min(800, 400) = 400 requests/minute
В этом примере ограничивающим фактором является TPM. Добавление большего числа воркеров не увеличит устойчивую пропускную способность. Это создаст больше очередей, больше повторных попыток или больше ошибок 429.
Для онлайн-систем переведите безопасную скорость запросов в отправную точку по concurrency:
target_concurrency ~= requests_per_second * average_request_seconds
Если безопасная скорость составляет 400 запросов в минуту, это примерно 6.67 запроса в секунду. Если средняя задержка модели — 3 секунды, стартовая concurrency будет около 20. Настраивайте по p95 и p99 задержки, а не только по средним значениям.
Резервирование токенов для безопасности TPM
Инциденты с TPM часто возникают из-за оптимистичного планирования. Приложение допускает работу, исходя из ожидаемого числа токенов, но модель генерирует более длинный ответ, чем планировалось.
Более безопасный планировщик резервирует токены до отправки запроса:
reservation:
  workload: support_answer
  model_route: primary_chat_route
  request_id: req_8f3a
  estimated_input_tokens: 3200
  max_output_tokens: 900
  reserved_total_tokens: 4100
  reservation_expires_at: 2026-10-10T11:03:00Z
После ответа сопоставьте зарезервированные токены с фактическими токенами:
actual_usage:
  input_tokens: 3014
  output_tokens: 622
  total_tokens: 3636
  retry_attempts: 0
  accepted_result: true
Для production резервируйте по p95 или по оценкам, специфичным для типа нагрузки. Используйте фактическое потребление для распределения затрат и прогнозирования. Такое разделение упрощает работу с лимитами API LLM: контроль допуска использует безопасную оценку, а финансы и продукт анализируют фактическую стоимость одного принятого результата.
Дерево решений по лимитам запросов
Когда запрос отклонён или растёт очередь, определите контроль по причине.
Did the provider return Retry-After or a reset header?
  yes -> wait for the hint if it fits the caller latency budget
  no  -> use bounded exponential backoff with jitter for transient classes

Is the cause daily quota, billing, permission, or hard spend limit?
  yes -> do not retry; fail, reschedule, or request capacity
  no  -> continue

Is RPM the binding constraint?
  yes -> pace requests, batch small work, or queue low priority traffic
  no  -> continue

Is TPM the binding constraint?
  yes -> shorten context, cap output, reserve tokens, or delay long jobs
  no  -> continue

Is concurrency the binding constraint?
  yes -> reduce workers, set queue deadlines, and apply backpressure
  no  -> continue

Is an eligible fallback route healthy and policy-approved?
  yes -> route after the retry budget is spent
  no  -> return a controlled failure
Это дерево решений — ценный актив для Пояснение лимитов запросов к LLM: RPM, TPM и повторные попытки. Оно не позволяет обработке 429 превратиться в бесконечный цикл и превращает Пояснение лимитов запросов к LLM: RPM, TPM и повторные попытки из темы определений в рабочий процесс реагирования на инциденты.
Как использовать Retry-After
HTTP Retry-After сообщает клиенту, как долго ждать перед выполнением следующего запроса. В RFC это определяется либо как задержка в секундах, либо как дата HTTP. Справка MDN по 429 Too Many Requests также описывает использование Retry-After для указания, когда клиент может повторить попытку.
Практические правила:
- Соблюдайте корректный
Retry-After, если он укладывается в бюджет задержки вызывающей стороны. - Ограничивайте очень большие значения для интерактивных вызовов; не держите запрос пользователя открытым бесконечно.
- Считайте некорректные или отсутствующие значения основанием для клиентского backoff.
- Не повторяйте неретрайабельные причины только потому, что
Retry-Afterотсутствует. - Записывайте подсказку провайдера и фактически использованную задержку.
Для интерактивных пользовательских сценариев бюджет повторной попытки часто меньше, чем подсказка провайдера. В таком случае быстро завершайте с понятным сообщением или перенаправляйте запрос в другое место. Для пакетной обработки очередь может быть лучше, чем возврат ошибки.
Экспоненциальный backoff с jitter
Экспоненциальный backoff увеличивает задержку после каждой неудачной попытки. Jitter случайным образом изменяет эту задержку, чтобы рабочие процессы не синхронизировались и не выполняли повторные попытки одновременно. Рекомендации AWS по backoff и jitter полезны, потому что они объясняют, почему обычный ограниченный экспоненциальный backoff без случайности все равно может приводить к группировке повторных попыток.
Распространенная формула full jitter:
delay_ms = random(0, min(cap_ms, base_ms * 2^attempt))
Политика повторных попыток в production требует большего, чем просто формула задержки:
| Поле политики | Рекомендуемое управление |
|---|---|
| Статусы, допускающие повтор | 429, выбранные 5xx и временные сетевые сбои |
| Статусы, не допускающие повтор | ошибки валидации, ошибки аутентификации, ошибки прав доступа, ошибки биллинга, исчерпание дневной квоты |
| Максимум попыток | Небольшое число для интерактивных вызовов; большее — только для офлайн-задач |
| Максимальное прошедшее время | Ограничено бюджетом задержки, видимым пользователю, или дедлайном задачи |
| Jitter | Обязателен для систем с несколькими рабочими процессами |
Retry-After |
Используйте, когда значение корректно и допустимо по стоимости |
| Отмена | Немедленно останавливайтесь, когда вызывающая сторона прерывает запрос |
| Наблюдаемость | Количество попыток, время ожидания, финальный статус, ID запроса, задержка в очереди |
Неудачные запросы все равно могут потреблять емкость лимита запросов. Поэтому повторные попытки должны быть частью планирования rate limit, а не второстепенной мыслью.
Помощник повторных попыток на TypeScript для API, совместимых с OpenAI
Этот помощник использует Retry-After, если он присутствует, иначе — full jitter. Он останавливается, когда попытки или прошедшее время исчерпаны.
type ChatRequest = {
  model: string;
  messages: Array<{ role: "system" | "user" | "assistant"; content: string }>;
  max_tokens?: number;
};

const sleep = (milliseconds: number) =>
  new Promise((resolve) => setTimeout(resolve, milliseconds));

function retryAfterMilliseconds(response: Response): number | null {
  const value = response.headers.get("retry-after");
  if (!value) return null;

  const seconds = Number(value);
  if (Number.isFinite(seconds)) return Math.max(0, seconds * 1_000);

  const date = Date.parse(value);
  return Number.isNaN(date) ? null : Math.max(0, date - Date.now());
}

export async function createChatCompletion(
  apiKey: string,
  request: ChatRequest,
  options: { maxAttempts?: number; maxElapsedMs?: number } = {},
) {
  const maxAttempts = options.maxAttempts ?? 4;
  const maxElapsedMs = options.maxElapsedMs ?? 30_000;
  const startedAt = Date.now();

  for (let attempt = 0; attempt < maxAttempts; attempt += 1) {
    const response = await fetch("https://router.flatkey.ai/v1/chat/completions", {
      method: "POST",
      headers: {
        Authorization: `Bearer ${apiKey}`,
        "Content-Type": "application/json",
      },
      body: JSON.stringify(request),
    });

    if (response.ok) return response.json();

    const retryable = response.status === 429 || response.status >= 500;
    const finalAttempt = attempt === maxAttempts - 1;
    if (!retryable || finalAttempt) {
      throw new Error(`Запрос к LLM завершился ошибкой ${response.status}: ${await response.text()}`);
    }

    const serverDelay = retryAfterMilliseconds(response);
    const exponentialCap = Math.min(8_000, 500 * 2 ** attempt);
    const jitteredDelay = Math.random() * exponentialCap;
    const delayMs = serverDelay ?? jitteredDelay;

    if (Date.now() + delayMs - startedAt >= maxElapsedMs) {
      throw new Error("Бюджет повторных попыток LLM исчерпан");
    }

    await sleep(delayMs);
  }

  throw new Error("Недостижимое состояние повторной попытки");
}
Перед использованием в production добавьте тайм-ауты запросов, структурированные классы ошибок, телеметрию и отмену. Если вызов может создавать внешние побочные эффекты, сделайте бизнес-операцию идемпотентной перед повторной попыткой.
Повторять, ставить в очередь, уменьшать или перенаправлять?
Устойчивый система имеет больше одного ответа на ограничение пропускной способности.
| Ситуация | Повторная попытка | Очередь | Сократить токены | Направить в другое место |
|---|---|---|---|---|
Один короткий временный 429 |
Да, с ограничением | Необязательно | Нет | Обычно нет |
| Устойчивая нехватка RPM | Очень ограниченно | Да | Обычно нет | Иногда |
| Устойчивая нехватка TPM | Очень ограниченно | Да | Да | Иногда |
| Дневная квота исчерпана | Нет | Только если приемлем последующий сброс | Нет | Возможно |
| Ошибка биллинга или прав доступа | Нет | Нет | Нет | Нет, сначала исправьте доступ |
| Перегрузка провайдера при наличии исправного fallback | Кратко | Необязательно | Нет | Да, после проверки политики |
| Частичный поток уже доставлен | Обычно без повторного воспроизведения | Возможно, продолжить или явно перезапустить | Возможно | Только с четкой семантикой |
Постановка в очередь защищает провайдера и пользовательский опыт, когда работу можно отложить. Сокращение токенов защищает TPM. Маршрутизация защищает доступность только тогда, когда альтернативный маршрут соблюдает тот же продуктовый контракт.
Для паттернов, связанных именно с перегрузкой, используйте руководство API Error 529 overloaded. Для последствий в стоимости свяжите поведение повторных попыток и fallback с ценообразованием AI gateway и как сравнивать цены на AI-модели.
Ограничения скорости в оценке моделей
Ограничения скорости могут сделать сравнение моделей недействительным.
Если модель A тестируется с 10 воркерами, а модель B — со 100, модель B может выглядеть медленнее, потому что тестовый стенд вызвал постановку в очередь и повторные попытки. Это измерение больше говорит о конфигурации теста, чем о задержке модели.
Для обоснованных оценок:
- Разделяйте задержку модели, задержку в очереди и задержку из-за повторных попыток.
- Используйте один и тот же процесс поступления запросов или нормализованный уровень загрузки для каждого маршрута.
- Плавно прогревайте трафик, когда провайдеры используют механизмы ускорения.
- Записывайте токены и число попыток на каждую завершенную задачу.
- Отдельно указывайте долю успеха с первой попытки и итоговую долю успеха.
- Сравнивайте стоимость на принятую задачу, а не только цену токена.
- Проводите тесты на перегрузку отдельно от тестов качества.
Это особенно важно для бесплатных или низкоуровневых аккаунтов. Статья free LLM APIs полезна для контекста, потому что бесплатные лимиты часто предназначены для исследования, а не для производственной нагрузки.
Метрики, на которые стоит настраивать оповещения
Отслеживайте их по провайдеру, модели, маршруту, тенанту, рабочей нагрузке и среде:
- Запросы в минуту.
- Входящие токены в минуту и исходящие токены в минуту.
- Оценочные зарезервированные токены по сравнению с фактически использованными токенами.
- Глубина очереди и возраст самого старого элемента в очереди.
- Время ожидания доступной пропускной способности по лимиту.
- Доля успеха с первой попытки.
- Число повторных попыток на успешный запрос.
- Частота
429по классифицированной причине. - Усиление повторов: общее число попыток, деленное на число успешных результатов.
- Частота fallback и результат fallback.
- Сквозная задержка p50, p95 и p99.
- Стоимость на успешную или принятую задачу.
Семантические соглашения OpenTelemetry для генеративного ИИ могут помочь стандартизировать телеметрию модели, операции, токенов, ответов и ошибок. Сохраняйте и продуктовые измерения: клиент, рабочее пространство, класс трафика, среда, функция и владелец.
Оповещение только по общему числу 429 будет шумным. Лучший сигнал сочетает скорость throttling, возраст очереди, усиление повторов и итоговую долю сбоев.
Архитектура ограничения скорости в продакшене
Надежный путь обработки запроса обычно включает семь уровней управления:
client
  -> admission control
  -> priority queue
  -> token reservation
  -> RPM + TPM limiter
  -> provider/model route
  -> bounded retry controller
  -> contract-safe fallback
  -> usage, cost, and latency ledger
Используйте admission control, когда очередь не может уложиться в дедлайн вызывающей стороны. Используйте приоритетные очереди, чтобы некритичные оценки не вытесняли production-трафик. Используйте резервирование токенов, чтобы честно соблюдать TPM. Используйте централизованный контроллер повторных попыток, чтобы SDK, очередь, gateway и уровни worker не выполняли повторы независимо друг от друга.
Журнал использования должен записывать:
rate_limit_event:
  request_id: req_8f3a
  workspace_id: ws_42
  environment: production
  workflow: support_answer
  route_requested: primary_chat_route
  route_final: fallback_chat_route
  estimated_input_tokens: 3200
  max_output_tokens: 900
  actual_input_tokens: 3014
  actual_output_tokens: 622
  attempt_count: 2
  retry_delay_ms: 740
  queue_delay_ms: 1180
  final_status: success
  classified_limit: transient_rpm_burst
  accepted_result: true
Это делает ограничения скорости LLM API доступными для анализа после инцидента. Это также дает командам финансов и продукта доказательства, которые им нужны, когда повторы или fallback меняют стоимость на принятый результат.
Как вписывается Flatkey
Flatkey дает командам один API-ключ и совместимый с OpenAI базовый URL для поддерживаемых маршрутов моделей. Это не снимает ограничения скорости upstream LLM. Это дает командам одну точку интеграции, где маршрутизация, анализ использования и политика могут быть согласованы между провайдерами.
Для workflow Пояснение лимитов запросов к LLM: RPM, TPM и повторные попытки gateway-уровень помогает, когда:
- Вашему приложению нужна единая политика повторных попыток, очереди и резервного переключения вместо логики для каждого провайдера, разбросанной по сервисам.
- Продуктовым командам нужно сравнивать состояние маршрутов, задержку, токены и стоимость принятого результата в одном реестре.
- Платформенным командам нужны списки разрешённых моделей, бюджеты по sub-key и контроль использования по окружению или рабочему процессу.
- Финансам нужен единый баланс, счёт и подтверждающие данные на уровне запросов вместо разрозненных панелей провайдеров.
- Операторам нужно переносить допустимый трафик, когда маршрут ограничен, без переписывания SDK приложения.
Шлюз по-прежнему должен сохранять контракты, специфичные для модели. Не перенаправляйте запрос с одной модели на другую, если окно контекста, поведение инструментов, структурированный вывод, политика безопасности, контроль данных, задержка и стоимость не подходят для этой рабочей нагрузки. Перед запуском в production проверьте текущее состояние доступности маршрутов и цены в каталоге моделей Flatkey и ценах Flatkey.
Распространённые ошибки
Воспринимать RPM как конкуррентность
RPM измеряет количество допусков за время. Конкуррентность измеряет объём выполняемой работы. Медленные генерации могут создавать высокую конкуррентность при умеренном RPM.
Немедленно повторять каждый 429
Немедленные повторы синхронизируют рабочих и потребляют больше мощности. Соблюдайте Retry-After, когда он действителен, добавляйте jitter и ограничивайте бюджет повторов.
Использовать один ограничитель для каждой модели
Провайдеры могут использовать отдельные пулы моделей или общие пулы аккаунта. Ограничитель должен соответствовать документированной области квоты и наблюдаемым заголовкам ответа.
Игнорировать общих потребителей
Панель управления, запуск оценок, coding agent и production API могут использовать один проект. Резервируйте мощность по рабочей нагрузке и, где возможно, изолируйте критический трафик.
Повторять частичные потоки
После того как токены дошли до пользователя или было выполнено действие инструмента, тихий повтор может дублировать вывод или побочные эффекты. Явно определите семантику продолжения, перезапуска или идемпотентности.
Измерять только задержку провайдера
Задержка для конечного пользователя включает задержку в очереди, задержку повторов, задержку fallback и задержку модели. Настраивайте оповещения по всему пути и держите компоненты раздельно.
FAQ
В чём разница между RPM и TPM?
RPM ограничивает количество запросов, допускаемых за время. TPM ограничивает количество входных и/или выходных токенов, допускаемых системой. Небольшие промпты обычно упираются сначала в RPM; задачи с большим контекстом или высоким объёмом вывода часто первыми упираются в TPM.
Почему я получаю ошибки 429 ниже моего лимита RPM?
Провайдер может применять скользящие окна, токен-бакеты, общие квоты аккаунта, отдельные лимиты по токенам, пулы для конкретных моделей, дневные лимиты или controls по ускорению. Ваш локальный счётчик запросов может не отражать полную область квоты.
Стоит ли повторять каждый 429?
Нет. Повторяйте кратковременное throttling с небольшим бюджетом и jitter. Не повторяйте многократно исчерпание дневной квоты, ограничения по биллингу, ошибки прав доступа, ошибки валидации или устойчивую перегрузку, у которой нет реалистичного окна восстановления.
Гарантирует ли экспоненциальный backoff успех?
Нет. Backoff уменьшает столкновения и даёт временной мощности время на восстановление. Он не может создать квоту. Постоянное исчерпание требует снижения спроса, увеличения мощности, отложенной работы или другого допустимого маршрута.
Учитываются ли повторы в лимитах запросов?
Да, могут. Провайдеры могут учитывать неуспешные запросы или попытки в рамках активных лимитов, поэтому усиление повторами нужно отслеживать и ограничивать.
Сколько повторов должен использовать запрос к LLM?
Универсального числа нет. Определяйте количество попыток исходя из бюджета задержки, заметной пользователю, и типа сбоя. Интерактивным приложениям обычно достаточно нескольких коротких попыток до отказа или маршрутизации; офлайн-задачи могут терпеть более длинные очереди.
Итоговый чек-лист
Используйте этот чек-лист при внедрении Пояснение лимитов запросов к LLM: RPM, TPM и повторные попытки в production:
- Отдельно моделируйте RPM, TPM, дневные лимиты, лимиты расходов и конкуррентность.
- Рассчитывайте мощность по минимуму из потолков по запросам и токенам.
- Работайте ниже опубликованного максимума с запасом безопасности.
- Резервируйте токены перед отправкой запросов с высокой вариативностью.
- Используйте очереди и pacing для устойчивой нагрузки.
- Соблюдайте
Retry-After, когда он действителен и приемлем по стоимости. - Используйте экспоненциальный backoff с jitter, когда нет действительной подсказки от сервера.
- Ограничивайте число попыток и общее время повторов.
- Прекращайте повторы при ошибках квоты, биллинга, прав доступа и валидации.
- Не воспроизводите частичные потоки или неидемпотентные побочные эффекты.
- Маршрутизируйте только к моделям, которые сохраняют требуемый продуктовый контракт.
- Отделяйте задержку в очереди и задержку повторов от задержки модели в оценках.
- Настраивайте оповещения на усиление повторов и возраст очереди, а не только на сырое количество
429. - Записывайте идентификаторы запросов, оценки токенов, фактические токены, попытки, маршрут fallback и итоговый результат в реестр использования.
Лимиты запросов — это прежде всего средства планирования мощности, а уже потом сообщения об ошибках. Главный вывод из Пояснение лимитов запросов к LLM: RPM, TPM и повторные попытки — независимо измерять частоту запросов, пропускную способность по токенам, конкуррентность, повторы и результаты fallback, чтобы 429 стал полезным сигналом, а не шумом в production.
Источники
- Документация OpenAI по лимитам запросов: https://platform.openai.com/docs/guides/rate-limits
- OpenAI Cookbook, обработка лимитов запросов: https://cookbook.openai.com/examples/how_to_handle_rate_limits
- Лимиты запросов Anthropic: https://docs.anthropic.com/en/api/rate-limits
- Лимиты запросов Gemini API: https://ai.google.dev/gemini-api/docs/rate-limits
- RFC 9110 Retry-After: https://www.rfc-editor.org/rfc/rfc9110.html#name-retry-after
- MDN 429 Too Many Requests: https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Status/429
- Блог AWS Architecture, экспоненциальная задержка и джиттер: https://aws.amazon.com/blogs/architecture/exponential-backoff-and-jitter/
- Семантические соглашения OpenTelemetry для генеративного ИИ: https://opentelemetry.io/docs/specs/semconv/gen-ai/
- Тарифы Flatkey: https://flatkey.ai/pricing
- Каталог моделей Flatkey: https://flatkey.ai/models