Инфраструктура суверенного ИИ: модели, локализация данных и контроль вычислений (руководство на 2026 год)
Инфраструктура суверенного ИИ — это совокупность вычислительных ресурсов, данных, моделей и процессов эксплуатации, которые страна или организация контролирует в рамках собственного законодательства, без зависимости от сервисов под иностранным контролем. На практике это означает четыре вещи: GPU находятся в выбранной юрисдикции, данные остаются в ней, модели можно запускать и проверять самостоятельно (обычно это модели с открытыми весами), а операторы подчиняются местному законодательству. Большинству компаний не нужна полная суверенность; им нужен подходящий уровень контроля для каждой рабочей нагрузки.
Это руководство предназначено для корпоративных команд по ИИ, инфраструктуре и закупкам, которым поручили «сделать наш ИИ суверенным». В нем дается определение термина, разбираются нормативные требования по состоянию на октябрь 2026 года, описываются пять уровней контроля — от публичных API до изолированных от внешних сетей кластеров — и приводится пример расчета мощности и стоимости развертывания GPU внутри страны.
Что такое суверенный ИИ?
NVIDIA описывает суверенный ИИ как создание странами ИИ «с использованием национальной инфраструктуры, данных, специалистов и деловых связей с учетом своего языка, культуры и нормативных требований», причем модели «размещаются и работают на местной инфраструктуре, подчиняясь только местному законодательству» (NVIDIA). Red Hat рассматривает это с точки зрения бизнеса: контроль над тем, где работает ИИ, кто получает к нему доступ и какие компоненты можно проверить и заменить.
Термин охватывает две взаимосвязанные цели:
- Национальный суверенный ИИ: страна развивает собственные вычислительные мощности, модели для местных языков и специалистов, чтобы критически важные сервисы не зависели от иностранных поставщиков.
- Корпоративный суверенный ИИ: организация сохраняет данные, подпадающие под нормативные требования, модели и эксплуатацию ИИ в рамках выбранных ею юрисдикций и договоров.
Оба подхода опираются на одни и те же слои инфраструктуры.
Четыре слоя инфраструктуры суверенного ИИ
| Слой | Что означает «суверенный» | Типичные меры контроля |
|---|---|---|
| Вычисления | GPU находятся в выбранной стране и эксплуатируются организацией, подчиняющейся ее законодательству | Дата-центры внутри страны, выделенные или частные GPU-кластеры, суверенные облачные регионы |
| Данные | Обучающие данные, промпты, результаты, журналы и резервные копии остаются в юрисдикции | Договорные условия локализации данных, региональные хранилища, шифрование с ключами у заказчика |
| Модели | Модель можно запускать, изучать, дообучать и продолжать использовать без согласия иностранного поставщика | Самостоятельное размещение моделей с открытыми весами (Llama, Mistral, Qwen, DeepSeek) или договорные гарантии для закрытых моделей |
| Эксплуатация | Администраторы, сотрудники поддержки и субобработчики находятся в стране, а их действия доступны для аудита | Местные специалисты поддержки, журналирование доступа, право на независимый аудит, планы выхода из сервиса |
Суверенность развертывания определяется его самым слабым слоем. GPU внутри страны не помогут, если промпты записываются в журналы зарубежного сервиса мониторинга, а локальная модель не поможет, если единственный административный доступ проходит через службу поддержки иностранного поставщика.
Почему суверенность стала актуальна в 2026 году
Три фактора превращают эту тему из политической дискуссии в вопрос закупок:
- Сроки применения EU AI Act. Согласно графику внедрения AI Act (последнее обновление — 31 августа 2026 года), большинство оставшихся положений начали применяться 2 августа 2026 года; поставщики моделей ИИ общего назначения, вышедших на рынок до 2 августа 2025 года, должны выполнить требования к 2 августа 2027 года; обязательства для систем высокого риска из Приложения III начинают действовать 2 декабря 2027 года. Организациям нужны подконтрольные им журналы аудита и документация.
- Правила трансграничной передачи данных. Согласно GDPR, персональные данные можно свободно передавать только в страны, в отношении которых ЕС принял решение об адекватности защиты данных; для других передач нужны защитные меры. При этом американский CLOUD Act (март 2018 года) дает властям США правовой механизм запроса данных у поставщиков, базирующихся в США. Поэтому заказчики из ЕС спрашивают, кто управляет сервисом, а не только где он работает.
- Риски поставщиков и поставок. Прекращение поддержки моделей, изменение цен и правил использования, а также экспортные ограничения на GPU могут нарушить работу продукта, построенного на одном иностранном API.
Облачные поставщики ответили суверенными предложениями: AWS запустила AWS European Sovereign Cloud как независимое облако для Европы; программа Microsoft EU Data Boundary предусматривает хранение и обработку клиентских данных корпоративных сервисов в пределах ЕС; Oracle предлагает варианты суверенного облака с контролем размещения, доступа и эксплуатации.
Пять уровней суверенности ИИ
Выбирайте уровень для каждой рабочей нагрузки, а не один для всей компании.
| Уровень | Конфигурация | Локализация данных | Контроль над моделью | Контроль эксплуатации | Для каких задач подходит |
|---|---|---|---|---|---|
| 1. Публичный API | Глобальная конечная точка поставщика модели | По выбору поставщика | Отсутствует | Поставщик | Общедоступный контент, прототипы |
| 2. Региональный API | Тот же поставщик с обработкой в регионе или внутри страны (например, инференс Claude только в США за 1.1x от базовой цены, региональные конечные точки OpenAI с локализацией данных за +10%) | Регион по договору | Отсутствует | Поставщик | Большинство внутренних бизнес-данных |
| 3. Суверенное облако | Размещение модели в суверенном регионе под управлением местной организации | Внутри страны | Ограниченный (модели из каталога) | Местный оператор | Регулируемые отрасли, государственный сектор |
| 4. Выделенные GPU внутри страны | Арендованный или зарезервированный GPU-кластер в выбранной стране, на котором работают развернутые вами модели с открытыми весами | Внутри страны, в вашем хранилище | Полный | Вы и оператор дата-центра | Здравоохранение, финансы, поставщики оборонной отрасли, национальные LLM |
| 5. На собственной площадке или с изоляцией от внешних сетей | Собственное оборудование без подключения к внешней сети | На вашей территории | Полный | Вы | Секретные задачи или задачи со строгими ограничениями |
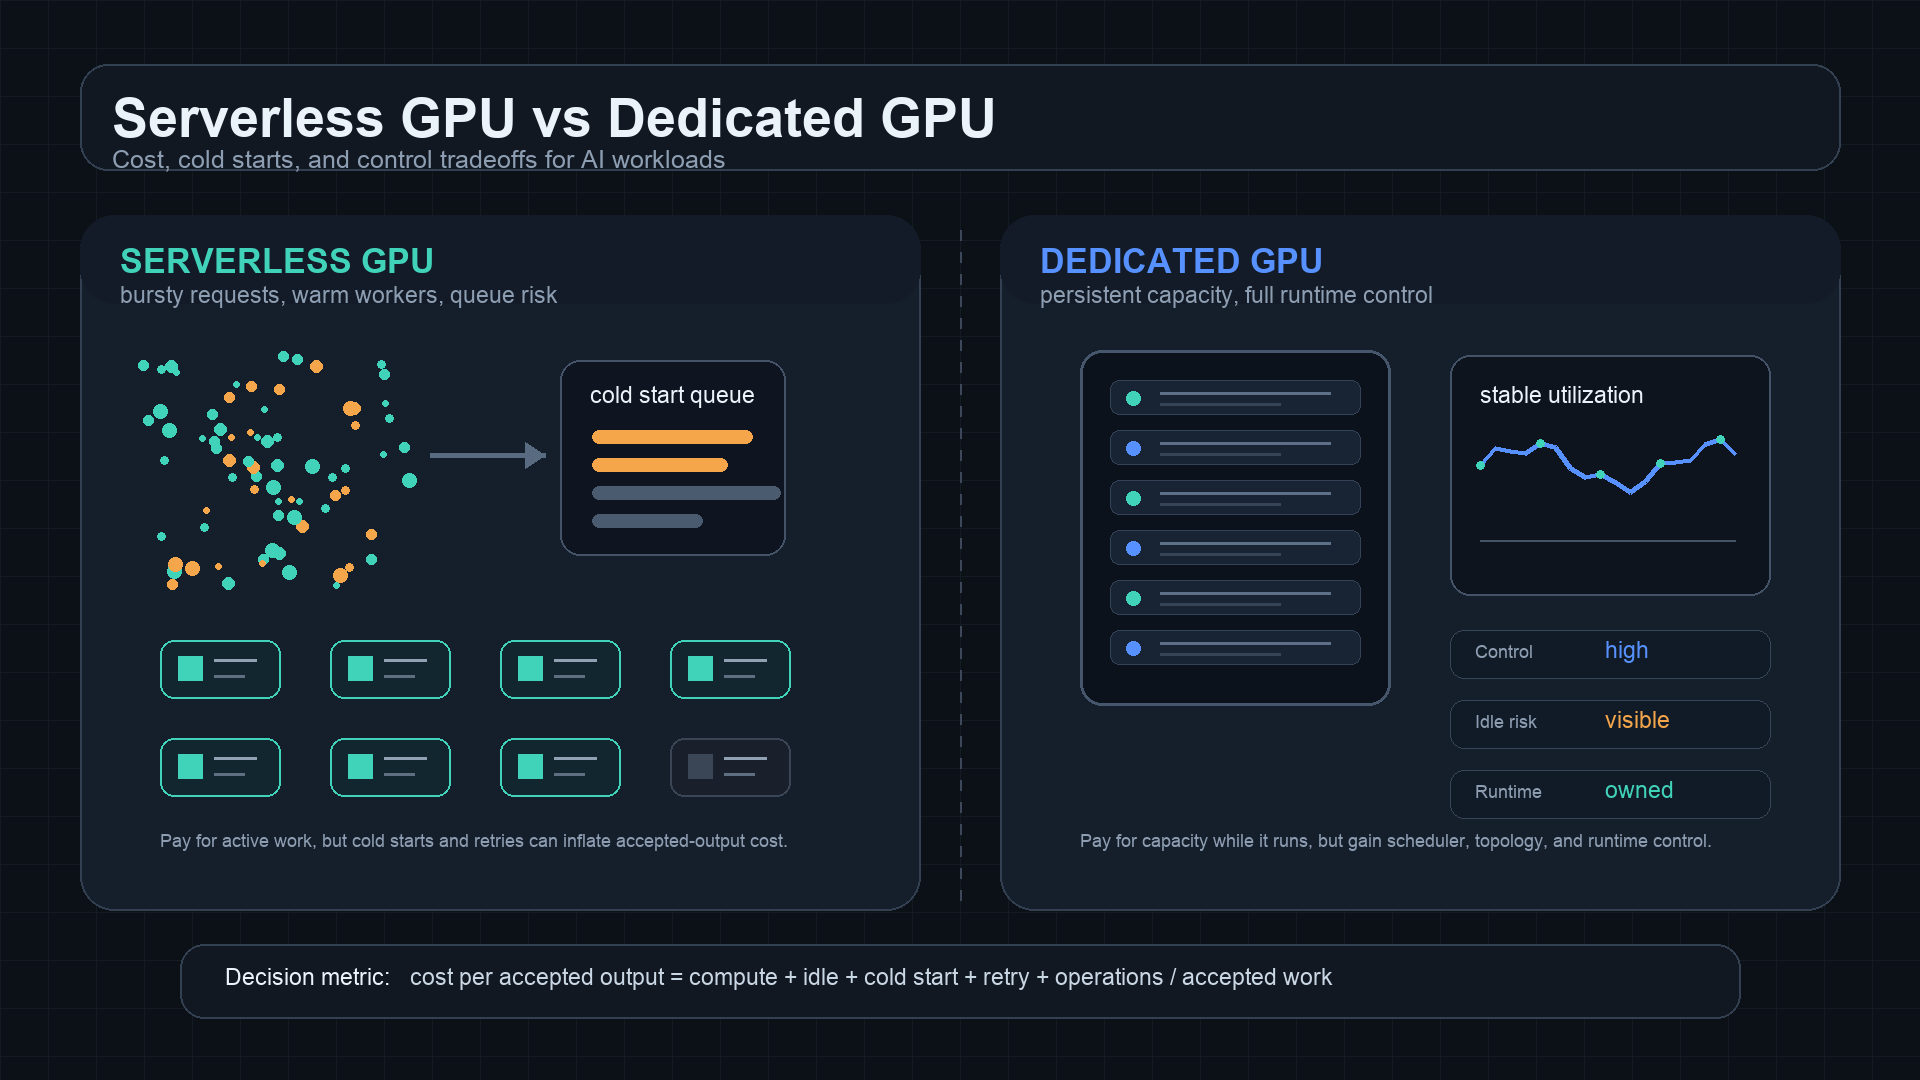
Цены для уровня 2 взяты с официальной страницы цен Claude и страницы цен OpenAI по состоянию на октябрь 2026 года: региональная обработка обычно стоит примерно на 10 процентов дороже глобальной. На уровнях 4 и 5 вместо этой надбавки вы оплачиваете GPU-мощности, которым нужно обеспечивать загрузку.
Проектирование стека суверенного ИИ
Вычисления
Для инференса и дообучения на собственной инфраструктуре практичные варианты в октябре 2026 года — NVIDIA H100, H200, B200 и B300, а также ускорители AMD серии MI300. Объем памяти определяет, насколько крупная модель поместится на каждом GPU; см. наше сравнение H200 и H100 и материал о требованиях LLM к памяти GPU. О проектировании кластеров (сети, хранилища, планирование задач) читайте в материалах об архитектуре GPU-кластера и частном GPU-облаке.
Вопросы, которые стоит задать любому поставщику GPU для суверенного развертывания:
- Какое юридическое лицо управляет дата-центром и законодательству какой страны оно подчиняется?
- Можно ли указать в договоре конкретную площадку и регион?
- У кого есть физический и удаленный административный доступ и фиксируется ли он в журналах?
- Куда поступают резервные копии, журналы и данные мониторинга?
- Сможете ли вы забрать свои данные и диски при прекращении сотрудничества?
Модели
Модели с открытыми весами — основа суверенности уровней 4 и 5: их можно размещать где угодно и продолжать использовать, даже если поставщик изменит условия. Среди распространенных вариантов — модели Mistral (разработаны во Франции), семейство Llama от Meta, а также открытые релизы Qwen и DeepSeek. Проверяйте каждую лицензию на ограничения коммерческого использования и оценивайте качество работы на местных языках на собственных данных.
Обслуживание моделей
Сервер инференса, совместимый с OpenAI, позволяет приложениям переключаться между суверенной моделью на собственной инфраструктуре и публичным API, меняя один URL. Пример с vLLM:
docker run --gpus all -p 8000:8000 \
  -v /data/models:/models \
  vllm/vllm-openai:latest \
  --model /models/your-open-weight-model \
  --tensor-parallel-size 2 \
  --max-model-len 32768
from openai import OpenAI

# Sovereign endpoint inside your in-country cluster
client = OpenAI(base_url="http://inference.internal:8000/v1", api_key="local-token")
r = client.chat.completions.create(
    model="/models/your-open-weight-model",
    messages=[{"role": "user", "content": "Summarize this contract clause."}],
)
print(r.choices[0].message.content)
Храните базовый URL в конфигурации, чтобы задачи без чувствительных данных могли использовать региональный или публичный API, а задачи, подпадающие под нормативные требования, оставались на суверенной конечной точке. В нашем руководстве по серверам инференса, совместимым с OpenAI, сравниваются vLLM, SGLang и другие решения.
Данные и эксплуатация
- Храните промпты, результаты, векторные базы данных и журналы в той же юрисдикции, что и модель.
- Используйте ключи шифрования под управлением заказчика, хранящиеся внутри страны.
- Отправляйте данные наблюдаемости в локально размещенный стек, а не в зарубежный SaaS.
- Документируйте субобработчиков; в нашем чек-листе DPA для ИИ-шлюза перечислены условия, которые стоит запросить.
Пример стоимости: суверенный сервис инференса для модели класса 70B
Согласно рыночному индексу Flatkey Compute за 23 октября 2026 года (обновлен в 02:01 UTC), ориентировочная стоимость H200 составляла $3.65 за GPU-час при оплате по требованию и $2.74 при договоре на 1 год, а H100 — $2.64 и $1.98 соответственно.
Модели класса 70B с открытыми весами в формате FP8 требуется около 70GB для весов. Один H200 (141GB) оставляет место для KV-кэша; для резервирования стоит запустить как минимум две реплики.
| Вариант | GPU | За час (по индексу) | За месяц (730 часов) |
|---|---|---|---|
| 2x H200, оплата по требованию | 2 | $7.30 | около $5,329 |
| 2x H200, договор на 1 год | 2 | $5.48 | около $4,000 |
| 4x H100 (2 реплики x 2 GPU), договор на 1 год | 4 | $7.92 | около $5,782 |
Добавьте расходы на хранилище, сеть, мониторинг и рабочее время сотрудников; в нашем руководстве по TCO GPU-кластера есть полная таблица для расчета. Сравните результат с ожидаемыми расходами на API уровня 2: если региональный API обходится дешевле кластера и отвечает вашим юридическим требованиям, обычно это лучший выбор. Цены индекса служат ориентиром; фактические цены внутри страны зависят от страны и срока договора и подтверждаются в коммерческом предложении.
Чек-лист готовности к суверенному ИИ
- Классифицируйте рабочие нагрузки по чувствительности данных и юридическим требованиям, затем назначьте каждой уровень суверенности.
- Опишите все потоки данных: промпты, результаты, эмбеддинги, журналы, резервные копии, телеметрию.
- Выберите модели, которые можно законно запускать в целевой юрисдикции, и проверьте качество их работы на местных языках.
- Выберите вычислительную инфраструктуру с указанием конкретной площадки, оператора и условий выхода.
- Предоставьте доступ к каждой модели через конечную точку, совместимую с OpenAI, чтобы приложения могли переходить между уровнями.
- Держите свидетельства для аудита (журналы доступа, версии моделей, результаты оценок) под собственным контролем для проверок по AI Act и отраслевым требованиям.
- Пересматривайте план каждые шесть месяцев: предложения региональных API и цены на GPU быстро меняются.
Частые вопросы
Что такое суверенный ИИ?
Это ИИ, созданный и работающий на инфраструктуре, данных и моделях, которые страна или организация контролирует в рамках собственного законодательства. Он включает вычисления внутри страны, локализацию данных, модели, которые можно запускать и проверять самостоятельно (часто с открытыми весами), и эксплуатацию с подотчетностью в местной юрисдикции.
Что такое инфраструктура суверенного ИИ?
Это физические и программные слои, благодаря которым возможен суверенный ИИ: GPU-дата-центры внутри страны, региональные хранилища и сети, стеки обслуживания моделей, а также эксплуатационные меры контроля и договоры, которые сохраняют доступ под местной юрисдикцией.
В каких странах есть программы суверенного ИИ?
Во многих. Среди примеров NVIDIA — Франция (ИИ-агенты для государственных услуг Министерства экономики и финансов), Индия (многоязычные модели Sarvam на отечественной инфраструктуре наряду с государственной программой IndiaAI) и Бразилия (ИИ для юридических услуг в Риу-Гранди-ду-Сул). Страны Европы, Ближнего Востока и Азии финансируют национальные вычислительные мощности и модели для местных языков.
Какие компании лидируют в инфраструктуре ИИ?
Среди лидеров часто называют NVIDIA и AMD в области ускорителей; AWS, Microsoft Azure, Google Cloud и Oracle в области облачных и суверенных облачных регионов; специализированных поставщиков GPU, таких как CoreWeave и Lambda, — в области выделенных мощностей. Для суверенных проектов юрисдикция оператора так же важна, как и бренд.
Локализация данных и суверенитет данных — это одно и то же?
Нет. Локализация данных означает, что они хранятся в определенном месте. Суверенитет данных означает, что данные подчиняются законодательству этого места и контролируются сторонами, действующими в его рамках. Сервис под управлением американской компании может обеспечивать хранение данных в ЕС, но при этом оставаться доступным для запросов в рамках юридических процедур США.
Нужны ли мне собственные GPU для суверенного ИИ?
Не всегда. Для многих задач достаточно региональных конечных точек API или суверенных облачных регионов. Выделенные GPU внутри страны оправданны, когда нужен полный контроль над моделью, требуется сохранять все данные и эксплуатацию внутри страны или есть стабильный объем задач, обеспечивающий загрузку кластера.