
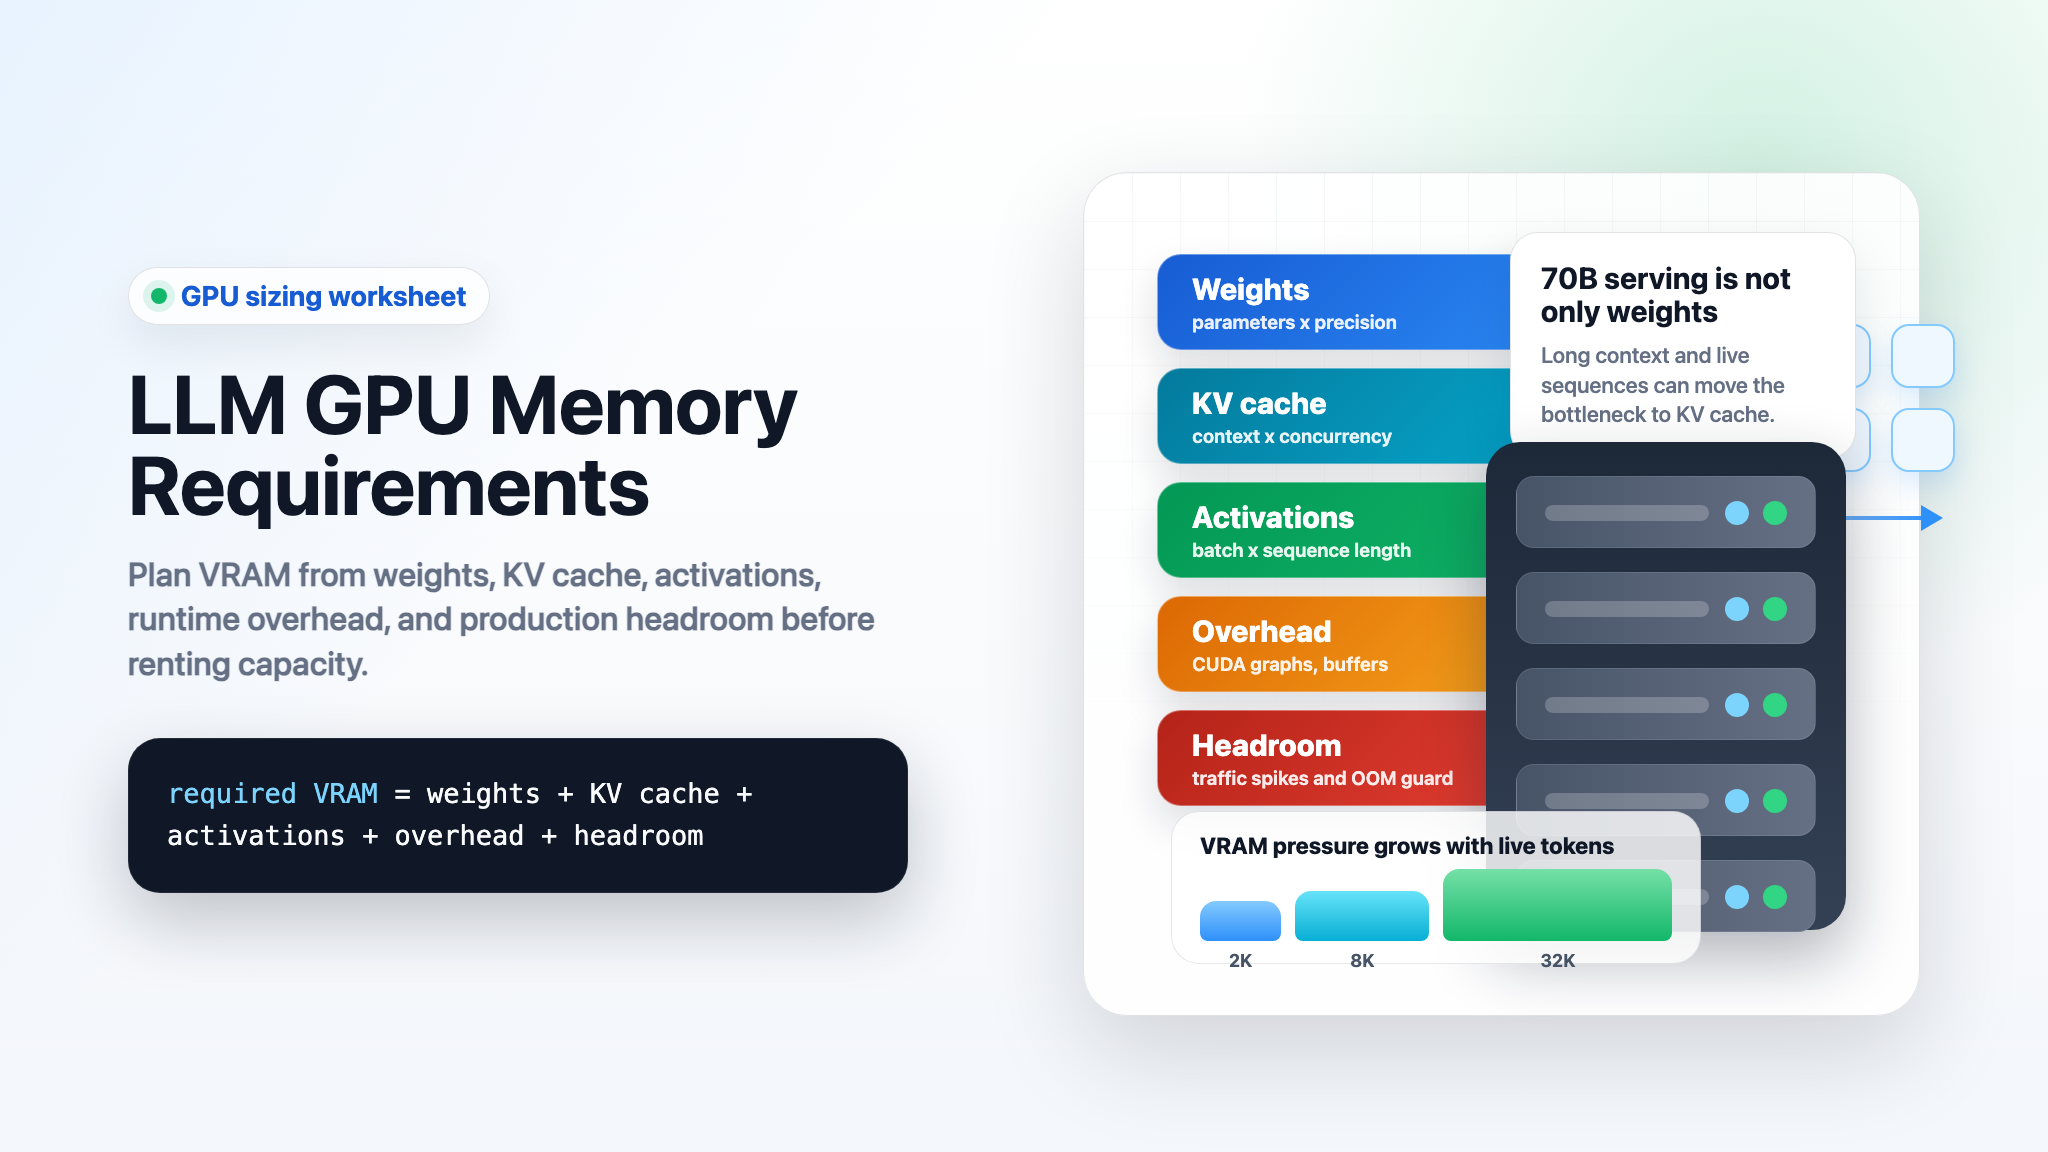
Требования к GPU-памяти для LLM — это не просто «размер модели плюс немного запаса». Для задачи инференса или обучения есть несколько отдельных категорий памяти: веса модели, KV-кэш, активации, рабочие области фреймворка, CUDA graphs, временные буферы и операционный запас.
Быстрое правило планирования такое:
required VRAM =
  model weights
+ KV cache for live tokens
+ activation and workspace memory
+ training state, if training or full fine-tuning
+ allocator and safety headroom
Именно поэтому две команды могут запускать одну и ту же модель 70B на одном и том же классе GPU и получать разные результаты. Одна использует короткие промпты, один поток, KV-кэш FP8 и консервативный batching. Другая использует длинный контекст, много одновременных запросов, захват CUDA graphs и высокое значение gpu_memory_utilization. Первая задача помещается. Вторая падает с ошибками out-of-memory или съедает задержку, перекладывая работу в другое место.
Это руководство дает практическую рабочую таблицу по llm gpu memory requirements для инференса, обслуживания в vLLM, fine-tuning и обучения. Используйте его до аренды GPU, выбора емкости H100 вместо H200 вместо B200 или решения, проще ли использовать API модели, чем поддерживать собственную GPU-точку входа.
Краткий ответ по требованиям к GPU-памяти LLM
Для инференса начните с весов, затем оцените размер KV-кэша по длине контекста и уровню параллелизма. Для обучения веса — только начало; состояния оптимизатора, градиенты и сохраненные активации доминируют в плане памяти.
| Нагрузка | Что обычно доминирует в VRAM | Быстрое правило планирования |
|---|---|---|
| Инференс одного запроса | Веса | parameters x bytes_per_weight, затем добавьте KV-кэш для промпта и сгенерированных токенов. |
| Инференс с высокой пропускной способностью | KV-кэш и запас для планировщика | Оценивайте по concurrent sequences x tokens per sequence, а не только по числу параметров модели. |
| Обслуживание с длинным контекстом | KV-кэш | Удвоение длины контекста примерно удваивает память KV-кэша для той же модели и batch. |
| Полный fine-tuning | Состояния оптимизатора, градиенты, активации | AdamW в смешанной точности может требовать во много раз больше памяти, чем сами веса модели, еще до учета активаций. |
| LoRA или адаптерный тюнинг | Базовые веса плюс активации и состояние адаптера | Гораздо меньше, чем полный fine-tuning, но длинный контекст и размер batch по-прежнему важны. |
| Pretraining | Training state плюс активации плюс распределенные накладные расходы | Планируйте по измеренному запуску фреймворка; формулы — только первый проход. |
Если вам нужны только ответы модели, сначала сравните прямое обслуживание на GPU с базовым вариантом через API модели. Прямые GPU имеют смысл, когда нужны пользовательские веса, контроль размещения, приватная политика выполнения или нагрузка, которая становится дешевле после измерения утилизации. Если вам в основном нужны надежные ответы API, управляемый маршрут к модели может избавить от недель подбора размера GPU, очередей и операционных задач.
Рабочая таблица требований к GPU-памяти LLM
Используйте эту таблицу перед выбором инстанса.
| Категория | Формула или проверка | Примечания |
|---|---|---|
| Веса | parameter_count x weight_bytes |
BF16/FP16 используют около 2 байт на параметр. INT8 — около 1 байта. 4-битный формат — около 0,5 байта до учета метаданных квантования. |
| KV-кэш | active_tokens x layers x kv_heads x head_dim x 2 x kv_bytes |
Число 2 соответствует ключам и значениям. Grouped-query attention уменьшает kv_heads по сравнению с обычным multi-head attention. |
| Активации | Инференс: обычно умеренно. Обучение: масштабируется с batch, длиной последовательности, размером скрытого слоя, числом слоев и выбором checkpointing. | В документации Hugging Face по анатомии памяти модели отдельно выделяются веса, состояния оптимизатора, градиенты, сохраненные активации, временные буферы и специфичная для функции память при обучении. |
| Резерв для serving-фреймворка | vLLM, TensorRT-LLM, SGLang, PyTorch, CUDA graphs, attention kernels, очереди планирования | vLLM предоставляет такие настройки памяти, как gpu_memory_utilization, kv_cache_memory_bytes, kv_cache_dtype, max_model_len и max_num_seqs. |
| Запас безопасности | 10-20% для production, больше во время первых бенчмарков | Оставляйте место для фрагментации аллокатора, всплесков трафика, более длинных промптов, перезагрузки модели и агентов наблюдаемости. |
Самая частая ошибка — разместить веса и забыть про живые токены. Для оценки требований к GPU-памяти LLM при инференсе KV-кэш может стать разницей между стабильной точкой обслуживания и бесконечным OOM-циклом.
Шаг 1: рассчитайте память под веса модели
Веса — самая простая часть требований к GPU-памяти для нагрузок LLM.
weight_memory_gib = parameters x bytes_per_parameter / 1024^3
| Размер модели | Веса BF16 / FP16 | Веса INT8 | 4-битные веса до учета метаданных |
|---|---|---|---|
| 7B | ~13.0 GiB | ~6.5 GiB | ~3.3 GiB |
| 13B | ~24.2 GiB | ~12.1 GiB | ~6.1 GiB |
| 34B | ~63.3 GiB | ~31.7 GiB | ~15.8 GiB |
| 70B | ~130.4 GiB | ~65.2 GiB | ~32.6 GiB |
| 405B | ~754.4 GiB | ~377.2 GiB | ~188.6 GiB |
Эта таблица — нижняя граница. В реальных развертываниях добавляются масштабы квантования, буферы не-параметров, состояние токенизатора/рантайма, временные рабочие области и накладные расходы на обслуживание.
Для оценки требований vLLM к GPU-памяти для модели 70B VRAM одни только веса BF16/FP16 уже превышают возможности одного H100 на 80 GB. Один H200 имеет 141 GB HBM3e согласно странице H200 NVIDIA, так что веса в принципе могут поместиться, но оставшийся KV-кэш и запас для работы рантайма все равно могут вынудить уменьшить контекст, снизить параллелизм, использовать квантование KV-кэша или тензорный параллелизм. NVIDIA указывает H100 SXM как 80 GB, H200 как 141 GB, а DGX B200 — как восемь GPU Blackwell с 1,440 GB общей HBM3e, что фактически означает 180 GB на один GPU B200 в этой системе.
Шаг 2: рассчитайте память KV-кэша для требований LLM к GPU-памяти
KV-кэш — это память, используемая для хранения ключей и значений attention для уже обработанных токенов. Она позволяет модели генерировать ответ, не пересчитывая каждый раз весь префикс.
Для инференса трансформера только с декодером:
kv_cache_bytes =
  active_tokens
x num_layers
x num_kv_heads
x head_dim
x 2
x bytes_per_kv_element
Где:
| Переменная | Значение |
|---|---|
active_tokens |
Сумма токенов промпта и сгенерированных токенов, которые в данный момент находятся в кэше для всех активных запросов. |
num_layers |
Количество слоев трансформера. |
num_kv_heads |
KV-головы, не всегда совпадают с attention-головами. Grouped-query attention может значительно уменьшить это число. |
head_dim |
Размерность на одну голову. |
2 |
Ключ и значение. |
bytes_per_kv_element |
2 для BF16/FP16, 1 для FP8, меньше для поддерживаемых режимов кэша с меньшей разрядностью. |
Например, конфигурация в стиле Llama 70B с 80 слоями, 8 KV-головами и размерностью головы 128 использует:
80 x 8 x 128 x 2 x 2 bytes = 327,680 bytes per token
Это около 0.3125 MiB на один активный токен в KV-кэше BF16/FP16.
| Активный контекст на последовательность | Примерный KV-кэш для одной последовательности | Примерный KV-кэш для 16 активных последовательностей |
|---|---|---|
| 2,048 токенов | ~0.6 GiB | ~10.0 GiB |
| 4,096 токенов | ~1.3 GiB | ~20.0 GiB |
| 8,192 токенов | ~2.5 GiB | ~40.0 GiB |
| 16,384 токенов | ~5.0 GiB | ~80.0 GiB |
| 32,768 токенов | ~10.0 GiB | ~160.0 GiB |
Точное значение зависит от архитектуры модели. Модель с большим числом KV-голов использует больше KV-памяти. Модель с multi-query или grouped-query attention может использовать гораздо меньше KV-памяти, чем полноценная реализация multi-head attention.
В документации vLLM описаны несколько важных параметров: --gpu-memory-utilization управляет долей памяти GPU, используемой исполнительным модулем модели, --kv-cache-memory-bytes позволяет явно задать размер KV-кэша, --kv-cache-dtype — выбрать точность кэша, а руководство по экономии памяти рекомендует уменьшать max_model_len и max_num_seqs, когда памяти не хватает. vLLM также документирует FP8 KV-кэш как способ уменьшить объем KV-кэша и поддерживать более длинный контекст или более высокую пропускную способность, при этом все равно требуется проверка точности.
Шаг 3: добавьте активации и накладные расходы рантайма
Для инференса память под активации обычно меньше, чем под веса и KV-кэш, но она не равна нулю. Prefill, CUDA graphs, attention kernels, временные буферы, мультимодальные процессоры, speculative decoding и планирование батчей могут резервировать дополнительную память.
Для обучения память под активации становится одним из ключевых факторов. В материале Hugging Face о строении памяти модели компоненты памяти при обучении перечислены как веса модели, состояния оптимизатора, градиенты, сохраненные для вычисления градиентов forward-активации, временные буферы и память для специализированных функций. Там также отмечается, что память под активации зависит от длины последовательности, скрытого размера и размера батча.
Удобное разбиение для планирования выглядит так:
| Сценарий | Подход к активациям и накладным расходам |
|---|---|
| Простой инференс, batch 1 | Оставляйте как минимум 10% запаса после учета весов и KV-кэша. |
| Обслуживание на vLLM с CUDA graphs и batching | Сначала закладывайте 15-20% запаса, затем настраивайте gpu_memory_utilization, max_model_len и max_num_seqs. |
| Обслуживание с длинным контекстом | Рассматривайте KV-кэш как главный переменный фактор и выделяйте больше запаса на всплески prefill. |
| Fine-tuning | Перед масштабированием измерьте небольшую прогонку на целевой длине последовательности; по мере роста batch и контекста активации могут стать доминирующим фактором. |
| Мультимодальные модели | Добавьте память под кэш процессора и входные медиа-данные; в руководстве vLLM по экономии памяти упоминаются кэш мультимодальности и ограничения на вход. |
Не запускайте production на 99% заполнения памяти только потому, что тестовый запрос помещается. Это не оставляет места для более длинных промптов, горячей перезагрузки, захвата CUDA graph, поведения аллокатора или потока трафика, отличающегося от бенчмарка.
Шаг 4: оцените память для обучения и fine-tuning
Память для обучения больше, потому что GPU должен хранить не только веса прямого прохода.
Для полного дообучения с mixed precision и AdamW анализ памяти Hugging Face даёт практическую разбивку: при обучении с mixed precision могут храниться копии весов FP32 и FP16/BF16, состояния оптимизатора AdamW, градиенты, сохранённые активации, временные буферы и память под функционально-специфичные нужды. На той же странице типичная схема mixed-precision AdamW суммируется как 18 байт на параметр модели плюс память под активации.
Это означает:
| Размер модели | 18 байт на параметр до учёта активаций |
|---|---|
| 7B | ~117 GiB |
| 13B | ~218 GiB |
| 34B | ~570 GiB |
| 70B | ~1,173 GiB |
Именно поэтому запросы вида gpu memory requirements LLM training требуют иного ответа, чем запросы про инференс. Модель 70B, которую можно обслуживать с tensor parallelism и квантованным KV-кэшем, не становится автоматически практичной для полного дообучения на небольшом числе GPU.
Способы снизить потребление памяти при обучении включают:
| Техника | Что она уменьшает | Компромисс |
|---|---|---|
| LoRA / QLoRA | Память под обучаемые параметры и оптимизатор | Это не то же самое, что полное дообучение; всё равно нужна память под базовую модель и активации. |
| Activation checkpointing | Память под сохранённые активации | Больше пересчётов и ниже пропускная способность обучения. |
| ZeRO / FSDP / tensor parallelism | Память на GPU под оптимизатор, градиенты, параметры или вычисления | Более сложная распределённая конфигурация и чувствительность к коммуникациям. |
| Shorter sequence length | Память под активации и attention | Может снизить качество задачи, если рабочей нагрузке нужен длинный контекст. |
| Smaller micro-batch | Память под активации | Может потребоваться accumulation градиентов, чтобы сохранить эффективный размер batch. |
Для полного обучения формулы помогают получить первую оценку формы кластера. Они не заменяют измеренный прогон фреймворка.
Шаг 5: сопоставьте требования к GPU-памяти для LLM с распространёнными объёмами памяти GPU
Используйте ёмкость GPU-памяти как ограничение, а не как единственный критерий покупки. Пропускная способность памяти, топология NVLink, сеть, хранилище, планирование и загрузка могут быть не менее важны, чем чистый объём VRAM.
| Класс GPU | Публичный ориентир по памяти | Что это обычно означает для требований LLM к GPU-памяти |
|---|---|---|
| H100 SXM | 80 GB HBM3 | Сильный вариант по умолчанию для обслуживания моделей 7B-34B и многих задач дообучения. Для 70B BF16 обычно нужны tensor parallelism или квантование. |
| H100 NVL | 94 GB на GPU, 188 GB на пару на странице NVIDIA про H100 | Предназначен для более крупного LLM-инференса в enterprise-стойках с ограничениями по питанию; всё равно нужно проверять топологию и SKU провайдера. |
| H200 | 141 GB HBM3e | Более комфортен для весов больших моделей и более длинного контекста, чем H100, но высококонкурентное обслуживание 70B всё ещё может упираться в KV-кэш. |
| B200 в DGX B200 | 1,440 GB всего на 8 GPU | Большой пул памяти для enterprise-систем обучения и инференса, с эксплуатационными требованиями, выходящими за рамки одной спецификации GPU. |
Если в вашей таблице указано, что один H200 «едва помещает» модель 70B, это не план развёртывания. Это сигнал провести бенчмарк для следующих настроек:
| Настройка | Почему это важно |
|---|---|
max_model_len |
Устанавливает верхнюю границу контекста, а значит и KV-кэша. |
max_num_seqs |
Ограничивает число одновременных последовательностей и нагрузку на планировщик. |
kv_cache_dtype |
Может сократить память KV-кэша, но требует проверки качества. |
| Tensor parallel size | Распределяет работу модели между GPU; также меняет потребности в коммуникациях. |
| Quantization format | Сжимает веса, а иногда и KV-кэш; может влиять на качество и поддержку kernels. |
| Целевая p95 latency | Более высокопроизводительные настройки могут ухудшить задержку даже при достатке памяти. |
Для деталей выбора оборудования используйте этот worksheet вместе с гайдами Flatkey: best GPU for LLM inference, H200 vs H100 и B200 vs H200.
Пример: расчёт размеров для инференса 70B в vLLM
Ниже приведён консервативный способ оценить vllm gpu memory requirements 70b model vram до аренды ресурсов.
Предположим:
| Вход | Значение |
|---|---|
| Веса модели | 70B параметров |
| Точность весов | BF16 / FP16 |
| Память под веса | ~130.4 GiB |
| Форма KV-кэша | 80 layers, 8 KV heads, 128 head dimension |
| Точность KV | BF16 / FP16 |
| KV на активный токен | ~0.3125 MiB |
Затем сравните несколько вариантов обслуживания:
| Целевой сценарий обслуживания | Примерный объём KV-кэша | Почему это важно |
|---|---|---|
| 1 активная последовательность, 4K токенов | ~1.3 GiB | Веса доминируют. Одна большая GPU может поместиться только при небольшом запасе. |
| 8 активных последовательностей, 4K токенов | ~10.0 GiB | Требуется реальный запас сверх весов. |
| 16 активных последовательностей, 8K токенов | ~40.0 GiB | План с одной GPU обычно ненадёжен, если только веса или KV-кэш не квантизированы. |
| 16 активных последовательностей, 16K токенов | ~80.0 GiB | Один только KV-кэш — это примерно объём памяти одного H100 SXM. |
С точки зрения эксплуатации, план на 70B в vLLM обычно попадает в один из следующих сценариев:
| Сценарий | Подходит |
|---|---|
| BF16-веса, низкая конкуррентность, меньший контекст | Память уровня H200 может подойти после проверки накладных расходов. |
| BF16-веса, production-конкуррентность | Используйте tensor parallelism и проверьте сеть/топологию. |
| Квантизированные веса, KV-кэш BF16/FP16 | Хороший первый бенчмарк, если качество допускает квантизацию весов. |
| Квантизированные веса плюс FP8 KV-кэш | Может открыть более длинный контекст или большую конкуррентность, но требует проверки точности и задержек. |
| Нет требования к управлению оборудованием | Сравните путь через API модели, прежде чем переходить к эксплуатации GPU. |
Это практический ответ на вопрос о gpu memory requirements for LLM при обслуживании: число параметров показывает, загрузится ли модель; KV-кэш и резерв времени выполнения показывают, сможет ли она обслуживать полезный трафик.
Почему длина контекста меняет ответ
Длинный контекст дорог, потому что кэш растёт вместе с количеством активных токенов. Если увеличить контекст с 8K до 16K, KV-кэш для той же модели, точности и конкуррентности примерно удвоится. Если удвоить конкуррентность при том же контексте, KV-кэш снова примерно удвоится.
Для команд, сравнивающих планы llm hardware requirements gpu memory, это даёт простую схему расчёта размера:
больше пользователей x более длинные промпты x больше выходных токенов = больше KV-кэша
Прежде чем арендовать более мощную GPU, спросите, действительно ли продукту нужен максимальный контекст для каждого запроса. Многие системы могут маршрутизировать:
| Тип запроса | Политика экономии памяти |
|---|---|
| Короткий чат или извлечение | Меньший лимит контекста, более высокая конкуррентность. |
| Анализ длинных документов | Более высокий лимит контекста, меньший пул конкуррентности. |
| Пакетные задачи | Очередь по бюджету токенов, а не только по числу запросов. |
| Премиальные нагрузки | Выделенный пул с явным максимальным контекстом и целевым p95. |
Часто это дешевле и стабильнее, чем запуск одного огромного endpoint'а с одним глобальным параметром памяти.
Что измерять в первом бенчмарке
Запустите бенчмарк, похожий на production-трафик, а не один удачный запрос.
| Метрика | Почему она нужна в первом бенчмарке |
|---|---|
| Пиковый выделенный и зарезервированный объём VRAM | Показывает запас аллокатора и фреймворка, а не только математику тензоров. |
| Задержка prefill | Длинные промпты нагружают пропускную способность памяти и attention-ядра. |
| Токены decode в секунду | Показывает устойчивую пропускную способность генерации. |
| Задержка p95 и p99 | Не позволяет конфигурации, оптимизированной только под throughput, вредить пользователям. |
| Частота OOM | Отслеживает сбои памяти на реальном миксе трафика. |
| Использование KV-кэша | Показывает, что является узким местом — контекст/конкуррентность или веса. |
| Стоимость принятого вывода | Связывает стоимость аренды GPU с полезными завершениями, а не с сырыми токенами. |
Для многонодовых развёртываний дополните это чек-листами GPU cluster architecture и GPU cluster TCO. Модель, которая помещается в память, всё равно может оказаться дорогой, если сеть, хранилище, очереди или утилизация организованы плохо.
Типичные ошибки
| Ошибка | Лучший подход |
|---|---|
| Оценка только по числу параметров | Добавляйте KV-кэш, активации, резерв фреймворка и запас. |
| Считать, что «помещается один раз» означает готовность к production | Тестируйте целевой контекст, конкуррентность, длину вывода и поведение при повторных попытках. |
| Игнорирование точности KV-кэша | Проверяйте FP8 или другие форматы кэша, когда узкое место — память. |
| Использование названия GPU у провайдера без точного SKU | Подтверждайте ёмкость памяти, интерконнект, политику MIG, стек драйверов и то, являются ли GPU общими. |
| Предположение, что память для обучения равна памяти для inference | Обучение добавляет состояния оптимизатора, градиенты, сохранённые активации и распределённые накладные расходы. |
Слишком агрессивное использование gpu_memory_utilization |
Оставляйте достаточный резерв для CUDA graphs, буферов, всплесков трафика и поведения аллокатора. |
Руководство по выбору: арендовать GPU или использовать API модели?
Прямая GPU-мощность — правильный выбор, когда вам нужно одно или несколько из следующего:
| Выбирайте прямые GPU, когда... | Выбирайте базовый API модели, когда... |
|---|---|
| Вы обслуживаете собственные веса или приватные дообученные модели. | Вы используете распространённые размещённые модели и в основном нуждаетесь в надёжных ответах. |
| Вам нужен контроль над размещением, изоляцией или временем выполнения. | Вы не хотите управлять очередями, автоскейлингом, образами, драйверами и сбоями GPU. |
| Измеренная загрузка достаточно высока, чтобы превзойти экономику API. | Трафик носит всплесковый характер, на ранней стадии или его трудно прогнозировать. |
| Вы можете сами отвечать за бенчмаркинг и реагирование на инциденты. | Ваша команда предпочла бы тратить инженерное время на логику продукта. |
Flatkey полезен как базовый путь, когда контроль над железом не является требованием продукта. Он даёт командам одну точку сравнения между официальными моделями и инструментами, так что вы можете сопоставить стоимость аренды GPU со стоимостью вывода через API модели, прежде чем брать на себя обязательства по длительно работающему кластеру. Если бенчмарк покажет, что прямые GPU выигрывают, используйте приведённую выше таблицу памяти, чтобы арендовать минимально надёжный конфиг вместо самого большого и впечатляющего.
Часто задаваемые вопросы
Сколько GPU-памяти нужно 70B LLM?
Весам BF16 или FP16 для модели 70B требуется около 130 GiB ещё до KV-кэша и накладных расходов времени выполнения. Веса INT8 занимают около 65 GiB до метаданных. Веса 4-bit занимают около 33 GiB до метаданных квантизации. Для продуктивного инференса добавьте KV-кэш для контекста и параллельности, резерв фреймворка обслуживания и запас по безопасности.
Почему модель загружается, но падает под нагрузкой?
Тест загрузки может помещать только веса. Реальный трафик добавляет KV-кэш для активных промптов и сгенерированных токенов, накладные расходы батчинга, временные буферы и резервы фреймворка. Более длинные промпты и большее число параллельных последовательностей могут привести ту же модель к OOM.
Что больше всего влияет на требования LLM inference к GPU-памяти?
Наибольшие переменные — размер модели, точность весов, длина контекста, число одновременных последовательностей, точность KV-кэша и настройки фреймворка обслуживания. При обслуживании длинного контекста узким местом часто становится KV-кэш.
Что влияет на аппаратные требования LLM к GPU-памяти при обучении?
Обучение добавляет состояния оптимизатора, градиенты, сохранённые активации, временные буферы и накладные расходы распределённого фреймворка. Размер батча, длина последовательности, checkpointing активаций, выбор оптимизатора и стратегия шардинга могут кардинально изменить требуемое число GPU.
Снижает ли vLLM требования к GPU-памяти?
vLLM даёт полезные средства управления памятью и эффективное управление KV-кэшем, но не отменяет базовый бюджет памяти. Вам всё равно нужна достаточная VRAM для весов, KV-кэша, активаций, резерва времени выполнения и запаса. Его средства управления памятью помогают выбрать компромисс между длиной контекста, параллельностью, точностью и пропускной способностью.
Может ли FP8 KV-кэш решить проблему нехватки памяти при длинном контексте?
Это может уменьшить объём KV-кэша, и в документации vLLM поддерживается FP8 KV-кэш. Рассматривайте это как настройку для бенчмарка, а не как бесплатный переключатель: проверьте качество вывода, задержку, поддерживаемые аппаратные/программные пути и поведение при сбоях, прежде чем использовать это в продакшене.
Финальный чек-лист
Прежде чем арендовать мощность, ответьте на следующие вопросы:
- Какой размер модели и какая точность весов у вас обслуживаются?
- Какова максимальная длина контекста, которую пользователи реально могут отправить?
- Сколько одновременных последовательностей должно помещаться при нагрузке p95?
- Какую длину вывода вы резервируете для генерации?
- KV-кэш использует BF16/FP16, FP8 или другой поддерживаемый формат?
- Какой запас остаётся после весов и KV-кэша?
- Используете ли вы tensor parallelism, квантизацию, LoRA, FSDP или ZeRO?
- Какую точную SKU GPU, ёмкость памяти и топологию выделит провайдер?
- Какие пороги OOM, задержки и стоимости за принятый вывод определяют успех?
- Если вам не нужен контроль над железом, какова стоимость базового API модели?
Лучший прогноз требований llm gpu memory — тот, который выдерживает бенчмарк, имитирующий продакшен. Используйте таблицу, чтобы быстро отбраковать невозможные конфигурации GPU, затем проверьте короткий список на реальных длинах контекста, реальной параллельности и с достаточным запасом, чтобы оставаться в сети.
Источники
- Аргументы движка vLLM:
gpu_memory_utilization,kv_cache_memory_bytes,kv_cache_dtypeи связанные элементы управления кэшем: https://docs.vllm.ai/en/latest/configuration/engine_args.html - Руководство vLLM по экономии памяти: tensor parallelism, квантизация, длина контекста, размер батча, память CUDA graph и средства управления памятью для мультимодальных сценариев: https://docs.vllm.ai/en/latest/configuration/conserving_memory/
- Руководство vLLM по квантизированному KV-кэшу: варианты FP8 KV-кэша и компромиссы: https://docs.vllm.ai/en/latest/features/quantization/quantized_kvcache.html
- Анатомия памяти моделей Hugging Face Transformers: категории памяти при обучении, состояния оптимизатора, градиенты, активации и примечания по смешанной точности: https://huggingface.co/docs/transformers/v4.57.1/en/model_memory_anatomy
- Страница продукта NVIDIA H100: память H100, пропускная способность, H100 NVL и позиционирование для LLM: https://www.nvidia.com/en-us/data-center/h100/
- Страница продукта NVIDIA H200: 141 GB HBM3e и пропускная способность памяти: https://www.nvidia.com/en-us/data-center/h200/
- Страница продукта NVIDIA DGX B200: восемь GPU B200 и 1,440 GB общей HBM3e: https://www.nvidia.com/en-us/data-center/dgx-b200/


