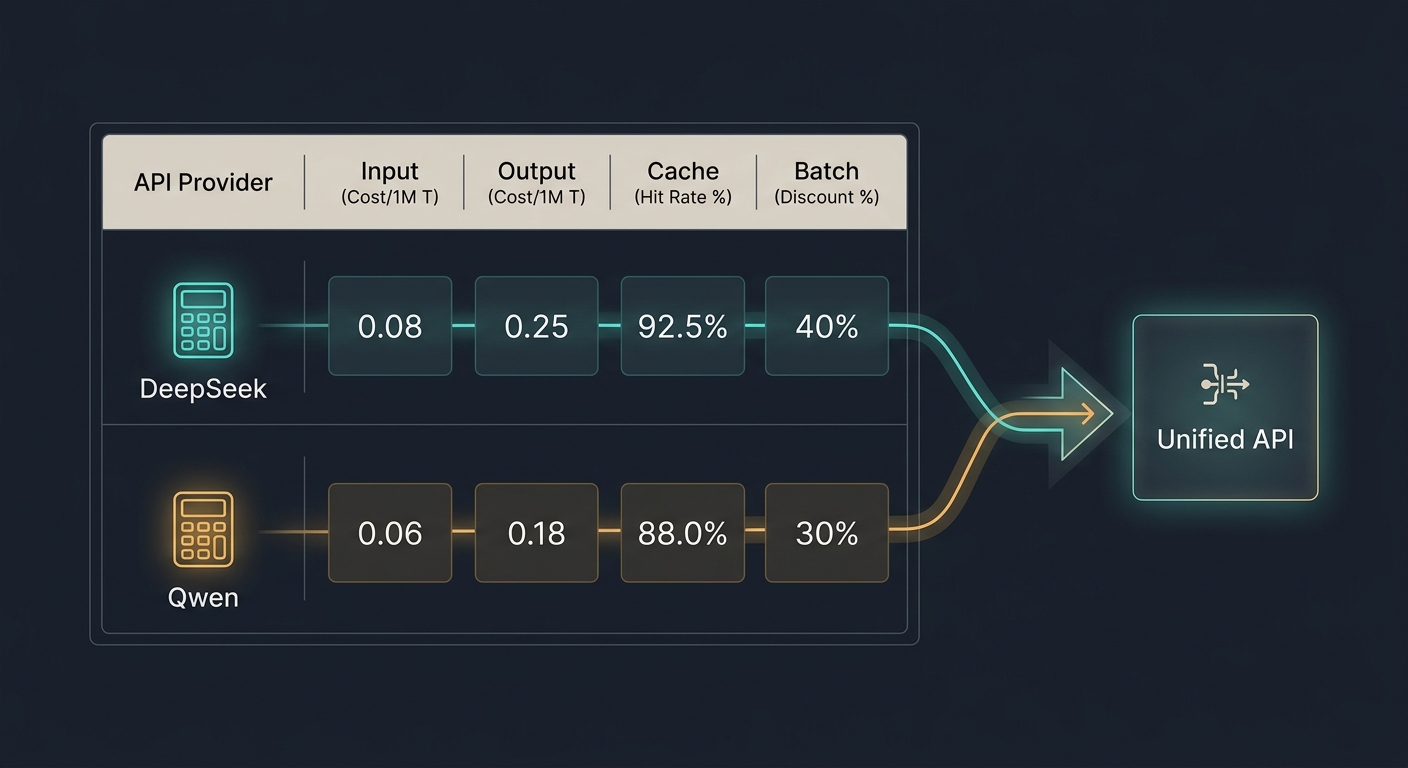
Если вы выбираете между DeepSeek API и Qwen API для продукта, чувствительного к бюджету, не начинайте с одной броской цены за токен. Начните со структуры вашей рабочей нагрузки.
Полезное руководство по DeepSeek API vs Qwen API для задач с чувствительностью к стоимости: руководство по затратам на 2026 год должно сравнивать как минимум шесть вещей: входные токены, выходные токены, попадания в кэш, промахи кэша, возможность пакетной обработки и операционные затраты на последующую смену маршрутов.
Это руководство было проверено по официальной документации поставщиков на 23 сентября 2026 года. Оно написано для indie hackers и небольших команд, создающих ИИ-продукты, которым нужна минимально возможная надежная стоимость за принятый запрос, а не рекордный бенчмарк.
Коротко:
- В первую очередь выбирайте Qwen для простого чата с высоким объемом, асинхронных пакетных задач и рабочих процессов, которые могут использовать пакетный inference Qwen или явные/неявные правила кэша.
- В первую очередь выбирайте DeepSeek, если вам нужен более простой глобальный endpoint в формате OpenAI, явные строки токенов для пиковых/непиковых периодов, автоматический учет попаданий и промахов кэша или если качество DeepSeek Flash уже достаточно хорошее для вашего продукта.
- Используйте маршрутизатор и журнал учета использования, когда ожидаемая экономия токенов настолько мала, что настройка провайдера, поведение повторных попыток, разрозненные балансы или работа по миграции могут съесть скидку.
DeepSeek API vs Qwen API для рабочих нагрузок, чувствительных к стоимости: таблица решений
| Шаблон рабочей нагрузки | Текущий ценовой сигнал | Семейство моделей, которое стоит тестировать первым | Что может изменить ответ |
|---|---|---|---|
| Короткий чат без кэша | Строки семейства Qwen Flash могут быть ниже по расчету на основе прайс-листа | Qwen | Длина вывода, регион, точный snapshot Qwen, доля прохождения качества |
| Асинхронная оценка или разметка | Пакетный inference Qwen тарифицирует успешные запросы по 50% от тарифа real-time inference | Qwen | Доступность пакетной обработки, допустимое время выполнения, недоступные скидки на кэш в batch |
| Повторяющийся длинный контекст | У обоих провайдеров есть механизмы кэша; DeepSeek напрямую показывает строки попаданий/промахов, у Qwen есть явные и неявные режимы кэша | Тестировать оба | Фактическая доля попаданий в кэш, накладные расходы на создание кэша, специфичные для провайдера поля кэша |
| Вывод с интенсивным reasoning | Победитель зависит от того, проходит ли порог качества Qwen Plus, Qwen Max, DeepSeek Flash или DeepSeek Pro | Нет явного победителя | Thinking-токены, повторные попытки, длина ответа, доля принятия |
| Простая прямая настройка | DeepSeek публикует один base URL в формате OpenAI; настройка Qwen зависит от региона и workspace | DeepSeek | Требования к региону данных, закупки, уже существующий footprint в Alibaba Cloud |
| Частое переключение моделей | Экономия токенов может быть потеряна из-за накладных расходов на интеграцию и биллинг | Общий слой маршрутизации | Доступность моделей, план отката, единые логи |
Эта таблица не является рейтингом качества. Это инструмент первичной оценки стоимости. Правильное сравнение — это стоимость за принятый запрос, а не стоимость за один миллион входных токенов.
Что изменилось с ценового обзора за июль 2026 года
Предыдущий ценовой обзор Flatkey для этого URL использовал DeepSeek V4 Flash и V4 Pro в качестве базы и считал Qwen Flash устойчивой недорогой строкой Qwen. Текущие страницы провайдеров делают сравнение более нюансированным.
Теперь DeepSeek сообщает пользователям API, что в качестве имени модели нужно использовать deepseek-flash. В документации указано, что устаревшие имена, такие как deepseek-v4-flash, по-прежнему принимаются, но запросы обслуживаются DeepSeek-V4.1-Flash и тарифицируются по цене Flash. DeepSeek также публикует цены в пиковые и непиковые часы, поэтому рабочий процесс, который запускается по выходным или вне пиковых UTC-окон, может иметь иную структуру затрат, чем рабочий процесс, выполняемый в пиковые часы.
Alibaba Cloud Model Studio теперь показывает несколько строк семейства Qwen Flash в разных версиях модели и регионах развертывания, включая qwen3.8-flash, qwen3.7-flash и qwen-flash. На той же странице также отдельно указаны региональные цены и область развертывания, поэтому одной цены Qwen недостаточно для согласования. Точный идентификатор модели и регион имеют значение.
Для руководства по затратам на 2026 год это означает, что первое правило простое: сначала нормализуйте данные по точному идентификатору модели, региону, правилу кэширования и режиму выполнения, а уже потом сравнивайте провайдеров.
Текущий снимок цен первого источника
Все цены ниже — это публичные базовые цены за один миллион токенов, как указано в официальной документации первого источника на 23 сентября 2026 года. Не рассматривайте их как договорные. Перед переносом трафика проверьте страницу провайдера и свой аккаунт.
Строки цен API DeepSeek
На странице цен DeepSeek указаны deepseek-flash и deepseek-v4-pro, оба с длиной контекста 1M и максимальным выводом 384K.
| Модель | Вход, попадание в кэш, вне пика | Вход, промах кэша, вне пика | Вывод, вне пика | Вход, попадание в кэш, пик | Вход, промах кэша, пик | Вывод, пик |
|---|---|---|---|---|---|---|
deepseek-flash | $0.003 | $0.15 | $0.60 | $0.006 | $0.30 | $1.20 |
deepseek-v4-pro | $0.022 | $0.66 | $1.98 | $0.044 | $1.32 | $3.96 |
DeepSeek также публикует:
- Базовый URL в формате OpenAI:
https://api.deepseek.com - Базовый URL в формате Anthropic:
https://api.deepseek.com/anthropic - автоматическое кэширование контекста
prompt_cache_hit_tokensиprompt_cache_miss_tokensв usage- пиковые часы с 01:00-04:00 и 06:00-10:00 UTC, с понедельника по пятницу, за исключением китайских государственных праздников
Практическое преимущество — в прозрачности. Вы можете отдельно рассчитать вход при попадании в кэш, вход при промахе кэша и вывод, не гадая, какие входные токены были со скидкой.
Строки цен API Qwen
На странице цен Alibaba Cloud Model Studio указано множество строк Qwen. Наиболее релевантные строки семейства Flash для текстовых рабочих процессов, чувствительных к стоимости, включают:
| Строка модели | Пример сигнала по прайс-листу | Почему это важно |
|---|---|---|
qwen3.8-flash | В одной видимой международной строке указаны $0.15 за вход и $0.47 за выход; в других регионах цифры отличаются | Более новая семейство Flash; проверьте регион и точный маршрут |
qwen3.7-flash | В одной видимой международной строке указаны $0.030 за вход и $0.130 за выход; в других регионах цифры отличаются | Часто очень выгодный кандидат по прайс-листу, если качества достаточно |
qwen-flash | В одной видимой международной строке указаны $0.05 за вход и $0.40 за выход; в других регионах значения могут отличаться | Надёжная базовая строка для простых недорогих задач |
qwen-plus | В одной видимой строке указаны $0.40 за вход и $1.20 за выход | Полезно, когда качества Flash недостаточно |
qwen3.7-plus | В одной видимой строке указаны $0.40 за вход и $1.60 за выход | Полезно для более сложных задач рассуждения или генерации |
qwen3.8-max / qwen3.7-max | В строках указаны существенно более высокие цены за вход и выход | Тестируйте только если Plus/Flash не проходят качественные пороги |
Qwen также публикует:
- совместимые с OpenAI чат-интерфейсы
- базовые URL, зависящие от региона/рабочего пространства
- API-ключи, которые должны соответствовать региону конечной точки
- пакетный вывод для поддерживаемых моделей по цене 50% от стоимости инференса в реальном времени для успешных запросов
- явные и неявные режимы кэша контекста, с полями токенов cache-hit в usage
Практическое преимущество — в ширине дисконта. Если ваша нагрузка может выполняться асинхронно или стабильно попадать в кэш Qwen, эффективная цена Qwen может быть значительно ниже простой строки для инференса в реальном времени.
Три расчёта для рабочих нагрузок
Эти примеры сравнивают только форму биллинга. Они не утверждают эквивалентное качество, задержку, надёжность или поведение безопасности.
Сценарий 1: короткий чат без кэша
Предположим:
- 10,000 запросов
- 1,000 токенов входа на запрос
- 500 токенов выхода на запрос
- нет попаданий в кэш
- нет пакетного режима
| Маршрут | Расчёт | Оценочная стоимость токенов по прайс-листу |
|---|---|---|
пример строки qwen-flash | 10M входа по $0.05 + 5M выхода по $0.40 | $2.50 |
пример строки qwen3.8-flash | 10M входа по $0.15 + 5M выхода по $0.47 | $3.85 |
deepseek-flash, вне пика | 10M входа с промахом кэша по $0.15 + 5M выхода по $0.60 | $4.50 |
deepseek-flash, пик | 10M входа с промахом кэша по $0.30 + 5M выхода по $1.20 | $9.00 |
Для короткого чата без кэша Qwen — первый кандидат по стоимости. DeepSeek всё ещё может выиграть, если у него выше доля успешных прохождений по качеству, требуется меньше повторных попыток или операционная простота важнее, чем абсолютный разброс по токенам.
Сценарий 2: длинный контекст с повторным использованием
Предположим:
- 10,000 запросов
- 10,000 входных токенов на запрос
- 1,000 выходных токенов на запрос
- 90% входных токенов попадают в кеш после прогрева
- без пакетного режима
| Маршрут | Допущение по кешу | Оценочная стоимость токенов по прайс-листу |
|---|---|---|
deepseek-flash, вне пика | 90M входных токенов с попаданием по $0.003, 10M входных токенов с промахом по $0.15, 10M выходных токенов по $0.60 | $7.77 |
deepseek-flash, пик | 90M входных токенов с попаданием по $0.006, 10M входных токенов с промахом по $0.30, 10M выходных токенов по $1.20 | $15.54 |
пример строки qwen-flash с 20% неявным кешированием входа | 90M входных токенов из кеша по $0.01, 10M обычных входных токенов по $0.05, 10M выходных токенов по $0.40 | $5.40 |
Именно здесь старое правило большого пальца может дать сбой. DeepSeek предоставляет очень понятные строки для попадания в кеш и промаха мимо кеша, но текущая документация Qwen по кешу говорит, что многие модели с неявным кешем тарифицируют кешированный вход как процент от обычного входа, при этом также указываются исключения для конкретных моделей. Если ваш рабочий процесс зависит от экономии на кеше, не утверждайте ни одного провайдера только по таблице. Логируйте фактическое количество токенов с попаданием в кеш из ответа API.
Сценарий 3: пакетируемая оценка
Предположим ту же короткую чат-структуру, что и в Сценарии 1, но задача может подождать асинхронной пакетной обработки и использует поддерживаемую batch-модель Qwen.
| Маршрут | Расчёт | Оценочная стоимость токенов по прайс-листу |
|---|---|---|
реальное время qwen-flash, пример строки | То же, что и в Сценарии 1 | $2.50 |
qwen-flash batch eligible | 50% от стоимости токенов успешного запроса в реальном времени | $1.25 |
deepseek-flash, внепиковое реальное время | То же, что и в Сценарии 1 | $4.50 |
Для наборов для оценки, ночной разметки данных, офлайн-обогащения и регрессионного тестирования пакетный inference Qwen обычно является первым вариантом по затратам, который стоит проверить. Компромисс — это задержка и механика: batch-задачи требуют входных данных в JSONL, одной модели на файл, опроса, обработки файла результатов и проверок на приемку.
Калькулятор, который должны использовать indie-хакеры
Используйте это перед переключением моделей:
accepted task cost =
  cache_miss_input_tokens * cache_miss_input_rate
  + cache_hit_input_tokens * cache_hit_input_rate
  + output_tokens * output_rate
  - verified_batch_discount
  + retry_tokens
  + fallback_tokens
  + migration_operating_cost
----------------------------------------------------
  accepted_tasks
Затем отслеживайте эти поля для каждого кандидата-маршрута:
| Поле | Почему это важно |
|---|---|
| Точный ID модели | Плавающие псевдонимы и снимки на определённую дату могут вести себя по-разному |
| Регион и endpoint | API-ключи Qwen привязаны к региону; несовпадение endpoint может привести к ошибкам аутентификации |
| Режим выполнения | Real-time, batch, cache и router fallback используют разные предположения о тарификации |
| Входные токены | Длинные промпты делают важными cache и усечение промпта |
| Выходные токены | Вывод часто доминирует в затратах на генерацию и рассуждение |
| Токены с попаданием в кэш | Предположения о кэше не являются экономией, пока это не подтверждают логи |
| Количество повторных попыток | Более дешёвая модель, которая делает больше повторов, может стоить дороже |
| Доля принятых задач | Сбои качества — это скрытая стоимость |
| Время выполнения | Пиковые и внепиковые тарифы DeepSeek могут менять стоимость одной и той же задачи |
| Работы по миграции | Работа над SDK, endpoint, регионом, логированием и откатом имеет реальную стоимость |
Различия в настройке API, влияющие на стоимость
Настройка DeepSeek с операционной точки зрения проста. Для вызовов, совместимых с OpenAI, базовый URL — https://api.deepseek.com, а текущие имена моделей включают deepseek-flash и deepseek-v4-pro. Для многих небольших команд это важно, потому что время на настройку — это тоже затраты.
У Qwen настройка даёт больше вариантов. Model Studio поддерживает вызовы, совместимые с OpenAI, но базовый URL зависит от региона и рабочего пространства. В документации указано, что API-ключи привязаны к региону, в котором были созданы, и ключ из одного региона может не работать с endpoint другого региона. Это не критический недостаток, но его нужно учитывать в сравнении затрат.
Если вы запускаете небольшой продукт, скрытая работа часто выглядит так:
- Добавить учитывающий регион base URL для Qwen.
- Создать API-ключи в правильном регионе.
- Проверить точный ID модели Qwen в этом регионе.
- Подтвердить, поддерживается ли batch inference для этой модели.
- Подтвердить, применяется ли явный или неявный кэш.
- Проверить, сообщает ли usage о токенах из кэша.
- Добавить routing отката, если маршрут не проходит пороги качества или задержки.
Именно поэтому один router с одним ключом может быть полезен даже команде, ориентированной на экономию. Flatkey даёт командам одну OpenAI-совместимую точку входа, один баланс, один счёт, обнаружение моделей и просмотр использования across providers. Перед запуском в production всё равно нужно проверить доступность моделей и цены, но операционное сравнение становится чище, потому что данные о тарификации и запросах находятся в одном месте.
Когда DeepSeek — лучший выбор по стоимости
DeepSeek — лучший первый тест, если:
- Вам нужен один простой прямой endpoint провайдера.
- Ваш рабочий процесс может выполняться в внепиковые окна.
- В промпте есть повторяющиеся префиксы и токены cache-hit в DeepSeek стабильно учитываются.
- Качества
deepseek-flashдостаточно для задачи. - Вам нужны понятные строки цены для cache-hit, cache-miss и output в одной таблице тарифов.
- Ваша команда предпочла бы избежать управления ключами по регионам и рабочим пространствам.
Важное предупреждение — стоимость вывода. DeepSeek Flash может быть очень привлекательным, когда число попаданий во входной кэш высоко, но длинные ответы всё равно оплачиваются по ставкам output. Если модель выдаёт многословные ответы или требует повторных попыток, экономия от базовой цены может исчезнуть.
Когда Qwen — лучший выбор по стоимости
Qwen — лучший первый тест, когда:
- Вы можете использовать недорогую строку семейства Flash в нужном вам регионе.
- Ваш рабочий процесс может выполняться через пакетную инференцию.
- Ваши промпты могут использовать неявный или явный кэш.
- Вы уже используете Alibaba Cloud или вам нужны конкретные семейства моделей Qwen.
- Вам нужен более широкий набор снимков Qwen для компромиссов между качеством и стоимостью.
- Вы можете работать с эндпоинтом и API-ключом, привязанными к региону.
Предупреждение — сложность. У Qwen много строк, регионов, версий моделей и исключений кэша. Вам нужен сохранённый обзор маршрута, а не просто цена, скопированная из таблицы.
Шаблон обзора маршрута на 30 минут
Скопируйте это перед изменением производственного трафика:
decision_date: 2026-09-23
workflow: ""
current_route:
  provider: ""
  model_id: ""
  region: ""
  endpoint: ""
candidate_routes:
  - provider: deepseek
    model_id: deepseek-flash
    execution_mode: realtime
    pricing_checked_url: https://api-docs.deepseek.com/quick_start/pricing
    cache_fields_to_log:
      - prompt_cache_hit_tokens
      - prompt_cache_miss_tokens
  - provider: qwen
    model_id: ""
    region: ""
    execution_mode: realtime_or_batch
    pricing_checked_url: https://docs.modelstudio.console.alibabacloud.com/en/model-studio/model-pricing
    cache_fields_to_log:
      - cached_tokens
acceptance_gate:
  sample_size: 100
  minimum_quality_pass_rate: ""
  maximum_retry_rate: ""
  maximum_p95_latency: ""
  maximum_cost_per_accepted_task: ""
rollback:
  owner: ""
  fallback_model_id: ""
  spend_limit: ""
  review_date: ""
Практическая рекомендация
Для большинства недорогих независимых рабочих процессов начинайте в таком порядке:
- Проверьте самую дешёвую строку семейства Qwen Flash, доступную в нужном вам регионе.
- Если рабочий процесс асинхронный, протестируйте пакетную инференцию Qwen.
- Если в промпте есть повторяющийся контекст, сравните поля кэша Qwen и поля кэша DeepSeek бок о бок.
- Протестируйте
deepseek-flashв часы низкой нагрузки, если важны простая настройка или качество DeepSeek. - Используйте Plus, Max или DeepSeek Pro только после того, как более дешёвый маршрут не пройдёт тест приемки.
- Используйте общий шлюз, когда переключение, fallback или подтверждение биллинга становятся частью операционных затрат.
Не утверждайте маршрут, который дешевле всего на входной токен. Утверждайте маршрут, который дешевле всего на принятую задачу после того, как зафиксированы данные о качестве, повторах, кэше, пакетной обработке и откате.
Частые вопросы
DeepSeek дешевле, чем Qwen, в 2026 году?
Не всегда. В текущих примерах Qwen часто выигрывает в простом чате без кэша и в пакетируемых задачах, тогда как DeepSeek остаётся привлекательным для простой прямой настройки, явного учёта кэша, трафика в часы низкой нагрузки и рабочих процессов, где deepseek-flash проходит по качеству с меньшим числом повторов.
Qwen batch inference всегда дешевле?
Нет. Пакетная инференция Qwen может тарифицировать успешные запросы по 50% от стоимости инференции в реальном времени для поддерживаемых моделей, но пакетные задания асинхронны и не участвуют в некоторых промоакциях или скидках на кэш. Используйте её для офлайн-задач, а не для продуктовых вызовов, чувствительных к задержке.
Стоит ли сравнивать DeepSeek Pro с Qwen Flash?
Только если оба проходят один и тот же контроль качества. Для руководства по затратам сравнивайте самую дешёвую модель, которая удовлетворяет задачу. Если Qwen Flash не проходит, а DeepSeek Flash проходит, более дешёвая указанная строка Qwen не имеет значения.
Гарантирует ли кэширование экономию?
Нет. DeepSeek говорит, что попадания в кэш зависят от совпадения кэшированных префиксных единиц и не гарантируются. В документации Qwen также сказано, что вероятность неявного попадания в кэш не гарантируется и должна проверяться через поля использования. Рассматривайте экономию на кэше как измеренную экономию, а не как обещанную.
Где здесь подходит Flatkey?
Flatkey полезен, когда само переключение между моделями начинает стоить денег. С одним OpenAI-compatible маршрутом, одним балансом, одним счетом и журналами использования вы можете сравнивать DeepSeek, Qwen и другие маршруты моделей, не разбрасывая ключи и платежные подтверждения по разным провайдерам.
Итоговый ответ
Правильный вывод из DeepSeek API vs Qwen API для задач с чувствительностью к стоимости: руководство по затратам на 2026 год — не «DeepSeek дешевле» и не «Qwen дешевле». Он такой:
Сначала используйте Qwen для простых, недорогих, кэшируемых и пакетируемых workflows. Сначала используйте DeepSeek, когда простая настройка, планирование вне пиковых часов, прямой учет попаданий в кэш или качество DeepSeek Flash дают вам более низкую стоимость принятой задачи. Используйте Flatkey, когда стоимость переключения, ведения логов и подтверждения биллинга начинает иметь такое же значение, как и цена токенов.