
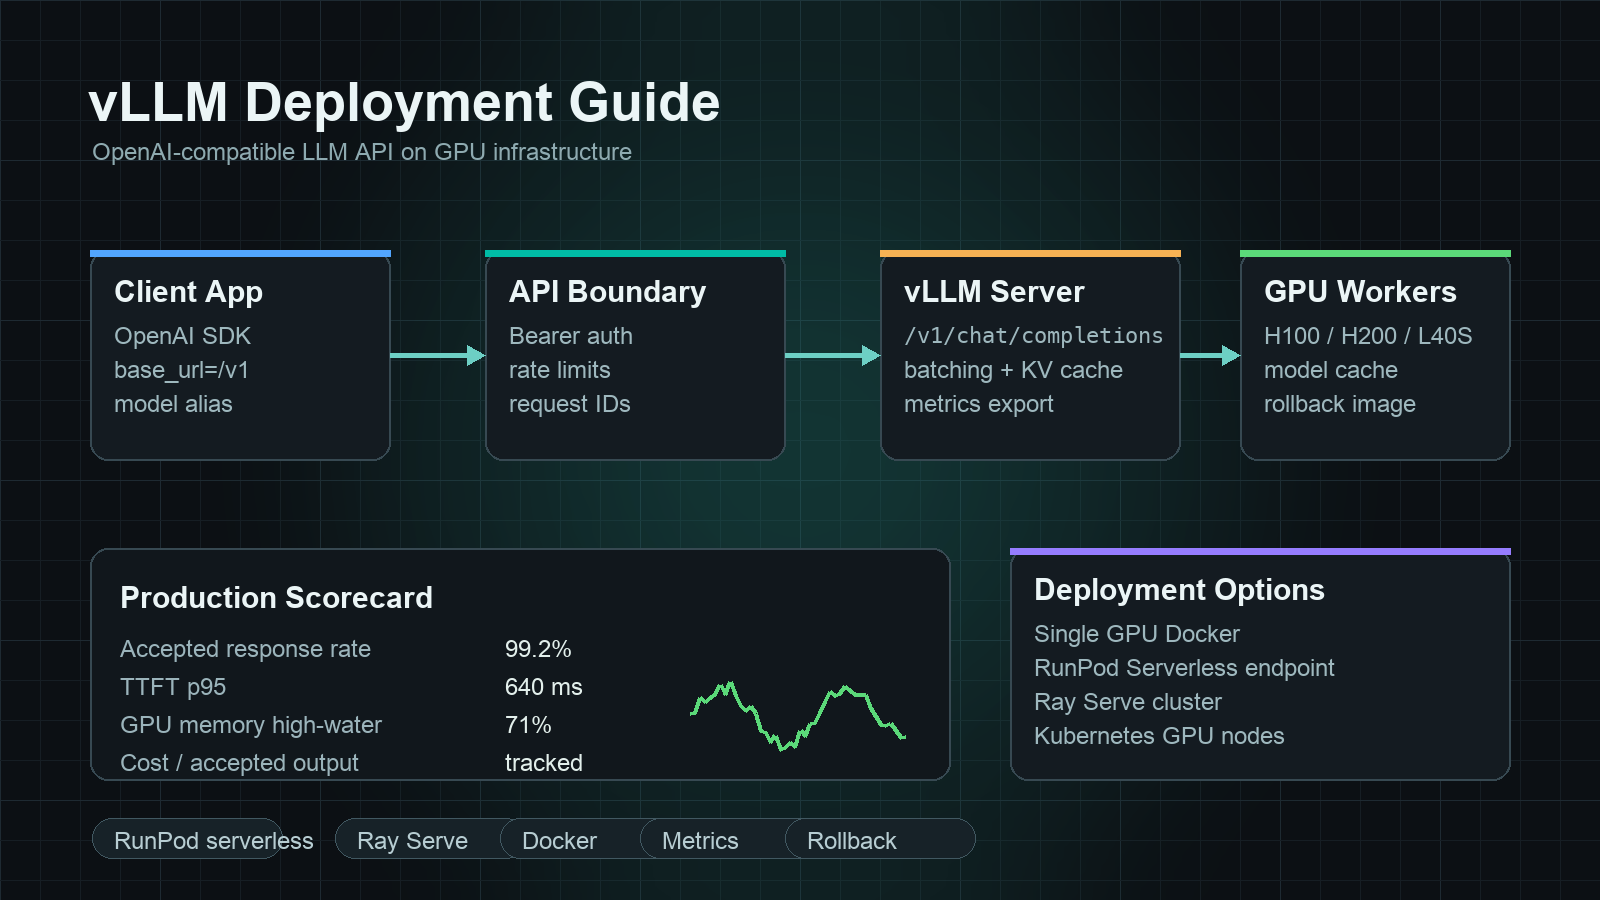
Руководство по развертыванию vLLM должно отвечать на один практический вопрос: как превратить GPU-мощность в LLM API, совместимый с OpenAI, который команды приложений могут вызывать, наблюдать, откатывать и сравнивать с управляемыми API моделей?
Короткий ответ: начните с одной модели, одной конфигурации GPU, одного OpenAI-совместимого маршрута и одного плана измерений. vLLM может предоставлять привычные /v1/models, /v1/chat/completions и связанные OpenAI-стильные конечные точки, но production-развертывание — это не только первая команда vllm serve. Вам нужен контейнерный образ, кэш модели, граница аутентификации, проверки работоспособности, метрики, лимиты запросов, нагрузочное тестирование и карточка показателей стоимости на принятый результат.
Это руководство по развертыванию vLLM дает AI-разработчикам и platform-командам путь развертывания от одного GPU-сервера до RunPod Serverless, Ray Serve и production-паттернов в стиле Kubernetes. Оно также объясняет, когда API модели или маршрутизатор, такой как Flatkey, могут быть проще, чем владение слоем обслуживания GPU.
Краткое руководство по развертыванию vLLM
Используйте эту последовательность, прежде чем добавлять сложность оркестрации.
| Шаг | Решение | Практический вариант по умолчанию |
|---|---|---|
| 1. Выберите модель | Выберите одну поддерживаемую модель и точную ревизию | Начните с самой маленькой модели, которая подтверждает контракт API, а затем масштабируйтесь |
| 2. Выберите GPU | Проверьте соответствие по памяти до настройки пропускной способности | Используйте один и тот же класс GPU в тестировании и production |
| 3. Запустите vLLM | Откройте OpenAI-совместимый API | Сначала используйте vllm serve, затем контейнеризируйте |
| 4. Зафиксируйте лимиты запросов | Ограничьте длину контекста, параллелизм и размер ответа | Защитите GPU от неограниченных промптов |
| 5. Добавьте аутентификацию и сетевые ограничения | Не выставляйте напрямую сырой GPU-worker | Поставьте перед ним gateway, ingress или private endpoint |
| 6. Измеряйте принятый результат | Отслеживайте успешные ответы, задержку, повторные попытки и стоимость | Сравнивайте со стоимостью API модели на принятый результат |
| 7. Добавьте механизмы выката | Canary, rollback и версионированные aliases модели | Сохраняйте стабильность клиентского кода при изменениях в обслуживании |
Цель не в том, чтобы сделать каждую нагрузку self-hosted. Цель в том, чтобы понимать, когда self-hosted vLLM оправдывает операционную сложность.
Что дает vLLM
vLLM — это open-source движок инференса и обслуживания для больших языковых моделей. Его документация охватывает OpenAI-совместимое обслуживание, развертывание в Docker, метрики, prefix caching, квантизацию, speculative decoding, параллелизм и поддерживаемые архитектуры моделей. Эти элементы делают vLLM сильным вариантом по умолчанию, когда нужно обслуживать модели с открытыми весами через привычный API-контракт.
Полезное production-свойство — это граница API. Если ваше приложение уже вызывает OpenAI-совместимый клиент, endpoint vLLM может сократить объем переписывания приложения. Слой обслуживания может измениться, веса модели могут измениться, а GPU-хост может переместиться, при этом клиентский код по-прежнему отправляет chat-completion запросы на один base URL.
Это не снимает работы по платформе. Это переносит сложную работу из интеграции приложения в operations инференса: выделение GPU, загрузка модели, batching, observability, rate limits, реагирование на инциденты и управление стоимостью.
Развертывание vLLM на одном GPU
Начните локально или на одном облачном GPU, прежде чем добавлять serverless, Ray или Kubernetes.
pip install vllm

vllm serve meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
Затем проверьте OpenAI-совместимый endpoint.
curl http://localhost:8000/v1/models
Используйте chat-запрос, который выглядит так же, как запрос, который ваше приложение действительно будет отправлять.
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-8B-Instruct",
    "messages": [
      {"role": "user", "content": "Write a three-bullet deployment checklist."}
    ],
    "temperature": 0.2,
    "max_tokens": 300
  }'
Это первое развертывание — не production. Оно отвечает на четыре вопроса:
- Загружается ли модель на выбранном GPU?
- Понимает ли ваш клиент форму ответа?
- Работают ли streaming, вызов инструментов или структурированный вывод для вашего конкретного запроса?
- Каковы примерные показатели time-to-first-token и end-to-end latency?
Сделайте первый тест простым. Не настраивайте batching, квантизацию или параллелизм, пока базовый endpoint не заработает.
Развертывание в Docker для воспроизводимого GPU-сервера
Для воспроизводимого сервера используйте официальный путь vLLM Docker или закрепленный container image в собственном registry. Важны не только image tag. Также важны стек драйверов, совместимость CUDA, кэш модели, mount тома, сетевой порт и флаги процесса.
Пример:
docker run --gpus all \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  --env HUGGING_FACE_HUB_TOKEN=$HUGGING_FACE_HUB_TOKEN \
  vllm/vllm-openai:latest \
  --model meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
Перед использованием этого паттерна в production закрепите версии:
- image tag vLLM.
- NVIDIA driver и container runtime.
- Стек CUDA, если он управляется отдельно.
- Ревизию модели или commit hash.
- Поведение tokenizer и chat template.
- Режим квантизации, если он используется.
Руководство по развертыванию vLLM будет неполным, если в нем сказано только «запустите Docker». В рабочем регламенте также должны быть описаны поведение при перезапуске, логирование, прогрев кеша модели, проверки готовности и путь отката к предыдущему образу и версии модели.
Сделайте конечную точку совместимой с OpenAI, но не открытой для неаутентифицированного доступа
vLLM умеет работать с API, совместимым с OpenAI, но ваш «сырой» worker vLLM обычно не должен быть публичной границей интернета. Поставьте перед ним что-то из следующего:
- Приватную VPC-конечную точку для внутренних сервисов.
- API-шлюз с проверкой bearer-токена.
- Service mesh или ingress-controller с mTLS.
- Тонкий прокси на уровне приложения, который принудительно применяет псевдонимы моделей, идентификаторы запросов и бюджеты по командам.
- Слой маршрутизации, когда нужен fallback к управляемым API моделей.
Используйте базовые URL, зависящие от окружения:
VLLM_BASE_URL_DEV=http://localhost:8000/v1
VLLM_BASE_URL_STAGING=https://staging-inference.example.com/v1
VLLM_BASE_URL_PROD=https://inference.example.com/v1
Затем сделайте клиент приложения обратимо переключаемым:
from openai import OpenAI

client = OpenAI(
    api_key="not-used-by-raw-vllm",
    base_url="https://inference.example.com/v1",
)

response = client.chat.completions.create(
    model="llama-3-1-8b-instruct",
    messages=[{"role": "user", "content": "Кратко изложите план развертывания."}],
)
Если позже вы направите часть запросов в совместимый с OpenAI слой API моделей Flatkey, тот же шаблон клиента останется полезным: меняйте базовый URL, API-ключ и псевдоним модели, сохраняя стабильный контракт приложения.
Параметры production, которые нужно определить до начала трафика
Флаги развертывания зависят от модели, GPU и нагрузки, но каждой команде следует определить эти параметры до запуска production-трафика:
| Параметр | Почему это важно |
|---|---|
| Максимальная длина модели | Не дает нескольким длинным промптам занять всю память KV-cache |
| Максимальное число выходных токенов | Не позволяет бесконтрольным генерациям надолго занимать decode-capacity |
| Лимит параллелизма | Защищает p95 и p99 задержки при всплесках трафика |
| Таймаут запроса | Останавливает зависшие запросы, которые скрывают перегрузку |
| Политика очереди | Определяет, будет ли избыточный спрос ждать, быстро завершаться с ошибкой или переключаться на fallback |
| Псевдоним модели | Позволяет клиентам использовать стабильное имя, пока обслуживаемая версия меняется |
| Граница аутентификации | Не позволяет дорогой GPU-конечной точке стать открытым прокси |
| Политика логирования | Балансирует отладку с требованиями к хранению данных и конфиденциальности |
| Экспорт метрик | Делает наблюдаемыми задержки, ошибки, поведение кеша и пропускную способность |
Не копируйте флаги другой команды. Копируйте их метод измерения.
Метрики для production-развертываний vLLM
Отслеживайте метрики на трех уровнях.
| Уровень | Метрики для отслеживания |
|---|---|
| Уровень API | Количество запросов, доля принятых ответов, доля 4xx/5xx, доля таймаутов, доля повторов |
| Уровень обслуживания | Время до первого токена, задержка между токенами, сквозная задержка, время ожидания в очереди, токенов в секунду |
| Уровень GPU | Загрузка GPU, использование памяти, события OOM, время загрузки модели, количество перезапусков |
Затем добавьте финансовую метрику:
стоимость на один принятый выход =
  (аренда GPU + хранилище + пропускная способность + повторы + время оператора)
  / принятые ответы, прошедшие проверки качества
Это делает руководство по развертыванию vLLM привязанным к экономике production. Более быстрый endpoint не является более дешевым, если он чаще дает сбои, требует больше ручного вмешательства или простаивает большую часть дня.
Для более широкого контекста по стоимости сравните измеренный вами endpoint с ценами аренды GPU, лучшим GPU для инференса LLM, GPU cloud против API модели и TCO GPU-кластера.
Руководство по развертыванию serverless vLLM в RunPod
Руководство по развертыванию serverless vLLM в RunPod имеет другую операционную модель, чем долго работающая GPU VM. Вы упаковываете handler или контейнер, определяете serverless-конечную точку и позволяете платформе масштабировать workers в зависимости от запросов. Это может быть полезно, когда трафик носит всплесковый характер или когда вам нужна управляемая среда выполнения на GPU без необходимости владеть каждой деталью жизненного цикла VM.
Используйте RunPod Serverless, когда:
- Вам нужен GPU-выполнение в стиле endpoint без управления постоянными хостами.
- Трафик достаточно всплесковый, чтобы постоянно включенная GPU-мощность простаивала.
- Холодный старт и поведение загрузки модели приемлемы для этой нагрузки.
- Ваше приложение может работать с асинхронным или специфичным для endpoint шаблоном запросов платформы.
- Вы можете протестировать параллелизм, очереди и таймауты до запуска.
Осторожно используйте serverless для чат-сценариев, чувствительных к задержке. У больших моделей могут быть заметные эффекты холодного старта и времени загрузки. Измеряйте задержку до первого токена после периодов простоя, а не только во время прогретого бенчмарка.
Для руководства по развертыванию vLLM в serverless-конечной точке RunPod ваш acceptance test должен включать:
| Проверка | Почему это важно |
|---|---|
| Время загрузки контейнерного образа | Большие образы могут доминировать в cold start |
| Скачивание весов модели или монтирование тома | Повторные загрузки могут свести на нет экономию serverless |
| Максимальное число воркеров | Предотвращает неожиданные расходы во время всплесков нагрузки |
| Таймаут очереди | Определяет поведение отказа, видимое пользователю |
| Политика warm-worker | Изменяет задержку и стоимость простоя |
| Форма запроса и ответа | Подтверждает, что клиентов, совместимых с OpenAI, можно корректно адаптировать |
Если ваш точный поисковый запрос — runpod serverless endpoints vllm deployment guide, рассматривайте "endpoints" как тему эксплуатации: создайте endpoint, но также протестируйте cold start, масштабирование воркеров, лимиты запросов и откат.
Руководство по развертыванию Ray Serve vLLM
Руководство по развертыванию Ray Serve vLLM полезно, когда развертывание — это уже не просто одна модель на одном воркере. Ray Serve может помочь командам построить serving-приложение, которое объединяет развертывания, масштабирует реплики и работает на кластере Ray. Это ценно, когда вам нужна логика обслуживания на уровне Python вокруг модели, пользовательская маршрутизация, многомодельные приложения или кластер, который уже стандартизирован на Ray.
Используйте Ray Serve, когда:
- Вы уже используете Ray для ML-инфраструктуры.
- Вам нужно несколько развертываний в одном графе обслуживания.
- Вы хотите маршрутизацию на уровне приложения вокруг одного или нескольких движков vLLM.
- Вам нужен путь от локального тестирования к кластеру Ray.
- Ваша платформа умеет эксплуатировать Ray, а не только vLLM.
Компромисс — в операционной сложности. Ray дает мощные возможности оркестрации, но также добавляет операции с кластером Ray, поведение autoscaling, особенности object store, логи, панели мониторинга и еще один путь обновления. Для одной модели за одним endpoint прямое развертывание vLLM может быть проще.
Шаблон развертывания Kubernetes
Kubernetes хорошо подходит, когда ваша организация уже эксплуатирует GPU-узлы, ingress, секреты, метрики и политики выката в Kubernetes. Это не обязательно правильный первый вариант развертывания для небольшой команды.
Чек-лист Kubernetes:
| Область | Чек-лист |
|---|---|
| Планирование GPU | Метки узлов, taints, запросы ресурсов, device plugin и изоляция GPU |
| Хранение модели | Постоянный том, синхронизация с object storage или стратегия вшитого образа |
| Запуск | Прогрев кеша модели и реалистичная readiness probe |
| Health | Liveness probe, которая не убивает медленную, но рабочую загрузку модели |
| Выкат | Canary или blue-green deployment с быстрым откатом |
| Autoscaling | Масштабирование по очереди, задержке или метрикам GPU, а не только по CPU |
| Сеть | По умолчанию только внутренняя; публичный ingress только через механизмы аутентификации |
| Наблюдаемость | Задержка по маршрутам, частота ошибок, память GPU и распределение затрат |
Если ваша платформа еще не достигла зрелости в Kubernetes для GPU, начните сначала с одного GPU-хоста или управляемого endpoint. Kubernetes должен снижать операционные риски, а не превращать простой endpoint в кластерный проект.
План нагрузочного тестирования для развертывания vLLM
Не проводите нагрузочное тестирование на одном промпте. Создайте репрезентативный набор запросов.
Используйте как минимум три трассы:
- Короткий чат: короткий prompt, короткий output, высокая конкуренция.
- RAG с длинным контекстом: длинный prompt, средний output, повторяющийся шаблон system и retrieval.
- Agent или цикл инструментов: повторяющаяся схема, структурированный output, отмена, повторные попытки и многотуровый контекст.
Записывайте:
| Метрика | Цель |
|---|---|
| Принятые запросы в минуту | Измеряет полезную пропускную способность |
| Время до первого токена p50/p95/p99 | Показывает интерактивную задержку |
| Сквозная задержка p50/p95/p99 | Показывает время выполнения задачи, видимое пользователю |
| Частота ошибок и таймаутов | Показывает надежность под нагрузкой |
| Задержка с учетом повторных попыток | Показывает реальный опыт после сбоев |
| Максимальный уровень использования памяти GPU | Показывает запас по ресурсам |
| Стоимость на принятый output | Показывает экономику |
Запустите два бенчмарка:
- Стандартный запуск: минимальная настройка, чтобы вы понимали время до production.
- Тюнингованный запуск: настроенные batching, cache, quantization и лимиты запросов, чтобы вы понимали потолок.
Если тюнингованный запуск быстрее, но нестабилен, не разворачивайте его по умолчанию. Разверните конфигурацию, которую дежурная команда может объяснить.
Когда не стоит разворачивать vLLM самостоятельно
Self-hosting полезен, когда вам нужен контроль над оборудованием, собственные веса, строгая локализация данных или высокая устойчивая загрузка на стабильной рабочей нагрузке. Он менее привлекателен, когда трафик неопределенный, модель часто меняется, требуются передовые проприетарные модели или у команды нет ресурсов для эксплуатации inference.
Сначала выбирайте управляемый API для модели или router, когда:
- Вы все еще тестируете качество модели.
- Вам нужны частые замены модели.
- Трафик скачкообразный или его трудно спрогнозировать.
- Возможность fallback между провайдерами важнее, чем контроль над GPU.
- Вам нужен учет использования, бюджеты, счета и управление командой до тонкой настройки GPU.
Flatkey хорошо подходит для этого слоя, когда рабочим нагрузкам на стороне API нужны один ключ, один баланс, один счет, записи об использовании и доступ к официальным маршрутам моделей. Если позже окажется, что рабочая нагрузка достаточно стабильна для выделенного обслуживания на GPU, продолжайте сравнивать самохостинг vLLM endpoint с сравнением цен на AI-модели, сравнением цен на AI API и измеренной стоимостью GPU на один принятый вывод.
Шаблон runbook для развертывания
Скопируйте это перед запуском.
Service:
  Owner:
  On-call:
  Model alias:
  Served model revision:
  vLLM version:
  Container image:
  GPU type and count:
  Base URL:

Request policy:
  Max model length:
  Max output tokens:
  Max concurrency:
  Queue timeout:
  Request timeout:
  Auth method:

Observability:
  Metrics dashboard:
  Log location:
  Trace/request ID field:
  Alert thresholds:

Rollout:
  Canary percentage:
  Rollback image:
  Rollback model revision:
  Fallback route:

Cost:
  GPU cost source:
  Storage/bandwidth assumptions:
  Accepted-output denominator:
  Weekly cost review owner:
Этот шаблон важнее, чем идеальная первая команда. Руководство по развертыванию vLLM, которое нельзя передать on-call, все еще является прототипом.
Часто задаваемые вопросы
Это все еще контент для руководства по развертыванию vLLM, если я использую управляемый GPU endpoint?
Да. Если vLLM — это serving engine и вы решаете, как его публиковать, масштабировать, наблюдать за ним и защищать его, это по-прежнему относится к руководству по развертыванию vLLM. Операционные детали отличаются между обычной VM, RunPod Serverless, Ray Serve и Kubernetes, но критерии приемки похожи: контракт endpoint, задержка, ошибки, параллелизм, откат и стоимость на один принятый вывод.
Следует ли использовать RunPod Serverless или постоянную GPU VM для vLLM?
Используйте RunPod Serverless, когда важнее обработка пиковых нагрузок и управление endpoint, чем всегда прогретая задержка. Используйте постоянную GPU VM, когда вам нужна предсказуемая производительность в прогретом состоянии, прямой контроль над хостом или более простой путь отладки. Сравните обе опции, если решение определяется задержкой и загрузкой.
Когда Ray Serve имеет смысл вместе с vLLM?
Ray Serve имеет смысл, когда vLLM — часть более крупного приложения для обслуживания, особенно если вы уже используете Ray. Для одной модели за одним endpoint прямое обслуживание vLLM может быть проще в эксплуатации.
Может ли vLLM заменить OpenAI API?
vLLM может предоставлять интерфейс, совместимый с OpenAI, для поддерживаемых self-hosted моделей, но это не делает open-weight модели идентичными проприетарным frontier API. Рассматривайте это как контракт endpoint и вариант обслуживания, а затем проверяйте качество модели, задержку и операционные затраты на вашей рабочей нагрузке.
Что мне следует измерять в первую очередь?
Измеряйте долю принятых ответов, время до первого токена, задержку p95 и p99, процент таймаутов, давление на память GPU и стоимость на один принятый вывод. Сырые tokens per second полезны, но этого недостаточно для производственных решений.
Где Flatkey вписывается в vLLM?
Используйте vLLM, когда вам нужно владеть слоем обслуживания на GPU. Используйте Flatkey, когда вам нужен один API-слой моделей, совместимый с OpenAI, единое выставление счетов, записи об использовании и управление доступом по официальным маршрутам моделей и инструментам. Многие команды будут использовать оба варианта: vLLM для стабильных self-hosted рабочих нагрузок и Flatkey для frontier-моделей, fallback, экспериментов и управления на стороне API.
Итоговый чек-лист
Перед запуском ваше руководство по развертыванию vLLM должно дать такие артефакты:
- Закрепленная версия модели и контейнера.
- Протестированный базовый URL, совместимый с OpenAI.
- Граница аутентификации и сети.
- Лимиты запросов по контексту, выводу, таймауту и параллелизму.
- Метрики задержки, ошибок, очередей, пропускной способности и памяти GPU.
- Путь отката и предыдущий проверенный образ.
- Таблица стоимости на один принятый вывод.
- Запись о принятом решении, объясняющая, почему self-hosted vLLM лучше управляемого API модели для этой рабочей нагрузки.
Если эти артефакты существуют, вы не просто запускаете vLLM. Вы управляете LLM API на GPU.


