
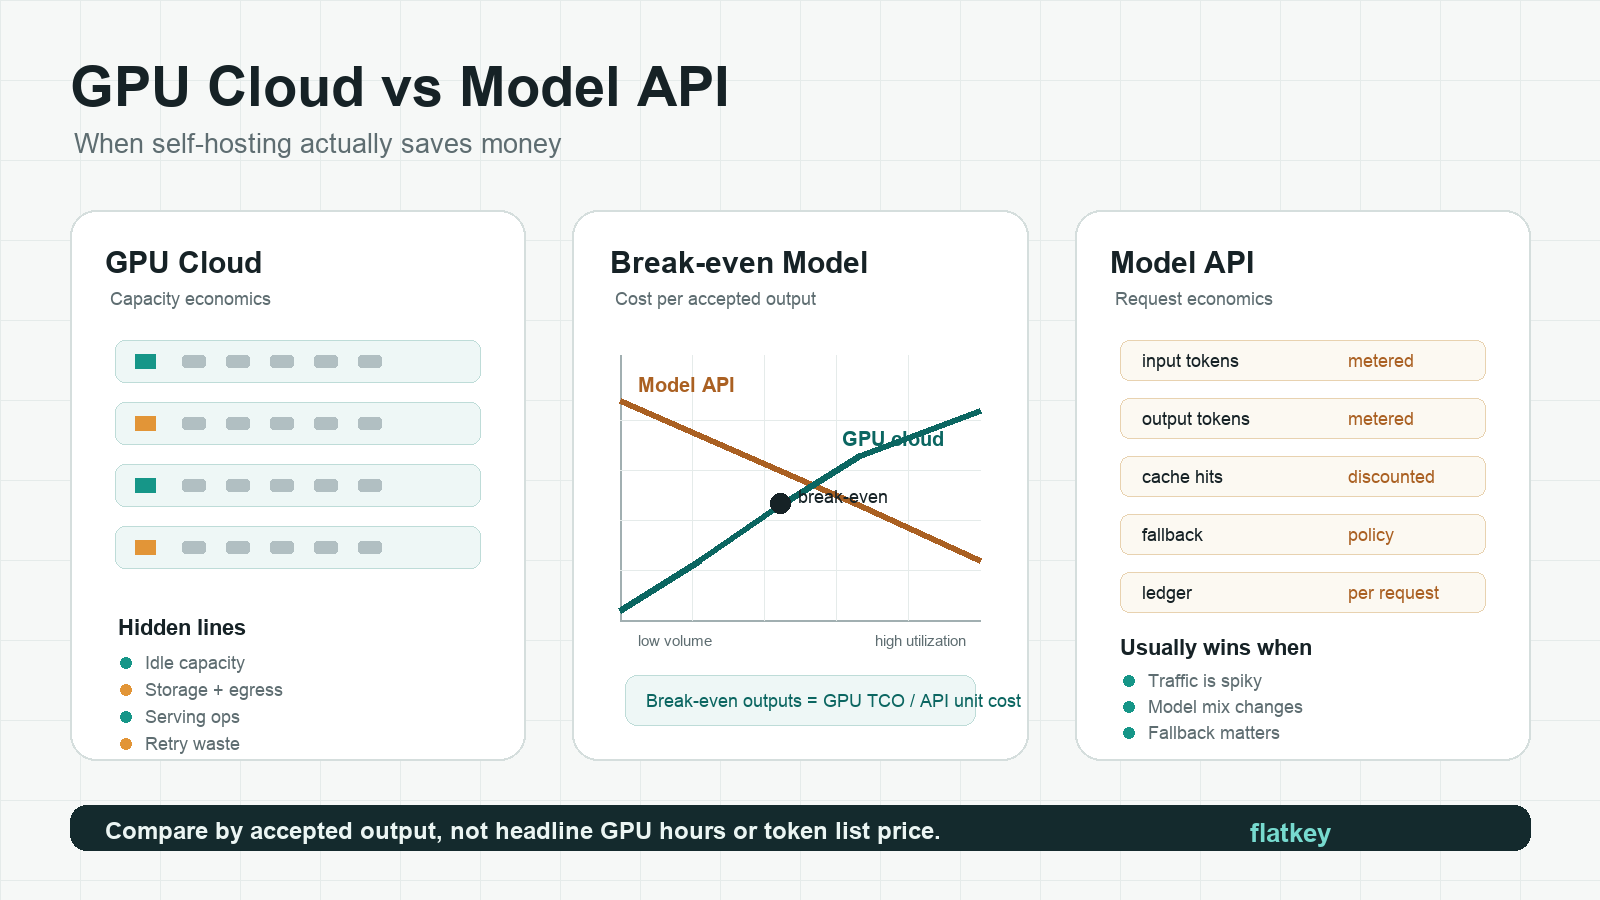
Hầu hết các đội ngũ đặt câu hỏi GPU cloud so với model API quá muộn. Họ thuê GPU, triển khai một ngăn xếp phục vụ, tinh chỉnh batching, thuê hỗ trợ nền tảng, rồi sau đó mới so sánh hóa đơn với một model API được quản lý. Đến lúc đó, phép so sánh đã bị thiên lệch về phía con đường mà họ đã đổ công sức vào.
Câu hỏi tốt hơn thì đơn giản hơn: bạn cần kiểm soát lớp GPU, hay bạn cần đầu ra mô hình đáng tin cậy với chi phí chấp nhận được thấp nhất?
Đối với các đội ngũ AI doanh nghiệp, GPU cloud bắt đầu tiết kiệm chi phí khi bạn có nhu cầu ổn định, lựa chọn mô hình ổn định, mức sử dụng hữu ích cao, và đội ngũ kỹ thuật để vận hành suy luận. Một model API thường rẻ hơn khi lưu lượng tăng giảm thất thường, lựa chọn mô hình thay đổi thường xuyên, retry và failover quan trọng hơn việc kiểm soát phần cứng, hoặc bạn cần các mô hình frontier không thể tự triển khai.
Quy tắc thực tế của Flatkey: so sánh GPU cloud với model API theo chi phí trên mỗi đầu ra được chấp nhận, chứ không chỉ dựa vào giá theo giờ của GPU hoặc giá niêm yết của token.
GPU cloud so với model API: câu trả lời nhanh
Hãy dùng bảng này trước khi xây bảng tính.
| Tình huống | Thường bắt đầu với | Tại sao |
|---|---|---|
| Sản phẩm giai đoạn đầu, prompt thay đổi, nhu cầu chưa chắc chắn | Model API | Bạn tránh GPU nhàn rỗi trong khi tìm hiểu lưu lượng, chất lượng và mức độ phù hợp của mô hình. |
| Suy luận batch khối lượng lớn trên một mô hình mở ổn định | GPU cloud | Mức sử dụng ổn định có thể phân bổ chi phí cho ngăn xếp phục vụ. |
| Chat hướng tới khách hàng với các đợt tăng đột biến khó đoán | Model API hoặc hybrid | Autoscaling, fallback, và không có công suất nhàn rỗi thường quan trọng hơn đơn giá thô. |
| Trọng số độc quyền, kernel tùy chỉnh, yêu cầu nghiêm ngặt về vị trí dữ liệu | GPU cloud | Yêu cầu kinh doanh là kiểm soát, không chỉ là chi phí. |
| Điều phối mô hình đa nhà cung cấp, mô hình frontier, hoặc thay đổi mô hình thường xuyên | Model API | Bạn tránh phải xây lại hạ tầng phục vụ cho mỗi lần đổi mô hình. |
| Khối lượng công việc ổn định dài hạn với mức sử dụng đã được chứng minh | GPU cloud đặt trước, cụm GPU chuyên dụng, hoặc GPU colocated | Cam kết có thể làm giảm chi phí công suất hiệu dụng sau khi nhu cầu đã được chứng minh. |
Phần còn lại của hướng dẫn này cung cấp một mô hình có thể sao chép để so sánh GPU cloud với model API mà không che giấu thời gian nhàn rỗi, retry, vận hành, hay bộ lọc chất lượng.
Đơn vị chi phí thực sự quan trọng
Đừng so sánh:
- Giá GPU theo giờ với giá token.
- Báo giá cloud với một benchmark tốt nhất có thể.
- Giá niêm yết của model API với một cụm tự triển khai được sử dụng tối đa.
Thay vào đó, hãy so sánh một trong các mẫu số này:
| Khối lượng công việc | Mẫu số tốt nhất |
|---|---|
| LLM chat hoặc agents | Chi phí trên mỗi phản hồi được chấp nhận, tác vụ được chấp nhận, hoặc token đầu ra được chấp nhận |
| Phân loại batch hoặc trích xuất | Chi phí trên mỗi bản ghi được chấp nhận |
| Tạo mã | Chi phí trên mỗi bản vá được chấp nhận hoặc tác vụ lập trình hoàn thành |
| Tạo ảnh | Chi phí trên mỗi ảnh được chấp nhận sau bộ lọc chất lượng |
| Tạo video | Chi phí trên mỗi giây được chấp nhận hoặc clip được chấp nhận |
| Fine-tuning hoặc training | Chi phí trên mỗi lần chạy hoàn tất |
Đối với phần lớn các đội ngũ suy luận:
chi_phi_don_vi_hieu_qua =
  tong_chi_phi_thang_tat_ca_yeu_to
  / dau_ra_duoc_chap_nhan_sau_retry_bo_loc_chat_luong_va_that_bai
Đây là nơi nhiều so sánh GPU cloud với model API bị đảo chiều. Một endpoint tự triển khai có thể cho throughput benchmark rất tốt nhưng vẫn thua nếu mức sử dụng thấp, mô hình không qua được các kiểm tra chất lượng, hoặc kỹ sư phải dành quá nhiều thời gian để giữ ngăn xếp hoạt động ổn định.
Mô hình chi phí của Model API
Một model API có vẻ đơn giản vì hóa đơn thường được tính theo request, token, giây video, ảnh, hoặc cuộc gọi công cụ. Nhưng một mô hình model API công bằng vẫn cần nhiều hơn đơn giá công bố.
Hãy dùng mô hình này:
chi_phi_model_api_hang_thang =
  chi_phi_token_dau_vao
  + chi_phi_dau_vao_duoc_cache_hoac_nguyen_canh
  + chi_phi_token_dau_ra
  + chi_phi_cong_cu_hoac_da_phuong_tien
  + chi_phi_retry_va_fallback
  + chi_phi_gateway_hoac_router
  + chi_phi_observability_va_finops
Sau đó chuẩn hóa:
chi_phi_model_api_tren_moi_dau_ra_duoc_chap_nhan =
  chi_phi_model_api_hang_thang
  / dau_ra_duoc_chap_nhan
Cần thu thập gì:
| Dòng chi phí | Cần kiểm tra gì |
|---|---|
| Token đầu vào và đầu ra | Trang giá chính thức của nhà cung cấp, model ID, context window, giới hạn đầu ra, và ngày kiểm tra. |
| Đầu vào được cache | Nhà cung cấp có hỗ trợ prompt caching hay giảm giá cache-hit hay không, và khối lượng công việc của bạn có thực sự tái sử dụng ngữ cảnh hay không. |
| Giá batch | Batch hoặc xử lý async có phù hợp với yêu cầu độ trễ của bạn hay không. |
| Retry | Retry do giới hạn tốc độ, lỗi tạm thời, kiểm tra chất lượng thất bại, và các request fallback. |
| Lớp router/gateway | Bất kỳ phí gateway nào, sổ cái sử dụng, allowlist mô hình, ngân sách sub-key, hoặc quy trình hóa đơn. |
| Vận hành | Tích hợp, giám sát, xử lý trạng thái của nhà cung cấp, và đối soát tài chính. |
Hãy dùng các trang nguồn chính thức cho số liệu hiện tại, không dùng bảng giá sao chép. Bắt đầu với OpenAI API pricing, Anthropic pricing, Google Gemini API pricing, và trang giá hiện tại của gateway hoặc router của bạn.
Đối với Flatkey, phía model API là một khóa, một số dư và một sổ ghi nhận sử dụng duy nhất trên các mô hình và công cụ chính thức. Điều đó quan trọng khi vấn đề chi phí thực sự không phải là một lần gọi mô hình đơn lẻ, mà là các khóa rời rạc, nhiều hóa đơn, kiểm soát ngân sách theo từng nhóm, và cơ chế dự phòng giữa các nhà cung cấp.
Mô hình chi phí GPU cloud
GPU cloud không chỉ là giá GPU theo giờ. Một API mô hình tự triển khai ở môi trường production có chi phí năng lực, phần mềm phục vụ, lưu trữ, mạng, giám sát, công việc duy trì uptime, và năng lực nhàn rỗi.
Hãy dùng mô hình này:
monthly_gpu_cloud_cost =
  gpu_compute_hours
  + storage_and_snapshot_cost
  + bandwidth_and_egress_cost
  + load_balancing_and_network_cost
  + serving_stack_cost
  + observability_and_logging_cost
  + platform_engineering_cost
  + support_plan_or_managed_service_cost
  + idle_capacity_cost
  + retry_failure_and_redeployment_waste
Sau đó chuẩn hóa:
self_hosted_cost_per_accepted_output =
  monthly_gpu_cloud_cost
  / accepted_outputs
Những gì cần ghi nhận:
| Dòng chi phí | Vì sao nó làm thay đổi câu trả lời |
|---|---|
| Mô hình GPU và bộ nhớ | GPU H100, H200, B200, A100, L40S và các GPU hạng RTX có các đường cong bộ nhớ, thông lượng, nguồn cung và giá khác nhau. |
| Chế độ sản phẩm | On-demand, spot, reserved, marketplace, serverless GPU, cluster chuyên dụng và bare metal có các hồ sơ độ tin cậy khác nhau. |
| Mức sử dụng | Một endpoint tự triển khai rẻ hơn sẽ nhanh chóng mất lợi thế nếu GPU phải nằm nhàn rỗi. |
| Serving stack | vLLM, SGLang, TensorRT-LLM, NIM hoặc các máy chủ tùy biến đều cần hỗ trợ vận hành thực tế. |
| Lưu trữ và tải mô hình | Weights lớn, snapshot, volume và việc pull lặp lại có thể trở thành chi phí đáng kể. |
| Mạng | Egress, private link, public IP và cân bằng tải có thể làm thay đổi kinh tế theo đơn vị. |
| Lỗi hỏng | Lỗi out-of-memory, bị preempt, container lỗi và cold start làm tăng chi phí trên mỗi output được chấp nhận. |
Hãy dùng các trang nhà cung cấp hiện tại như các mốc kiểm tra: giá AWS EC2, AWS P5 instances, giá GPU của Google Cloud, giá RunPod, Lambda GPU Cloud, và giá Vast.ai.
Hãy coi mọi mức giá GPU là có đóng dấu thời gian. Nguồn cung trên marketplace, mức sẵn có theo khu vực, và các báo giá đã cam kết có thể thay đổi nhanh hơn bài viết bạn đang đọc.
Công thức hòa vốn
Đây là điểm mà quyết định GPU cloud so với model API trở thành một quyết định ở cấp độ tài chính thay vì theo cảm tính.
Mô hình hòa vốn đơn giản nhất là:
break_even_outputs =
  monthly_gpu_cloud_cost
  / model_api_cost_per_accepted_output
Nếu khối lượng công việc của bạn tạo ra nhiều output được chấp nhận hơn break_even_outputs, tự triển khai có thể tiết kiệm chi phí. Nếu ít hơn, model API có lẽ rẻ hơn.
Bạn cũng có thể diễn đạt cùng ý tưởng theo mức sử dụng:
required_utilization =
  monthly_gpu_cloud_cost
  / equivalent_model_api_cost_at_expected_volume
Công thức đó chỉ hữu ích nếu khối lượng công việc ổn định. Nếu volume, model, độ dài context hoặc mục tiêu chất lượng thay đổi mỗi tháng, phía model API có giá trị tùy chọn mà công thức utilization không nắm bắt được.
Ví dụ minh họa: vì sao giá GPU theo giờ có thể gây hiểu lầm
Giả sử một nhóm đang quyết định có nên tự triển khai một mô hình mở ổn định hay không.
| Đầu vào | Giá trị ví dụ |
|---|---|
| Tổng chi phí GPU cloud | 24.000 USD mỗi tháng |
| Sản lượng output được chấp nhận | 30 triệu output được chấp nhận mỗi tháng |
| Chi phí tự triển khai trên mỗi output được chấp nhận | 0,0008 USD |
| Chi phí model API trên mỗi output được chấp nhận | 0,0012 USD |
| Chi phí model API hàng tháng ở cùng khối lượng | 36.000 USD |
| Mức tiết kiệm khi tự triển khai theo bề ngoài | 12.000 USD mỗi tháng |
Trong kịch bản cơ sở đó, GPU cloud có vẻ tiết kiệm chi phí.
Bây giờ hãy tạo áp lực lên các giả định.
| Thay đổi | Tác động |
|---|---|
| Mức sử dụng hữu ích giảm 35% | Chi phí đơn vị khi tự triển khai tăng lên vì cụm GPU cố định thực hiện ít công việc được chấp nhận hơn. |
| Tỷ lệ retry hoặc thất bại do chất lượng tăng gấp đôi | Cả hai phương án đều đắt hơn, nhưng tự triển khai còn phải gánh thêm phần lãng phí năng lực. |
| Sản phẩm chuyển sang mô hình lớn hơn | Các GPU hiện có có thể cần sharding, nhiều bộ nhớ hơn, hoặc một serving stack mới. |
| Nhu cầu trở nên theo từng đợt | Model API có thể mở rộng theo nhu cầu; cụm GPU phải được sizing cho các đỉnh tải hoặc chấp nhận hàng đợi. |
Nếu kịch bản xấu xóa sạch khoản tiết kiệm, thì tự triển khai thực ra không rẻ hơn. Đó là một canh bạc về năng lực.
Khi nào GPU cloud thực sự tiết kiệm chi phí
GPU cloud có thể tiết kiệm chi phí khi hầu hết các điều sau là đúng:
- Bạn có nhu cầu ổn định, không phải các đợt tăng đột biến thỉnh thoảng.
- Họ mô hình ổn định trong nhiều tháng, không phải vài ngày.
- Mô hình là open-weight hoặc bằng cách nào đó có thể tự triển khai.
- Khối lượng công việc có mức sử dụng hữu ích cao sau các khoảng chờ trong hàng đợi và các lần lỗi.
- Các mục tiêu độ trễ có thể đạt được với ngăn xếp phục vụ của bạn.
- Bạn có thể chạy vLLM, SGLang, TensorRT-LLM, NIM, hoặc một ngăn xếp khác một cách đáng tin cậy.
- Nhóm có thể giám sát mức sử dụng GPU, áp lực bộ nhớ, độ trễ p95/p99, tỷ lệ lỗi, và mức khuếch đại do thử lại.
- Bạn có kế hoạch cho việc tải mô hình, làm ấm cache, tự động hóa tắt máy, và an toàn khi triển khai.
- Báo giá bao gồm giả định về lưu trữ, lưu lượng egress, hỗ trợ, và tính sẵn sàng.
- Bộ phận tài chính sẵn sàng tài trợ năng lực trước khi mọi yêu cầu đến.
Điều này thường thấy trong suy luận batch khối lượng lớn, các pipeline trích xuất nội bộ, chatbot hỗ trợ ổn định, các mô hình mở chuyên biệt theo miền, và các khối lượng công việc mà trọng số tùy chỉnh hoặc tính gần dữ liệu là quan trọng.
Để lập kế hoạch sâu hơn ở phía GPU, hãy dùng các hướng dẫn của Flatkey về giá thuê GPU, GPU tốt nhất cho suy luận LLM, thuê cụm GPU, và TCO của cụm GPU.
Khi API mô hình vẫn rẻ hơn
API mô hình thường vẫn rẻ hơn khi những điều sau đúng:
- Lưu lượng mang tính đột biến, theo mùa, hoặc هنوز chưa rõ.
- Ứng dụng cần nhiều mô hình tiên phong khác nhau.
- Mô hình thay đổi nhanh hơn kế hoạch hạ tầng của bạn.
- Nhóm cần cơ chế dự phòng, xử lý giới hạn tốc độ, hóa đơn, nhật ký sử dụng, và kiểm soát ngân sách hơn là kiểm soát phần cứng.
- Bạn không thể giữ GPU bận đủ để bù cho thời gian nhàn rỗi.
- Bạn chưa có đội nền tảng sẵn sàng vận hành lớp phục vụ.
- Khối lượng công việc bao gồm các mô hình đóng, tạo sinh đa phương thức, năng lực độc quyền của nhà cung cấp, hoặc các đợt phát hành mô hình diễn ra nhanh.
- Bộ phận mua sắm muốn phân bổ chi phí theo từng yêu cầu thay vì một hóa đơn hạ tầng dùng chung.
Đây là lúc so sánh GPU cloud với API mô hình không chỉ còn là về giá. Một API mô hình có thể giảm thời gian tích hợp, độ phức tạp mua sắm, và phạm vi sự cố.
Flatkey phù hợp với phía này của quyết định khi các nhóm muốn một tuyến tương thích OpenAI cho nhiều mô hình chính thức, một số dư trả trước, một hóa đơn, ngân sách theo sub-key, danh sách cho phép mô hình, bản ghi sử dụng theo từng yêu cầu, và cơ chế chuyển đổi dự phòng giữa các kênh upstream. Xem các hướng dẫn liên quan về so sánh giá mô hình AI, so sánh giá API AI, giá cổng AI, và quản lý chi tiêu API AI.
Mô hình lai thường là câu trả lời thực sự
Nhiều nhóm AI doanh nghiệp không nên ép buộc một câu trả lời duy nhất cho mọi trường hợp. Một mô hình lai thường thuyết phục hơn:
| Phần khối lượng công việc | Mặc định tốt hơn |
|---|---|
| Suy luận open-weight ổn định, khối lượng lớn | GPU cloud |
| Suy luận hoặc lập trình với mô hình tiên phong | API mô hình |
| Các job batch có thể xếp hàng chờ | GPU cloud, spot, hoặc năng lực đặt trước |
| Các đợt tăng đột biến hướng tới khách hàng | API mô hình hoặc overflow lai |
| Trọng số độc quyền | GPU cloud |
| Khám phá mô hình | API mô hình |
| Triển khai có quản lý với kiểm soát hạ tầng | GPU cloud chuyên dụng, GPU cloud riêng, colocations, hoặc tại chỗ |
Mẫu hình lai là:
- Điều hướng các khối lượng công việc chưa rõ và biến động qua API mô hình.
- Benchmark các khối lượng công việc ổn định trên GPU cloud.
- Chỉ chuyển những khối lượng công việc đã chứng minh được khối lượng và sự ổn định của mô hình sang tự triển khai.
- Giữ một phương án dự phòng bằng API mô hình cho overflow, nâng cấp mô hình, và đa dạng hóa nhà cung cấp.
Con đường đó tránh được sai lầm tốn kém nhất: mua năng lực GPU cho một khối lượng công việc sau đó lại thay đổi hình dạng.
Kế hoạch benchmark trước khi chuyển đổi
Chạy cùng một lưu lượng qua cả hai hướng trong ít nhất một khoảng thời gian đại diện.
| Chỉ số | Đường GPU cloud | Đường API mô hình |
|---|---|---|
| Đầu ra được chấp nhận | ||
| Số token đầu vào hoặc bản ghi | ||
| Số token đầu ra hoặc kết quả | ||
| Độ trễ p50 / p95 / p99 | ||
| Thời gian đến token đầu tiên | ||
| Tỷ lệ lỗi | ||
| Tỷ lệ thử lại | ||
| Tỷ lệ từ chối theo chất lượng | ||
| Năng lực nhàn rỗi | Không áp dụng | |
| Giờ nhân sự | ||
| Lưu trữ và egress | ||
| Tổng chi phí | ||
| Chi phí trên mỗi đầu ra được chấp nhận |
Sau đó hãy hỏi:
- GPU cloud còn thắng sau thời gian nhàn rỗi không?
- Nó còn thắng sau thời gian nhân sự không?
- Nó còn thắng sau các lần thử lại và bộ lọc chất lượng không?
- Nó còn thắng nếu mô hình thay đổi không?
- Nó còn thắng nếu lưu lượng giảm 30% không?
- Nó còn thắng nếu độ trễ p95 phải cải thiện không?
Nếu câu trả lời là có trong kịch bản bất lợi, tự triển khai xứng đáng có một lộ trình mua sắm nghiêm túc.
Danh sách kiểm tra mua sắm
Đối với GPU cloud:
- Chính xác GPU, dung lượng bộ nhớ, CPU, RAM, ổ đĩa, interconnect và băng thông mạng nào được bao gồm?
- Năng lực đó là on-demand, spot, marketplace, secure cloud, reserved, dedicated hay bare metal?
- Những chi phí lưu trữ, snapshot, egress, IP công cộng, load balancer, hỗ trợ và quan sát nào bị loại trừ?
- Điều gì xảy ra khi host bị lỗi, bị preemption, bảo trì hoặc thiếu hụt năng lực?
- Nhà cung cấp có thể chạy benchmark thực tế của bạn trước khi cam kết không?
- Thời hạn tối thiểu, lộ trình tăng dần và chi phí thoát là gì?
Đối với model API:
- Chính xác model ID, context window, giới hạn đầu ra và đơn vị định giá nào được sử dụng?
- Cache hit, batch job, đơn vị hình ảnh/video và tool call có được tính giá riêng không?
- Rate limit và các tùy chọn dự phòng là gì?
- Các lần retry, cuộc gọi provider thất bại và từ chối chất lượng được tính như thế nào?
- Bộ phận tài chính có thể xuất mức sử dụng theo team, key, model, môi trường và khách hàng không?
- Những điều khoản lưu giữ dữ liệu, tuân thủ và SLA nào được áp dụng?
Danh sách kiểm tra nguồn
Hãy dùng các trang chính thức này làm điểm bắt đầu cho dữ liệu đầu vào hiện tại:
| Loại nguồn | Các trang cần kiểm tra |
|---|---|
| Định giá model API | OpenAI API pricing, Anthropic pricing, Google Gemini API pricing |
| Định giá GPU cloud | AWS EC2 pricing, AWS P5 instances, Google Cloud GPU pricing, RunPod pricing, Lambda GPU Cloud, Vast.ai pricing |
| Serving frameworks | vLLM OpenAI-compatible server, SGLang documentation |
| Thông số kỹ thuật GPU | NVIDIA H100, NVIDIA H200, NVIDIA DGX B200 |
| Cấu trúc FinOps | FinOps FOCUS |
| Bối cảnh chi phí Flatkey | Flatkey pricing, Flatkey Compute, Flatkey Compute price index |
Các câu hỏi thường gặp
GPU cloud có luôn rẻ hơn model API không?
Không. GPU cloud chỉ rẻ hơn khi mức sử dụng hữu ích đủ cao để bù đắp năng lực nhàn rỗi, lưu trữ, egress, vận hành serving, lãng phí do retry và thời gian nhân sự. Model API có thể rẻ hơn đối với khối lượng công việc theo đợt hoặc thay đổi, ngay cả khi giá token trông có vẻ cao hơn.
Khi nào tự host một LLM tiết kiệm chi phí?
Tự host tiết kiệm chi phí khi model ổn định, khối lượng lớn, mức sử dụng có thể dự đoán, nhóm có thể vận hành stack serving, và tổng chi phí GPU cloud cho mỗi output được chấp nhận thấp hơn chi phí model API dưới các giả định bất lợi.
Tôi nên so sánh giá GPU cloud với giá model API như thế nào?
Hãy so sánh chi phí trên mỗi output được chấp nhận. Bao gồm token, giờ GPU, lưu trữ, băng thông, thời gian nhàn rỗi, retry, tỷ lệ lỗi, bộ lọc chất lượng, thời gian kỹ thuật, hỗ trợ và vận hành tài chính. Đừng chỉ so sánh giá GPU theo giờ với giá niêm yết theo token.
Chi phí ẩn lớn nhất của suy luận trên GPU cloud là gì?
Những chi phí ẩn lớn nhất thường là năng lực nhàn rỗi, vận hành kỹ thuật, lưu trữ và egress, triển khai thất bại, retry do thiếu bộ nhớ, và các thay đổi serving chưa được kiểm thử kỹ. Những chi phí này không xuất hiện trong mức giá GPU theo giờ được nêu trên.
Chi phí ẩn lớn nhất của model API là gì?
Những chi phí ẩn lớn nhất thường là retry, lời gọi dự phòng, prompt dài, ngữ cảnh không được cache, phản hồi nặng về đầu ra, tool hoặc media call, tài khoản provider phân tán, và việc quy attribution sử dụng yếu. Một sổ cái ở mức request giúp làm lộ các chi phí này.
Các đội AI doanh nghiệp có nên dùng kiến trúc lai không?
Thường là có. Hãy dùng model API cho khám phá, các model tiên phong, đột biến lưu lượng và dự phòng. Chỉ chuyển những workload ổn định, khối lượng lớn sang GPU cloud sau khi benchmark chứng minh chi phí được chấp nhận thấp hơn. Giữ đường API sẵn có cho overflow và thay đổi model.
Kết luận
GPU cloud vs model API không phải là một quyết định mang tính triết lý. GPU cloud vs model API là một quyết định về kinh tế của workload.
Hãy chọn GPU cloud khi bạn có thể giữ cho năng lực luôn bận, model ổn định, và quyền kiểm soát phần cứng tạo ra lợi thế thực sự. Hãy chọn model API khi tính linh hoạt, khả năng truy cập đa nhà cung cấp, thay đổi model nhanh hơn và quản trị theo từng request đáng giá hơn khoản tiết kiệm phần cứng mang tính lý thuyết.
Con đường an toàn nhất là theo từng giai đoạn: bắt đầu với model API, benchmark workload, chuyển các phần ổn định sang GPU cloud chỉ khi phép toán hòa vốn vẫn đúng trong các trường hợp bất lợi, và giữ một tuyến API để dự phòng cũng như cho các thay đổi model trong tương lai.
Nếu bạn đang so sánh GPU cloud với model API cho một khối lượng công việc AI sản xuất, Flatkey có thể hỗ trợ ở phía API với một khóa, một số dư, các tuyến mô hình chính thức, sổ ghi nhận mức sử dụng, ngân sách và hóa đơn trong khi đội ngũ của bạn chứng minh những khối lượng công việc nào thực sự xứng đáng với năng lực GPU chuyên dụng.


