
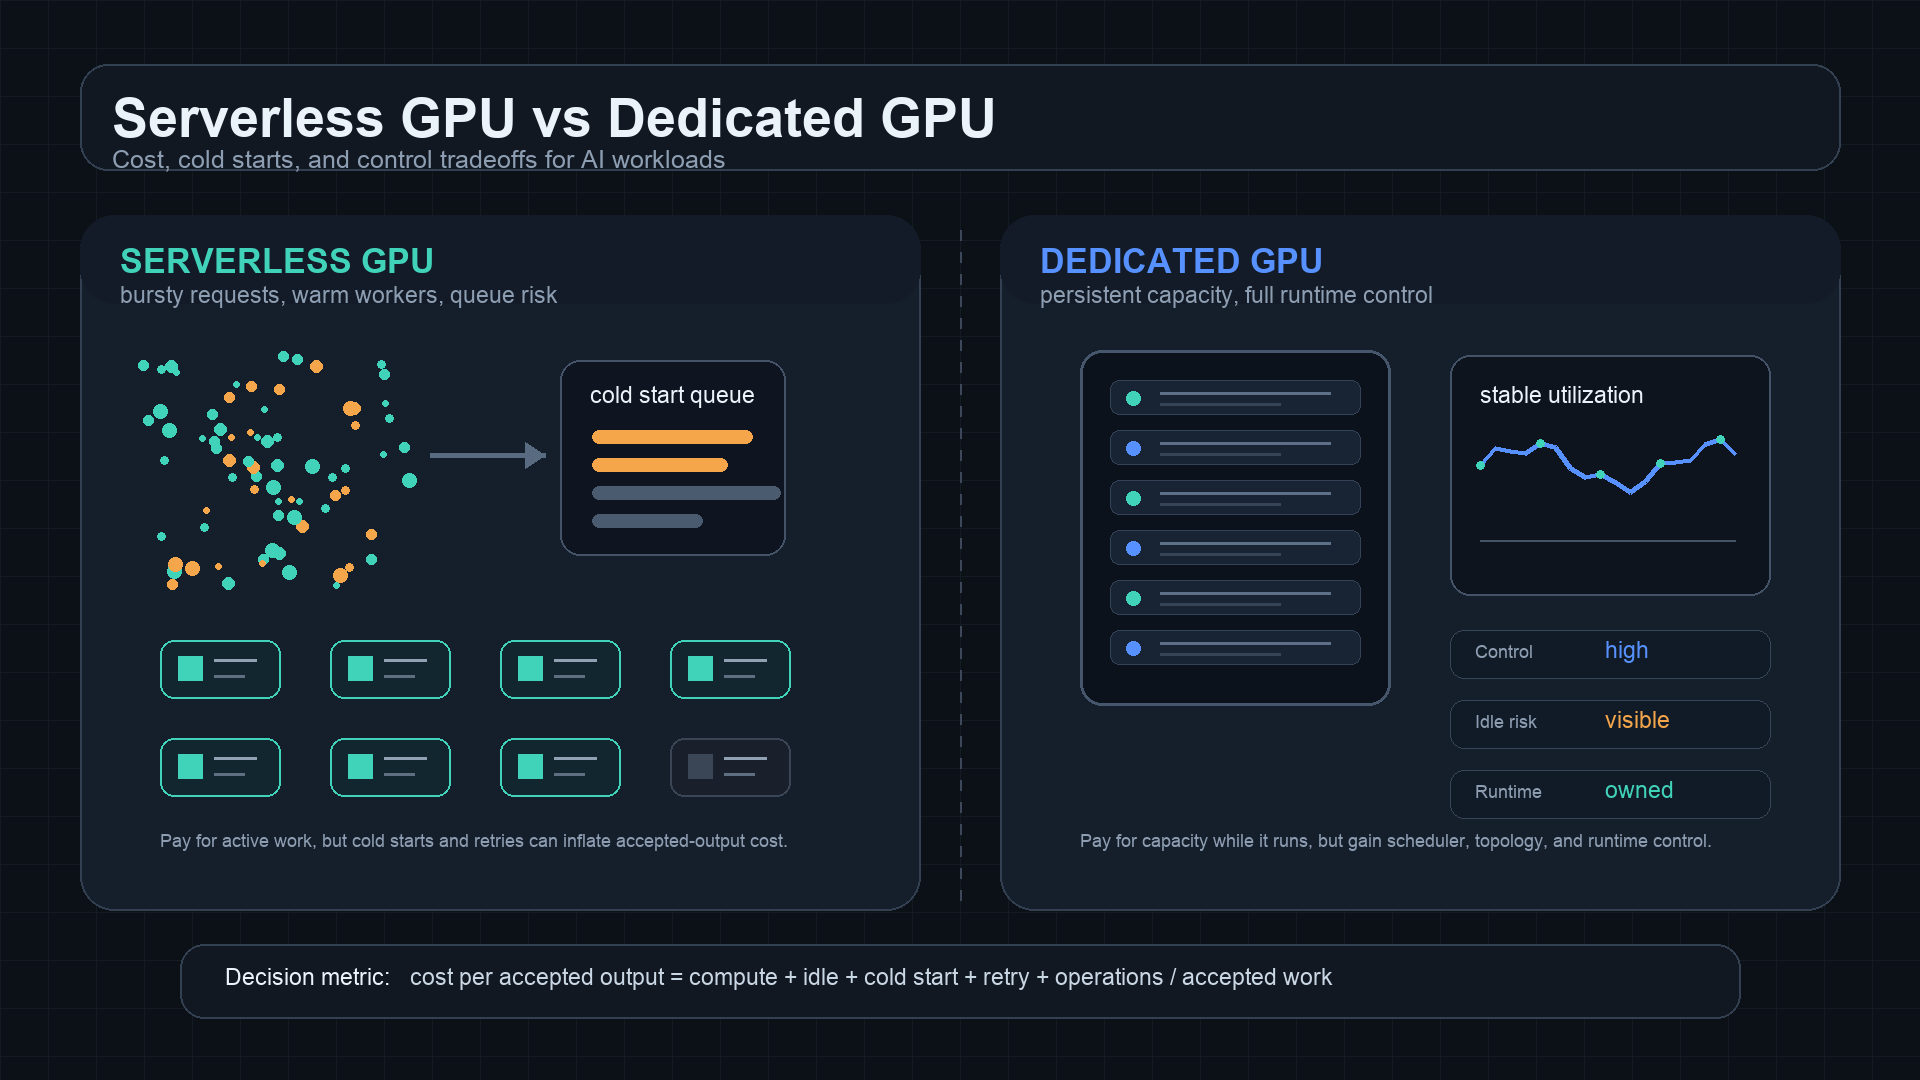
Serverless GPU so với Dedicated GPU: Chi phí, cold start và khả năng kiểm soát
Việc lựa chọn giữa serverless GPU và dung lượng dedicated GPU chủ yếu là câu hỏi về hình dạng khối lượng công việc. Serverless GPU hấp dẫn khi lưu lượng truy cập tăng theo đợt, các thử nghiệm không đều, hoặc nhóm muốn tránh phần cứng nhàn rỗi. Dedicated GPU hấp dẫn khi nhu cầu ổn định, độ trễ khởi động quan trọng, hoặc nhóm cần kiểm soát driver, bộ lập lịch, mạng, bộ nhớ đệm mô hình và các runtime phục vụ.
Sai lầm là so sánh giá request của serverless GPU với giá theo giờ của dedicated GPU như thể chúng mô tả cùng một thứ. Chúng không phải vậy. Một endpoint serverless có thể che giấu cold start, độ trễ hàng đợi, giới hạn đồng thời, chi phí retry và overhead trên mỗi request. Một dedicated GPU có thể che giấu thời gian nhàn rỗi, rủi ro công suất được cấp trước, lưu trữ, hỗ trợ và công việc kỹ thuật nền tảng.
Đối với các nhà phát triển độc lập và các nhóm AI nhỏ, quy tắc thực tế là:
serverless GPU vs dedicated GPU nên được so sánh theo chi phí trên mỗi đầu ra được chấp nhận,
không phải theo mức giá GPU thấp nhất nhìn thấy được.
Nếu bạn vẫn đang phân vân liệu có thực sự cần thuê GPU trực tiếp hay không, cũng hãy đọc các hướng dẫn của Flatkey về GPU cloud so với model API, giá thuê GPU, và chi phí ẩn của cloud GPU. Bài viết này tập trung vào lựa chọn serverless GPU so với dedicated GPU sau khi GPU đã nằm trong bộ đánh giá.
Serverless GPU vs dedicated GPU: câu trả lời nhanh
Hãy dùng bảng này như bộ lọc đầu tiên.
| Điểm quyết định | Serverless GPU thường phù hợp | Dedicated GPU thường phù hợp |
|---|---|---|
| Mẫu lưu lượng | Tăng theo đợt, xếp hàng, thử nghiệm hoặc không đều | Ổn định, khối lượng lớn, nhạy với độ trễ, hoặc đã lên kế hoạch dung lượng |
| Hình thức tính phí | Chủ yếu trả khi worker chạy hoặc request được thực thi, tùy nhà cung cấp | Trả trong khi instance, pod, node, cluster hoặc reservation tồn tại |
| Rủi ro khởi động | Cold start, tải mô hình, kéo container, làm ấm worker và độ trễ hàng đợi | Ít phơi nhiễm cold start hơn sau khi đã làm ấm, nhưng dung lượng nhàn rỗi vẫn bị tính phí |
| Kiểm soát vận hành | Kiểm soát thấp hơn đối với host, bộ lập lịch, runtime, topology và cache | Kiểm soát nhiều hơn đối với driver, stack phục vụ, cache, topology và khả năng quan sát |
| Mô hình độ tin cậy | Hệ thống mở rộng do nhà cung cấp quản lý với giới hạn endpoint và các đường dẫn cold có thể có | Nhóm tự quản lý uptime, autoscaling, failover, vá lỗi và phản ứng sự cố |
| Trường hợp sử dụng đầu tiên tốt nhất | Demo, công việc ảnh/video, batch inference, API không thường xuyên, prototype | Endpoint suy luận ổn định, dịch vụ chạy dài, runtime tùy chỉnh, công việc nhiều node |
Câu trả lời tốt nhất thường theo từng giai đoạn:
- Bắt đầu với serverless GPU khi nhu cầu chưa rõ.
- Đo cold start, độ trễ hàng đợi, tỷ lệ retry và chi phí trên mỗi đầu ra được chấp nhận.
- Chỉ chuyển các khối lượng công việc ổn định, khối lượng lớn sang dung lượng dedicated GPU.
- Giữ một đường dẫn model API mở khi sản phẩm cần nhiều mô hình hoặc không cần kiểm soát phần cứng.
Trình tự đó an toàn hơn việc đặt trước dedicated GPU khi bạn هنوز chưa biết liệu khối lượng công việc có thể sử dụng hết chúng hay không.
"Serverless GPU" có nghĩa là gì trong thực tế
Serverless GPU thường có nghĩa là nhà cung cấp trừu tượng hóa việc sở hữu server chạy dài. Bạn đóng gói một mô hình, container, function hoặc endpoint; nền tảng khởi động các worker GPU khi request đến; và nền tảng có thể tăng hoặc giảm số worker dựa trên nhu cầu.
Các triển khai của nhà cung cấp khác nhau. RunPod mô tả Serverless xoay quanh endpoint và worker, với giá serverless tách biệt so với giá pod. Modal ghi tài liệu về GPU functions, cold start và vòng đời container. Google Cloud Run hỗ trợ các dịch vụ có GPU và có mô hình giá Cloud Run riêng. Các triển khai của Replicate cung cấp các endpoint suy luận production có thể cấu hình. Đây không phải là các sản phẩm giống hệt nhau, vì vậy checklist nguồn rất quan trọng.
Từ góc nhìn người mua, dung lượng serverless GPU hữu ích khi:
- Khối lượng request thấp, tăng theo đợt, hoặc vẫn đang được khám phá.
- Các job có thể chờ trong hàng đợi mà không làm hại trải nghiệm người dùng.
- Cold start có thể chấp nhận được hoặc có thể che giấu.
- Nhóm muốn sở hữu ít hạ tầng hơn.
- Khối lượng công việc được đóng gói thành các job lặp lại thay vì một dịch vụ luôn được làm ấm.
- Doanh nghiệp thích chi tiêu theo mức sử dụng hơn là đặt cược cố định vào dung lượng hàng tháng.
Đổi lại, tradeoff ẩn là serverless GPU không xóa bỏ vật lý. Trọng số mô hình vẫn phải được tải. Container vẫn phải khởi động. GPU vẫn cần dung lượng sẵn có. Độ trễ hàng đợi vẫn ảnh hưởng đến người dùng. Retry vẫn tốn tiền.
"Dedicated GPU" có nghĩa là gì trong thực tế
Dung lượng dedicated GPU có nghĩa là bạn kiểm soát một instance, pod, server, node hoặc cluster đang chạy trong một khoảng thời gian. Đó có thể là theo nhu cầu, đặt trước, cam kết, bare metal, dung lượng trên marketplace hoặc một cluster riêng. Đặc điểm chung là GPU được cấp cho khối lượng công việc của bạn thay vì chỉ được khởi động quanh một request.
Dung lượng dedicated GPU hữu ích khi:
- Endpoint phải luôn ở trạng thái warm.
- Lưu lượng đủ dự đoán được để giữ GPU bận.
- Bạn cần driver tùy chỉnh, phiên bản CUDA, kernel, model server hoặc networking.
- Bạn cần điều kiện benchmark nhất quán.
- Cold start sẽ làm hỏng độ trễ hoặc trải nghiệm người dùng.
- Khối lượng công việc là multi-node, nhạy với topology hoặc nhạy với data locality.
- Bạn muốn trực tiếp vận hành vLLM, SGLang, TensorRT-LLM, Triton, Ray Serve, Kubernetes, Slurm hoặc hạ tầng serving tùy chỉnh.
Sự đánh đổi ẩn là năng lực nhàn rỗi. Nếu một GPU dedicated chạy 730 giờ trong một tháng nhưng chỉ thực hiện công việc hữu ích trong 180 giờ, mức giá theo giờ được niêm yết không phải là chi phí theo giờ hữu ích thực sự. Những giờ nhàn rỗi là một phần của chi phí khối lượng công việc.
Công thức chi phí giúp việc so sánh trở nên công bằng
Hãy dùng chung một mẫu số cho cả hai bên:
chi phí trên mỗi đầu ra được chấp nhận =
  compute
  + storage
  + bandwidth
  + thời gian nhàn rỗi
  + lãng phí do cold start
  + lãng phí do retry và job thất bại
  + support
  + chi phí vận hành kỹ thuật
  / đầu ra, bản ghi, token, hình ảnh, clip hoặc job được chấp nhận
Đối với serverless GPU:
chi phí serverless GPU trên mỗi đầu ra được chấp nhận =
  chi phí worker/request được tính phí
  + lãng phí do cold start và queue
  + chi phí request thất bại và retry
  + storage và transfer artifact
  + chi phí tích hợp nền tảng
  / đầu ra được chấp nhận
Đối với GPU dedicated:
chi phí GPU dedicated trên mỗi đầu ra được chấp nhận =
  chi phí công suất GPU đang chạy
  + storage và networking
  + năng lực nhàn rỗi
  + vận hành stack serving
  + support và xử lý sự cố
  + lãng phí do lỗi và redeploy
  / đầu ra được chấp nhận
Đây là lúc các so sánh serverless GPU so với dedicated GPU thường đảo chiều. Serverless có thể trông đắt theo từng giây nhưng rẻ hơn tổng thể nếu nó tránh được GPU nhàn rỗi. Dedicated có thể trông đắt theo từng tháng nhưng rẻ hơn tổng thể nếu khối lượng công việc giữ cho accelerator luôn bận và tránh được lãng phí do cold start.
Cold start là loại thuế của serverless GPU
Cold start là rủi ro quan trọng nhất của serverless GPU. Một cold start có thể bao gồm:
- Tìm dung lượng GPU.
- Pull hoặc mount image container.
- Import các dependency.
- Load trọng số mô hình.
- Chuyển mô hình lên bộ nhớ GPU.
- Làm ấm kernel hoặc các đường biên dịch.
- Xây dựng lại cache.
- Chờ phía sau các request đã xếp hàng trước đó.
Tài liệu cold-start của Modal hữu ích vì nó tách riêng công việc khởi động container, imports và khởi tạo ứng dụng. Cơ chế cụ thể sẽ khác nhau tùy nhà cung cấp, nhưng bài học thì có thể khái quát: thời gian khởi động là một phần của trải nghiệm người dùng và mô hình chi phí.
Cold start quan trọng nhất khi:
| Khối lượng công việc | Vì sao cold start gây hại |
|---|---|
| Chat tương tác hoặc agents | Người dùng nhận thấy độ trễ token đầu tiên chậm. |
| Chỉnh sửa ảnh realtime | Request đầu tiên có thể cảm giác như bị lỗi dù các request sau nhanh. |
| Webhook hoặc API hướng đến người dùng | Timeout từ upstream có thể biến cold start thành job thất bại. |
| Batch queue với SLA nghiêm ngặt | Độ trễ hàng đợi có thể vi phạm cửa sổ giao hàng. |
| Mô hình lớn | Việc load trọng số có thể chiếm phần lớn đường đi của request. |
Serverless GPU vẫn có thể là lựa chọn đúng nếu ứng dụng có thể hấp thụ độ trễ này. Ví dụ, các job ảnh offline, hàng đợi đánh giá ban đêm, async batch inference và các thử nghiệm nội bộ thường chịu được thời gian làm ấm tốt hơn chat hướng đến khách hàng.
GPU dedicated đánh đổi cold start lấy rủi ro nhàn rỗi
GPU dedicated thường giảm mức độ phơi nhiễm với cold start vì dịch vụ có thể luôn warm. Trọng số mô hình vẫn được nạp, cache vẫn nóng, và routing request có thể nhắm tới một endpoint đã biết.
Nhưng năng lực dedicated tạo ra một loại thuế khác:
tỷ lệ lãng phí nhàn rỗi =
  1 - thời gian GPU hoạt động hữu ích / thời gian chạy được tính phí
Nếu tỷ lệ GPU hoạt động hữu ích là 30%, thì mức giá theo giờ thấp hơn vẫn có thể trở nên đắt đỏ. GPU dedicated có thể sẵn sàng về mặt kỹ thuật, nhưng lại nhàn rỗi về mặt tài chính.
GPU dedicated phù hợp nhất khi bạn có thể chứng minh:
- Sản lượng request cơ bản.
- Mức sử dụng GPU cao sau khi batch và queue.
- Lựa chọn mô hình ổn định.
- Yêu cầu bộ nhớ có thể dự đoán.
- Một serving stack mà đội ngũ có thể vận hành.
- Một kế hoạch cho rolling deploy, monitoring, alerts và fallback.
Nếu các đầu vào đó chưa rõ, serverless GPU hoặc một model API thường là bước khởi đầu gọn gàng hơn.
Kiểm soát: điều mà GPU dedicated mang lại
Lập luận mạnh nhất cho năng lực GPU dedicated không phải lúc nào cũng là giá. Đó là khả năng kiểm soát.
Năng lực dedicated cho đội ngũ nhiều quyền quyết định hơn về:
- Model GPU, bộ nhớ và số lượng.
- Vùng và data locality.
- Phiên bản CUDA, driver, kernel và image.
- vLLM, SGLang, TensorRT-LLM, Triton, Ray Serve hoặc các thiết lập runtime tùy chỉnh.
- Continuous batching, hành vi KV cache, quantization, speculative decoding và tinh chỉnh scheduler.
- Local model cache và weights được nạp sẵn.
- Topology mạng, private links, thiết kế VPC, load balancer và ingress.
- Observability, traces, logs và xử lý sự cố.
Khả năng kiểm soát đó rất có giá trị khi khối lượng công việc đủ quan trọng để biện minh cho việc sở hữu. Nó trở nên đắt đỏ khi đội ngũ chỉ cần đầu ra mô hình đáng tin cậy.
Đây là ranh giới tương tự được đề cập trong các bài viết GPU tốt nhất cho suy luận LLM, hướng dẫn triển khai vLLM, và vLLM so với SGLang của Flatkey. Nếu bạn đang tinh chỉnh chính runtime, dung lượng GPU chuyên dụng có thể là lớp phù hợp. Nếu bạn đang triển khai các tính năng sản phẩm trên nhiều mô hình, một đường đi qua API được quản lý có thể nhanh hơn.
Ma trận quyết định khối lượng công việc
Hãy dùng ma trận này trước khi xây dựng bảng tính.
| Khối lượng công việc | Điểm khởi đầu tốt hơn | Tại sao |
|---|---|---|
| Tính năng sản phẩm AI mới với nhu cầu chưa rõ | Serverless GPU hoặc model API | Tránh mua dung lượng nhàn rỗi trước khi biết lưu lượng. |
| Hàng đợi tạo ảnh không đồng bộ | Serverless GPU | Độ trễ hàng đợi có thể chấp nhận được, và các đợt tăng đột biến không cần GPU luôn bật. |
| Bản demo hoặc nguyên mẫu ngắn hạn | Serverless GPU | Thiết lập nhanh và thanh toán theo mức sử dụng thường quan trọng hơn khả năng kiểm soát runtime. |
| Suy luận LLM ổn định với khối lượng lớn | Dedicated GPU | Mức sử dụng duy trì có thể khấu hao cho cả stack phục vụ. |
| Endpoint khách hàng nhạy cảm với độ trễ | Dedicated GPU hoặc model API | Cold start và độ trễ hàng đợi khó che giấu hơn. |
| Mô hình lớn có thời gian tải trọng số chậm | Dedicated GPU | Giữ trọng số luôn nóng có thể tốt hơn việc khởi động serverless lặp đi lặp lại. |
| Bộ đánh giá chạy định kỳ | Serverless GPU, spot GPU, hoặc batch model API | Các job có thể thử lại và có thể chạy phía sau một hàng đợi. |
| CUDA kernel tùy chỉnh hoặc nghiên cứu runtime | Dedicated GPU | Nhóm cần quyền kiểm soát ở mức thấp. |
| Huấn luyện đa nút hoặc suy luận phân tán | Cụm chuyên dụng | Topology, mạng, và các miền lỗi là yếu tố chi phối. |
| Sản phẩm cần nhiều mô hình frontier | Model API hoặc gateway | Sở hữu GPU trực tiếp không giải quyết được việc truy cập mô hình từ nhiều nhà cung cấp. |
Đối với việc lập kế hoạch dung lượng rộng hơn, hãy kết hợp phần này với các hướng dẫn của Flatkey về GPU theo nhu cầu so với GPU spot, TCO của cụm GPU, và thuê cụm GPU.
Bẫy chi phí của Serverless GPU
Kinh tế của Serverless GPU có thể gây thất vọng khi các nhóm bỏ qua những trường này.
| Bẫy | Điều gì xảy ra | Kiểm soát |
|---|---|---|
| Tải mô hình chậm | Mỗi worker cold start đều tiêu tốn thời gian tính phí trước khi công việc hữu ích bắt đầu | Đóng gói sẵn artifacts, thu nhỏ image, cache trọng số, đo warmup riêng |
| Không khớp timeout | Cold start kích hoạt timeout ở upstream và các lần retry | Đặt timeout thực tế, dùng hàng đợi bất đồng bộ, job ID idempotent |
| Hàng đợi mờ | Người dùng thấy độ trễ nhưng dashboard chỉ hiển thị các request đã hoàn thành | Theo dõi thời gian chờ hàng đợi, thời gian cold start, thời gian worker hoạt động, và độ trễ đầu ra sau khi chấp nhận |
| Job nhỏ trên GPU lớn | Overhead trên mỗi request chiếm ưu thế so với compute hữu ích | Batch công việc hoặc dùng mô hình nhỏ hơn/đường API |
| Giới hạn concurrency khi tăng đột biến | Request bị dồn lại trong các cửa sổ ra mắt | Kiểm thử tải concurrency của endpoint trước khi ra mắt |
| Khuếch đại do retry | Job thất bại làm tăng số lần thử bị tính phí | Theo dõi output đã chấp nhận, không phải output đã thử |
| Truyền dữ liệu | Input, trọng số, và output di chuyển lặp đi lặp lại | Giữ artifacts gần worker và hết hạn các tệp tạm thời |
Câu hỏi khi mua sắm không phải là "nhà cung cấp có hỗ trợ Serverless GPU không?" Mà là "chi phí trên mỗi output được chấp nhận sẽ ra sao khi worker đang lạnh, hàng đợi đầy, và các lần retry xảy ra?"
Bẫy chi phí của Dedicated GPU
Kinh tế của Dedicated GPU có thể gây thất vọng theo hướng ngược lại.
| Bẫy | Điều gì xảy ra | Kiểm soát |
|---|---|---|
| Endpoint nhàn rỗi | GPU luôn ấm để phục vụ các request hiếm | Tự động mở rộng, gộp khối lượng công việc, hoặc dùng serverless/model API cho lưu lượng thấp |
| Bộ nhớ bị cấp dư | Một GPU lớn chạy khối lượng công việc vốn phù hợp với phần cứng nhỏ hơn | Đo benchmark bộ nhớ và throughput của mô hình trước khi cam kết |
| Không khớp với mức đặt trước | Hợp đồng giả định nhu cầu không bao giờ xuất hiện | Đặt trước dựa trên baseline đã đo, không phải dự báo ra mắt |
| Sở hữu serving stack | Kỹ sư phải duy trì runtime thay vì tính năng sản phẩm | Tính công việc nền tảng vào TCO |
| Các dòng chi phí cloud ẩn | Lưu trữ, egress, hỗ trợ, và mạng nằm ngoài mức giá GPU | Dùng bảng tính chi phí ẩn đầy đủ cho GPU cloud |
| Thay đổi mô hình | Thế hệ mô hình mới làm thay đổi bộ nhớ, độ chính xác, hoặc nhu cầu runtime | Giữ các đường thoát mở |
| Gánh nặng sự cố | Uptime trở thành vấn đề của nhóm bạn | Xác định cảnh báo, phương án dự phòng, và phạm vi hỗ trợ của nhà cung cấp |
Khả năng kiểm soát của Dedicated GPU chỉ có giá trị khi nhóm có thể sử dụng nó. Nếu khối lượng công việc không đủ ổn định để tinh chỉnh, quyền kiểm soát bổ sung đó có thể trở thành gánh nặng vận hành.
Ví dụ minh họa: vì sao câu trả lời thay đổi theo mức sử dụng
Giả sử một nhóm vận hành một tính năng tạo media không đồng bộ. Các mức giá chính xác là giả định; hãy thay chúng bằng giá đã xác minh từ nhà cung cấp trước khi mua.
| Trường | Serverless GPU | Dedicated GPU |
|---|---|---|
| Số công việc được chấp nhận mỗi tháng | 120,000 | 120,000 |
| Compute được liệt kê | Phụ thuộc vào mức sử dụng | Năng lực cố định hàng tháng |
| Cold start và lãng phí do hàng đợi | Cao hơn | Thấp hơn |
| Năng lực nhàn rỗi | Thấp hơn | Cao hơn |
| Kiểm soát thời gian chạy | Thấp hơn | Cao hơn |
| Rủi ro phù hợp nhất | Nhu cầu chưa rõ | Nhu cầu ổn định |
Nếu phần lớn công việc đến theo các đợt ngắn còn phần còn lại của ngày khá yên ắng, serverless GPU có thể thắng vì tránh được năng lực dedicated nhàn rỗi. Nếu công việc đến đều đặn suốt cả ngày và mô hình có đường khởi động chậm, dedicated GPU có thể thắng vì worker luôn ở trạng thái nóng và thông lượng dễ tinh chỉnh hơn.
Bây giờ hãy đổi workload sang suy luận LLM hướng tới khách hàng với độ trễ nghiêm ngặt. Quyết định có thể đảo chiều ngay cả khi serverless trông rẻ hơn trên lưu lượng nhẹ, vì các đường cold-start và độ trễ hàng đợi tạo ra rủi ro cho sản phẩm. Trong trường hợp đó, dedicated GPU hoặc một API mô hình được quản lý với các kiểm soát độ trễ đã thiết lập có thể an toàn hơn.
Điểm mấu chốt không phải là một mô hình luôn thắng. Điểm mấu chốt là serverless GPU so với dedicated GPU nên được quyết định dựa trên hình dạng workload đã đo lường.
Kế hoạch benchmark trước khi lựa chọn
Chạy cùng một workload qua cả hai đường trong một cửa sổ kiểm thử đại diện. Theo dõi các chỉ số sau.
| Chỉ số | Đường serverless GPU | Đường dedicated GPU |
|---|---|---|
| Đầu ra được chấp nhận | Đếm số đầu ra thành công sau các bộ lọc chất lượng | Cùng mẫu số |
| Đầu ra đã thử | Bao gồm các công việc thất bại và được thử lại | Bao gồm các công việc thất bại và được thử lại |
| Độ trễ p50 / p95 / p99 | Bao gồm thời gian hàng đợi và cold-start | Bao gồm thời gian định tuyến và batching |
| Thời gian đến công việc hữu ích đầu tiên | Khởi động worker, tải model, warmup | Bắt đầu triển khai, tải model, rollout |
| Tỷ lệ cold start | Phần trăm request chạm vào worker lạnh | Thường thấp hơn sau warmup |
| Thời gian chờ hàng đợi | Độ trễ hàng đợi của endpoint và áp lực đồng thời | Hàng đợi của scheduler và thời gian chờ batch |
| Sử dụng GPU | Thời gian worker hoạt động nếu được hiển thị | Sử dụng compute và bộ nhớ GPU |
| Chi phí nhàn rỗi | Thường thấp hơn, nhưng hãy kiểm tra mức tối thiểu | Rủi ro chi phí chính |
| Tỷ lệ thử lại | Timeout, lỗi worker, lỗi năng lực | OOM, triển khai, runtime, lỗi host |
| Giờ công kỹ thuật | Tích hợp và gỡ lỗi endpoint | Vận hành nền tảng và xử lý sự cố |
Bài kiểm thử nên bao gồm điều kiện lạnh, điều kiện ấm, lưu lượng bùng nổ, lưu lượng bình thường và khôi phục sau lỗi. Một benchmark chỉ đo thông lượng khi ấm không phải là quyết định serverless GPU so với dedicated GPU; đó chỉ là một bài kiểm tra tốc độ một phần.
Danh sách kiểm tra nguồn nhà cung cấp
Hãy dùng các trang chính thức làm danh sách kiểm tra nguồn, không phải các bảng giá cố định. Kiểm tra lại vào ngày bạn phê duyệt chi tiêu.
| Nhà cung cấp/danh mục | Nguồn chính thức cần kiểm tra | Những gì cần ghi lại |
|---|---|---|
| RunPod Serverless | Tổng quan RunPod Serverless, Giá RunPod Serverless | Mô hình endpoint, hành vi worker, cơ sở tính phí, hành vi cold-start, lưu trữ, mạng, đồng thời, logs, giới hạn |
| RunPod Pods / kiểu dedicated | Tổng quan RunPod Pods, Giá RunPod Pods, Giá RunPod | Mô hình GPU, chế độ secure/community, tính phí pod, lưu trữ, volume mạng, kỳ vọng thời gian hoạt động |
| Modal | Tài liệu GPU của Modal, Cold start của Modal, Giá Modal | Loại GPU, vòng đời function, kiểm soát cold-start, chiến lược image container, tính phí theo mức sử dụng hoạt động |
| Google Cloud Run with GPUs | Cấu hình GPU trên Cloud Run, Giá Cloud Run | Ràng buộc dịch vụ GPU, số instance tối thiểu, đồng thời, tính phí CPU/bộ nhớ/GPU, tác động lên độ trễ request |
| Google Compute Engine GPUs | Giá GPU của Compute Engine | Loại GPU, khu vực, chi phí VM, đĩa, mạng, đặt trước, giảm giá committed use |
| AWS EC2 GPU instances | Giá Amazon EC2 | On-Demand, Spot, Savings Plans, Reserved Instances, capacity blocks, lưu trữ, truyền dữ liệu, hỗ trợ |
| Lambda Cloud | Lambda GPU Cloud | Loại instance, khả dụng, điều khoản on-demand/reserved, lưu trữ, mạng, phạm vi hỗ trợ |
| Replicate deployments | Tài liệu Replicate deployments | Cấu hình deployment, hành vi mở rộng, tùy chọn phần cứng, số instance tối thiểu/tối đa, mức độ phù hợp cho endpoint production |
Đối với bài viết này, danh sách kiểm tra nguồn đã được xem xét vào ngày 13 tháng 10 năm 2026.
Các câu hỏi mua sắm trước khi bạn cam kết
Hãy hỏi những câu này trước khi chọn serverless GPU so với dedicated GPU.
| Câu hỏi | Vì sao điều này quan trọng |
|---|---|
| Đâu là mẫu số cho output được chấp nhận? | Ngăn việc so sánh số lần thử yêu cầu với kết quả kinh doanh thành công. |
| Endpoint sẽ lạnh bao lâu một lần? | Cold start có thể chi phối độ trễ và chi phí đối với khối lượng công việc không thường xuyên. |
| Việc tải mô hình mất bao lâu? | Weights lớn có thể xóa sạch khoản tiết kiệm của serverless. |
| Điều gì xảy ra khi có concurrency tăng đột biến? | Hàng đợi của serverless và autoscaler của dedicated đều cần các bài kiểm thử chịu tải. |
| Tỷ lệ GPU dedicated nhàn rỗi là bao nhiêu? | Năng lực nhàn rỗi là điểm rò rỉ chi phí cố định chính. |
| Các job có thể retry an toàn không? | Serverless và các workflow kiểu spot đều cần tính idempotent. |
| Có cần kiểm soát runtime tùy chỉnh không? | Nếu không, việc sở hữu GPU dedicated có thể là không cần thiết. |
| Storage, egress, logs và support có được bao gồm không? | Compute GPU chỉ là một phần của hóa đơn. |
| Khối lượng công việc có thể chuyển sang model API không? | Các sản phẩm có mức sử dụng thấp hoặc nhiều mô hình có thể không đáng để vận hành GPU. |
| Lộ trình thoát là gì nếu mô hình thay đổi? | Các cam kết về phần cứng trở nên rủi ro khi kiến trúc mô hình thay đổi. |
Gói mua sắm tốt nhất bao gồm kết quả benchmark, bảng tính chi phí trên mỗi output được chấp nhận, và lý do rõ ràng vì sao đội ngũ cần либо năng lực GPU serverless theo nhu cầu sử dụng hoặc năng lực GPU dedicated được kiểm soát.
Khi model API tốt hơn cả hai
Cả GPU serverless và GPU dedicated đều giả định rằng việc vận hành ở tầng GPU là hữu ích. Đôi khi thì không.
Model API hoặc gateway được quản lý có thể tốt hơn khi:
- Nhu cầu chưa rõ hoặc có tính tăng đột biến.
- Sản phẩm cần nhiều mô hình, không phải một mô hình tự lưu trữ ổn định.
- Đội ngũ cần các mô hình frontier hoặc độc quyền.
- Độ tin cậy, phương án dự phòng và sự đa dạng nhà cung cấp quan trọng hơn quyền kiểm soát host.
- Bộ phận tài chính cần sổ cái sử dụng, ngân sách và một hóa đơn duy nhất.
- Thời gian kỹ thuật được dùng tốt hơn cho hành vi sản phẩm thay vì vận hành GPU.
Flatkey phù hợp với phía quyết định này. Nó cung cấp cho các đội một lộ trình tương thích OpenAI, một khóa, một số dư, một hóa đơn, khả năng quan sát mức sử dụng, và quyền truy cập vào các endpoint mô hình chính thức trên nhiều nhà cung cấp. Nếu bảng tính serverless GPU so với dedicated GPU cho thấy mức sử dụng thấp, lãng phí do cold start cao, hoặc chi phí vận hành quá lớn, hãy so sánh hướng đó với so sánh giá mô hình AI, so sánh giá AI API, và quản lý chi tiêu AI API trước khi cam kết với hạ tầng GPU.
Khuyến nghị cuối cùng
Hãy dùng trình tự này cho quyết định serverless GPU so với dedicated GPU:
- Dùng GPU serverless cho nguyên mẫu, các job bùng nổ, hàng đợi async, và nhu cầu chưa biết.
- Đo cold start, độ trễ hàng đợi, tỷ lệ retry, và chi phí trên mỗi output được chấp nhận.
- Chỉ chuyển khối lượng công việc ổn định, khối lượng lớn, nhạy độ trễ sang năng lực GPU dedicated sau khi đã chứng minh được mức sử dụng.
- Giữ sẵn một tuyến model API khi lựa chọn mô hình thay đổi thường xuyên, không cần kiểm soát phần cứng, hoặc đội ngũ cần thanh toán và phương án dự phòng rõ ràng hơn.
Serverless GPU so với dedicated GPU không phải là một lựa chọn thắng-thua chung cho mọi trường hợp. GPU serverless mua được sự linh hoạt và giảm rủi ro nhàn rỗi. GPU dedicated mua được khả năng kiểm soát và năng lực ấm hơn. Câu trả lời đúng là câu trả lời mang lại cho đội ngũ chi phí thấp nhất trên mỗi output được chấp nhận trong khi đặt độ trễ, độ tin cậy và rủi ro vận hành ở nơi bạn thực sự có thể quản lý chúng.
Câu hỏi thường gặp
GPU serverless có rẻ hơn GPU dedicated không?
GPU serverless rẻ hơn khi lưu lượng thấp, bùng nổ, hoặc không chắc chắn đến mức GPU dedicated sẽ phải nằm idle. GPU dedicated rẻ hơn khi mức sử dụng cao, mô hình luôn ấm, và đội ngũ có thể vận hành stack phục vụ một cách hiệu quả.
GPU serverless luôn có cold start không?
Không phải mọi yêu cầu đều sẽ là cold, và các nhà cung cấp đưa ra những điều khiển khác nhau cho năng lực ấm, số worker tối thiểu, tối ưu hóa image, và mở rộng quy mô. Nhưng cold start là rủi ro cốt lõi trong đánh giá GPU serverless vì các mô hình lớn và container có thể cần thời gian đáng kể mới trở nên hữu dụng.
Khi nào tôi nên chuyển từ GPU serverless sang GPU dedicated?
Hãy chuyển khi bạn chứng minh được nhu cầu ổn định, mức sử dụng cao, độ trễ cold start không chấp nhận được, cần kiểm soát runtime tùy chỉnh, hoặc có lợi thế về chi phí trên mỗi output được chấp nhận sau khi đã tính đến vận hành và thời gian nhàn rỗi.
GPU dedicated có tốt hơn cho suy luận LLM không?
GPU dedicated có thể tốt hơn cho suy luận LLM ổn định với lưu lượng lớn, đặc biệt khi bạn tinh chỉnh vLLM, SGLang, TensorRT-LLM, batching, hành vi cache và quá trình tải mô hình. Với sản phẩm có lưu lượng thấp, nhiều mô hình, hoặc thay đổi nhanh, model API có thể đơn giản và rẻ hơn.
Tôi nên đo gì trước tiên?
Hãy đo output được chấp nhận, tỷ lệ cold start, thời gian chờ hàng đợi, độ trễ p95/p99, tỷ lệ retry, mức sử dụng GPU hữu ích, chi phí idle, storage/egress, và số giờ kỹ thuật. Những chỉ số đó giúp quyết định serverless GPU so với dedicated GPU trở nên có cơ sở.


