
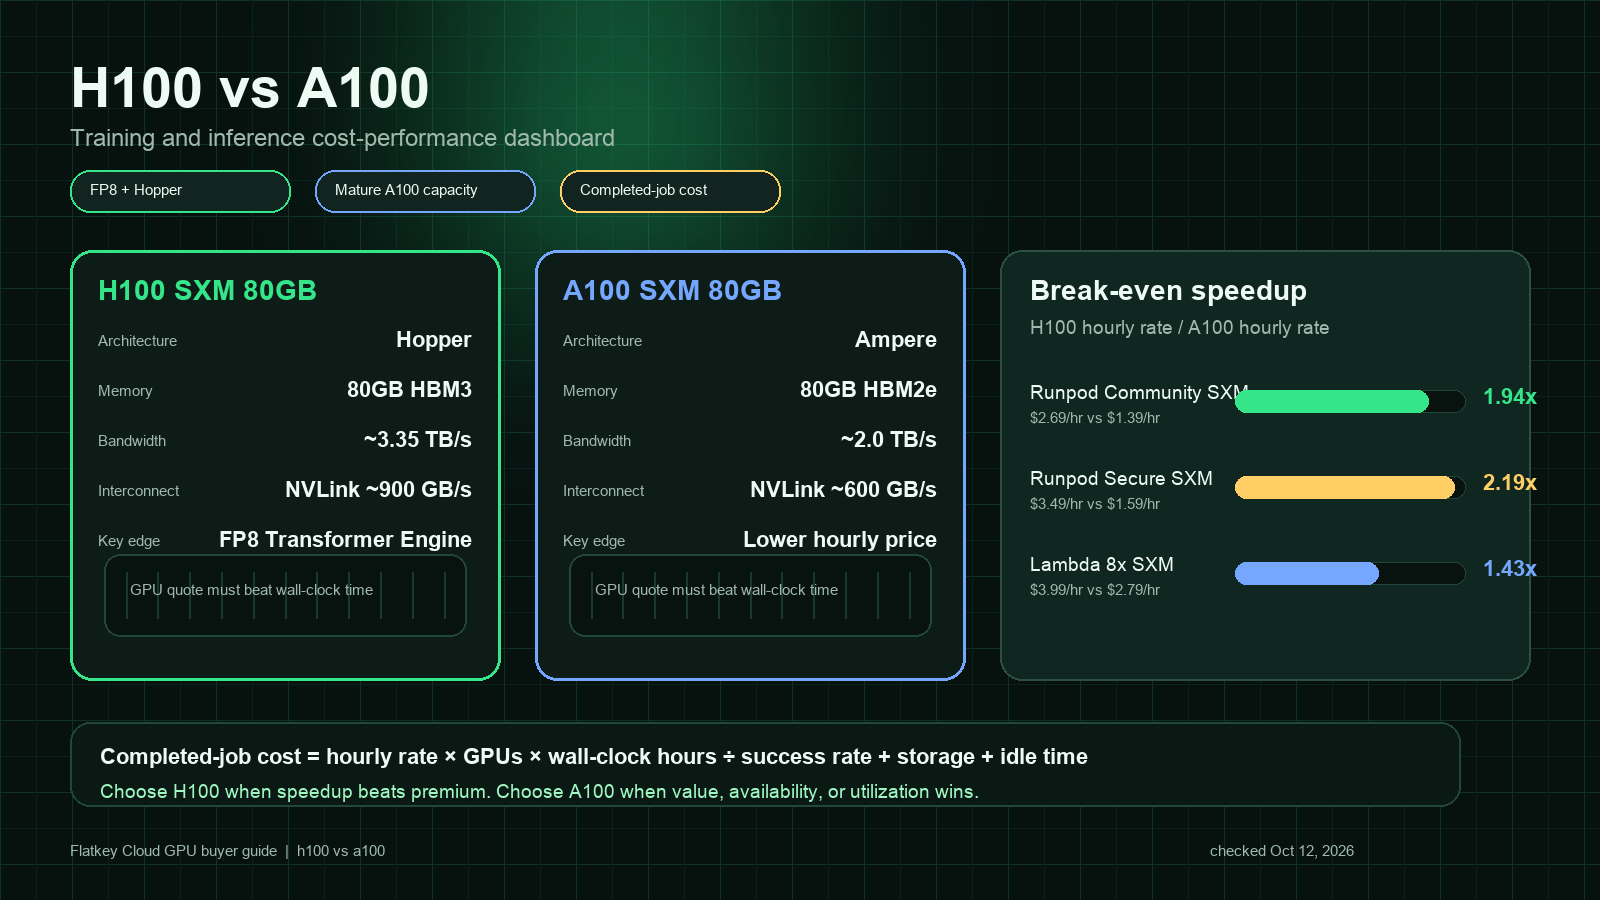
Câu trả lời ngắn cho H100 vs A100 khá rõ ràng: chọn H100 khi khối lượng công việc có thể tận dụng các tính năng của Hopper như FP8 Transformer Engine, băng thông bộ nhớ cao hơn, NVLink thế hệ thứ tư nhanh hơn, và các kernel suy luận mới hơn. Chọn A100 khi tác vụ ổn định về bộ nhớ, thông lượng FP16/BF16 đã đủ, tính sẵn có quan trọng hơn tốc độ đỉnh, hoặc báo giá theo giờ của A100 thấp hơn nhiều.
Đó là lý do câu hỏi đúng không phải là "GPU nào nhanh hơn?" H100 là bộ tăng tốc mới hơn và nhanh hơn. Câu hỏi của bên mua là: H100 có hoàn thành tác vụ huấn luyện hoặc suy luận của bạn đủ nhanh hơn để bù lại phần chênh giá so với A100 không?
Hướng dẫn này so sánh NVIDIA H100 vs A100 cho huấn luyện AI, suy luận LLM, fine-tuning, tác vụ batch, và mua sắm GPU trên đám mây. Giá thay đổi mỗi tuần, vì vậy hãy xem các hàng giá công khai bên dưới như các ví dụ báo giá được kiểm tra vào ngày 12 tháng 10, 2026, rồi chạy lại phép tính tương tự với danh sách nhà cung cấp bạn đã chọn.
Hiệu năng H100 vs A100: bảng quyết định nhanh
| Khối lượng công việc | Thường chọn | Lý do |
|---|---|---|
| Huấn luyện LLM tiên phong hoặc tiền huấn luyện phân tán quy mô lớn | H100 SXM | FP8 Transformer Engine, băng thông bộ nhớ cao hơn, NVLink nhanh hơn, và dư địa tốt hơn cho mở rộng đa GPU. |
| Fine-tuning các mô hình 7B đến 70B | Tùy trường hợp | H100 thắng khi thời gian huấn luyện quan trọng; A100 thắng khi run không bị giới hạn bởi thông lượng hoặc ngân sách cố định. |
| Suy luận LLM nhạy với độ trễ | H100 | Đường dẫn suy luận transformer tốt hơn, băng thông cao hơn, và tối ưu hóa mới hơn cho tầng phục vụ. |
| Suy luận batch với SLA thoáng hơn | A100 | Giá theo giờ thấp hơn có thể thắng nếu mức sử dụng cao và thời gian chờ hàng đợi chấp nhận được. |
| Notebook đa thuê bao, demo, và tác vụ nhỏ | A100 | Tính sẵn có trưởng thành, chi phí thấp hơn, và hỗ trợ MIG khiến A100 trở thành lựa chọn mặc định thực dụng. |
| Khối lượng công việc bị giới hạn bởi bộ nhớ và vừa trong 80 GB | Kiểm tra cả hai | H100 có băng thông cao hơn nhiều, nhưng A100 80 GB vẫn có thể rẻ hơn trên mỗi tác vụ hoàn thành. |
| Khối lượng công việc CUDA cũ đã được tinh chỉnh cho Ampere | Ưu tiên A100 | Rủi ro di chuyển thấp hơn trừ khi benchmark H100 chứng minh được mức tăng đáng kể. |
Đối với hầu hết các đội đang so sánh hiệu năng h100 vs a100, hãy bắt đầu với quy tắc hai dòng:
- Nếu tác vụ đắt vì chạy quá lâu, hãy benchmark H100 trước.
- Nếu tác vụ đắt vì GPU nhàn rỗi, thất bại, hoặc chờ dữ liệu, hãy tối ưu mức sử dụng trước khi trả tiền cho H100.
Khác biệt thông số cốt lõi
Khác biệt quan trọng nhất giữa NVIDIA A100 vs H100 là thế hệ kiến trúc. A100 dựa trên NVIDIA Ampere. H100 dựa trên NVIDIA Hopper và bổ sung Transformer Engine, tăng tốc tensor FP8, NVLink mới hơn, và giới hạn công suất SXM cao hơn. NVIDIA định vị H100 cho AI quy mô lớn, HPC, và khối lượng công việc nghìn tỷ tham số, trong khi A100 vẫn là bộ tăng tốc trung tâm dữ liệu được triển khai rộng rãi cho huấn luyện, suy luận, phân tích, và HPC. Nguồn: trang sản phẩm NVIDIA H100, trang sản phẩm NVIDIA A100, và bảng dòng sản phẩm GPU trung tâm dữ liệu NVIDIA.
| Hạng mục | NVIDIA H100 SXM 80 GB | NVIDIA A100 SXM 80 GB | Hàm ý cho bên mua |
|---|---|---|---|
| Kiến trúc | Hopper | Ampere | H100 là thế hệ mới hơn được tối ưu cho AI. |
| Bộ nhớ | 80 GB HBM3 | 80 GB HBM2e | Cùng dung lượng tiêu đề cho các phiên bản 80 GB phổ biến, nhưng H100 có bộ nhớ nhanh hơn. |
| Băng thông bộ nhớ | Lên tới khoảng 3,35 TB/s | Lên tới khoảng 2,0 TB/s | H100 có nhiều dư địa hơn cho huấn luyện và suy luận bị giới hạn bởi bộ nhớ. |
| Độ chính xác tensor | FP8, FP16, BF16, TF32, đường tensor FP64 | FP16, BF16, TF32, đường tensor FP64 | FP8 có thể cải thiện đáng kể thông lượng transformer nếu vẫn đảm bảo độ chính xác. |
| Thế hệ NVLink | NVLink thế hệ thứ tư, băng thông GPU-đến-GPU lên tới 900 GB/s trên SXM | NVLink thế hệ thứ ba, băng thông GPU-đến-GPU lên tới 600 GB/s trên SXM | H100 mạnh hơn cho huấn luyện đa GPU và song song hóa mô hình lớn. |
| MIG | Có hỗ trợ | Có hỗ trợ | Cả hai đều có thể phân vùng GPU cho sử dụng đa thuê bao. |
| Ngưỡng công suất SXM điển hình | Cao hơn | Thấp hơn | H100 có thể cần nhiều điện và làm mát hơn, nhưng có thể hoàn thành nhanh hơn. |
Các con số này giải thích vì sao so sánh h100 gpu vs a100 sẽ thay đổi theo khối lượng công việc. Một mô hình có thể dùng FP8 và các kernel mới hơn có thể thấy H100 vượt lên rất xa. Một tác vụ nhỏ hơn bị nghẽn bởi tiền xử lý CPU, lưu trữ, hoặc mạng có thể cho thấy mức tăng ít hơn nhiều.
Công thức hiệu năng trên chi phí
Hãy dùng chi phí cho tác vụ đã hoàn thành thay vì giá theo giờ:
completed_job_cost =
  GPU_hourly_rate
  x number_of_GPUs
  x wall_clock_hours
  / success_rate
  + storage
  + network
  + idle_time
  + orchestration_overhead
Sau đó so sánh:
H100 must be at least this much faster to break even =
  H100_hourly_rate / A100_hourly_rate
Nếu H100 đắt gấp 1,8 lần A100, nó cần hoàn thành cùng một tác vụ đã được chấp nhận nhanh hơn hơn 1,8 lần mới có thể thắng về tiền thuê GPU thuần túy. Nếu nó đắt gấp 1,4 lần, ngưỡng hòa vốn sẽ thấp hơn. Đây là lý do lựa chọn GPU trên đám mây luôn nên dùng đúng SKU và báo giá: H100 SXM, H100 PCIe, H100 NVL, A100 SXM 80 GB, và A100 PCIe 40 GB không thể thay thế cho nhau.
Đối với một bảng tính rộng hơn về các chi phí ẩn, hãy xem hướng dẫn của Flatkey về giá thuê GPU.
Ví dụ về giá GPU trên public cloud được kiểm tra vào ngày 12 tháng 10, 2026
Bảng dưới đây không phải là một chỉ số giá chung. Nó là một ảnh chụp nhanh của các ví dụ công khai cho thấy mức chênh lệch có thể lớn đến mức nào.
| Trang nhà cung cấp | Ví dụ H100 | Ví dụ A100 | Điều này cho thấy gì |
|---|---|---|---|
| Bảng giá Runpod | H100 SXM: Community Cloud $2.69/giờ, Secure Cloud $3.49/giờ; H100 PCIe: Community Cloud $1.99/giờ, Secure Cloud $2.89/giờ | A100 SXM: Community Cloud $1.39/giờ, Secure Cloud $1.59/giờ; A100 PCIe: Community Cloud $1.19/giờ, Secure Cloud $1.59/giờ | Chợ mua bán và môi trường bảo mật có thể có điểm hòa vốn khác nhau. |
| Bảng giá Lambda | Dòng cụm 8x H100 SXM: $3.99/GPU/giờ; dòng đơn H100 SXM: $4.29/GPU/giờ; dòng đơn H100 PCIe: $3.29/GPU/giờ | Dòng 8x A100 SXM 80 GB: $2.79/GPU/giờ; dòng đơn A100 SXM 40 GB: $1.99/GPU/giờ | Kích thước cụm, dung lượng bộ nhớ và cấu hình node quan trọng không kém tên GPU. |
| Bảng giá Massed Compute | Trang liệt kê các mức giá GPU và cấu hình theo nhu cầu | Trang liệt kê các mức giá GPU và cấu hình theo nhu cầu | Luôn kiểm tra số lượng, bộ nhớ, lưu trữ và chi tiết instance trước khi so sánh. |
Từ những ví dụ này, người mua đang so sánh hiệu năng a100 vs h100 không nên giả định có một mức chênh lệch cố định duy nhất. Trong một báo giá, H100 PCIe có thể đủ gần với A100 để H100 dễ được biện minh. Trong báo giá khác, A100 có thể đủ rẻ để một lần chạy chậm hơn vẫn có lợi hơn.
So sánh khi huấn luyện
Đối với huấn luyện, H100 thường là GPU đầu tiên nên thử khi:
- Bạn huấn luyện các mô hình transformer và có thể an toàn dùng FP8 mixed precision.
- Công việc đủ lớn để tốc độ kernel và tốc độ liên kết nội bộ chi phối phần chi phí thiết lập.
- Bạn dùng song song mô hình multi-node hoặc multi-GPU.
- Bạn có deadline cứng, trong đó thời gian thực thi ngắn hơn đáng giá hơn khoản chênh lệch theo giờ.
- Nhóm của bạn có thể giữ GPU sử dụng rất cao với dữ liệu đã chuẩn bị, checkpoint ổn định và cơ chế thử lại tự động.
A100 vẫn có thể là lựa chọn mua để huấn luyện tốt hơn khi:
- Mô hình vừa khít trong 80 GB và không hưởng lợi nhiều từ FP8.
- Bạn fine-tune thay vì pretrain.
- Bạn chạy nhiều thí nghiệm, trong đó độ dài hàng đợi quan trọng hơn tốc độ của một lần chạy nhanh nhất.
- Mã nguồn, driver, bộ công cụ CUDA và giám sát của bạn đã ổn định trên A100.
- Bạn đang mua công suất dành trước và mức chiết khấu của A100 rất sâu.
Thói quen mua sắm quan trọng là so sánh chi phí trên mỗi lần huấn luyện hoàn tất được chấp nhận, chứ không chỉ token mỗi giây. Một lần chạy H100 nhanh nhưng lỗi muộn vì checkpoint, dữ liệu hoặc tính ổn định của huấn luyện phân tán có thể đắt hơn một lần chạy A100 chậm hơn nhưng hoàn thành đáng tin cậy.
So sánh khi suy luận
Đối với suy luận, H100 thường thắng khi đường phục vụ được tối ưu cho các kernel LLM hiện đại:
- Các yêu cầu ngữ cảnh dài gây áp lực lên băng thông bộ nhớ và việc di chuyển KV-cache.
- Phục vụ đồng thời cao được hưởng lợi từ tối ưu hóa kernel mới hơn.
- SLO độ trễ đủ chặt để độ trễ p95 hoặc p99 thấp hơn mang lại giá trị kinh doanh.
- Mô hình dùng FP8 hoặc các đường quantization mà stack phục vụ của bạn đã xác thực.
- Bạn có thể batch đủ yêu cầu để giữ GPU bận rộn.
A100 thường thắng khi:
- Các job batch có thể chạy qua đêm.
- Lưu lượng yêu cầu tăng giảm thất thường và sẽ khiến các H100 đắt tiền bị nhàn rỗi.
- Mô hình đủ nhỏ để một tầng GPU rẻ hơn mới là lựa chọn thực sự tốt nhất.
- Bạn đang phục vụ các công cụ nội bộ ổn định thay vì lưu lượng quan trọng đến doanh thu.
- Bạn có thể chuyển phần tràn sang một API mô hình được quản lý thay vì giữ công suất riêng chuyên dụng bị nhàn rỗi.
Đối với phục vụ LLM, hiệu năng h100 vs a100 cũng phụ thuộc vào lớp phần mềm: vLLM, TensorRT-LLM, SGLang, NVIDIA NIM, định dạng quantization, chính sách batching, cài đặt KV-cache và phân phối độ dài prompt. Đừng mua H100 chỉ dựa trên một benchmark chung chung. Hãy phát lại chính tổ hợp prompt của bạn.
Một kế hoạch benchmark thực tế
Chạy cùng một benchmark trên mỗi SKU ứng viên. Giữ cố định các tiêu chí chấp nhận.
| Bước | Đo lường gì | Tại sao điều đó quan trọng |
|---|---|---|
| 1. Khóa workload | Mô hình, độ dài chuỗi, kích thước batch, độ chính xác, bộ dữ liệu, chính sách thử lại | Ngăn một so sánh giả kiểu táo với táo. |
| 2. Đo throughput | Token/giây khi huấn luyện, mẫu/giây, hoặc token/giây khi suy luận | Cho thấy tốc độ thô. |
| 3. Đo độ trễ | p50, p95, p99, thời gian đến token đầu tiên, tốc độ giải mã | Ghi nhận hiệu năng nhìn thấy được bởi người dùng. |
| 4. Theo dõi mức sử dụng | Mức sử dụng GPU, băng thông bộ nhớ, chờ CPU, chờ lưu trữ, chờ mạng | Cho thấy liệu lựa chọn GPU có phải là nút thắt thực sự hay không. |
| 5. Theo dõi lỗi | Job khởi động lại, OOM, lỗi kernel, gián đoạn spot | Chuyển các mức giá theo giờ rẻ thành chi phí thực tế đã hoàn thành. |
| 6. Tính chi phí đã chấp nhận | Chi phí trên mỗi lần chạy hoàn tất, mỗi output được chấp nhận, hoặc mỗi triệu token được phục vụ | Đây là con số mà bộ phận mua sắm nên so sánh. |
Tối thiểu cho replay suy luận:
100 prompt ngắn
100 prompt trung bình
100 prompt có ngữ cảnh dài
cùng một mô hình
cùng một độ chính xác
cùng một phiên bản máy chủ
cùng một số token tối đa
cùng một bậc đồng thời
cùng một bộ kiểm tra chất lượng
Chạy lại huấn luyện tối thiểu:
same checkpoint
same dataset shard
same global batch size target
same optimizer settings
same precision policy
same checkpoint interval
same failure recovery method
H100 phải nhanh hơn bao nhiêu?
Hãy dùng báo giá của bạn, rồi tính mức tăng tốc hòa vốn.
| Ví dụ báo giá | Giá H100 | Giá A100 | Phần premium giá của H100 | Diễn giải hòa vốn |
|---|---|---|---|---|
| Runpod Community H100 SXM vs A100 SXM | $2.69/hr | $1.39/hr | 1.94x | H100 phải hoàn thành nhanh hơn hơn 1.94x trước khi tính đến các chi phí ẩn mới thắng về tiền thuê GPU. |
| Runpod Secure H100 SXM vs A100 SXM | $3.49/hr | $1.59/hr | 2.19x | H100 cần một mức tăng tốc lớn hoặc một lý do mạnh về độ trễ/kinh doanh. |
| Lambda 8x H100 SXM vs 8x A100 SXM 80 GB | $3.99/GPU/hr | $2.79/GPU/hr | 1.43x | H100 có thể thắng với mức tăng tốc nhỏ hơn nhiều. |
| Lambda single H100 PCIe vs single A100 SXM 40 GB | $3.29/hr | $1.99/hr | 1.65x | So sánh này trộn lẫn SKU; phải cân nhắc khác biệt về bộ nhớ và liên kết nội bộ. |
Đây là chỗ nhiều so sánh a100 vs h100 performance bị sai. Một benchmark nói rằng "H100 nhanh hơn 2x" là chưa đủ. Bạn cần biết báo giá H100 của mình là 1.4x, 1.9x hay 2.2x so với báo giá A100, và liệu công việc có thực sự hoàn thành thành công ở tốc độ đó hay không.
Danh sách kiểm tra khi mua sắm
Trước khi chọn H100 hay A100, hãy hỏi nhà cung cấp về:
- SKU GPU chính xác: SXM, PCIe, NVL, kích thước bộ nhớ, và chính sách MIG.
- Cấu hình node: số lượng GPU, CPU, RAM, NVMe cục bộ, mạng, và interconnect.
- Hạ tầng mạng cho cluster: NVLink/NVSwitch trong node, InfiniBand hoặc Ethernet giữa các node, chính sách oversubscription.
- Giá và hiệu năng lưu trữ: SSD cục bộ, volume bền vững, lưu trữ đối tượng, snapshot, và thời gian khôi phục.
- Chính sách egress và băng thông.
- Đơn vị tính phí: theo giây, theo phút, hoặc theo giờ.
- Chính sách gián đoạn cho spot hoặc năng lực marketplace.
- Khu vực và ràng buộc tuân thủ.
- SLA hỗ trợ và quy trình thay thế.
- Điều khoản đặt trước và quy tắc hủy.
Với huấn luyện phân tán, cấu hình node có thể quyết định kết quả. Tám GPU H100 đứng sau NVSwitch mạnh và một hạ tầng mạng tốt không thể so sánh với tám GPU tách biệt được kết nối qua một đường mạng yếu.
Khi nào H100 đáng với phần premium
H100 thường đáng tiền khi có ít nhất hai điều sau đúng:
- Khối lượng công việc nặng về transformer và đã được xác thực với FP8 hoặc các kernel tối ưu cho Hopper.
- Thời gian huấn luyện đang chặn việc phát hành, bàn giao cho khách hàng, hoặc vòng lặp nghiên cứu.
- Độ trễ p95 hoặc p99 của suy luận ảnh hưởng đến doanh thu hoặc khả năng giữ chân người dùng.
- Công việc dùng giao tiếp đa GPU rất nhiều.
- Nhà cung cấp đưa ra mức premium H100 vừa phải so với A100.
- Đội ngũ của bạn có thể giữ mức sử dụng cao.
H100 khó biện minh hơn khi:
- GPU bị nhàn rỗi trong phần lớn thời gian của giờ tính phí.
- Nạp dữ liệu, tiền xử lý trên CPU, hoặc I/O mạng là nút thắt cổ chai.
- Stack phục vụ của bạn chưa được tinh chỉnh.
- Mô hình đủ nhỏ để chạy trên L40S, RTX PRO, hoặc một API được quản lý.
- Dung lượng A100 đang được giảm giá mạnh.
Khi nào A100 vẫn là lựa chọn thực dụng
A100 vẫn là mặc định thực tế cho nhiều đội AI vì nó đã trưởng thành, sẵn có rộng rãi, và vẫn rất mạnh cho huấn luyện và suy luận. Nó đặc biệt hữu ích khi bạn cần năng lực dự đoán được cho:
- Các job fine-tuning.
- Tạo embedding.
- Suy luận theo lô.
- Các công cụ AI nội bộ.
- Notebook nghiên cứu.
- Môi trường đa thuê dùng MIG.
- Các workload CUDA kế thừa đã được xác thực trên Ampere.
Nếu một lần chạy trên A100 tốn bằng một nửa và chỉ chậm hơn 20%, A100 thắng. Nếu nó rẻ hơn 30% nhưng mất thời gian gấp 2 lần, H100 có lẽ thắng. Phép tính còn thay đổi nữa nếu dung lượng A100 dễ đặt trước hơn hoặc nếu thời gian chờ H100 làm chậm dự án.
Flatkey phù hợp ở đâu
Thuê GPU không phải lúc nào cũng là cách rẻ nhất để chạy AI. Với một số workload, API mô hình được quản lý rẻ hơn vì bạn trả tiền cho mỗi yêu cầu thành công thay vì giữ một GPU. Với các workload khác, năng lực GPU chuyên dụng tốt hơn vì bạn có lưu lượng ổn định, mô hình tùy chỉnh, nhu cầu độ trễ nghiêm ngặt, hoặc yêu cầu kiểm soát dữ liệu.
Flatkey giúp các đội so sánh những hướng đi đó từ phía ứng dụng: một API key, một số dư, một sổ cái sử dụng, và định tuyến mô hình qua các endpoint mô hình chính thức. Hãy dùng thuê GPU khi workload cần năng lực chuyên dụng. Hãy dùng đường API mô hình khi workload mang tính đột biến, đơn giản hơn về vận hành, hoặc rẻ hơn cho mỗi tác vụ được chấp nhận.
FAQ về H100 vs A100
H100 có nhanh hơn A100 không?
Có. H100 là GPU thế hệ Hopper mới hơn và có lợi thế lớn trong các workload hướng đến transformer, băng thông bộ nhớ, hỗ trợ FP8, và interconnect mới hơn. Câu hỏi thực sự là nó có đủ nhanh để bù cho phần premium giá H100 trong workload của bạn hay không.
A100 còn tốt cho suy luận LLM không?
Có. A100 vẫn là một GPU suy luận rất mạnh, đặc biệt cho phục vụ theo lô, công cụ nội bộ, embeddings, và các workload có yêu cầu độ trễ ở mức vừa phải. H100 mạnh hơn cho phục vụ transformer thông lượng cao và nhạy với độ trễ khi stack phần mềm đã được tinh chỉnh.
Tôi có nên so sánh H100 SXM với A100 PCIe không?
Chỉ khi đó là những mức báo giá thực tế mà bạn có thể mua. Với so sánh kỹ thuật, hãy giữ form factor và bộ nhớ càng giống nhau càng tốt: H100 SXM vs A100 SXM, H100 PCIe vs A100 PCIe, 80 GB vs 80 GB nếu có sẵn.
FP8 có làm H100 tự động tốt hơn không?
Không. FP8 chỉ hữu ích khi mô hình và stack phần mềm có thể sử dụng nó mà không làm giảm chất lượng đến mức không chấp nhận được. Hãy xác thực chất lượng đầu ra, khả năng hội tụ và độ ổn định trước khi cho rằng FP8 sẽ giúp tiết kiệm chi phí.
Cái nào tốt hơn cho fine-tuning?
Đối với các tác vụ fine-tuning nhỏ và vừa, A100 có thể hiệu quả hơn về chi phí. Với các tác vụ lớn hơn, thời hạn gấp, hoặc các stack huấn luyện hưởng lợi từ băng thông và các đường FP8 của H100, H100 có thể chiếm ưu thế.
Chỉ số tốt nhất cho H100 vs A100 là gì?
Hãy dùng chi phí trên mỗi kết quả được chấp nhận: một lần chạy huấn luyện hoàn tất, một checkpoint mô hình được chấp nhận, một triệu token được phục vụ, một batch thành công, hoặc một phản hồi đạt ngưỡng độ trễ. Chỉ giá theo giờ là chưa đầy đủ.
Kết luận
Với h100 vs a100, H100 là lựa chọn về hiệu năng và A100 thường là lựa chọn về giá trị. H100 thắng khi các tính năng Hopper đủ giảm thời gian thực thi để bù cho mức phụ phí theo giờ. A100 thắng khi workload ổn định, mức sử dụng không hoàn hảo, chênh lệch giá lớn, hoặc độ trễ không phải là ràng buộc.
Trước khi đặt trước bất kỳ GPU nào, hãy benchmark mô hình của chính bạn, phát lại traffic của chính bạn và tính chi phí cho công việc đã hoàn thành. Đó là phép so sánh H100 vs A100 duy nhất đủ sức vượt qua khâu xem xét mua sắm.


