
flatkey.ai 博客
面向 AI API 产品团队的洞察、产品更新和实施指南。
什么是 AI 工厂?GPU 集群、数据、模型与运营
了解什么是 AI 工厂,以及 GPU 集群、数据管道、模型、推理、治理和运营如何协同工作,并在何时模型 API 可以替代直接持有 GPU。
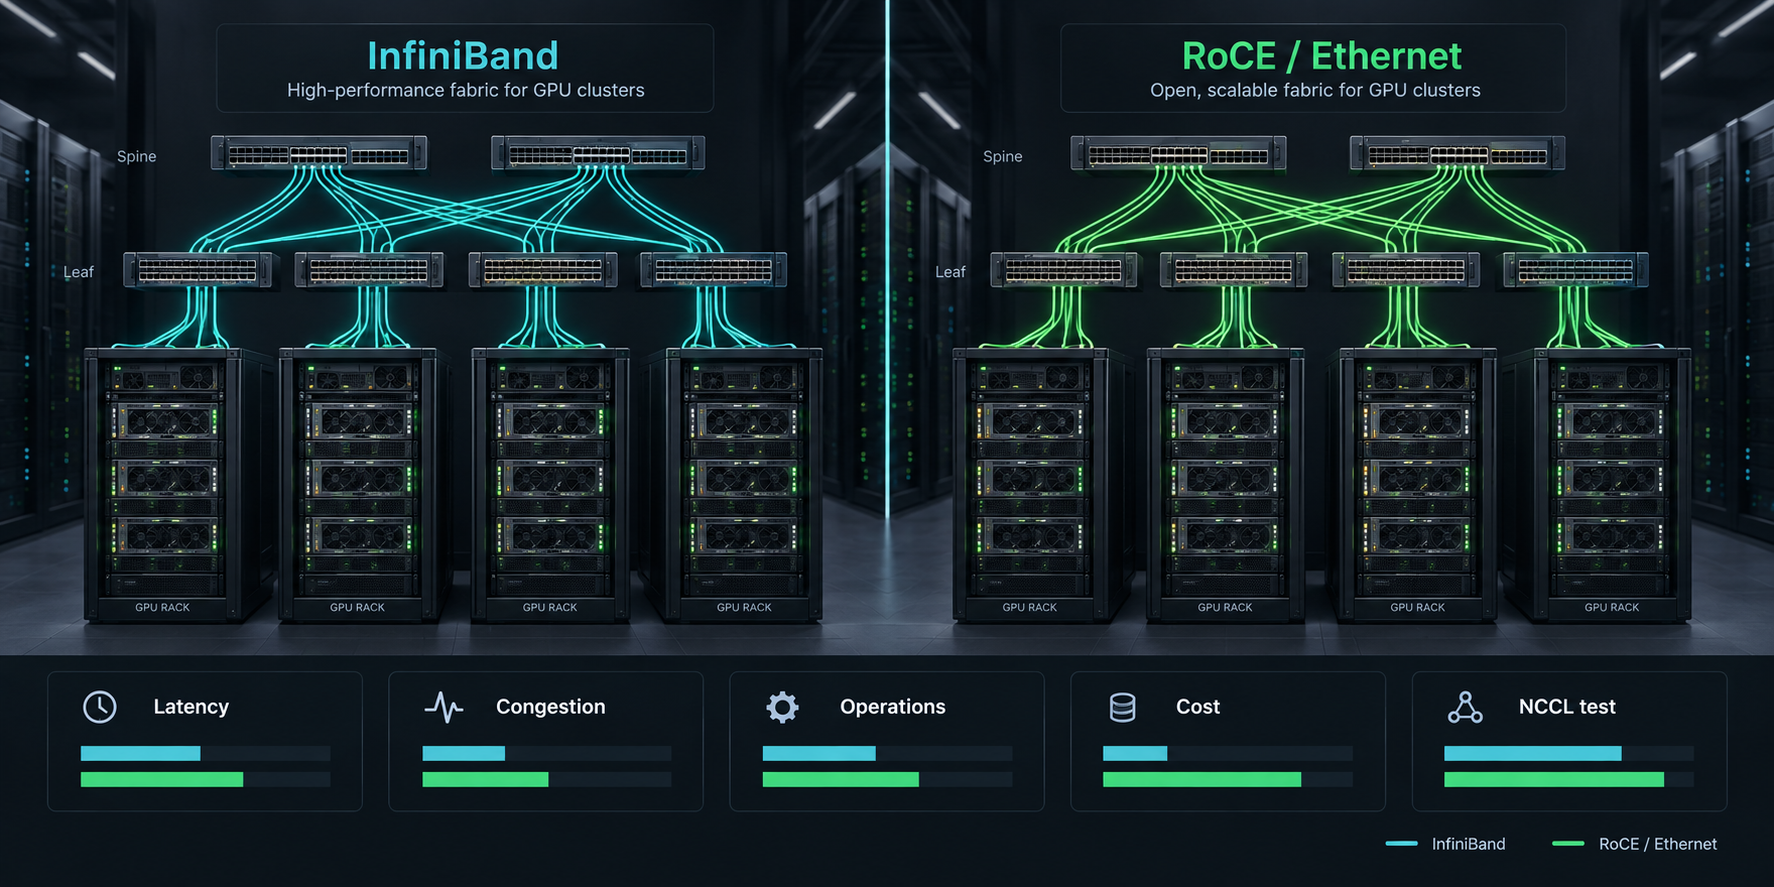
GPU 集群中的 RoCE 与 InfiniBand:延迟、运维与成本
通过实用的决策矩阵、NCCL 验收测试、成本模型和采购清单,对比用于多节点 GPU 集群的 RoCE 与 InfiniBand。
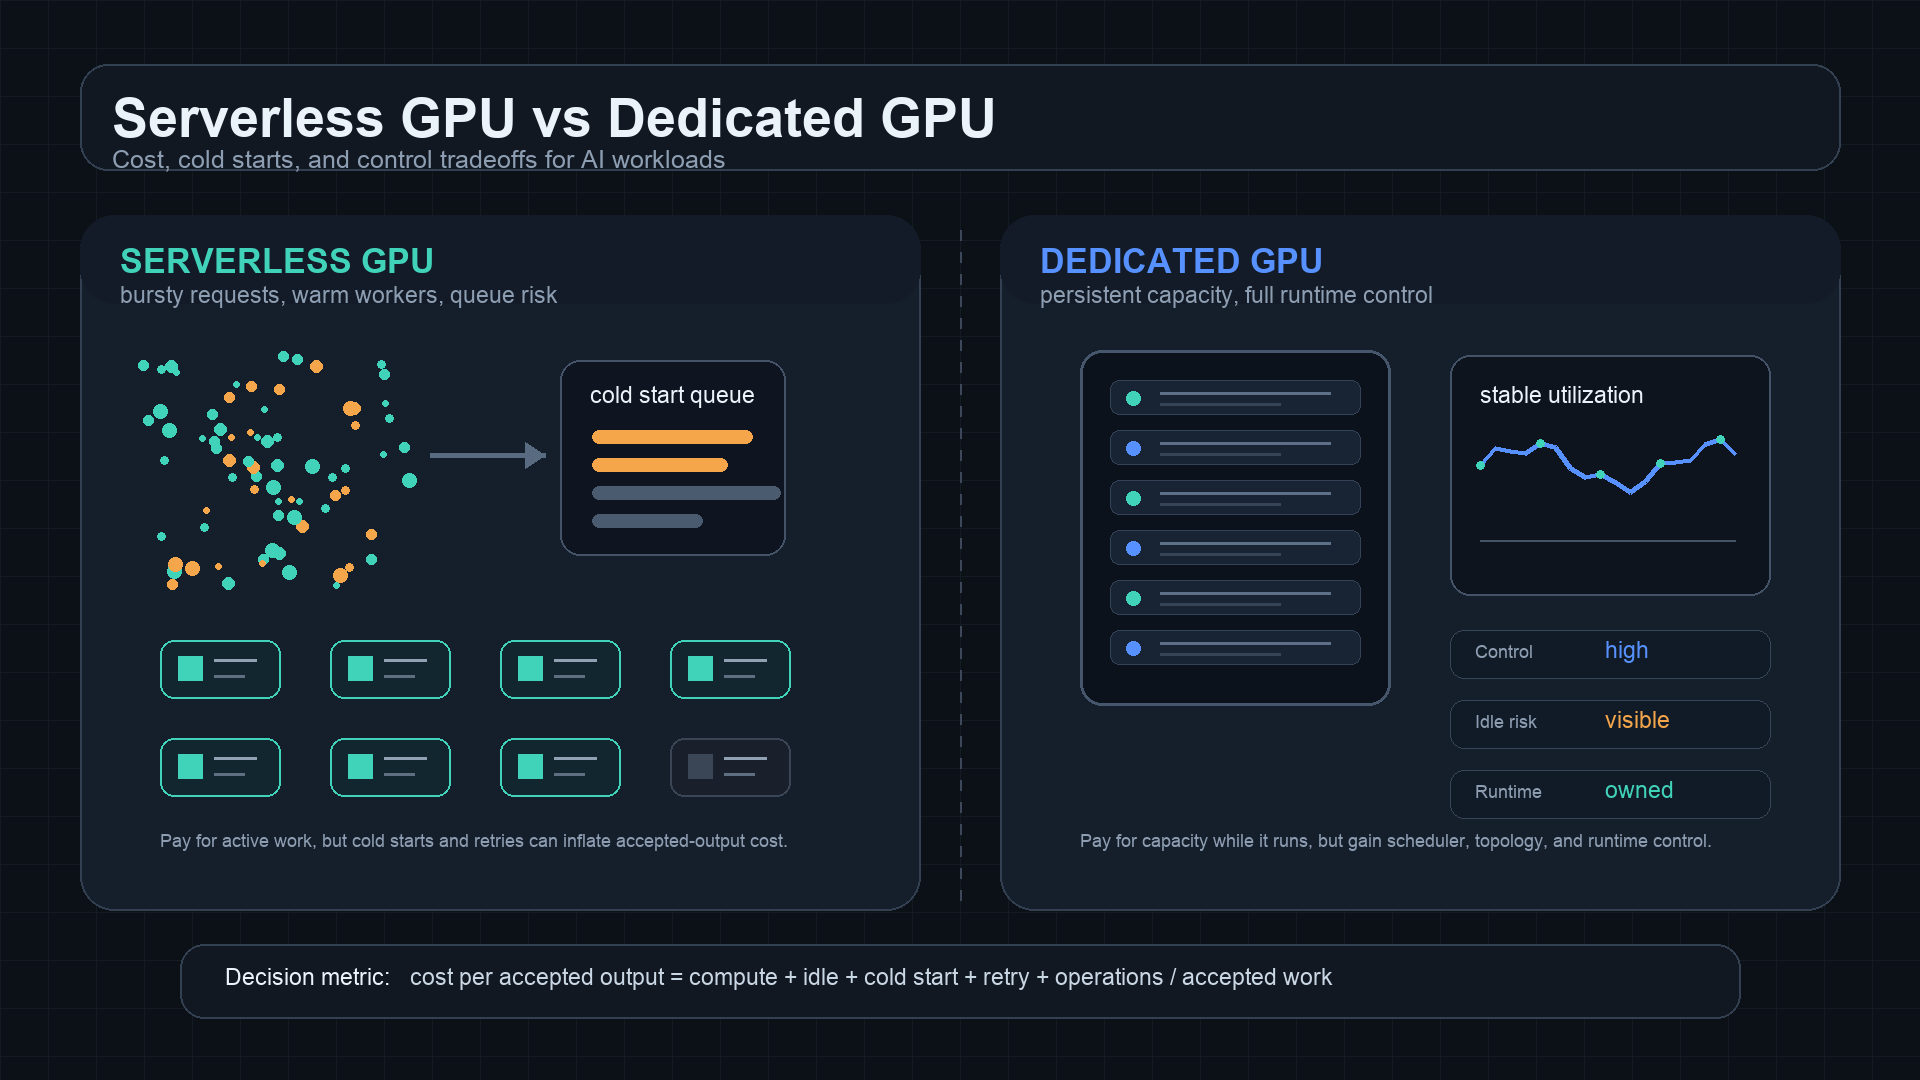
无服务器 GPU vs 专用 GPU:成本、冷启动与控制
从每个可接受输出的成本、冷启动、空闲容量、自动扩缩容和运维控制等方面比较无服务器 GPU 与专用 GPU。

AI 图像生成 API 定价对比:GPT Image、Gemini、Imagen 和 fal
通过将计费单位统一换算为每张被接受图像的成本,对比 GPT Image、Gemini Image、Imagen 和 fal 路径的图像生成 API 定价。
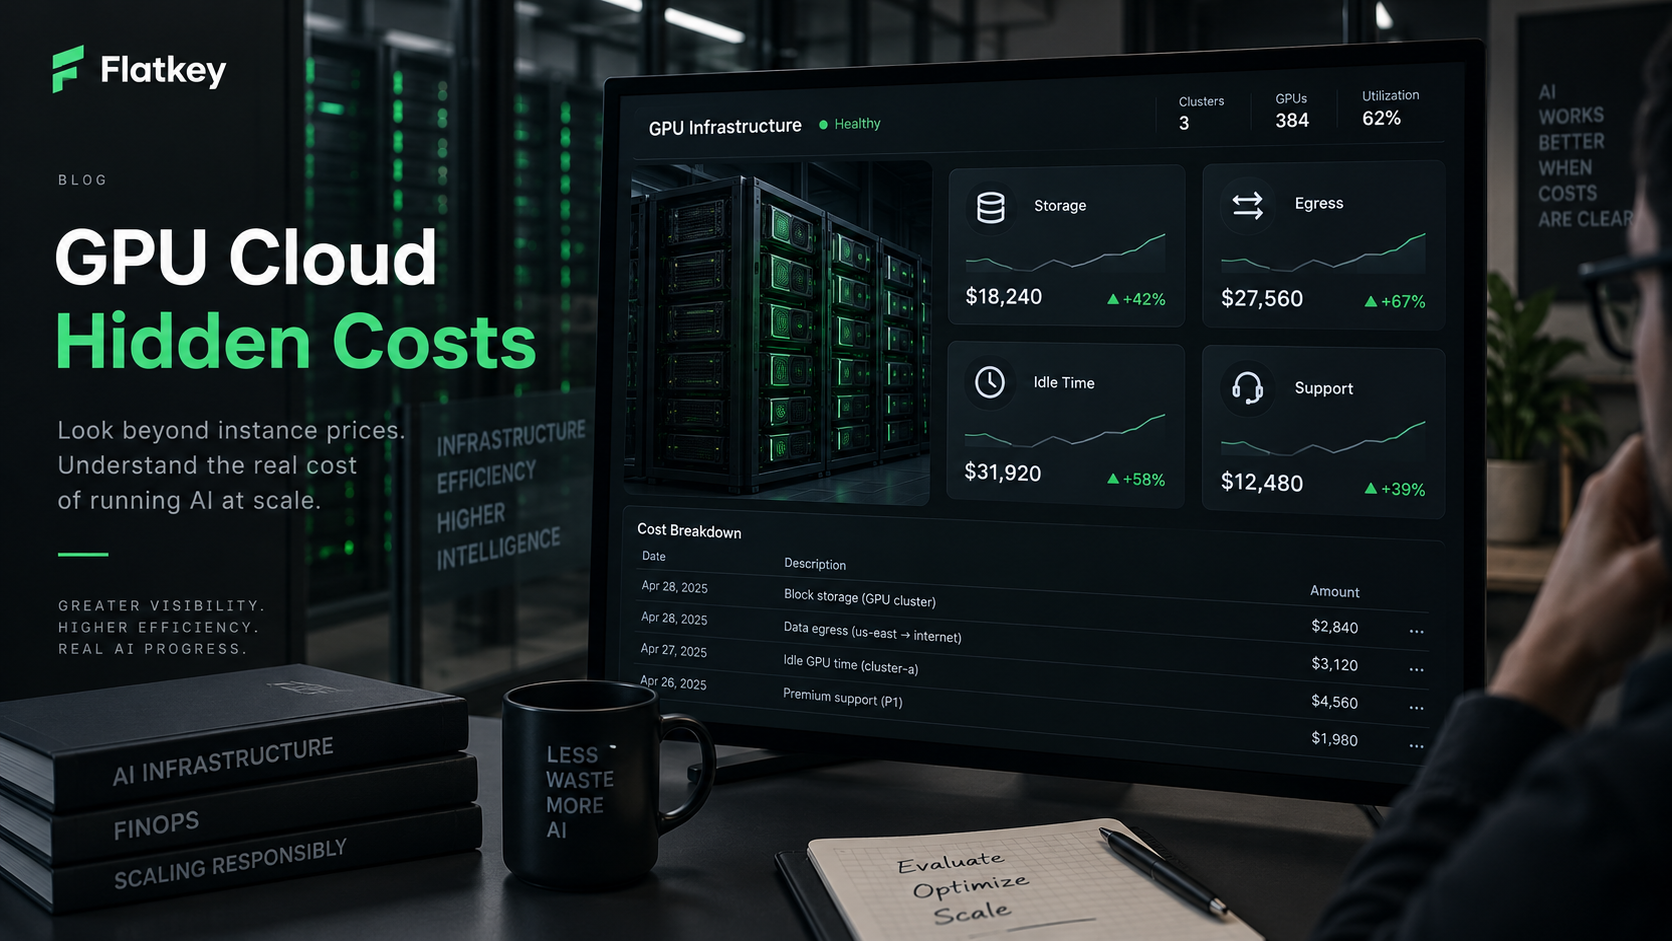
云 GPU 服务有哪些隐性成本?存储、出站流量、空闲时间和支持
一份实用的云 GPU 总拥有成本(TCO)指南,帮助你在账单到来前识别存储、出站流量、空闲时间、任务失败、支持、网络和运维成本。
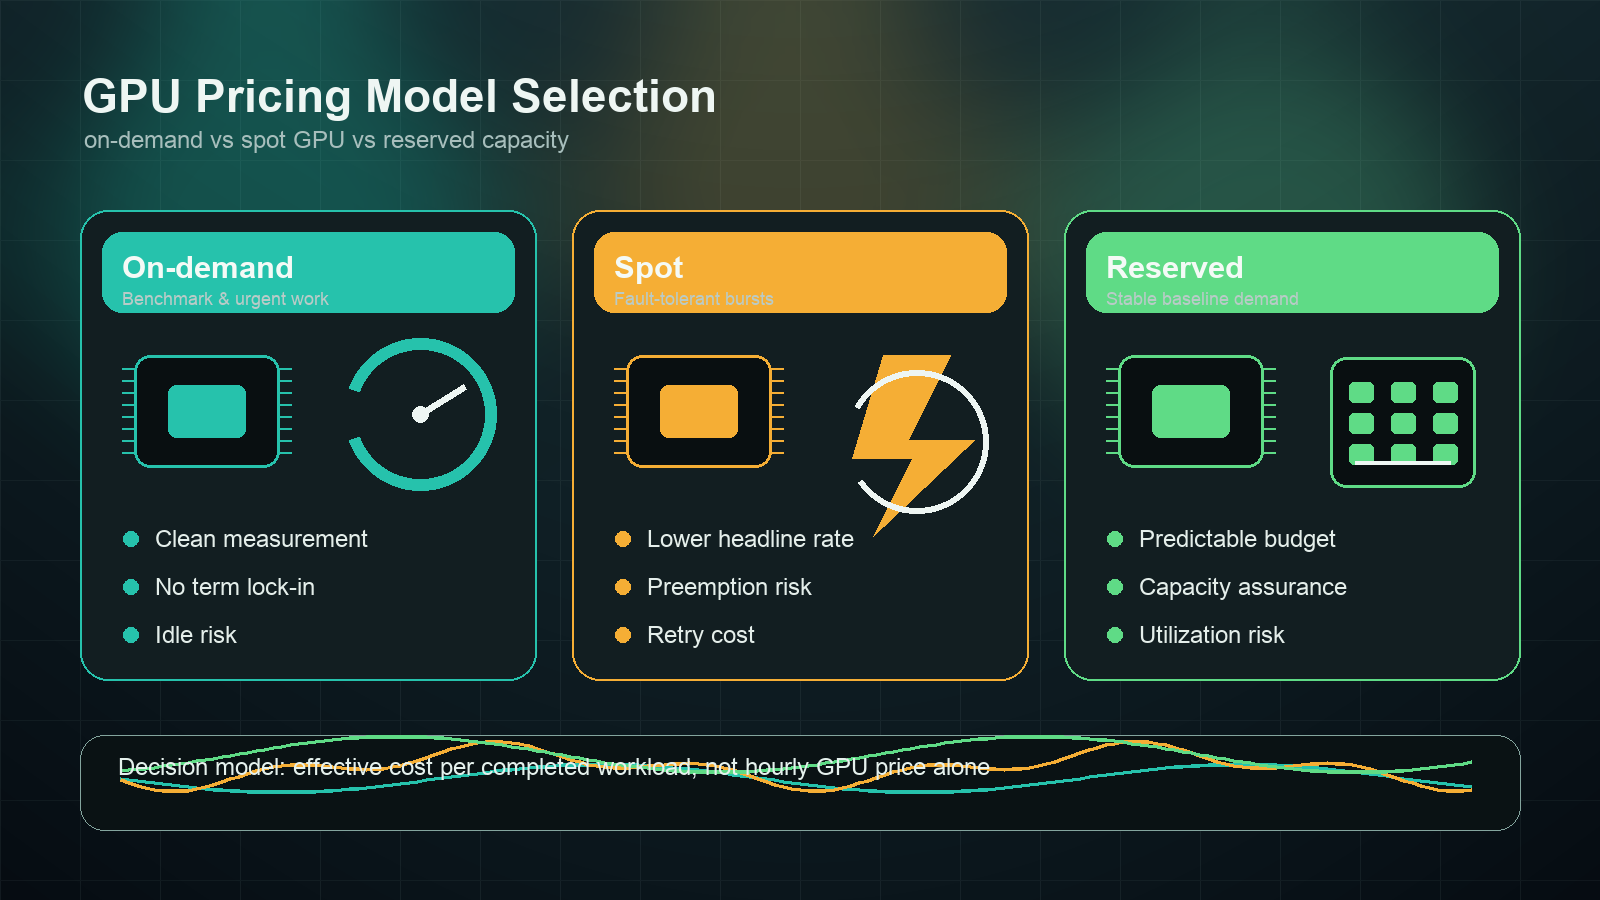
按需、竞价与预留 GPU 定价:哪种模式适合你的工作负载?
一个以工作负载为导向的框架,帮助你在按需、竞价或预留 GPU 容量之间做出选择,而不会把标注的小时费率与完成工作负载的实际成本混淆。
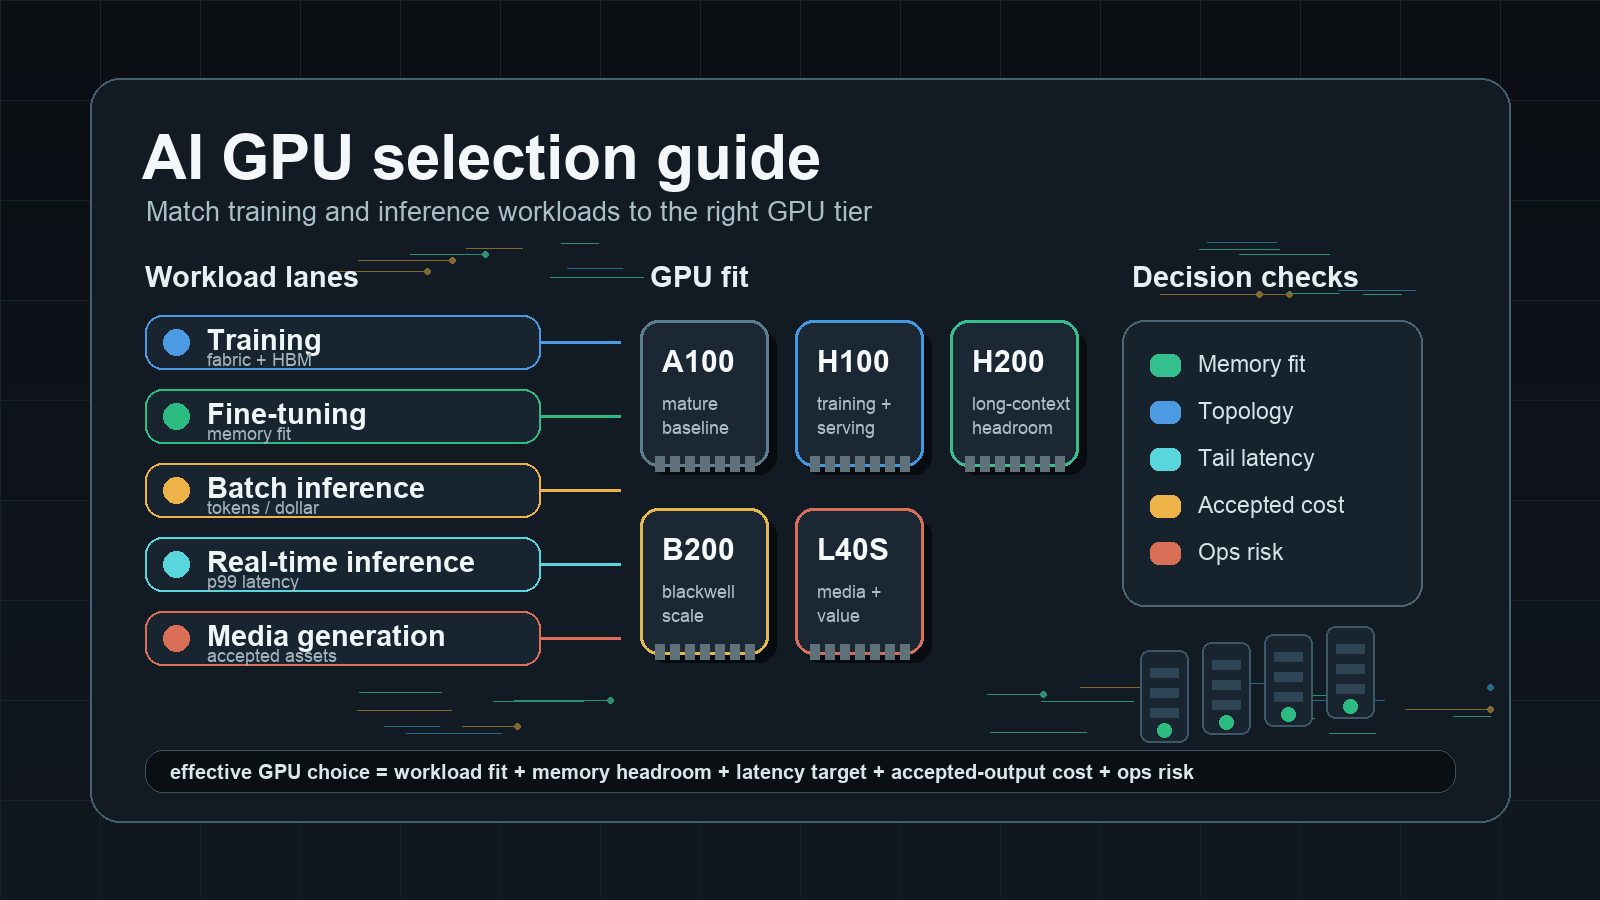
AI GPU 选型指南:为训练和推理工作负载匹配合适的 GPU
一份实用的 AI GPU 选型指南,帮助团队将训练、微调、LLM 推理、媒体生成和评估等工作负载匹配到合适的 GPU 与容量模型。
私有 GPU 云:架构、隔离与运维模式
了解如何评估私有 GPU 云架构、隔离性、调度器所有权、安全证据、运维模式、TCO 以及验收测试。

vLLM 部署指南:在 GPU 上提供兼容 OpenAI 的 LLM API
使用 Docker、RunPod Serverless、Ray Serve、指标、发布控制以及每次可接受输出成本检查,将 vLLM 部署为兼容 OpenAI 的 API,运行在 GPU 上。
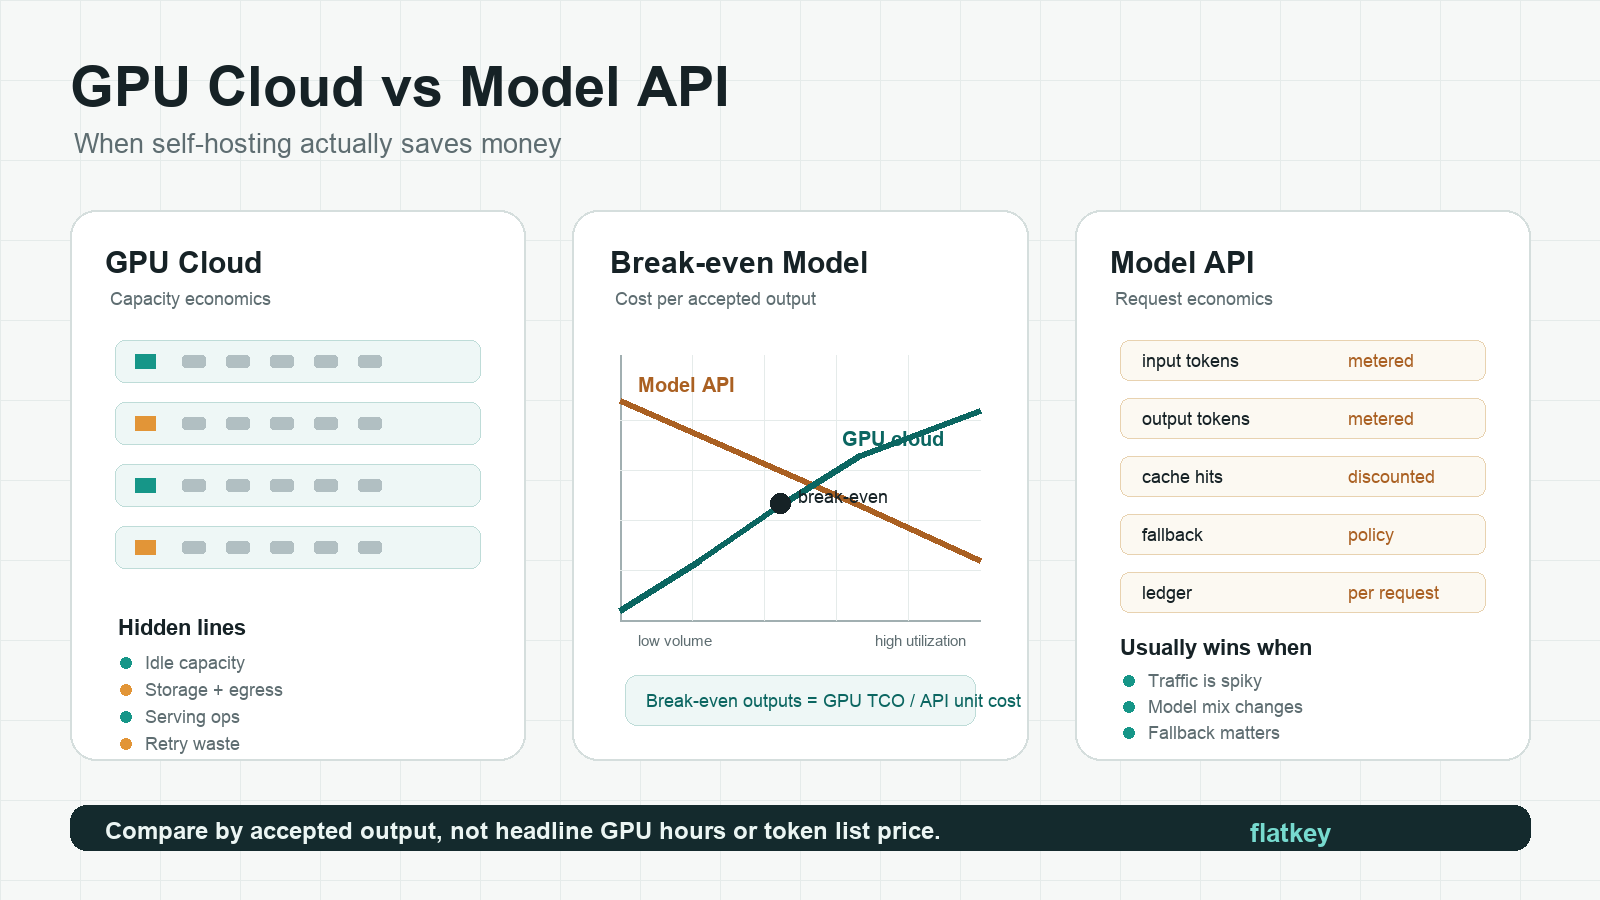
GPU 云 vs 模型 API:何时自托管真正更省钱
通过一份保本工作表,对比 GPU 云与模型 API 的经济性,涵盖可接受输出成本、利用率、重试、闲置容量和服务运维。
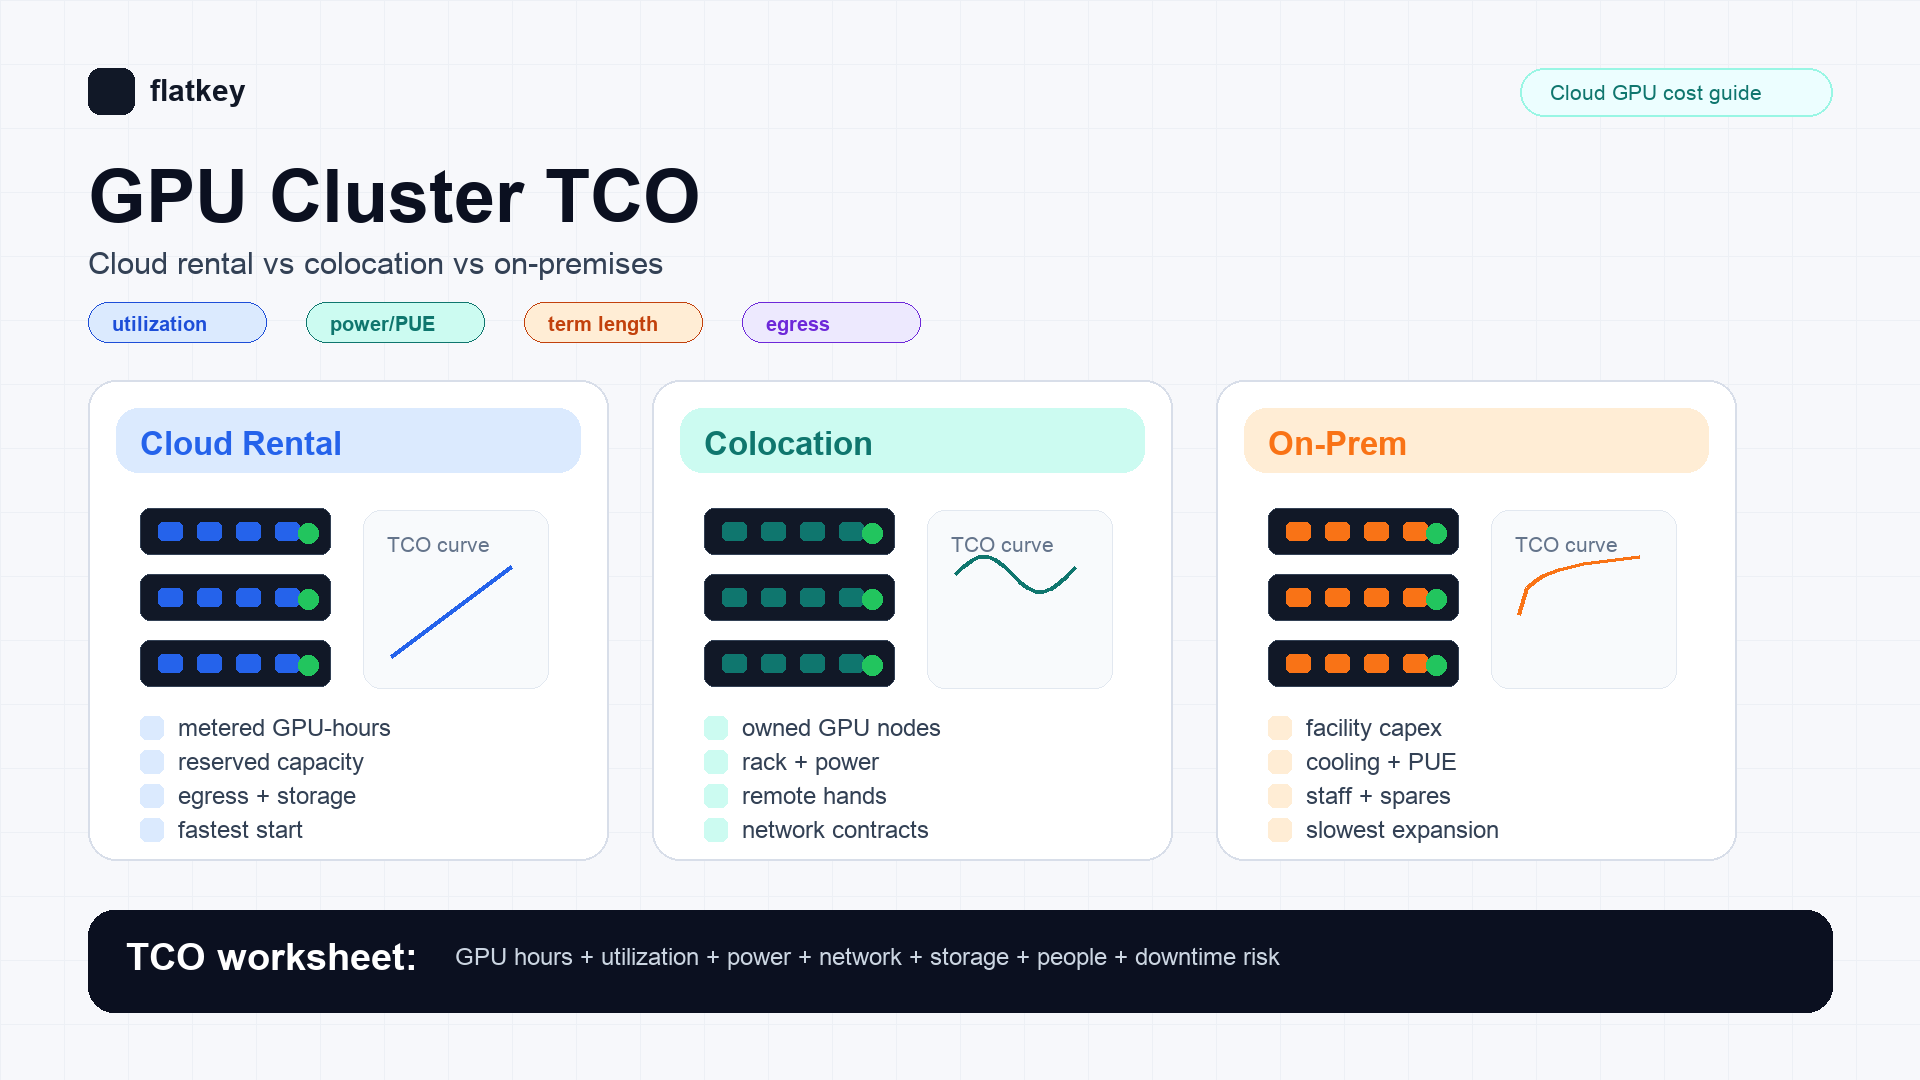
GPU 集群 TCO:云租用、托管机房与本地部署
通过一份实用的 FinOps 工作表,对云租用、托管机房和本地部署三种方案的 GPU 集群 TCO 进行比较,适用于 AI 基础设施采购者。
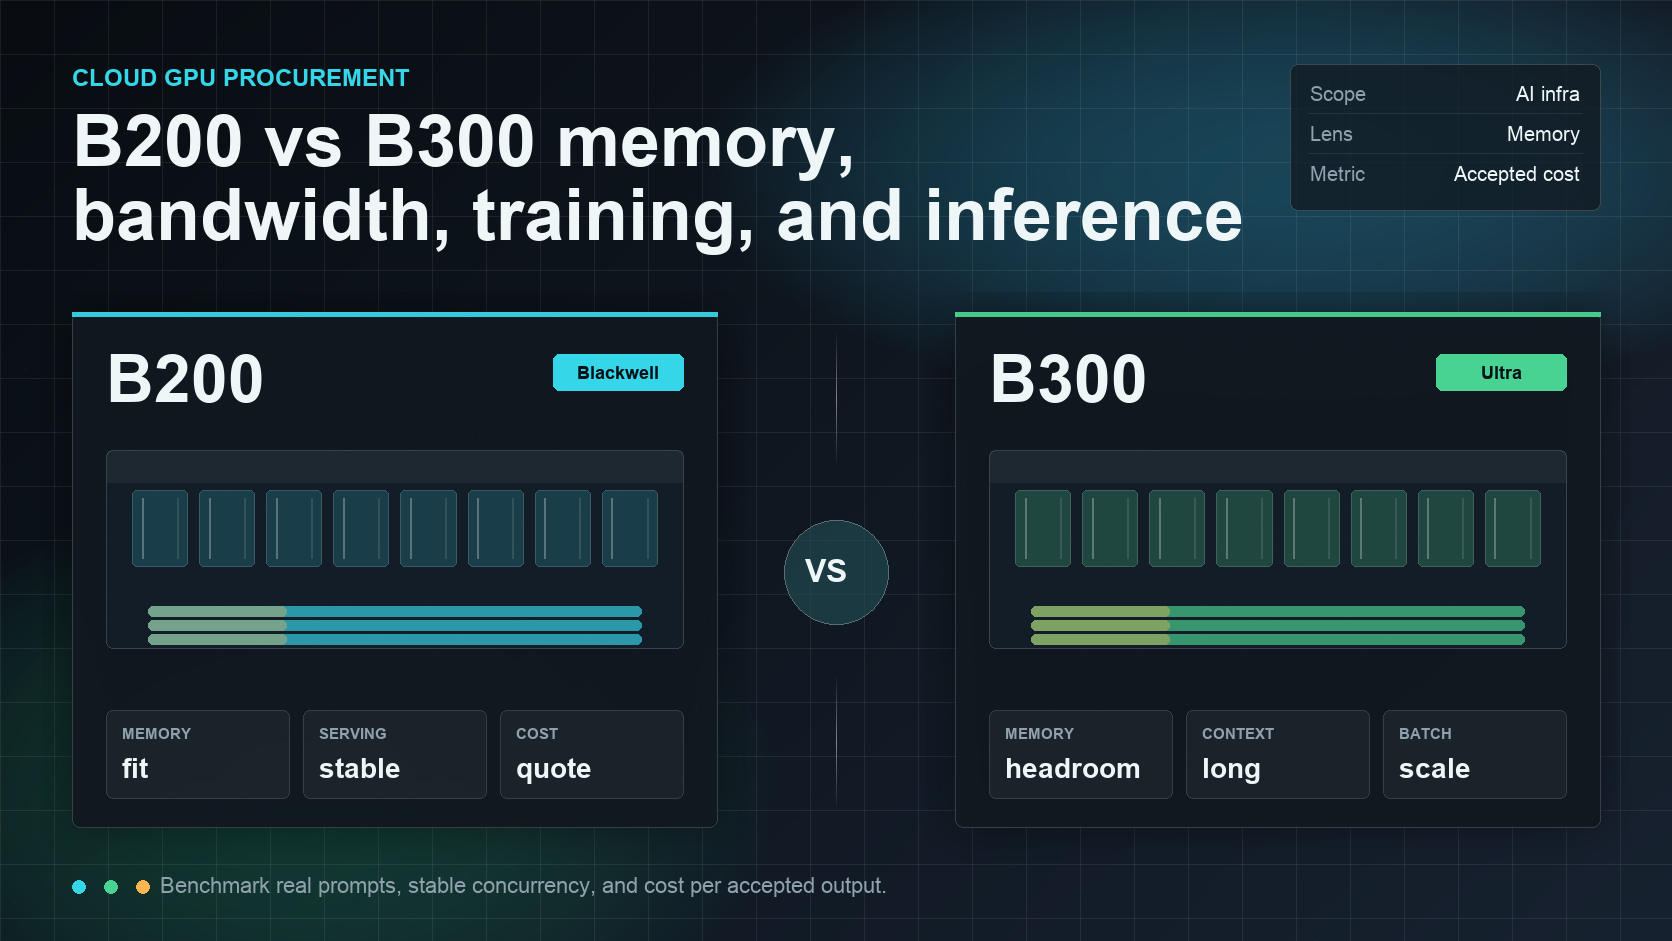
NVIDIA B300 vs B200:内存、带宽、训练与推理
面向 ML 基础设施团队的 B200 与 B300 实用对比,评估 NVIDIA Blackwell GPU 的内存、带宽、训练、推理和采购经济性。
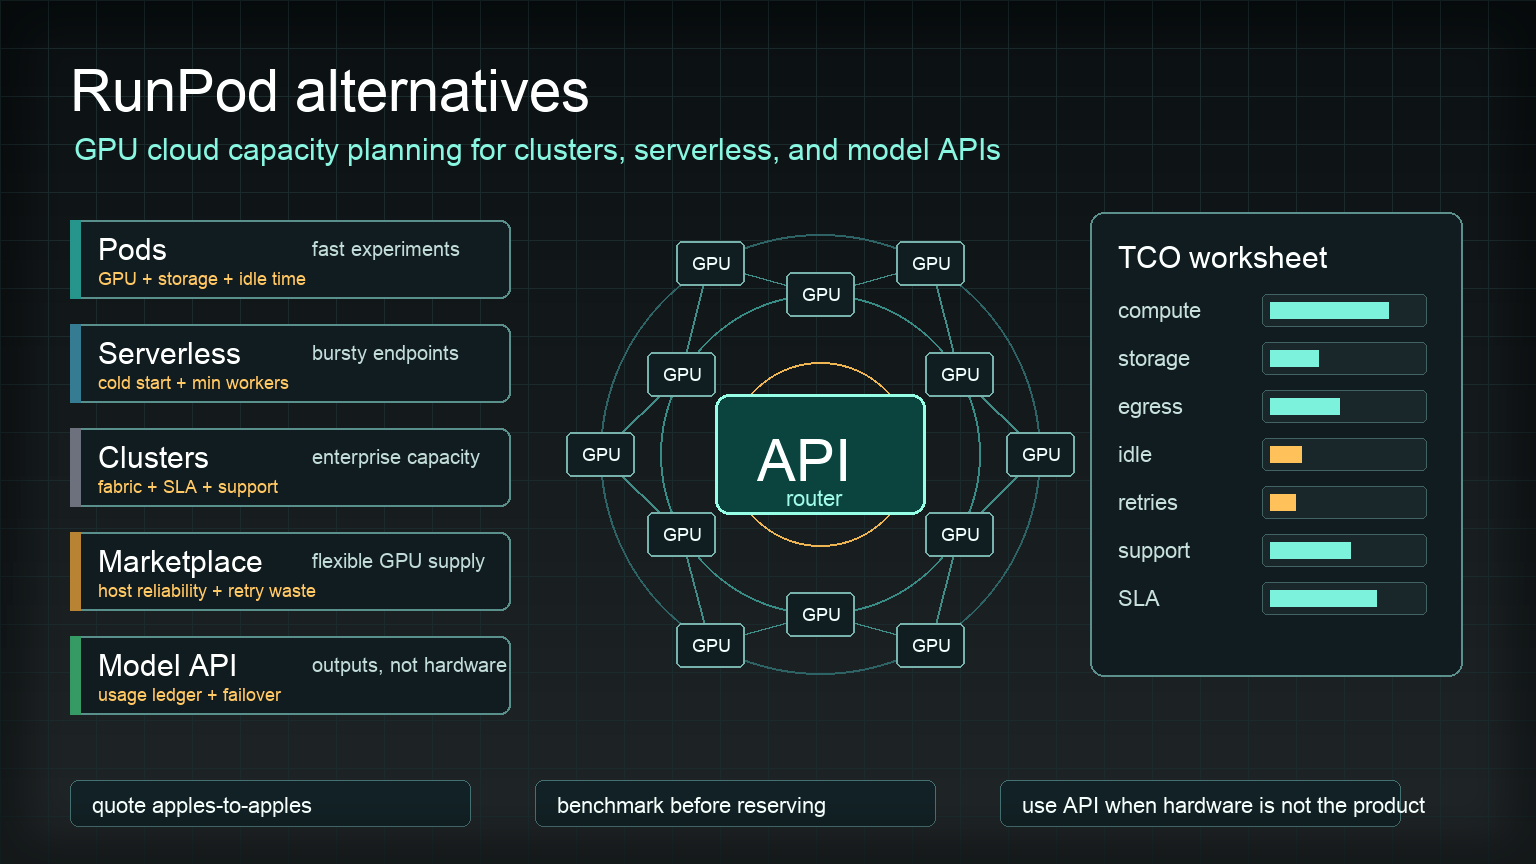
2026 年 10 大 RunPod 替代方案:价格、优势与选型建议
根据 2026 年 10 月 GPU 价格,对比 10 个 RunPod 替代方案:低价算力市场、稳定的 GPU 云、无服务器平台和模型 API,并提供 Vast.ai 与 RunPod 对比、可靠性分析及迁移清单。
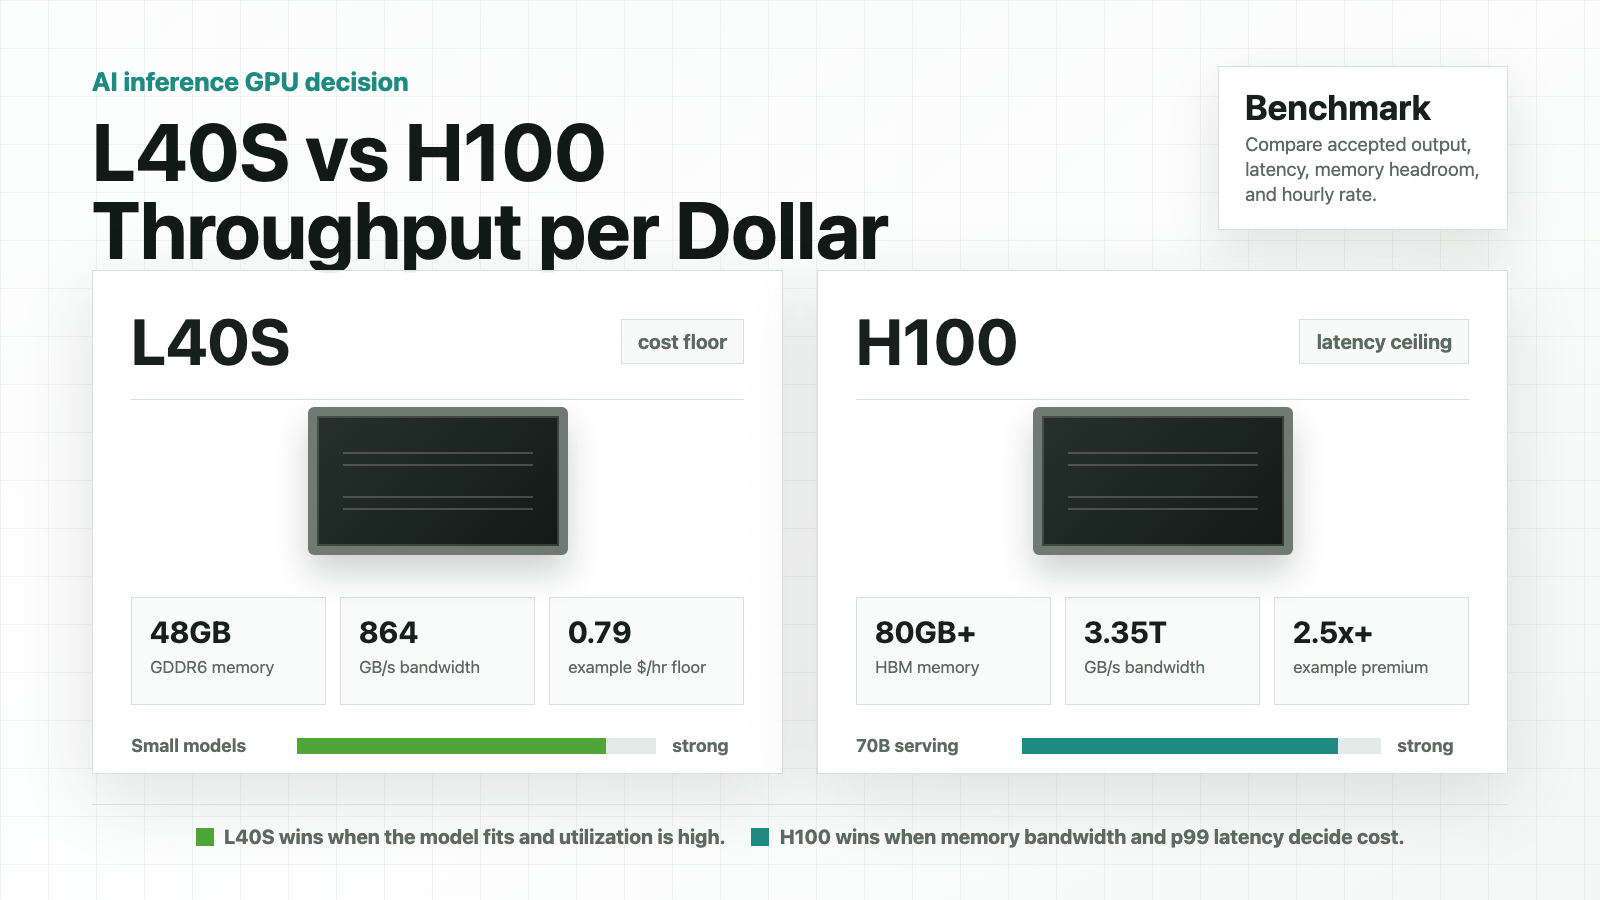
NVIDIA L40S 与 H100 的 AI 推理对比:每美元吞吐量
面向评估推理吞吐量、延迟、显存适配性以及按可接受输出计算的云 GPU 成本的 AI 团队,提供一份实用的 L40S 与 H100 对比。
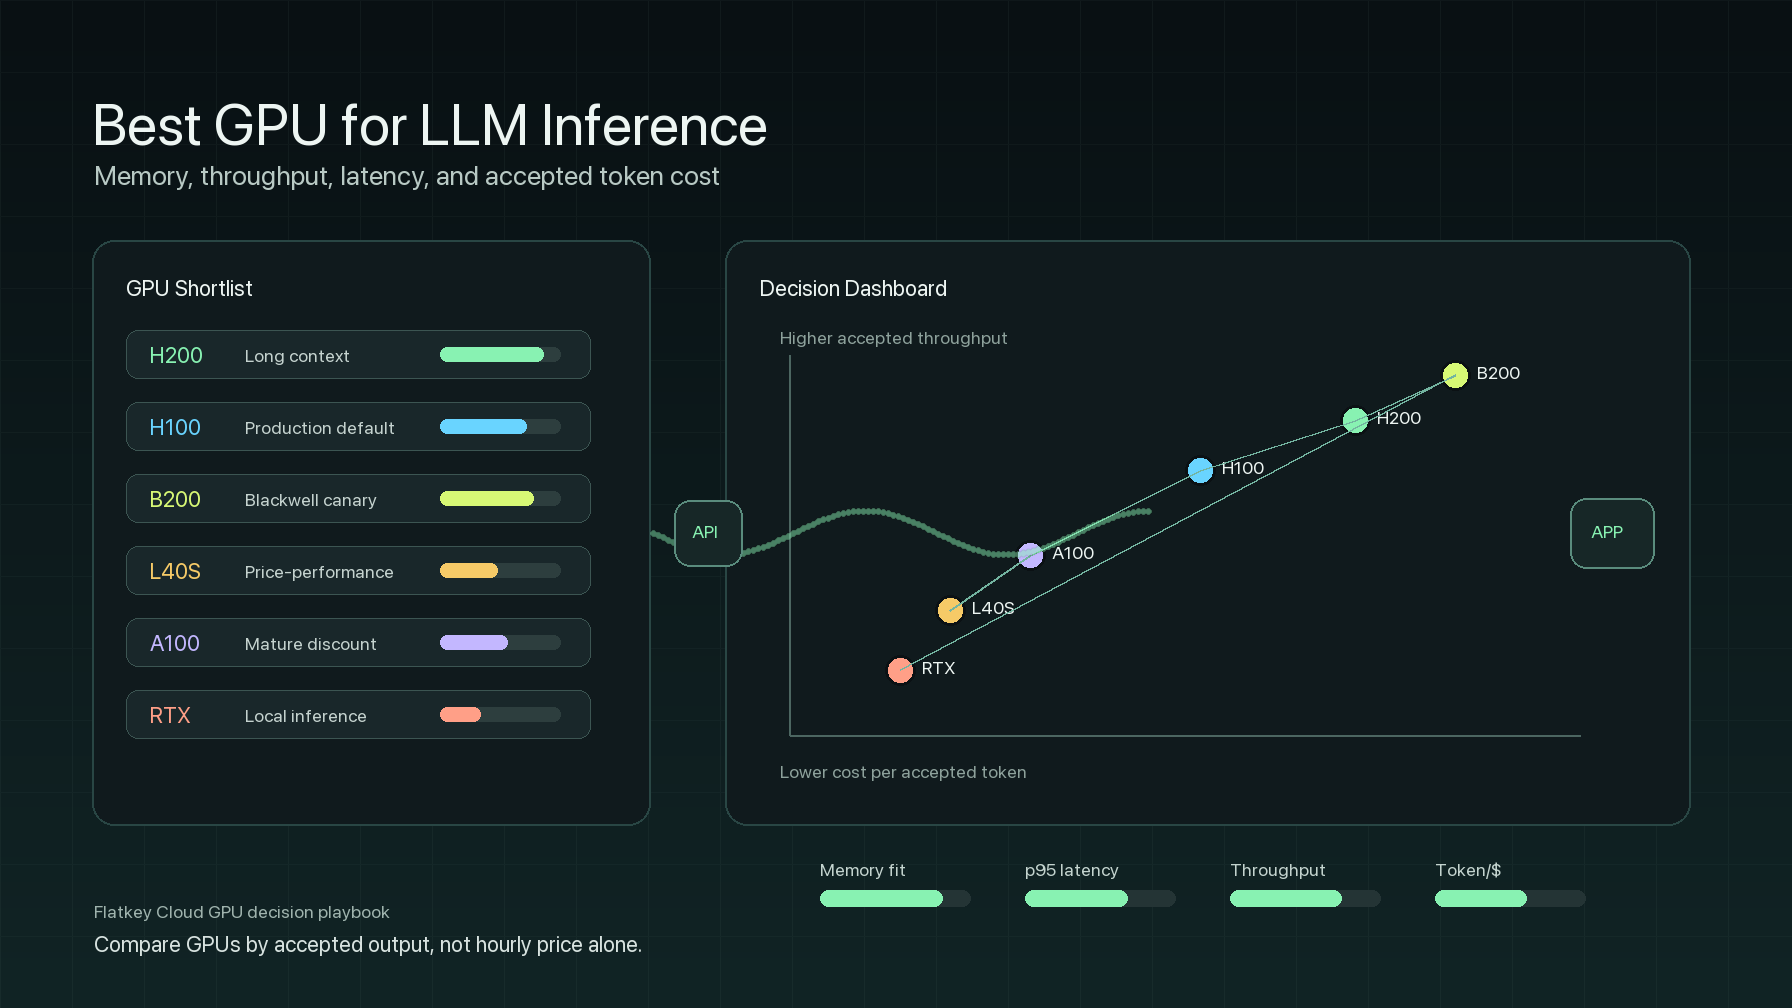
用于 LLM 推理的最佳 GPU:内存、吞吐量、延迟与成本
面向企业 LLM 推理团队的实用 GPU 选型指南,对比 H100、H200、B200、A100、L40S、本地 RTX 级 GPU、每美元 token 数、p95 延迟、内存适配性以及每个被接受 token 的成本。
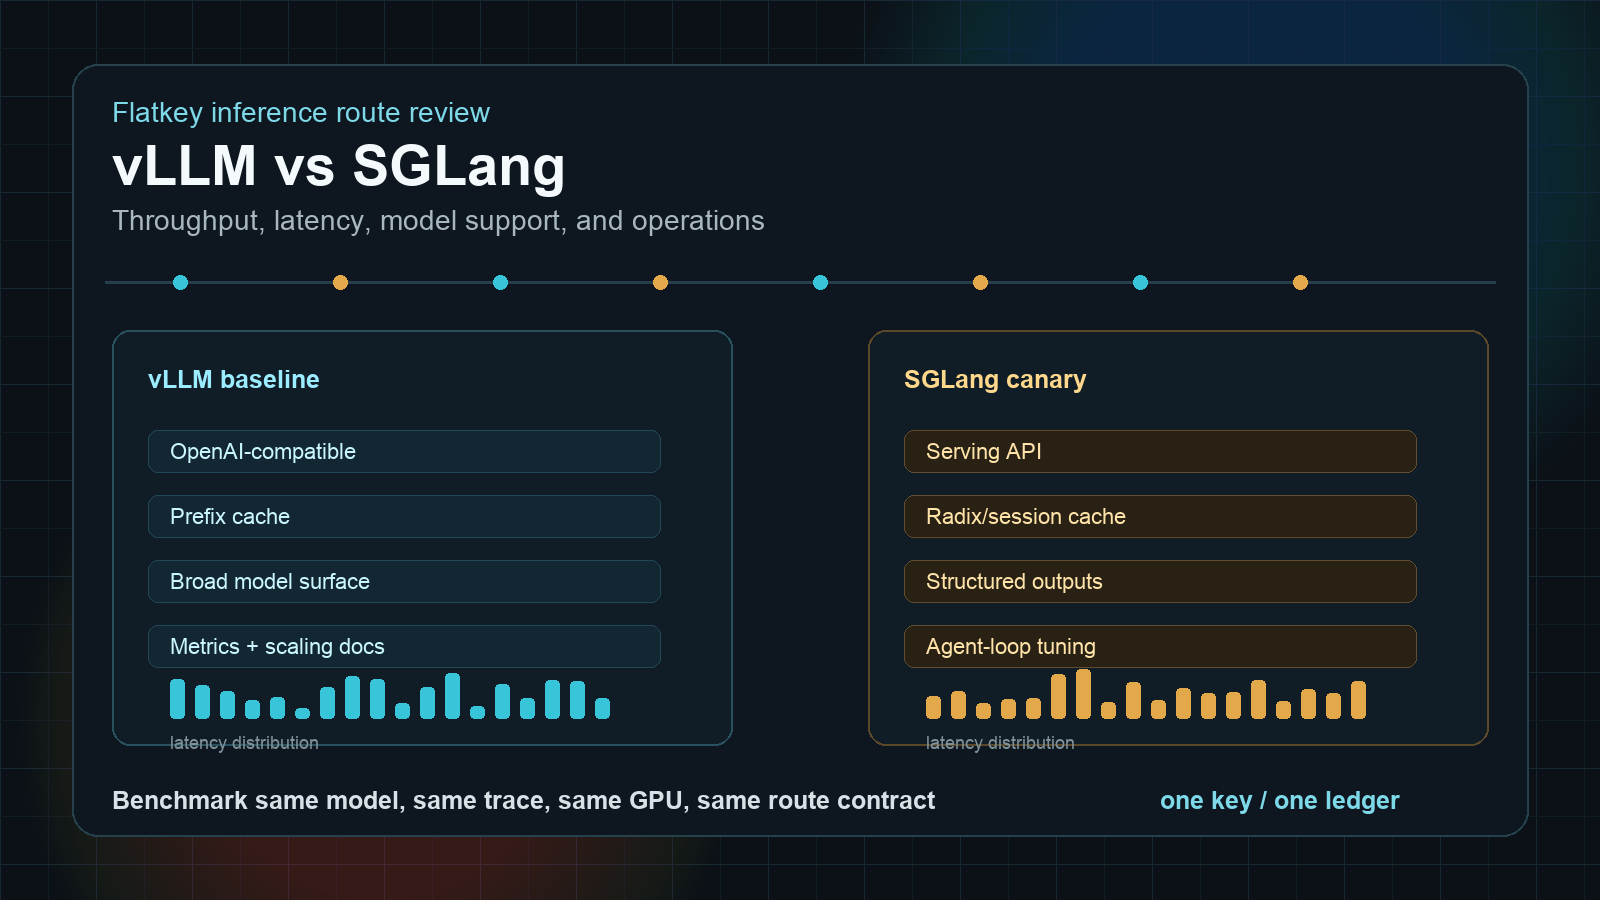
vLLM vs SGLang:吞吐量、延迟、模型支持与运维
比较 SGLang 与 vLLM 在云端 GPU 推理中的表现:吞吐量、延迟、模型支持、运维、基准测试,以及 Ollama 适合本地测试的场景。
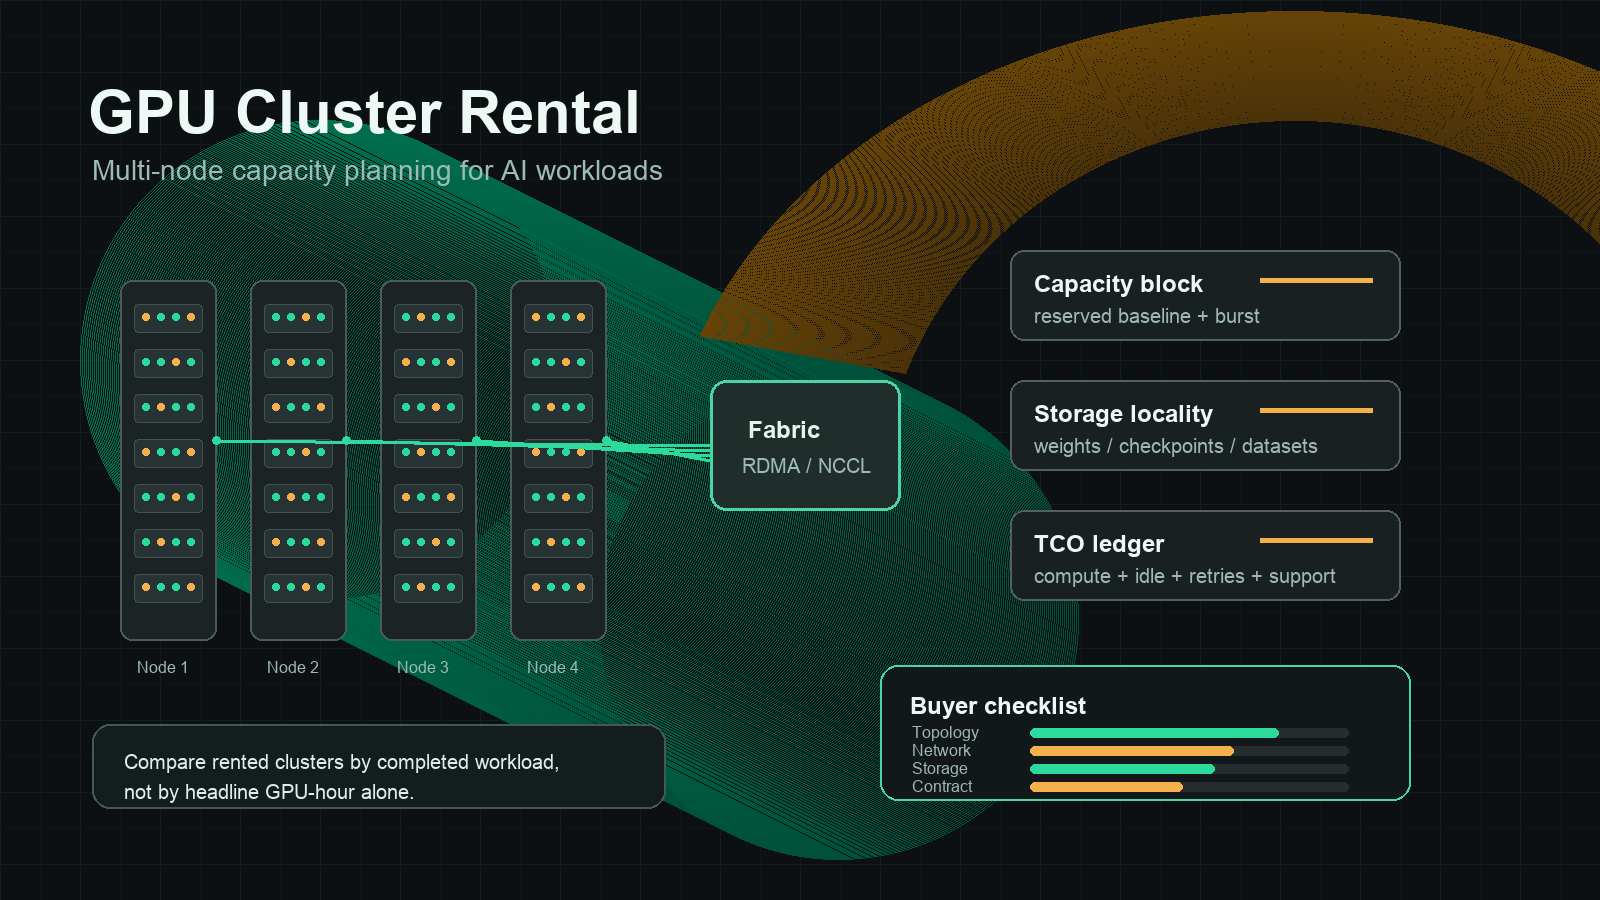
GPU 集群租赁:多节点 AI 算力采购指南
面向企业 AI 团队的采购指南,帮助评估多节点 GPU 集群租赁、云服务提供商、预留算力、网络架构、存储和总体拥有成本(TCO)。
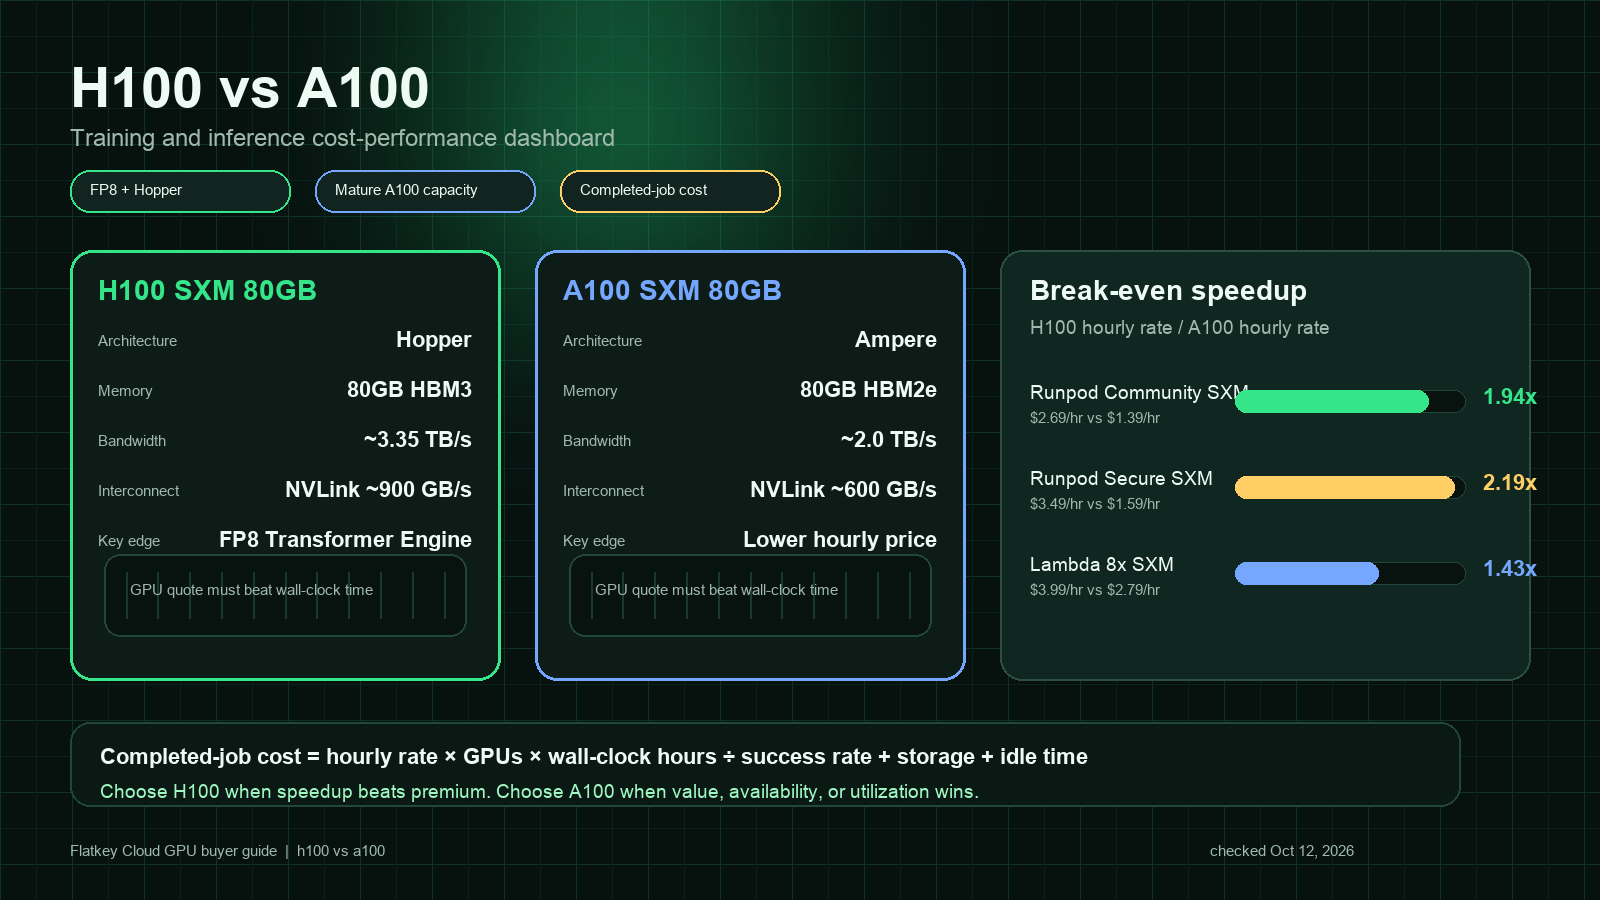
NVIDIA H100 vs A100:训练与推理的性价比
面向 AI 团队的实用 H100 vs A100 对比,帮助在训练、推理和云端 GPU 租用场景中权衡 Hopper 的性能与 Ampere 的价值。
用一个 AI 网关更快上线。
使用 flatkey.ai 在一个 API 平台中管理模型、密钥、计费和可观测性。
开始使用