
flatkey.ai 博客
面向 AI API 产品团队的洞察、产品更新和实施指南。
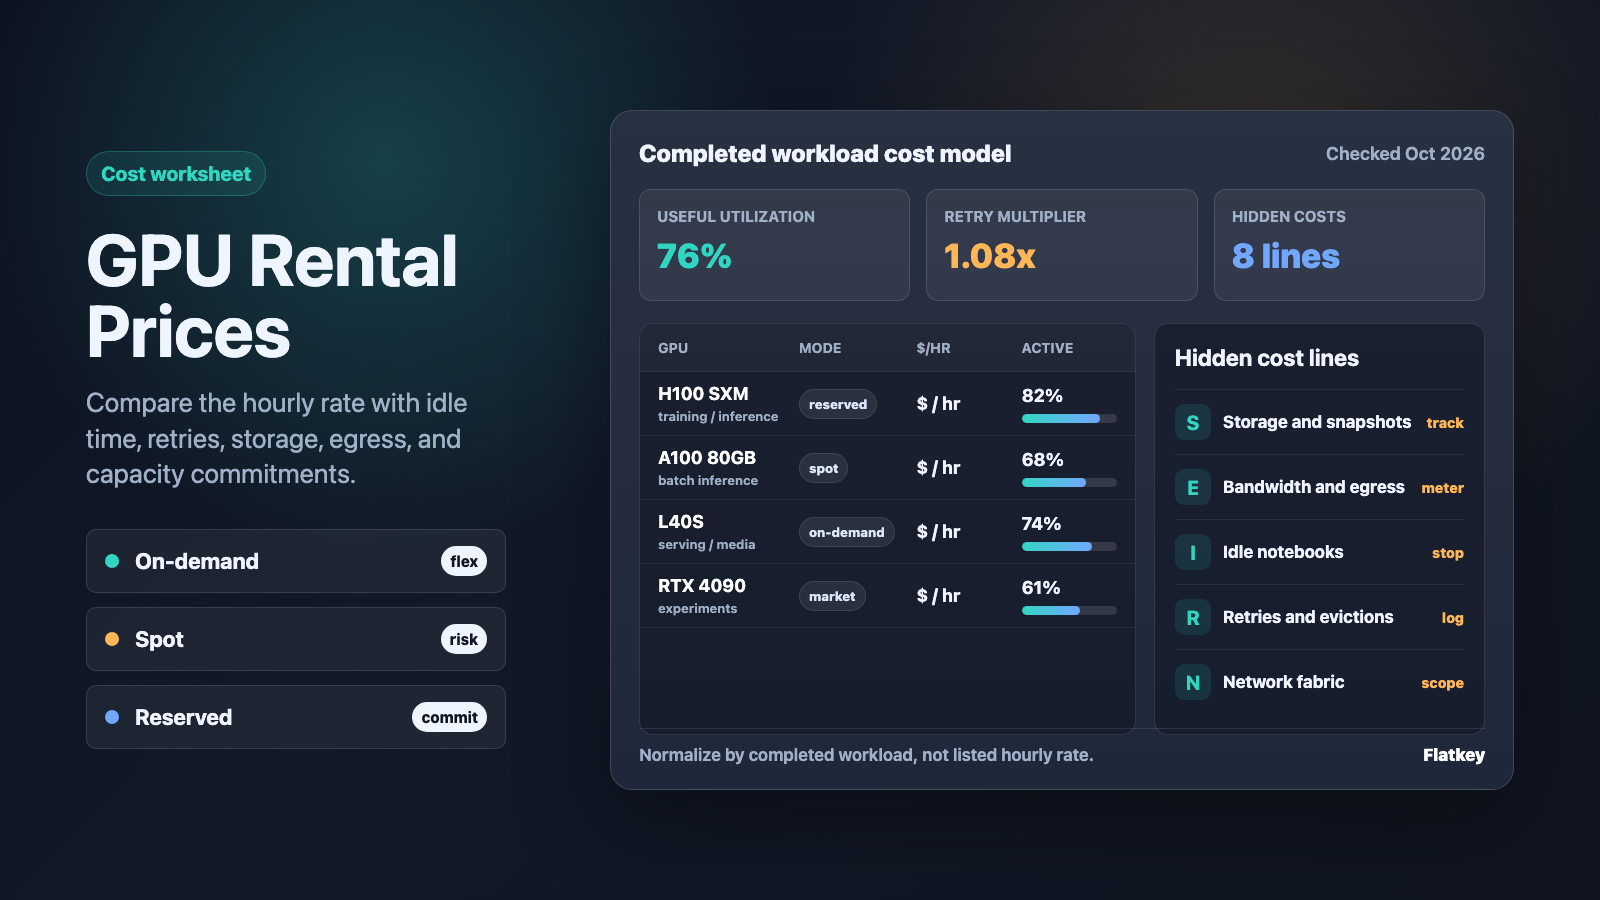
GPU 租赁价格详解:按需、竞价、预留与隐性成本
一份实用指南,帮助你按已完成工作负载成本而不只是按小时费率来比较 GPU 租赁价格,并附上按需、竞价、预留、市场平台及隐性成本模式的来源核查。
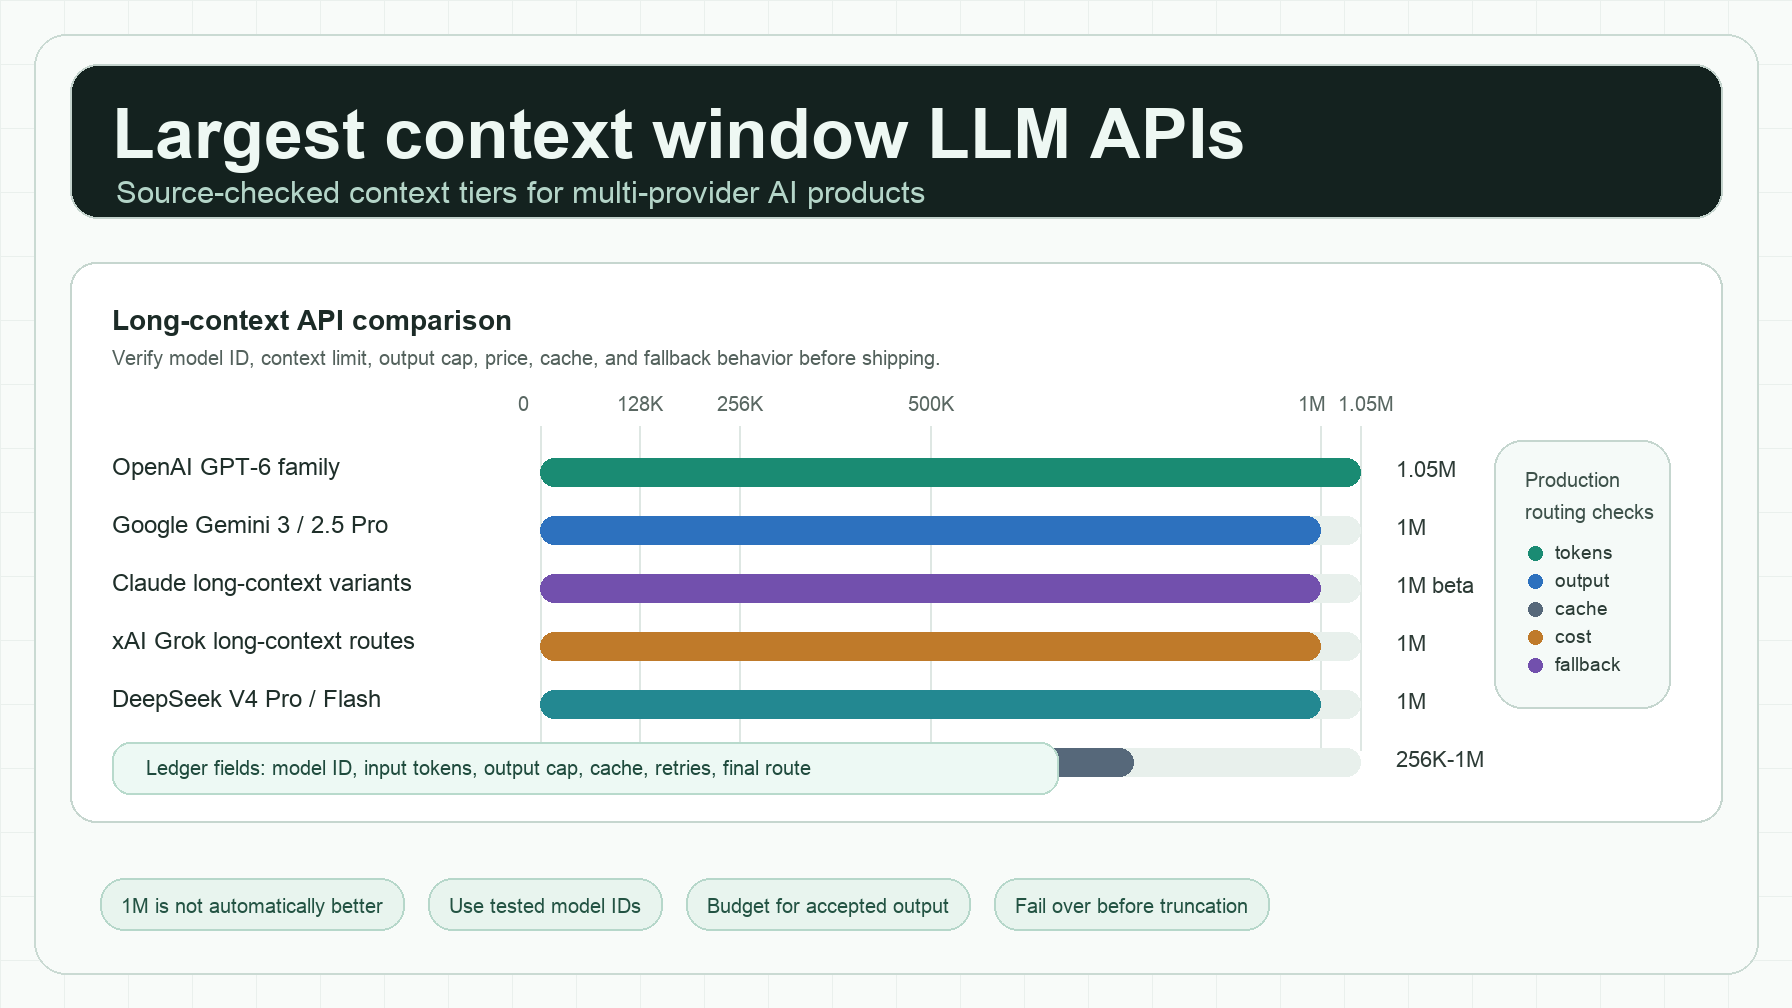
LLM 上下文窗口详解:含义、各主流模型的容量与使用方法(2026年10月)
LLM 上下文窗口是模型在单次请求中的工作记忆。本文介绍 128K、200K 和 1M token 的实际容量、截至2026年10月主流模型公布的限制、长上下文定价,以及统计 token 的代码。
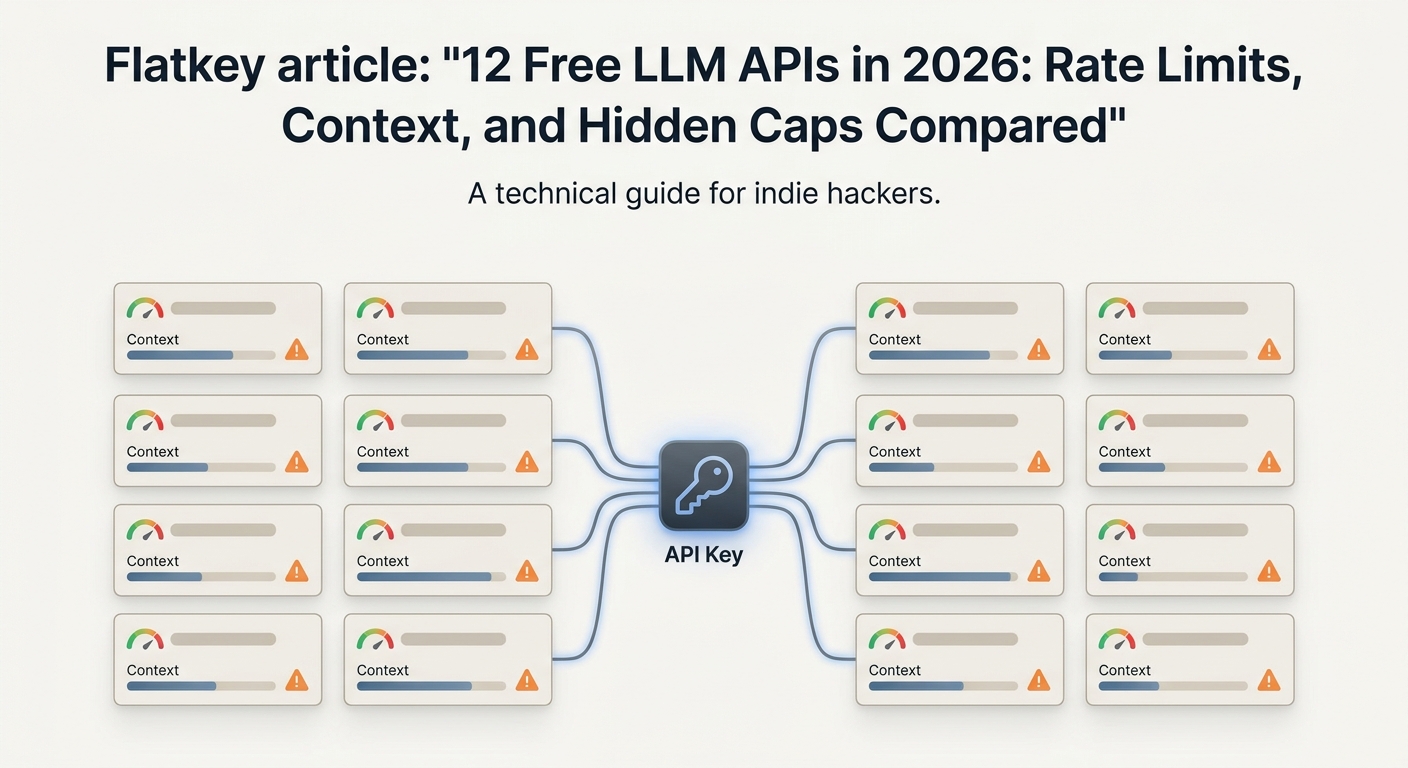
免费 LLM API(2026):按真实限额、模型与隐藏代价对比 10 个选项
依据 2026 年 10 月官方文档核对的 10 个免费 LLM API:免费内容、确切限额、隐藏代价,以及在它们之间自动回退的代码。
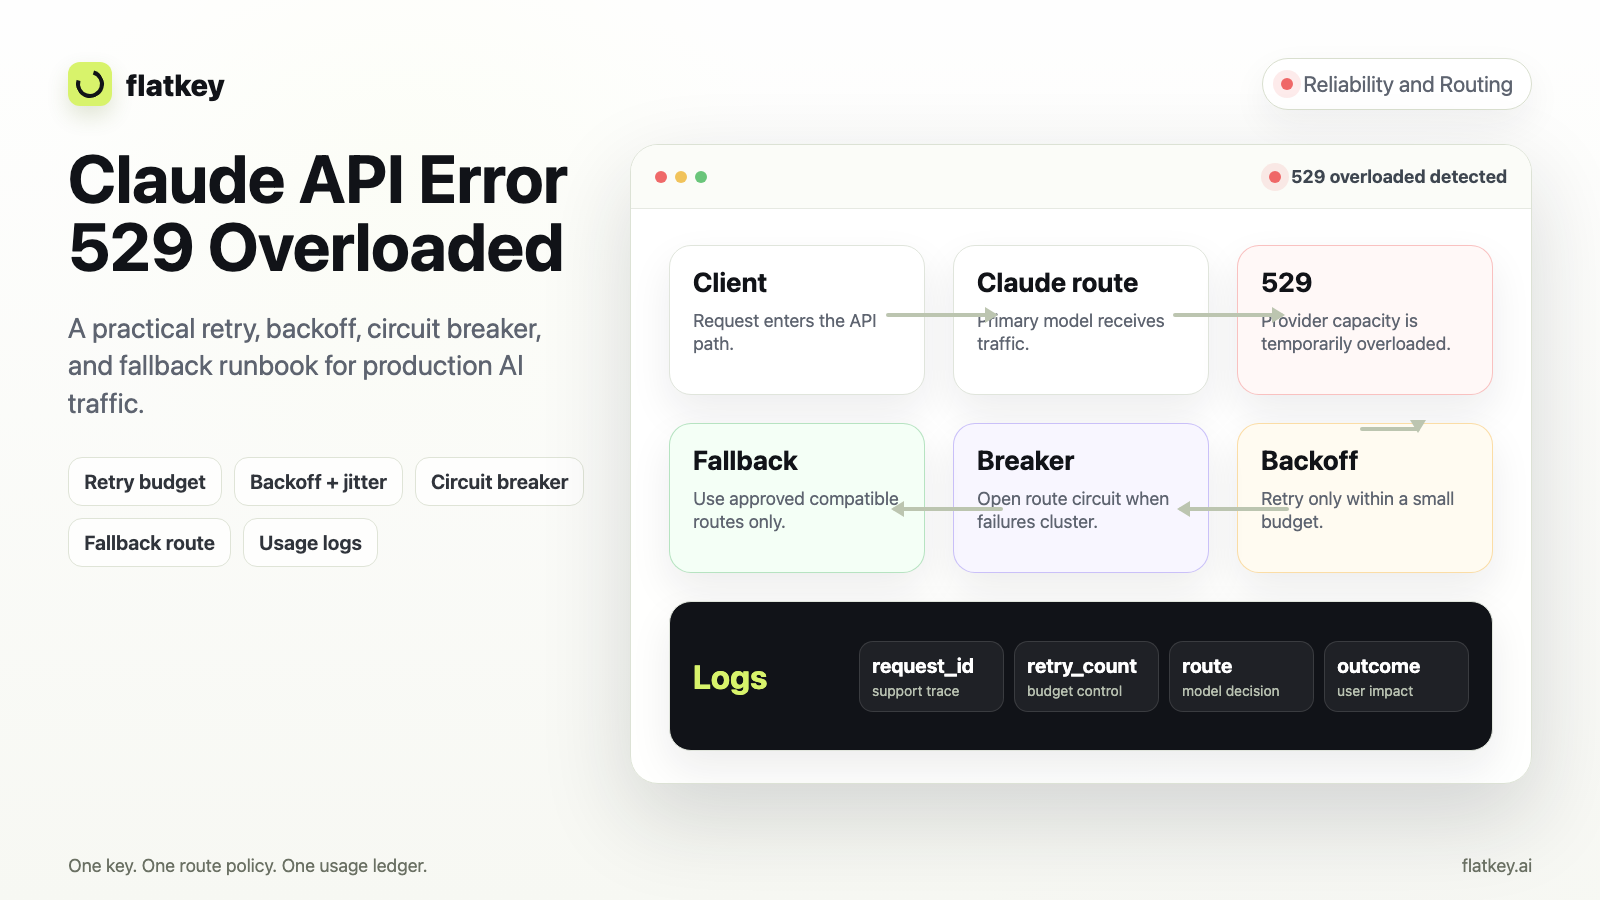
Claude API 错误 529 超载:重试、退避与降级运行手册
面向生产环境的 Claude API 529 超载错误运行手册:对故障进行分类,设置重试预算,添加退避和抖动,保护副作用,熔断重复超载,并选择安全的降级路径。

AI 模型定价比较:在一个仪表板中查看 Token、图像和视频成本
通过一个按可接受结果成本计算的仪表板,对比文本、图像、视频以及多提供商 API 路径的 AI 模型定价。
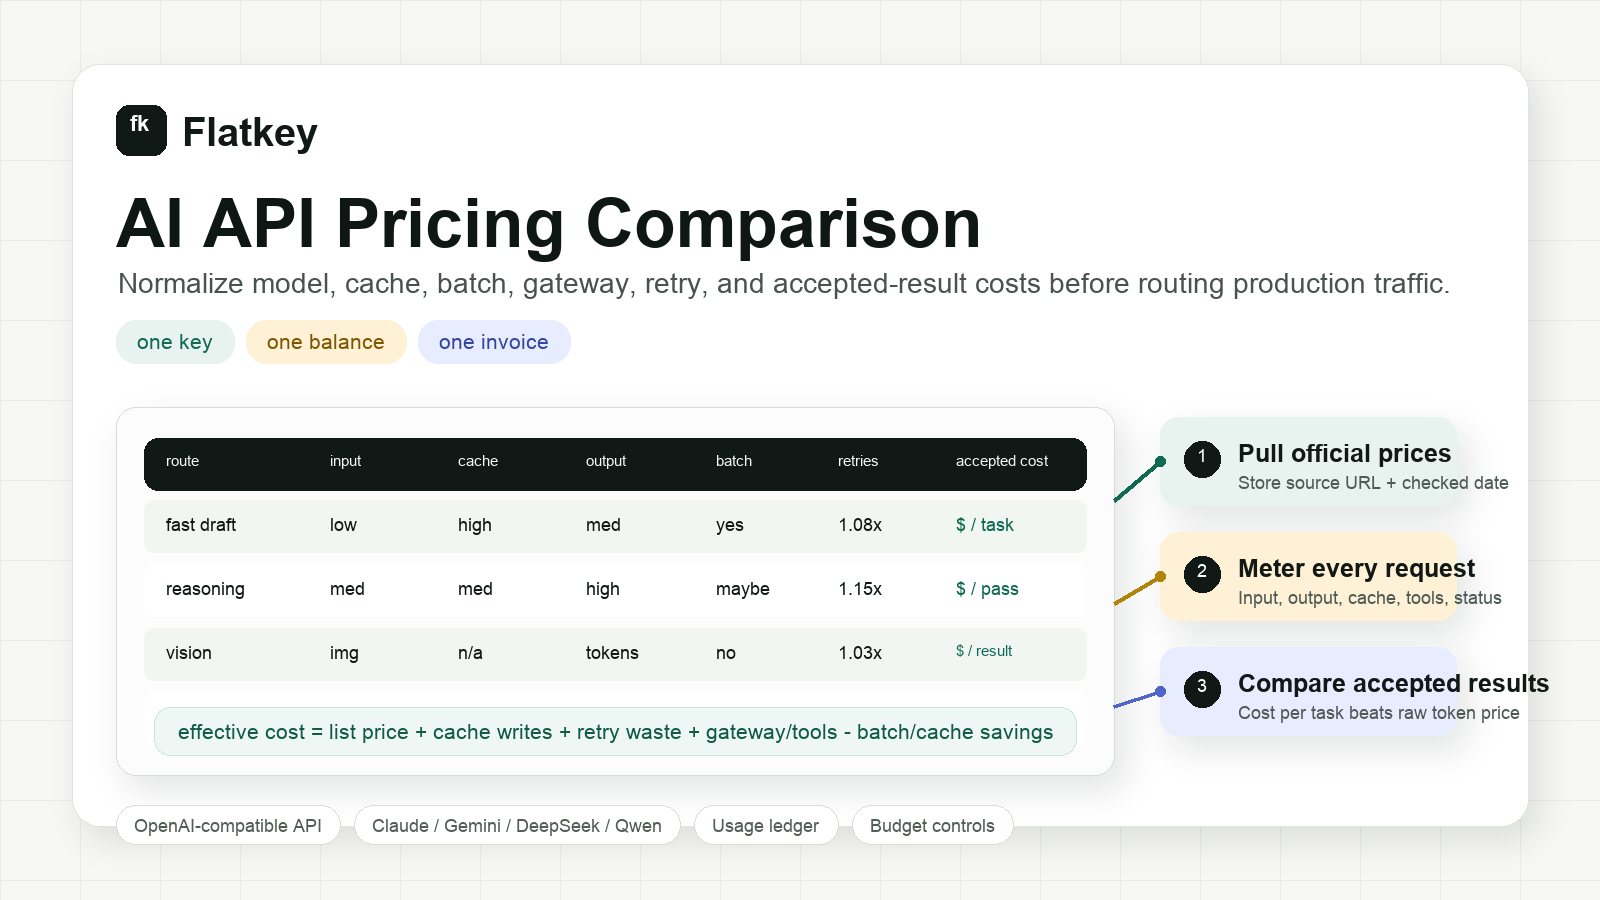
AI API 定价对比:模型、缓存、批处理和网关成本
面向开发者、产品团队和采购团队的实用 AI API 定价对比框架,比较模型、缓存、批处理、网关、重试和已接受结果成本。
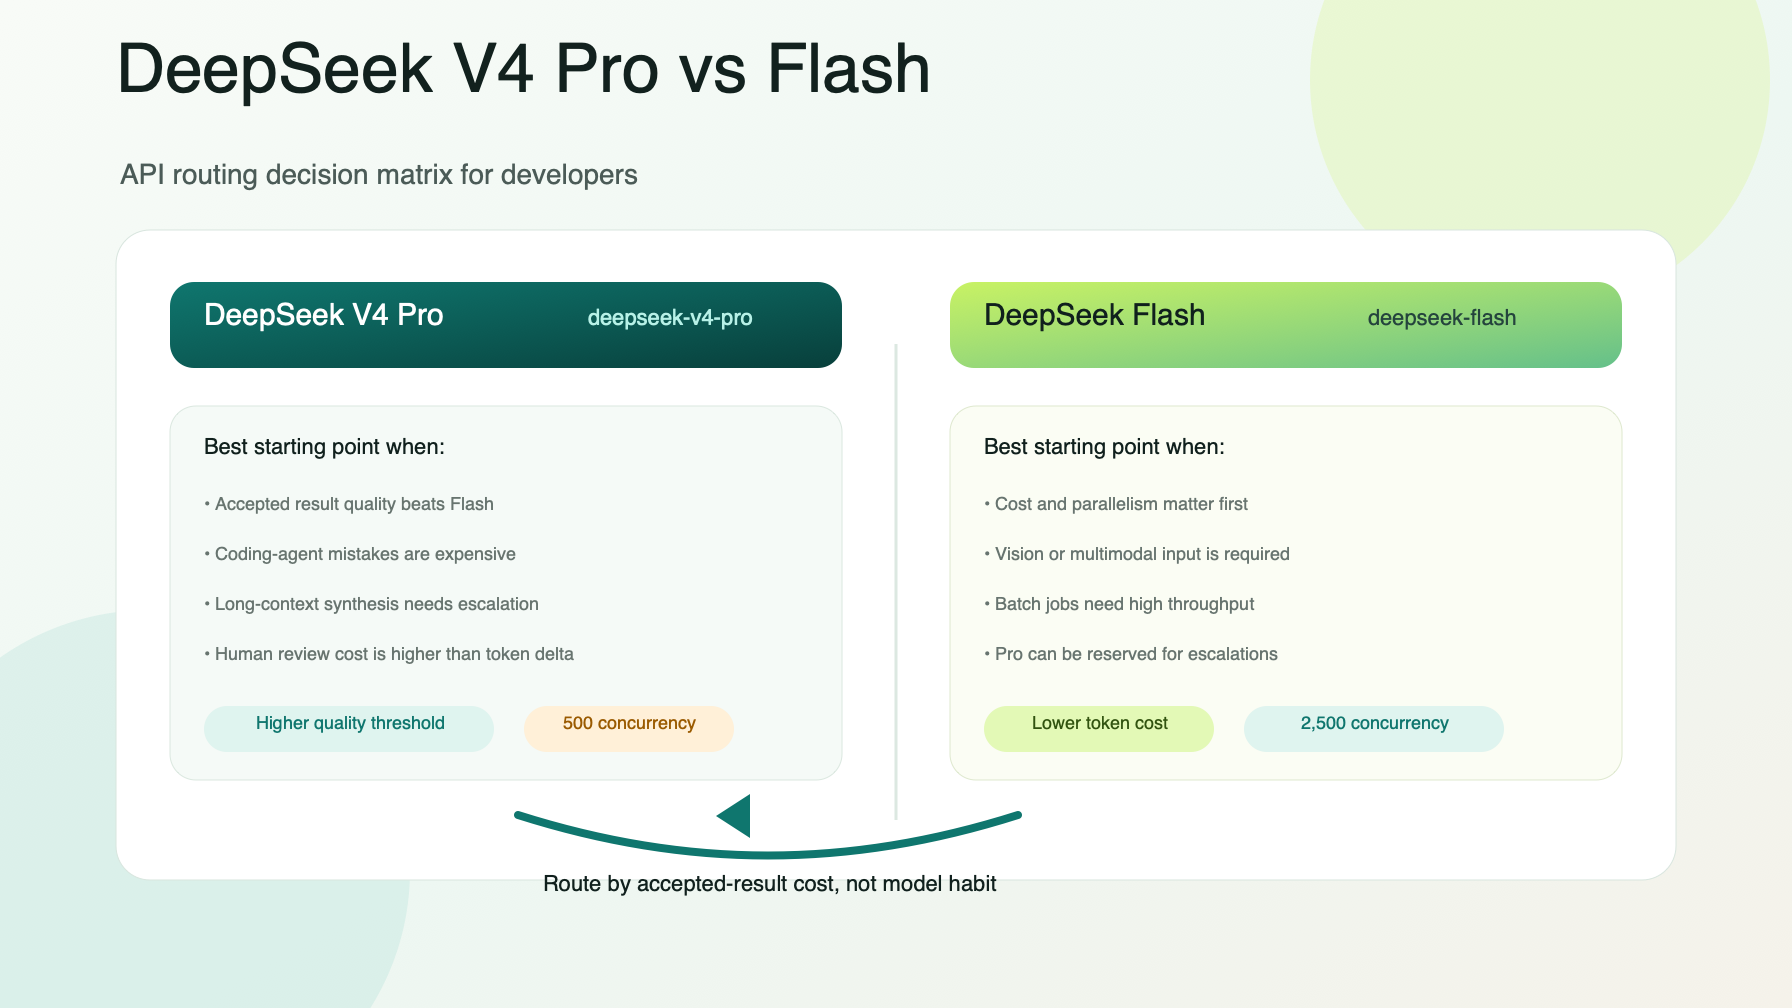
DeepSeek V4 Pro 与 Flash:哪款模型适合你的 API 工作流?
比较 DeepSeek V4 Pro 与 Flash 在 API 路由、定价、视觉、并发、缓存成本,以及何时使用 Pro 或 Flash。
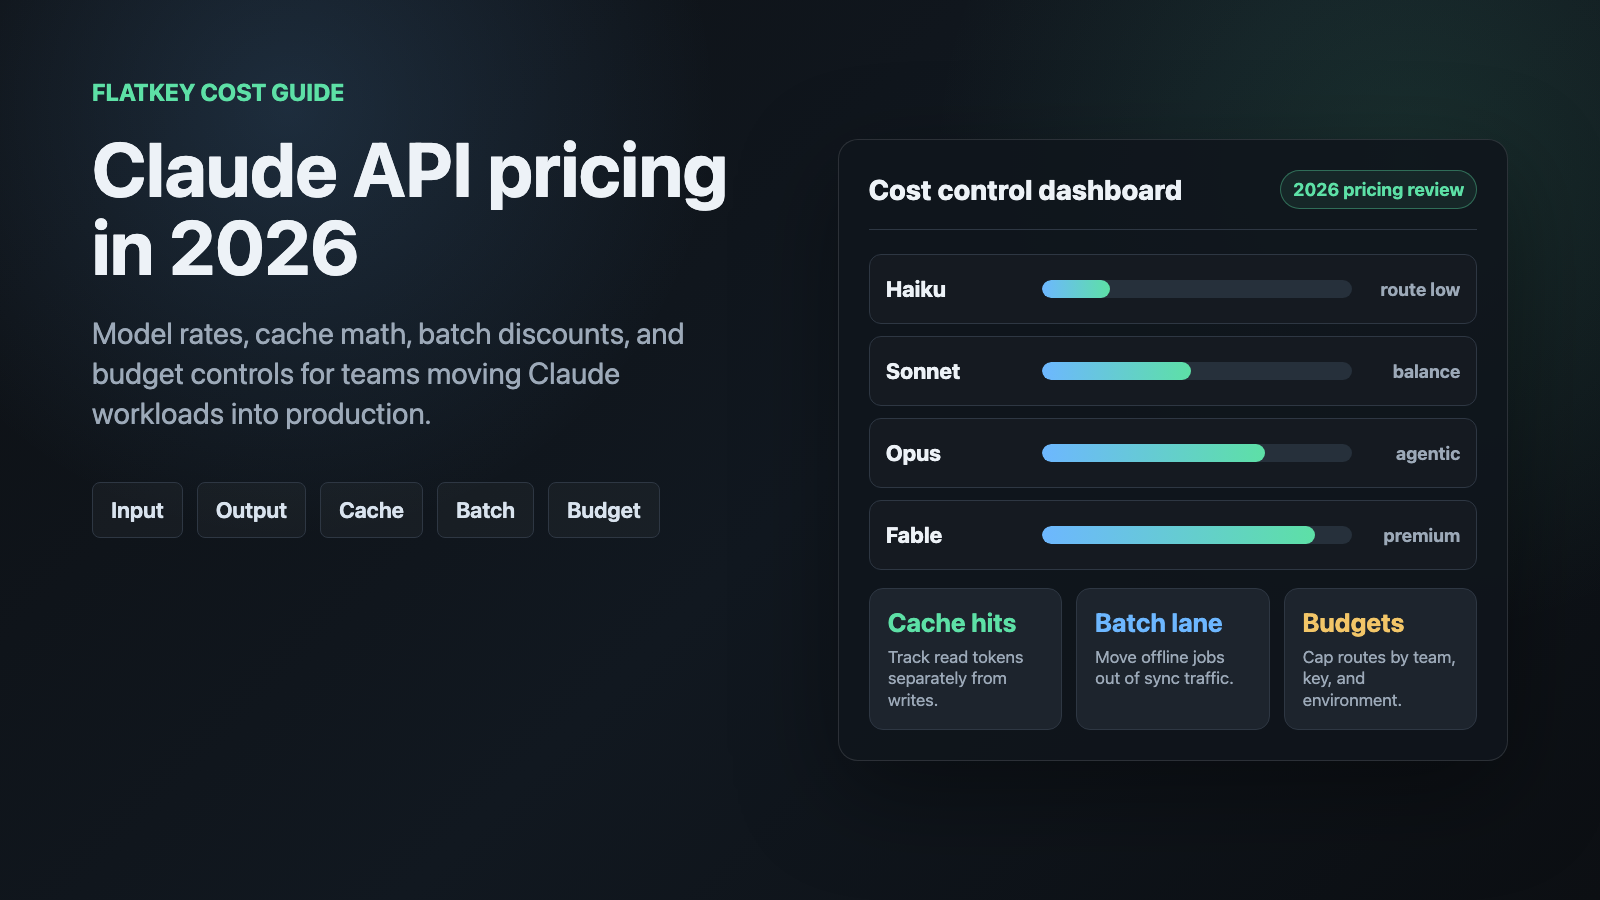
哪款 Claude 模型最适合编程?Opus 5.5、Sonnet 5.5、Haiku 5.5 与 Fable 5.1 对比(2026)
2026 年编程该用哪款 Claude 模型?本文按任务介绍 Opus 5.5、Sonnet 5.5、Haiku 5.5 和 Fable 5.1 的选择方法,涵盖官方定价、会话成本计算、Claude Code 别名及可运行的 API 示例。
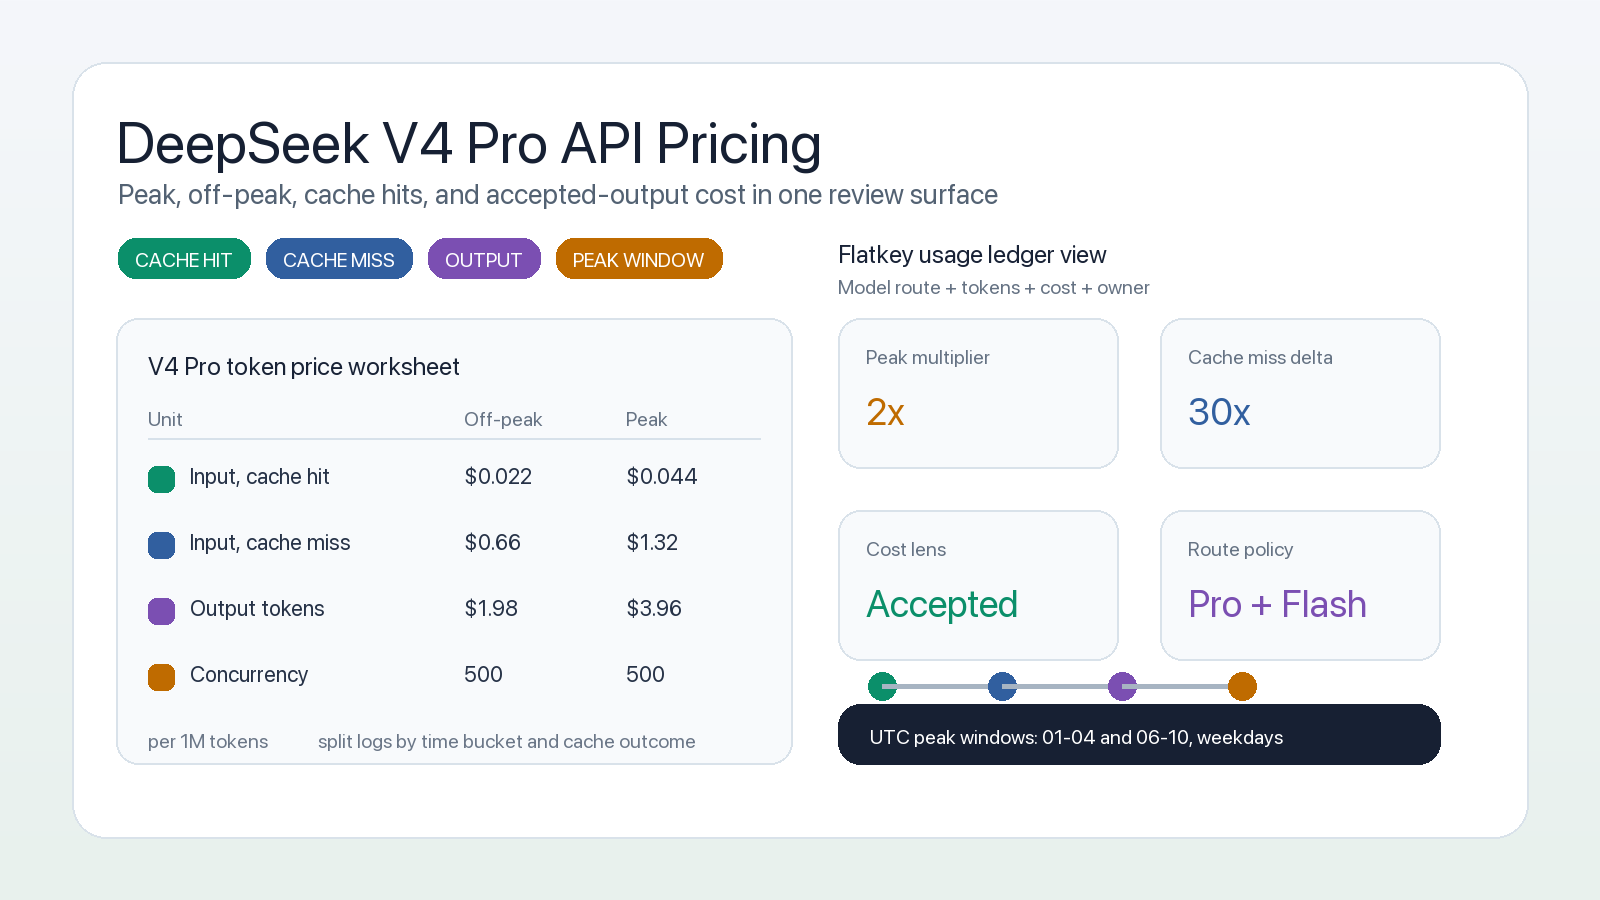
DeepSeek V4 Pro API 定价:峰值、非峰值与缓存成本
最新 DeepSeek V4 Pro API 定价,包含峰值/非峰值费率、缓存命中计算方法,以及面向开发者和采购团队的成本控制工作表。
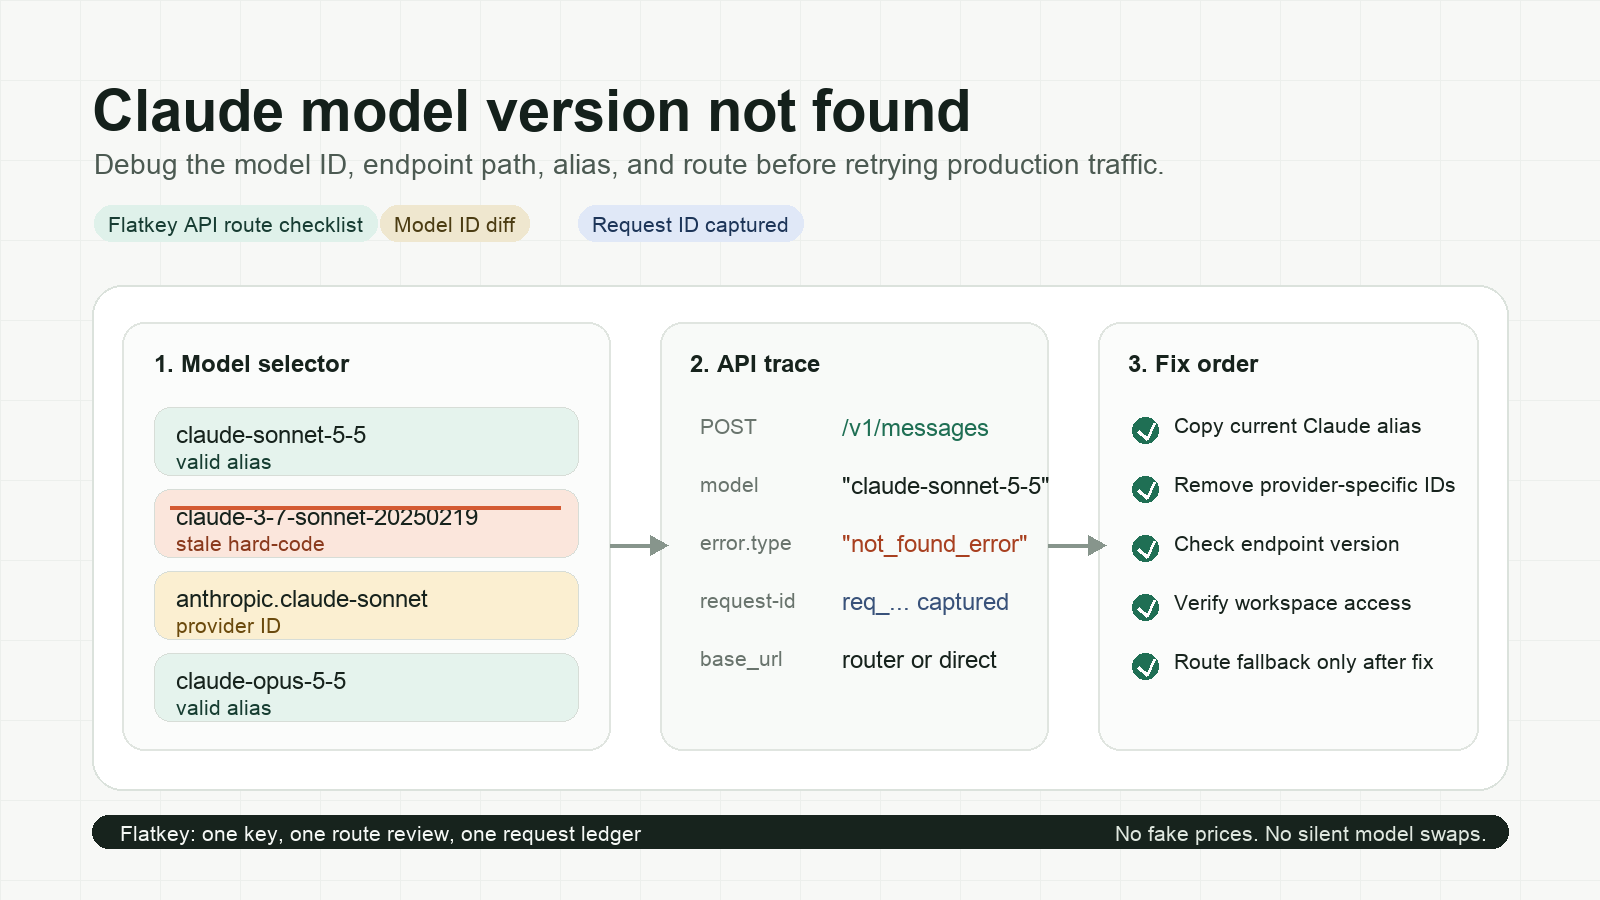
Claude 模型版本未找到:修复错误的模型 ID、别名和 API 路由
针对 Anthropic 原生 API、路由器、云提供商 ID、代理配置和生产回退中的 Claude 模型版本未找到错误的实用调试手册。
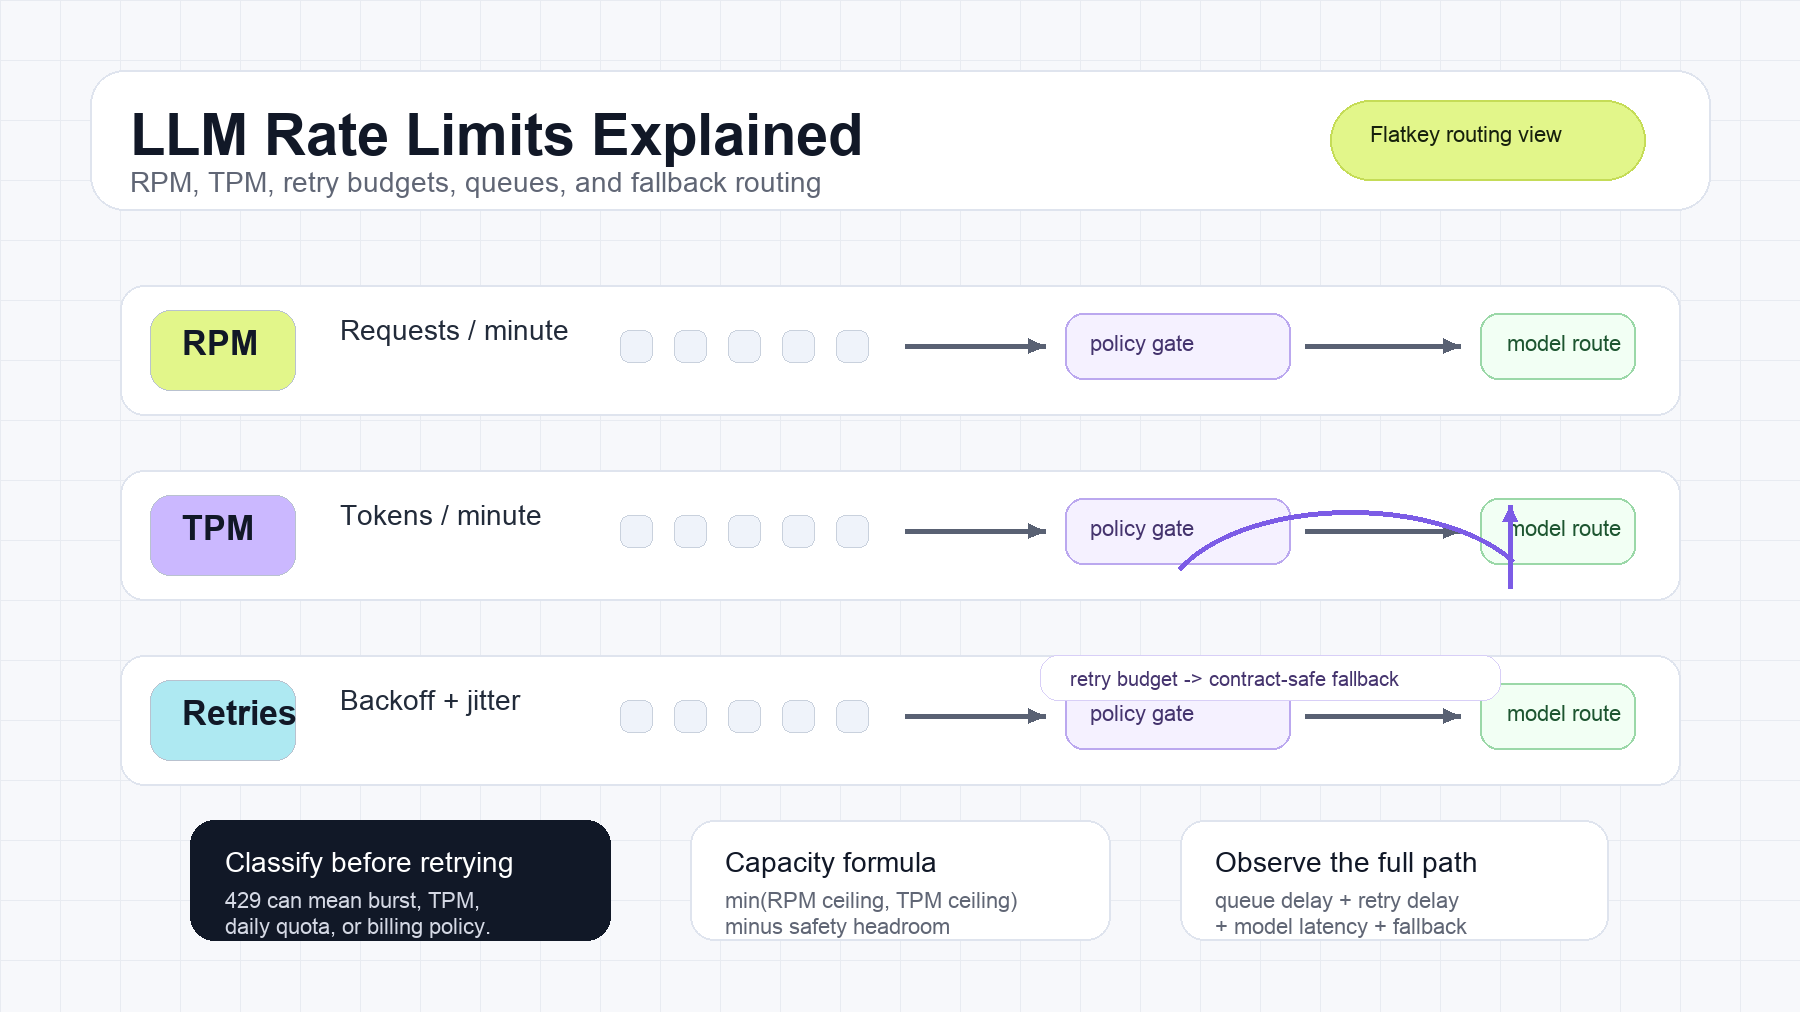
LLM 速率限制详解:RPM、TPM 与重试
了解 LLM 速率限制、RPM、TPM、429 错误、Retry-After、指数退避、重试预算、队列和故障转移路由。

GLM-5 API 访问:定价与 OpenAI 兼容配置
对比 GLM-5 系列 API 价格、模型 ID、上下文窗口,以及 Z.AI 和 Flatkey 的 OpenAI 兼容配置方式。
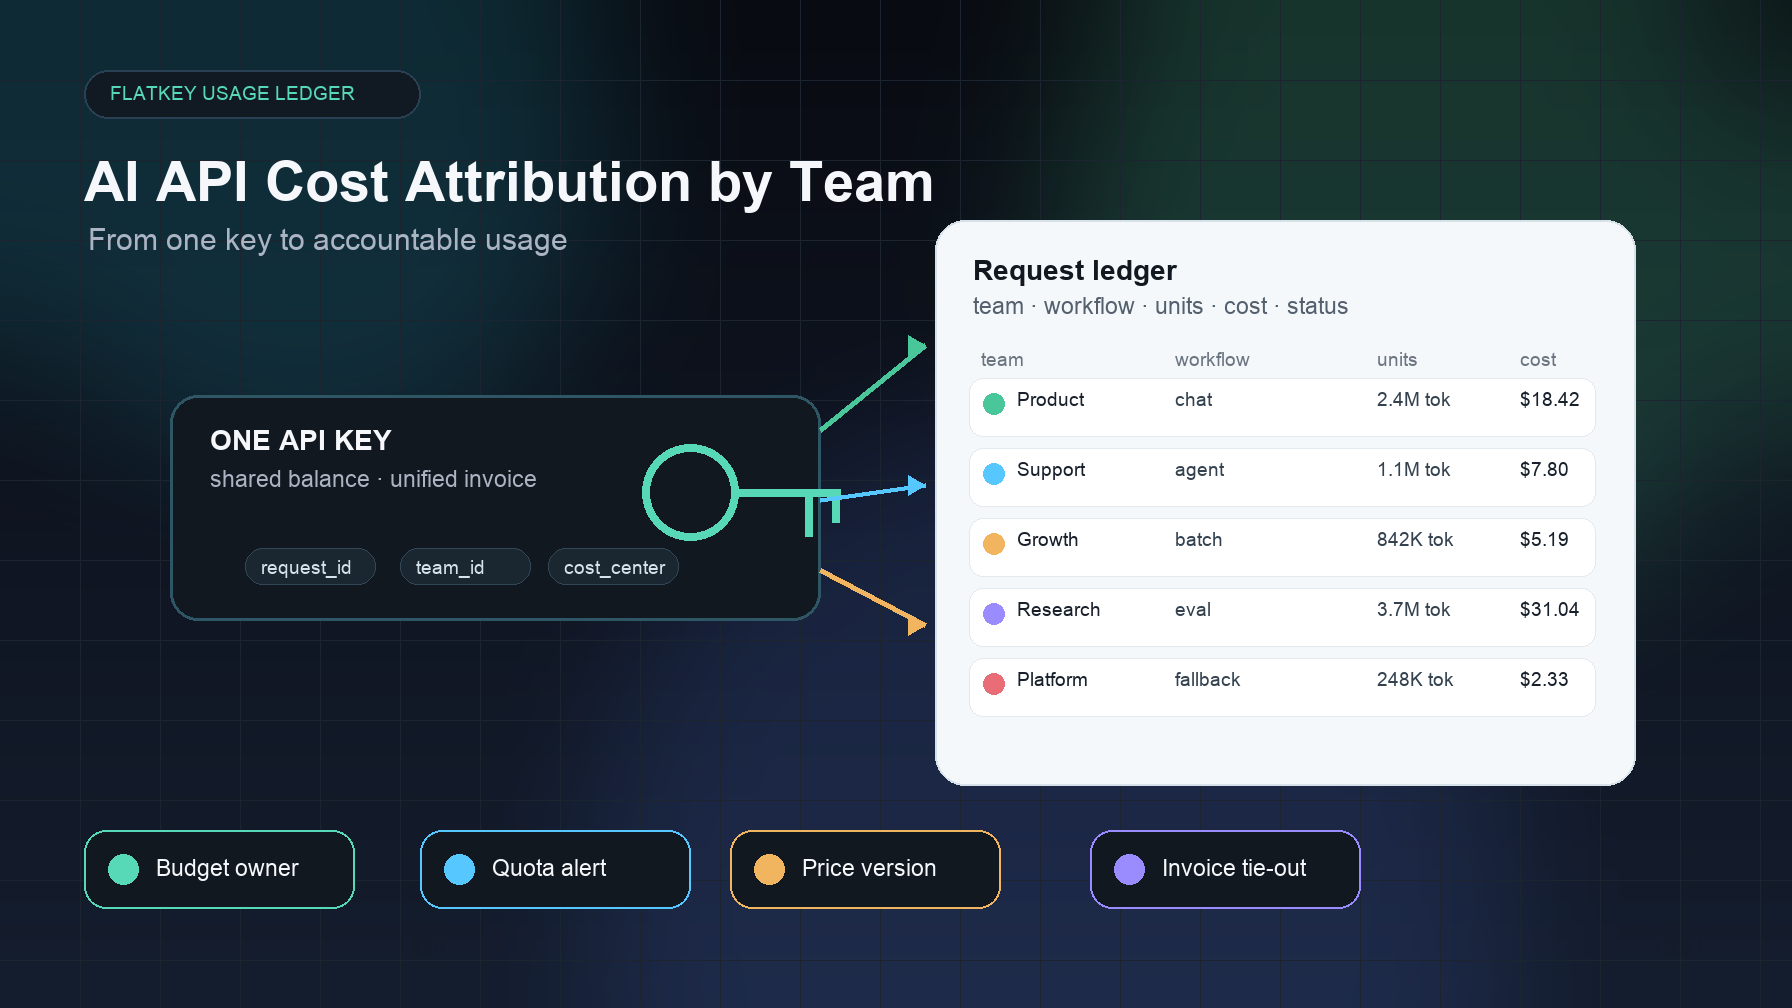
按团队分摊 AI API 成本:从一个密钥到可追责的使用
通过请求标签、子密钥边界、使用台账、配额和每月财务审查,按团队建立 AI API 成本分摊。
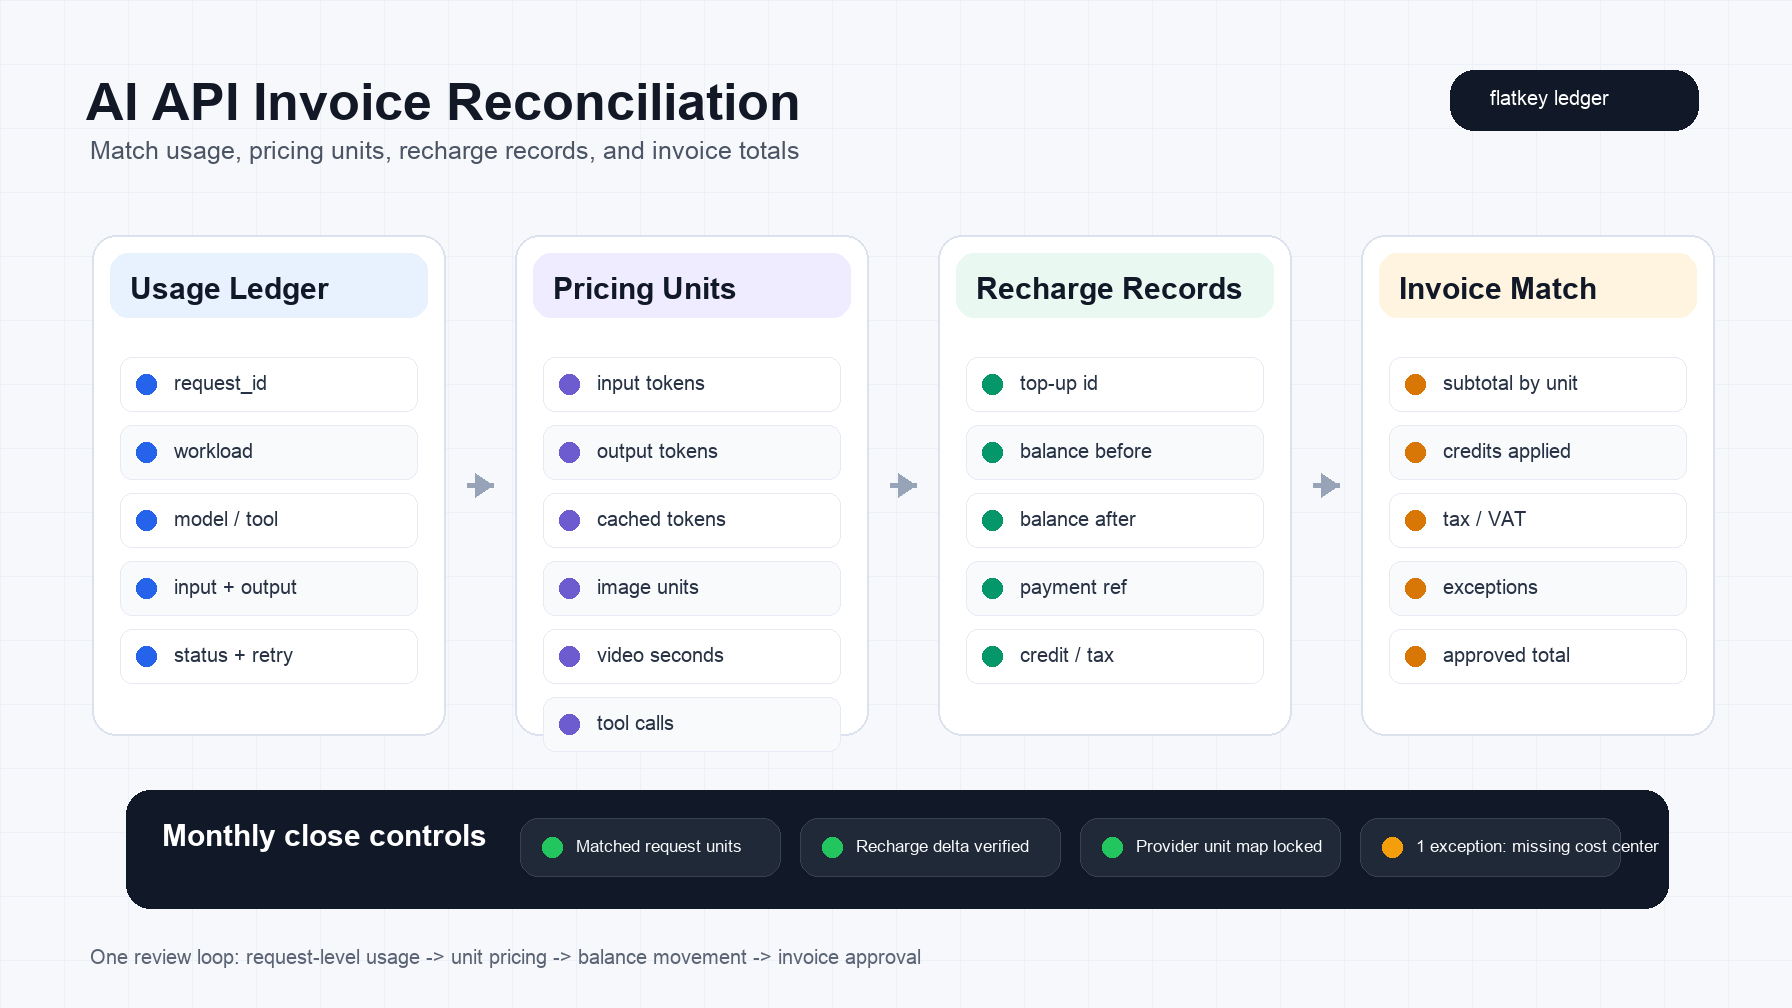
AI API 发票对账:匹配使用量、计价单位与充值记录
通过匹配使用台账、计价单位、充值记录、余额变动、抵扣、税费和发票总额,完成 AI API 发票对账。

Anthropic API 定价(2026 年 10 月):所有 Claude 模型价格、缓存、Batch 与真实成本测算
2026 年 10 月 Anthropic API 全部价格:从 Haiku 5.5 的 $0.10/$0.50 到 Fable 5.1 的 $10/$50,涵盖缓存、Batch API、数据驻留、快速模式、消费上限和月度预算示例。
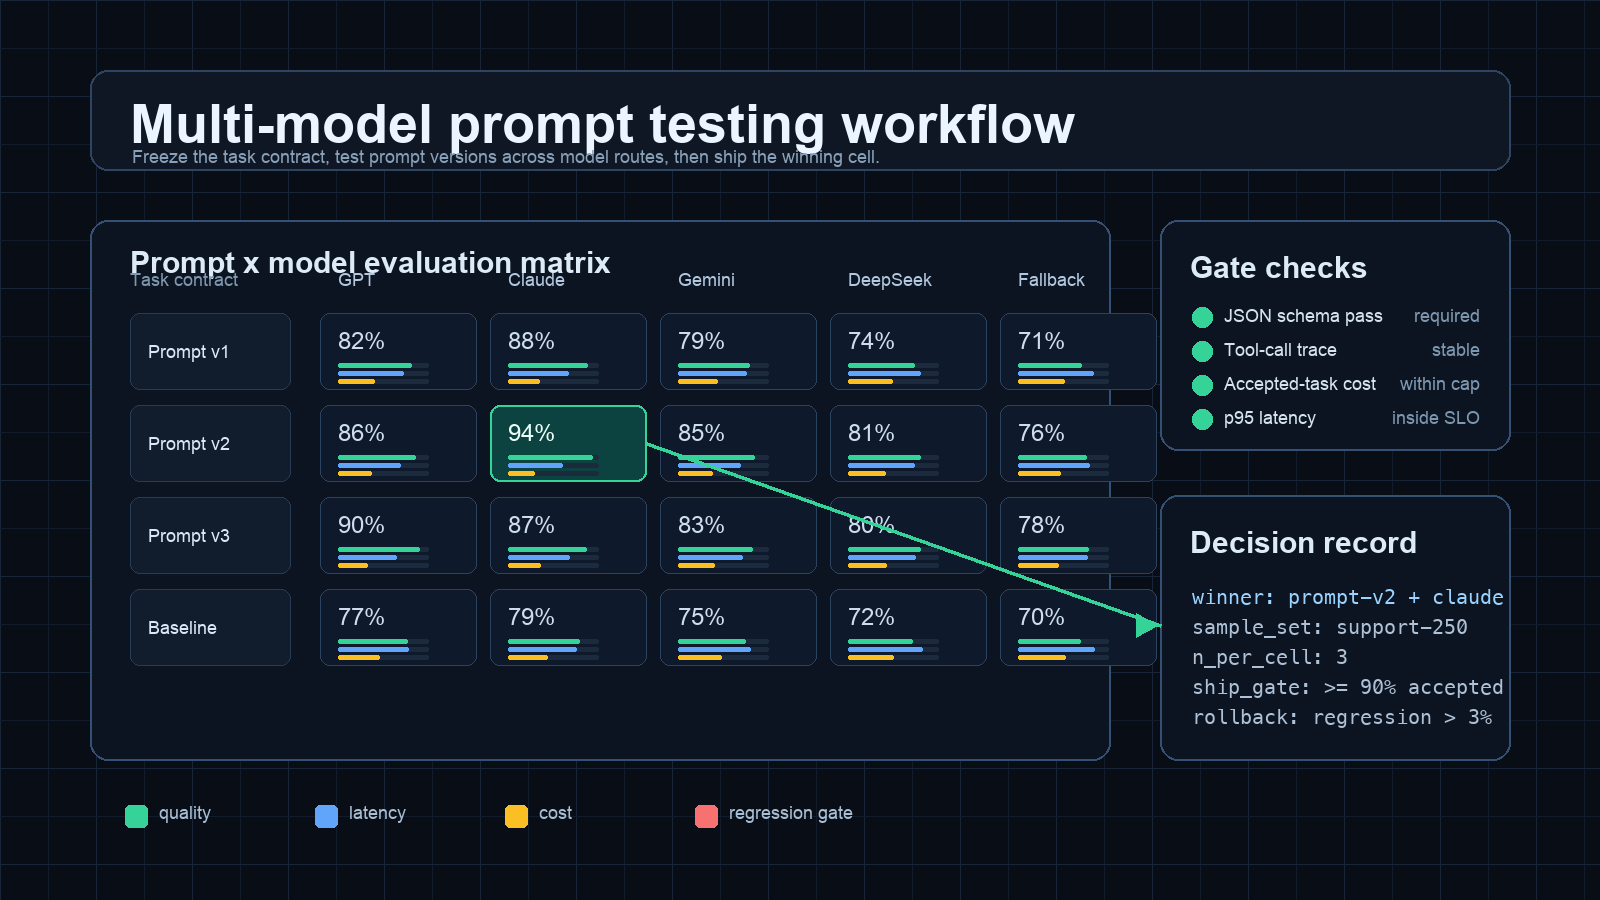
多模型提示测试工作流:面向 AI 产品团队的评估矩阵
使用提示词/模型矩阵、验证器、每个已接受任务的成本、延迟门槛和发布记录,运行多模型提示测试工作流。
在切换 API 提供商之前如何比较 AI 模型价格
在切换 API 提供商之前,请通过缓存行为、可接受输出质量、延迟、重试以及每个成功任务的有效成本来比较 AI 模型价格。
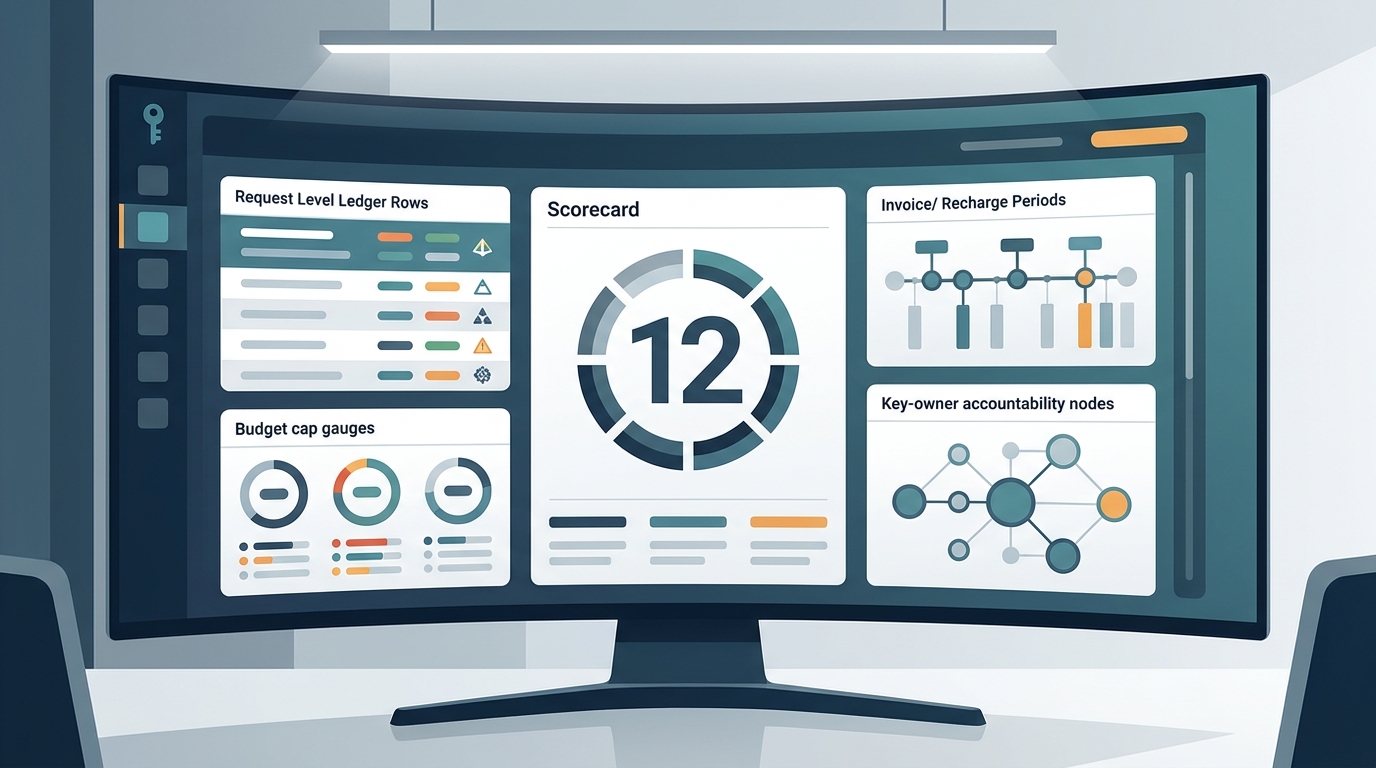
统一 AI 计费仪表盘:购买前必问的 12 个问题
一套 12 问买家评估框架,用于衡量统一 AI 计费仪表盘在用量账本、API 密钥、配额、充值记录、导出、发票和责任追踪方面的能力。
用一个 AI 网关更快上线。
使用 flatkey.ai 在一个 API 平台中管理模型、密钥、计费和可观测性。
开始使用