AI-Observability-Plattformen: Funktionen und Auswahl (2026)
Eine AI-Observability-Plattform zeichnet jeden Modellaufruf, jeden Agentenschritt und jeden Tool-Aufruf in Ihrer Anwendung auf (Prompt, Antwort, Token, Kosten, Latenz und Fehler), damit Sie in der Produktion debuggen, bewerten und Ausgaben kontrollieren können. Die führenden Optionen im Oktober 2026 sind Langfuse, LangSmith, Arize (Phoenix und AX), Datadog LLM Observability, Helicone, Braintrust und Pydantic Logfire, und die meisten akzeptieren OpenTelemetry-Traces. Entscheiden Sie danach, wo Ihre Daten liegen müssen, wie Sie Qualität bewerten und was Sie pro Trace bezahlen.
Dieser Leitfaden erklärt, was AI Observability ist, welche Signale Sie erfassen sollten, wie sich die wichtigsten Plattformen bei Funktionen und veröffentlichten Preisen unterscheiden und wie Sie eine Anwendung mit weniger als 30 Codezeilen instrumentieren. Die Preise stammen von der offiziellen Preisseite des jeweiligen Anbieters, Stand 24. Oktober 2026.
Was ist AI Observability?
AI Observability bezeichnet das Sammeln von Traces, Metriken, Logs und Qualitätsbewertungen aus KI-Systemen, damit Sie jederzeit drei Fragen beantworten können: Was hat das Modell getan? War die Antwort gut? Was hat es gekostet? Sie erweitert das klassische Anwendungsmonitoring, das Verfügbarkeit und Latenz verfolgt, um Signale, die nur bei Sprachmodellen relevant sind:
- Ein- und Ausgaben: der Prompt, der abgerufene Kontext und die generierte Antwort.
- Token-Verbrauch und Kosten: Eingabe-, Ausgabe- und gecachte Token pro Anfrage, Nutzer und Funktion.
- Agenten-Traces: jeder Denkschritt, Tool-Aufruf und Wiederholungsversuch in einem mehrstufigen Lauf.
- Qualität: Bewertungen von Evaluatoren, Nutzerfeedback sowie Markierungen für Halluzinationen oder Richtlinienverstöße.
- Modell- und Anbieter-Metadaten: welches Modell geantwortet hat, über welche Route und mit welchen Parametern.
Klassisches Monitoring sagt Ihnen, dass eine Anfrage 9 Sekunden gedauert hat. AI Observability sagt Ihnen, dass sie 9 Sekunden gedauert hat, weil der Agent dreimal ein Such-Tool aufgerufen hat, der zweite Modellaufruf einen 429-Fehler erhielt und das Fallback-Modell eine Antwort lieferte, die Ihre Groundedness-Prüfung nicht bestand.
Monitoring vs. Observability vs. Evaluation
| Praxis | Beantwortete Frage | Typisches Ergebnis |
|---|---|---|
| Monitoring | Läuft das System und bleibt es innerhalb der Schwellenwerte? | Dashboards, Alarme zu Latenz und Fehlerrate |
| Observability | Warum hat sich genau diese Anfrage so verhalten? | Traces mit Prompts, Tool-Aufrufen, Token und Metadaten |
| Evaluation | Ist die Ausgabe korrekt, sicher und nützlich? | Bewertungen aus Tests, LLM-Judges oder menschlicher Prüfung |
Eine moderne AI-Observability-Plattform vereint alle drei. Auch das AI Risk Management Framework des NIST betont die laufende Messung und Überwachung eingesetzter KI-Systeme, weshalb viele Governance-Teams diese Aufzeichnungen inzwischen verlangen.
Der offene Standard: OpenTelemetry-GenAI-Konventionen
Für KI-Telemetrie brauchen Sie kein herstellerspezifisches SDK mehr. OpenTelemetry definiert semantische Konventionen für generative KI, die die Standardattribute für Modellaufrufe benennen. Im Oktober 2026 werden diese Konventionen in einem eigenen semantic-conventions-genai-Repository gepflegt und sind weiterhin als „Development“ markiert, einige Namen können sich also noch ändern.
| Attribut | Bedeutung |
|---|---|
gen_ai.operation.name |
Die Operation, z. B. chat oder embeddings (Pflicht) |
gen_ai.provider.name |
Der Anbieter, z. B. openai oder anthropic (Pflicht) |
gen_ai.request.model |
Von Ihrem Code angefordertes Modell |
gen_ai.response.model |
Modell, das tatsächlich geantwortet hat |
gen_ai.usage.input_tokens / gen_ai.usage.output_tokens |
Token-Anzahl |
gen_ai.response.finish_reasons |
Grund für das Ende der Generierung |
gen_ai.conversation.id |
Fasst die Turns einer Unterhaltung zusammen |
Instrumentieren Sie einmal mit diesen Attributen, und Sie können dieselben Traces an Langfuse, Arize Phoenix, Datadog, Logfire, Grafana Tempo oder jedes andere OTLP-kompatible Backend senden. Die Kontextweitergabe zwischen Diensten folgt dem Standard W3C Trace Context.
AI-Observability-Plattformen im Vergleich
| Plattform | Bereitstellung | Stärken | Veröffentlichter Einstiegspreis (Okt. 2026) |
|---|---|---|---|
| Langfuse | Open Source (Self-Hosting) oder Cloud | Tracing, Prompt-Management, Evaluationen; MIT-lizenzierter Kern | Hobby kostenlos (50.000 Units/Monat); Core 29 $/Monat; Pro 199 $/Monat |
| LangSmith | Cloud, hybrid oder Self-Hosting mit Enterprise | Tiefe Integration mit LangChain und LangGraph, Evaluationen | Developer 0 $/Platz (5.000 Basis-Traces); Plus 39 $/Platz |
| Arize Phoenix und AX | Phoenix Open Source; AX Cloud | OTel-natives Tracing, Evaluationen, Drift-Analyse | Phoenix kostenlos im Self-Hosting; AX Pro 50 $/Monat (50.000 Spans) |
| Datadog LLM Observability | Cloud (Teil von Datadog) | Verknüpft LLM-Traces mit APM, Logs und Infrastruktur | Nutzungsbasiert; Angebot über Datadog |
| Helicone | Cloud oder Self-Hosting | Proxy-basiertes Logging mit einer Konfigurationszeile, Caching | Hobby kostenlos (10.000 Anfragen); Pro 79 $/Monat; Team 799 $/Monat |
| Braintrust | Cloud | Evaluation-first-Workflow, Experimente, Scoring | Starter 0 $ (1 GB verarbeitet, 10.000 Scores); Pro 249 $/Monat |
| Pydantic Logfire | Cloud | Allgemeine OTel-Observability mit starkem Python- und Agenten-Tracing | Personal kostenlos (10 Mio. Datensätze/Monat); Team 49 $/Monat |
So lesen Sie diese Tabelle:
- Daten müssen in Ihrer eigenen Umgebung bleiben? Beginnen Sie mit Langfuse oder Arize Phoenix; beide lassen sich selbst hosten.
- Sie zahlen bereits für Datadog? Dessen LLM-Observability-Produkt hält KI-Traces direkt neben Ihrem bestehenden APM und Ihren Logs.
- Sie bauen auf LangChain oder LangGraph? LangSmith erfordert die geringste Einrichtung.
- Evaluation hat Priorität? Braintrust und LangSmith führen bei Experimenten und Scoring-Workflows.
- Keine Codeänderungen gewünscht? Proxy-Tools wie Helicone oder die Logs Ihres AI-Gateways erfassen den Traffic auf Netzwerkebene.
Worauf Sie bei einer AI-Observability-Plattform achten sollten
Nutzen Sie diese Checkliste bei der Testphase:
- OpenTelemetry-Unterstützung. Kann sie OTLP-Traces mit
gen_ai.*-Attributen aufnehmen, und können Sie Ihre Daten wieder exportieren? - Agenten- und Tool-Tracing. Zeigt sie verschachtelte Spans für jeden Schritt, Tool-Aufruf und Wiederholungsversuch, nicht nur den finalen Modellaufruf?
- Kostenverfolgung. Berechnet sie die Kosten pro Anfrage aus Token und Ihren tatsächlichen Preisen, einschließlich gecachter Token und Batch-Rabatten?
- Evaluationen. Können Sie automatisierte Prüfungen (LLM-as-Judge, Regex, Referenzantworten) auf Produktions-Traces ausführen und bei sinkenden Scores alarmieren?
- Datenschutzfunktionen. Können Sie Prompts schwärzen oder hashen, Aufbewahrungsfristen festlegen und einschränken, wer Rohinhalte sieht?
- Abrechnungseinheit. Anbieter rechnen pro Trace, Span, „Unit“, GB oder Platz ab. Schätzen Sie Ihr Monatsvolumen in jeder Einheit, bevor Sie vergleichen.
- Self-Hosting. Bei regulierten Daten prüfen Sie, ob es eine Self-Hosting-Option gibt und was ihr Betrieb kostet.
Einen LLM-Aufruf in Python mit OpenTelemetry instrumentieren
Dieses Beispiel zeichnet eine Chat Completion mit den Standard-GenAI-Attributen auf und exportiert sie an einen beliebigen OTLP-Endpunkt (Langfuse, Phoenix, Logfire oder einen lokalen Collector). Es ruft Modelle über einen OpenAI-kompatiblen Endpunkt auf, daher funktioniert derselbe Code für GPT, Claude, Gemini oder DeepSeek.
pip install openai opentelemetry-sdk opentelemetry-exporter-otlp
export OTEL_EXPORTER_OTLP_ENDPOINT="http://localhost:4318"   # your collector or vendor endpoint
export FLATKEY_API_KEY="sk-..."
import os, time
from openai import OpenAI
from opentelemetry import trace
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporter

provider = TracerProvider()
provider.add_span_processor(BatchSpanProcessor(OTLPSpanExporter()))
trace.set_tracer_provider(provider)
tracer = trace.get_tracer("support-bot")

client = OpenAI(api_key=os.environ["FLATKEY_API_KEY"],
                base_url="https://router.flatkey.ai/v1")

def answer(question: str, model: str = "claude-sonnet-5-5") -> str:
    with tracer.start_as_current_span(f"chat {model}") as span:
        span.set_attribute("gen_ai.operation.name", "chat")
        span.set_attribute("gen_ai.provider.name", "flatkey")
        span.set_attribute("gen_ai.request.model", model)
        t0 = time.time()
        r = client.chat.completions.create(
            model=model, max_tokens=300,
            messages=[{"role": "user", "content": question}])
        span.set_attribute("gen_ai.response.model", r.model)
        span.set_attribute("gen_ai.usage.input_tokens", r.usage.prompt_tokens)
        span.set_attribute("gen_ai.usage.output_tokens", r.usage.completion_tokens)
        span.set_attribute("gen_ai.response.finish_reasons", [r.choices[0].finish_reason])
        span.set_attribute("app.latency_ms", int((time.time() - t0) * 1000))
        return r.choices[0].message.content

print(answer("How do I reset my password?"))
provider.shutdown()  # flush spans before exit
In Node.js funktioniert das Muster genauso mit @opentelemetry/sdk-node:
import OpenAI from "openai";
import { trace } from "@opentelemetry/api";

const tracer = trace.getTracer("support-bot");
const client = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

export async function answer(question, model = "gpt-6.1-sol") {
  return tracer.startActiveSpan(`chat ${model}`, async (span) => {
    span.setAttributes({ "gen_ai.operation.name": "chat", "gen_ai.request.model": model });
    const r = await client.chat.completions.create({ model, messages: [{ role: "user", content: question }] });
    span.setAttributes({
      "gen_ai.response.model": r.model,
      "gen_ai.usage.input_tokens": r.usage.prompt_tokens,
      "gen_ai.usage.output_tokens": r.usage.completion_tokens,
    });
    span.end();
    return r.choices[0].message.content;
  });
}
Legen Sie Prompt- und Antworttexte nur dann in Span-Attributen ab, wenn Ihre Datenschutzrichtlinie es erlaubt; viele Teams protokollieren stattdessen einen Hash oder eine geschwärzte Kopie. Unser Leitfaden zum Payload-Logging behandelt Schwärzungsmuster.
Ihr AI-Gateway ist ebenfalls eine Observability-Quelle
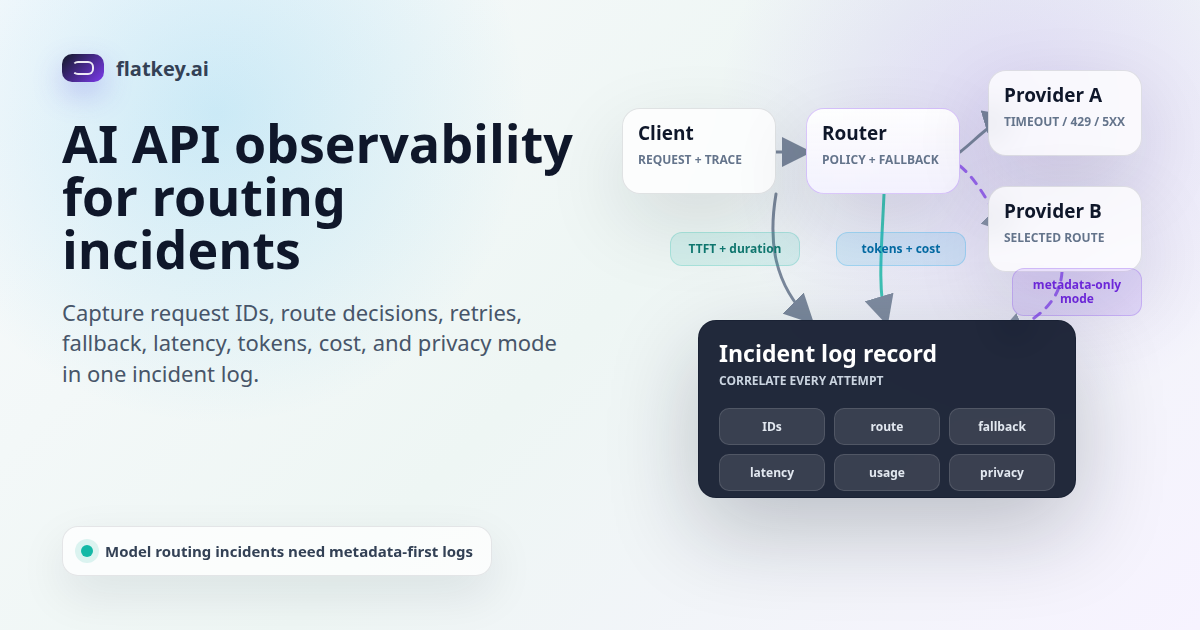
Wenn Ihre Anwendung Modelle über ein AI-Gateway oder einen Router aufruft, sieht das Gateway bereits jede Anfrage und ist daher der günstigste Startpunkt. Es erfasst Daten sogar für Dienste, die noch nicht instrumentiert sind. Die Nutzungsprotokolle von Flatkey zeichnen beispielsweise für jeden Aufruf Zeitstempel, Modell, Eingabe-Token, Ausgabe-Token, Kosten, maskierten API-Schlüssel und Status auf, lassen sich als CSV oder JSON exportieren und unterstützen monatliche Ausgabenlimits sowie Kontingente pro Gruppe (Flatkey-Nutzungsdokumentation, Oktober 2026).
Ein praxistaugliches Setup kombiniert beide Ebenen:
| Ebene | Was sie am besten sieht | Anwendungsbeispiel |
|---|---|---|
| Gateway-Logs | Jeder Modellaufruf, Kosten, Status, Anbieterfehler, Fallbacks | Ausgaben pro Schlüssel oder Team, 429- und 5xx-Raten, Anbieterausfälle |
| Anwendungs-Traces | Geschäftskontext, Agentenschritte, Retrieval, Tool-Aufrufe | Warum die Anfrage eines Nutzers fehlschlug oder schlecht beantwortet wurde |
| Evaluationen | Antwortqualität im Zeitverlauf | Regressionen nach einer Prompt- oder Modelländerung erkennen |
Verbinden Sie beide über eine gemeinsame Request-ID: Senden Sie Ihre Trace-ID bei jedem Modellaufruf als Header oder Metadatenfeld, damit Sie von einer Gateway-Logzeile zum vollständigen Anwendungs-Trace springen können. Unser empfohlenes Metrik-Set finden Sie unter LLM-API-Observability: Metriken, Traces und Kosten, Diagramm-Layouts im KPI-Dashboard für AI-Gateways.
Die Metriken, die in der Produktion zählen
| Metrik | Warum sie wichtig ist | Alarmidee |
|---|---|---|
| p50- / p95-Latenz pro Modell | Nutzer spüren die Tail-Latenz | p95 über Ihrem SLO für 10 Minuten |
| Zeit bis zum ersten Token | Streaming-Erlebnis | Steigende TTFT bei einem einzelnen Anbieter |
| Fehlerrate nach Status (429, 5xx, Timeout) | Anbieter- oder Kontingentprobleme | 429-Rate über 2 % |
| Fallback-Rate | Versteckte Zuverlässigkeitsprobleme | Fallbacks verdoppeln sich von Tag zu Tag |
| Kosten pro Anfrage und pro Nutzer | Budgetkontrolle | Tagesausgaben über der Prognose |
| Token pro Anfrage | Aufgeblähte Prompts und außer Kontrolle geratene Agenten | Agentenläufe über einer Token-Obergrenze |
| Evaluationsscore | Qualitätsregressionen | Score-Rückgang nach einem Deployment |
Ordnen Sie Kosten nach Team und Umgebung zu, damit die Finanzabteilung Antworten bekommt; der Leitfaden zur Kostenzuordnung und Kostenverfolgung nach Umgebung zeigen Tagging-Schemata. Für den Rollout-Plan folgen Sie der Checkliste zur Einführung von AI Observability.
FAQ
Was ist AI Observability?
AI Observability bedeutet, Traces, Metriken, Logs und Qualitätsbewertungen aus KI-Anwendungen zu sammeln, um zu sehen, was ein Modell oder Agent getan hat, ob das Ergebnis gut war und was es gekostet hat. Sie ergänzt das klassische Monitoring um Prompts, Token, Tool-Aufrufe und Evaluationen.
Was ist die beste AI-Observability-Plattform?
Die eine beste Plattform gibt es nicht. Langfuse und Arize Phoenix passen zu Teams, die Open Source und Self-Hosting wollen, LangSmith zu LangChain-Nutzern, Datadog zu Teams, die bereits Datadog einsetzen, und Braintrust zu evaluationslastigen Workflows. Testen Sie zwei Optionen mit Ihren eigenen Traces.
Gibt es eine kostenlose AI-Observability-Plattform?
Ja. Im Oktober 2026 sind Langfuse Hobby (50.000 Units pro Monat), LangSmith Developer (5.000 Basis-Traces), Helicone Hobby (10.000 Anfragen), Braintrust Starter und Logfire Personal (10 Mio. Datensätze) kostenlos, und Langfuse sowie Arize Phoenix lassen sich ohne Lizenzkosten selbst hosten.
Was ist der Unterschied zwischen LLM-Monitoring und AI Observability?
Monitoring überwacht vordefinierte Schwellenwerte wie Latenz und Fehlerrate. Observability ermöglicht es, jede einzelne Anfrage im Detail zu untersuchen, einschließlich Prompts, Tool-Aufrufen, Token-Verbrauch und Qualitätsbewertungen.
Funktioniert AI Observability mit OpenTelemetry?
Ja. Die GenAI-Semantikkonventionen von OpenTelemetry definieren Standardattribute wie gen_ai.request.model und gen_ai.usage.input_tokens, und die meisten Plattformen akzeptieren OTLP-Traces. Im Oktober 2026 haben die Konventionen weiterhin den Status Development.
Was ist Observability für generative KI?
Es ist dieselbe Praxis, angewandt auf generative Modelle: Prompts, Ausgaben, Token-Kosten, Agentenschritte und Evaluationsergebnisse erfassen, damit Teams Funktionen mit generativer KI in der Produktion debuggen und verbessern können.
Quellen
- OpenTelemetry-GenAI-Semantikkonventionen (Oktober 2026)
- Langfuse-Preise, LangSmith-Preise, Arize-Preise, Helicone-Preise, Braintrust-Preise, Logfire-Preise (alle geprüft am 24. Oktober 2026)
- Datadog-LLM-Observability-Dokumentation (Oktober 2026)
- Arize Phoenix auf GitHub und Langfuse auf GitHub
- AI Risk Management Framework des NIST