Nền tảng AI observability: chức năng và cách chọn (2026)
Nền tảng AI observability ghi lại mọi lệnh gọi mô hình, mọi bước của agent và mọi lệnh gọi công cụ trong ứng dụng của bạn (prompt, phản hồi, token, chi phí, độ trễ và lỗi) để bạn có thể gỡ lỗi, đánh giá và kiểm soát chi tiêu trong môi trường production. Các lựa chọn hàng đầu vào tháng 10/2026 là Langfuse, LangSmith, Arize (Phoenix và AX), Datadog LLM Observability, Helicone, Braintrust và Pydantic Logfire, và phần lớn đều nhận trace OpenTelemetry. Hãy chọn dựa trên nơi dữ liệu của bạn phải được lưu trữ, cách bạn đánh giá chất lượng và số tiền bạn sẽ trả cho mỗi trace.
Bài viết này giải thích AI observability là gì, nên thu thập những tín hiệu nào, các nền tảng chính so sánh ra sao về tính năng và giá công bố, cũng như cách gắn instrumentation cho ứng dụng với chưa đến 30 dòng mã. Giá được lấy từ trang giá chính thức của từng nhà cung cấp, kiểm tra vào ngày 24/10/2026.
AI observability là gì?
AI observability là việc thu thập trace, metric, log và điểm chất lượng từ hệ thống AI để bạn luôn trả lời được ba câu hỏi: Mô hình đã làm gì? Câu trả lời có tốt không? Tốn bao nhiêu tiền? Nó mở rộng việc giám sát ứng dụng truyền thống (theo dõi uptime và độ trễ) bằng những tín hiệu chỉ quan trọng với mô hình ngôn ngữ:
- Đầu vào và đầu ra: prompt, ngữ cảnh được truy xuất và câu trả lời được tạo ra.
- Mức dùng token và chi phí: token đầu vào, đầu ra và token cache theo từng yêu cầu, người dùng và tính năng.
- Trace của agent: từng bước suy luận, lệnh gọi công cụ và lần thử lại trong một lần chạy nhiều bước.
- Chất lượng: điểm của bộ đánh giá, phản hồi người dùng và các cờ báo ảo giác hoặc vi phạm chính sách.
- Metadata về mô hình và nhà cung cấp: mô hình nào trả lời, qua tuyến nào, với tham số nào.
Giám sát truyền thống cho bạn biết một yêu cầu mất 9 giây. AI observability cho bạn biết nó mất 9 giây vì agent đã gọi công cụ tìm kiếm ba lần, lệnh gọi mô hình thứ hai gặp lỗi 429, và mô hình dự phòng tạo ra câu trả lời không vượt qua bước kiểm tra tính có căn cứ (groundedness) của bạn.
Giám sát, observability và đánh giá khác nhau thế nào
| Hoạt động | Câu hỏi trả lời | Đầu ra điển hình |
|---|---|---|
| Giám sát | Hệ thống có đang chạy và nằm trong ngưỡng không? | Dashboard, cảnh báo về độ trễ và tỷ lệ lỗi |
| Observability | Vì sao yêu cầu cụ thể này lại hoạt động như vậy? | Trace có prompt, lệnh gọi công cụ, token và metadata |
| Đánh giá | Đầu ra có đúng, an toàn và hữu ích không? | Điểm từ bài test, LLM giám khảo hoặc người đánh giá |
Một nền tảng AI observability hiện đại kết hợp cả ba. Khung quản lý rủi ro AI của NIST cũng nhấn mạnh việc đo lường và giám sát liên tục các hệ thống AI đã triển khai, vì vậy nhiều nhóm quản trị hiện yêu cầu lưu giữ những bản ghi này.
Tiêu chuẩn mở: quy ước GenAI của OpenTelemetry
Bạn không còn cần SDK riêng của nhà cung cấp để thu thập telemetry AI. OpenTelemetry định nghĩa quy ước ngữ nghĩa cho AI tạo sinh, đặt tên cho các thuộc tính tiêu chuẩn của lệnh gọi mô hình. Tính đến tháng 10/2026, các quy ước này được duy trì trong một kho semantic-conventions-genai riêng và vẫn mang trạng thái "Development", nên một số tên có thể còn thay đổi.
| Thuộc tính | Ý nghĩa |
|---|---|
gen_ai.operation.name |
Thao tác, ví dụ chat hoặc embeddings (bắt buộc) |
gen_ai.provider.name |
Nhà cung cấp, ví dụ openai hoặc anthropic (bắt buộc) |
gen_ai.request.model |
Mô hình mà mã của bạn yêu cầu |
gen_ai.response.model |
Mô hình thực sự trả lời |
gen_ai.usage.input_tokens / gen_ai.usage.output_tokens |
Số lượng token |
gen_ai.response.finish_reasons |
Lý do quá trình sinh dừng lại |
gen_ai.conversation.id |
Gom các lượt trong cùng một cuộc hội thoại |
Chỉ cần gắn instrumentation một lần với các thuộc tính này, bạn có thể gửi cùng một trace tới Langfuse, Arize Phoenix, Datadog, Logfire, Grafana Tempo hoặc bất kỳ backend tương thích OTLP nào. Việc truyền ngữ cảnh giữa các dịch vụ tuân theo tiêu chuẩn W3C Trace Context.
So sánh các nền tảng AI observability
| Nền tảng | Triển khai | Điểm mạnh | Giá khởi điểm công bố (10/2026) |
|---|---|---|---|
| Langfuse | Mã nguồn mở (tự host) hoặc cloud | Tracing, quản lý prompt, đánh giá; lõi giấy phép MIT | Hobby miễn phí (50k đơn vị/tháng); Core 29 USD/tháng; Pro 199 USD/tháng |
| LangSmith | Cloud, hybrid hoặc tự host với gói Enterprise | Tích hợp sâu với LangChain và LangGraph, đánh giá | Developer 0 USD/chỗ (5k trace cơ bản); Plus 39 USD/chỗ |
| Arize Phoenix và AX | Phoenix mã nguồn mở; AX trên cloud | Tracing gốc OTel, đánh giá, phân tích drift | Phoenix tự host miễn phí; AX Pro 50 USD/tháng (50k span) |
| Datadog LLM Observability | Cloud (thuộc Datadog) | Kết nối trace LLM với APM, log và hạ tầng | Theo mức sử dụng; báo giá qua Datadog |
| Helicone | Cloud hoặc tự host | Ghi log qua proxy chỉ với một dòng cấu hình, có cache | Hobby miễn phí (10k yêu cầu); Pro 79 USD/tháng; Team 799 USD/tháng |
| Braintrust | Cloud | Quy trình ưu tiên đánh giá, thử nghiệm, chấm điểm | Starter 0 USD (xử lý 1 GB, 10k điểm); Pro 249 USD/tháng |
| Pydantic Logfire | Cloud | Observability OTel tổng quát, hỗ trợ Python và tracing agent rất tốt | Personal miễn phí (10 triệu bản ghi/tháng); Team 49 USD/tháng |
Cách đọc bảng này:
- Cần giữ dữ liệu trong môi trường của riêng bạn? Bắt đầu với Langfuse hoặc Arize Phoenix, cả hai đều có thể tự host.
- Đang trả tiền cho Datadog? Sản phẩm LLM Observability giữ trace AI ngay cạnh APM và log hiện có của bạn.
- Xây dựng trên LangChain hoặc LangGraph? LangSmith cần ít thiết lập nhất.
- Ưu tiên hàng đầu là đánh giá? Braintrust và LangSmith dẫn đầu về thử nghiệm và quy trình chấm điểm.
- Không muốn sửa mã? Các công cụ kiểu proxy như Helicone, hoặc log từ AI gateway của bạn, thu thập lưu lượng ở tầng mạng.
Cần xem xét gì ở một nền tảng AI observability
Hãy dùng checklist này khi dùng thử:
- Hỗ trợ OpenTelemetry. Nền tảng có nhận được trace OTLP với thuộc tính
gen_ai.*không, và bạn có xuất dữ liệu ra lại được không? - Tracing agent và công cụ. Nó có hiển thị span lồng nhau cho từng bước, lệnh gọi công cụ và lần thử lại, chứ không chỉ lệnh gọi mô hình cuối cùng?
- Theo dõi chi phí. Nó có tính chi phí mỗi yêu cầu từ token và giá thực tế của bạn, kể cả token cache và chiết khấu batch không?
- Đánh giá. Bạn có chạy được kiểm tra tự động (LLM làm giám khảo, regex, câu trả lời tham chiếu) trên trace production và cảnh báo khi điểm giảm không?
- Kiểm soát quyền riêng tư. Bạn có thể che hoặc băm prompt, đặt thời hạn lưu trữ và giới hạn người được xem nội dung gốc không?
- Đơn vị tính phí. Nhà cung cấp tính phí theo trace, span, "đơn vị", GB hoặc chỗ ngồi. Hãy ước tính khối lượng hằng tháng theo từng đơn vị trước khi so sánh.
- Tự host. Nếu liên quan đến dữ liệu chịu quản lý, hãy kiểm tra xem có tùy chọn tự host không và chi phí vận hành ra sao.
Gắn instrumentation cho lệnh gọi LLM trong Python bằng OpenTelemetry
Ví dụ dưới đây ghi lại một chat completion với các thuộc tính GenAI tiêu chuẩn và xuất nó tới bất kỳ endpoint OTLP nào (Langfuse, Phoenix, Logfire hoặc collector cục bộ). Mã gọi mô hình qua endpoint tương thích OpenAI, nên cùng một đoạn mã dùng được cho GPT, Claude, Gemini hoặc DeepSeek.
pip install openai opentelemetry-sdk opentelemetry-exporter-otlp
export OTEL_EXPORTER_OTLP_ENDPOINT="http://localhost:4318"   # your collector or vendor endpoint
export FLATKEY_API_KEY="sk-..."
import os, time
from openai import OpenAI
from opentelemetry import trace
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporter

provider = TracerProvider()
provider.add_span_processor(BatchSpanProcessor(OTLPSpanExporter()))
trace.set_tracer_provider(provider)
tracer = trace.get_tracer("support-bot")

client = OpenAI(api_key=os.environ["FLATKEY_API_KEY"],
                base_url="https://router.flatkey.ai/v1")

def answer(question: str, model: str = "claude-sonnet-5-5") -> str:
    with tracer.start_as_current_span(f"chat {model}") as span:
        span.set_attribute("gen_ai.operation.name", "chat")
        span.set_attribute("gen_ai.provider.name", "flatkey")
        span.set_attribute("gen_ai.request.model", model)
        t0 = time.time()
        r = client.chat.completions.create(
            model=model, max_tokens=300,
            messages=[{"role": "user", "content": question}])
        span.set_attribute("gen_ai.response.model", r.model)
        span.set_attribute("gen_ai.usage.input_tokens", r.usage.prompt_tokens)
        span.set_attribute("gen_ai.usage.output_tokens", r.usage.completion_tokens)
        span.set_attribute("gen_ai.response.finish_reasons", [r.choices[0].finish_reason])
        span.set_attribute("app.latency_ms", int((time.time() - t0) * 1000))
        return r.choices[0].message.content

print(answer("How do I reset my password?"))
provider.shutdown()  # flush spans before exit
Trong Node.js, cách làm tương tự với @opentelemetry/sdk-node:
import OpenAI from "openai";
import { trace } from "@opentelemetry/api";

const tracer = trace.getTracer("support-bot");
const client = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

export async function answer(question, model = "gpt-6.1-sol") {
  return tracer.startActiveSpan(`chat ${model}`, async (span) => {
    span.setAttributes({ "gen_ai.operation.name": "chat", "gen_ai.request.model": model });
    const r = await client.chat.completions.create({ model, messages: [{ role: "user", content: question }] });
    span.setAttributes({
      "gen_ai.response.model": r.model,
      "gen_ai.usage.input_tokens": r.usage.prompt_tokens,
      "gen_ai.usage.output_tokens": r.usage.completion_tokens,
    });
    span.end();
    return r.choices[0].message.content;
  });
}
Đừng đưa nội dung prompt và phản hồi vào thuộc tính span trừ khi chính sách quyền riêng tư cho phép; nhiều nhóm chỉ ghi giá trị băm hoặc bản đã che thông tin. Hướng dẫn ghi log payload của chúng tôi trình bày các mẫu che dữ liệu.
AI gateway cũng là một nguồn observability
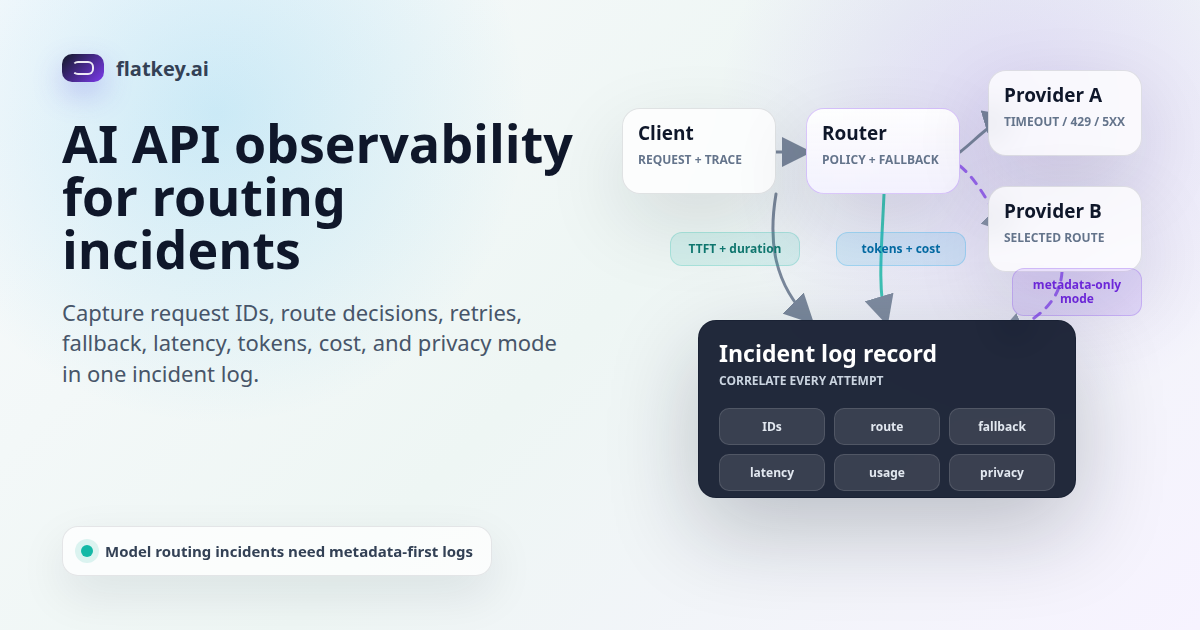
Nếu ứng dụng của bạn gọi mô hình qua AI gateway hoặc router, gateway đã thấy mọi yêu cầu, nên đây là điểm khởi đầu rẻ nhất. Nó thu thập dữ liệu ngay cả với các dịch vụ chưa được gắn instrumentation. Ví dụ, log sử dụng của Flatkey ghi lại thời điểm, mô hình, token đầu vào, token đầu ra, chi phí, API key đã che và trạng thái của mỗi lệnh gọi, có thể xuất ra CSV hoặc JSON, đồng thời hỗ trợ giới hạn chi tiêu hằng tháng và hạn mức theo nhóm (tài liệu sử dụng Flatkey, tháng 10/2026).
Một thiết lập thực tế kết hợp cả hai lớp:
| Lớp | Thấy rõ nhất điều gì | Ví dụ sử dụng |
|---|---|---|
| Log gateway | Mọi lệnh gọi mô hình, chi phí, trạng thái, lỗi nhà cung cấp, fallback | Chi tiêu theo key hoặc nhóm, tỷ lệ 429 và 5xx, sự cố nhà cung cấp |
| Trace ứng dụng | Ngữ cảnh nghiệp vụ, các bước agent, truy xuất, lệnh gọi công cụ | Vì sao yêu cầu của một người dùng thất bại hoặc trả lời kém |
| Đánh giá | Chất lượng câu trả lời theo thời gian | Phát hiện suy giảm sau khi đổi prompt hoặc mô hình |
Liên kết hai lớp bằng một request ID chung: gửi trace ID dưới dạng header hoặc trường metadata trong mỗi lệnh gọi mô hình để đi từ một dòng log gateway tới toàn bộ trace của ứng dụng. Xem LLM API observability: metric, trace và chi phí để biết bộ metric chúng tôi khuyên dùng, và dashboard KPI cho AI gateway để tham khảo bố cục biểu đồ.
Những metric quan trọng trong production
| Metric | Vì sao quan trọng | Gợi ý cảnh báo |
|---|---|---|
| Độ trễ p50 / p95 theo mô hình | Người dùng cảm nhận độ trễ đuôi | p95 vượt SLO trong 10 phút |
| Thời gian tới token đầu tiên | Trải nghiệm streaming | TTFT tăng ở một nhà cung cấp |
| Tỷ lệ lỗi theo trạng thái (429, 5xx, timeout) | Sự cố nhà cung cấp hoặc hạn mức | Tỷ lệ 429 trên 2% |
| Tỷ lệ fallback | Vấn đề độ tin cậy bị ẩn | Số fallback tăng gấp đôi so với hôm trước |
| Chi phí mỗi yêu cầu và mỗi người dùng | Kiểm soát ngân sách | Chi tiêu ngày vượt dự báo |
| Token mỗi yêu cầu | Prompt phình to và agent mất kiểm soát | Lần chạy agent vượt trần token |
| Điểm đánh giá | Suy giảm chất lượng | Điểm giảm sau khi deploy |
Phân bổ chi phí theo nhóm và môi trường để bộ phận tài chính có câu trả lời; hướng dẫn phân bổ chi phí và theo dõi chi phí theo môi trường trình bày các cách gắn tag. Về kế hoạch triển khai, hãy làm theo checklist triển khai AI observability.
Câu hỏi thường gặp
AI observability là gì?
AI observability là việc thu thập trace, metric, log và điểm chất lượng từ ứng dụng AI để thấy mô hình hoặc agent đã làm gì, kết quả có tốt không và tốn bao nhiêu chi phí. Nó bổ sung prompt, token, lệnh gọi công cụ và đánh giá vào việc giám sát truyền thống.
Nền tảng AI observability nào tốt nhất?
Không có một nền tảng tốt nhất duy nhất. Langfuse và Arize Phoenix phù hợp với nhóm muốn mã nguồn mở và tự host, LangSmith phù hợp với người dùng LangChain, Datadog phù hợp với nhóm đã dùng Datadog, còn Braintrust phù hợp với quy trình nặng về đánh giá. Hãy dùng thử hai lựa chọn với trace của chính bạn.
Có nền tảng AI observability miễn phí không?
Có. Tính đến tháng 10/2026, Langfuse Hobby (50k đơn vị mỗi tháng), LangSmith Developer (5k trace cơ bản), Helicone Hobby (10k yêu cầu), Braintrust Starter và Logfire Personal (10 triệu bản ghi) đều miễn phí, còn Langfuse và Arize Phoenix có thể tự host mà không mất phí giấy phép.
Giám sát LLM khác AI observability thế nào?
Giám sát theo dõi các ngưỡng định sẵn như độ trễ và tỷ lệ lỗi. Observability cho phép bạn điều tra chi tiết bất kỳ yêu cầu riêng lẻ nào, bao gồm prompt, lệnh gọi công cụ, mức dùng token và điểm chất lượng.
AI observability có hoạt động với OpenTelemetry không?
Có. Quy ước ngữ nghĩa GenAI của OpenTelemetry định nghĩa các thuộc tính tiêu chuẩn như gen_ai.request.model và gen_ai.usage.input_tokens, và phần lớn nền tảng đều nhận trace OTLP. Tính đến tháng 10/2026, các quy ước này vẫn ở trạng thái Development.
Observability cho AI tạo sinh là gì?
Đó là cùng một thực hành áp dụng cho mô hình tạo sinh: thu thập prompt, đầu ra, chi phí token, các bước agent và kết quả đánh giá để các nhóm có thể gỡ lỗi và cải thiện tính năng AI tạo sinh trong production.
Nguồn tham khảo
- Quy ước ngữ nghĩa GenAI của OpenTelemetry (tháng 10/2026)
- Giá Langfuse, giá LangSmith, giá Arize, giá Helicone, giá Braintrust, giá Logfire (tất cả kiểm tra ngày 24/10/2026)
- Tài liệu Datadog LLM Observability (tháng 10/2026)
- Arize Phoenix trên GitHub và Langfuse trên GitHub
- Khung quản lý rủi ro AI của NIST