Plataformas de observabilidad de IA: qué hacen y cómo elegir (2026)
Una plataforma de observabilidad de IA registra cada llamada al modelo, cada paso del agente y cada llamada a herramientas de tu aplicación (prompt, respuesta, tokens, coste, latencia y errores) para que puedas depurar, evaluar y controlar el gasto en producción. Las opciones líderes en octubre de 2026 son Langfuse, LangSmith, Arize (Phoenix y AX), Datadog LLM Observability, Helicone, Braintrust y Pydantic Logfire, y la mayoría acepta trazas de OpenTelemetry. Elige según dónde deben residir tus datos, cómo evalúas la calidad y cuánto pagarás por traza.
Esta guía explica qué es la observabilidad de IA, qué señales capturar, cómo se comparan las principales plataformas en funciones y precios publicados, y cómo instrumentar una aplicación en menos de 30 líneas de código. Los precios proceden de la página oficial de precios de cada proveedor, consultada el 24 de octubre de 2026.
¿Qué es la observabilidad de IA?
La observabilidad de IA es la práctica de recopilar trazas, métricas, logs y puntuaciones de calidad de los sistemas de IA para poder responder en todo momento a tres preguntas: ¿Qué hizo el modelo? ¿Fue buena la respuesta? ¿Cuánto costó? Amplía la monitorización clásica de aplicaciones, que vigila la disponibilidad y la latencia, con señales que solo importan en los modelos de lenguaje:
- Entradas y salidas: el prompt, el contexto recuperado y la respuesta generada.
- Uso de tokens y coste: tokens de entrada, de salida y en caché por solicitud, usuario y funcionalidad.
- Trazas de agentes: cada paso de razonamiento, llamada a herramienta y reintento en una ejecución de varios pasos.
- Calidad: puntuaciones de evaluadores, feedback de usuarios y marcas de alucinación o de incumplimiento de políticas.
- Metadatos del modelo y del proveedor: qué modelo respondió, por qué ruta y con qué parámetros.
La monitorización tradicional te dice que una solicitud tardó 9 segundos. La observabilidad de IA te dice que tardó 9 segundos porque el agente llamó tres veces a una herramienta de búsqueda, la segunda llamada al modelo recibió un 429 y el modelo de respaldo produjo una respuesta que no superó tu verificación de fundamentación (groundedness).
Monitorización vs observabilidad vs evaluación
| Práctica | Pregunta que responde | Resultado típico |
|---|---|---|
| Monitorización | ¿Está el sistema activo y dentro de los umbrales? | Dashboards, alertas de latencia y tasa de errores |
| Observabilidad | ¿Por qué esta solicitud concreta se comportó así? | Trazas con prompts, llamadas a herramientas, tokens y metadatos |
| Evaluación | ¿Es la salida correcta, segura y útil? | Puntuaciones de tests, jueces LLM o revisión humana |
Una plataforma moderna de observabilidad de IA combina las tres. El Marco de Gestión de Riesgos de IA del NIST también insiste en la medición y monitorización continuas de los sistemas de IA desplegados, por eso muchos equipos de gobernanza piden ahora estos registros.
El estándar abierto: convenciones GenAI de OpenTelemetry
Ya no necesitas un SDK propietario para capturar telemetría de IA. OpenTelemetry define convenciones semánticas para IA generativa que nombran los atributos estándar de las llamadas a modelos. En octubre de 2026 estas convenciones se mantienen en un repositorio semantic-conventions-genai dedicado y siguen marcadas como "Development", así que es posible que algunos nombres cambien.
| Atributo | Significado |
|---|---|
gen_ai.operation.name |
La operación, como chat o embeddings (obligatorio) |
gen_ai.provider.name |
El proveedor, como openai o anthropic (obligatorio) |
gen_ai.request.model |
Modelo solicitado por tu código |
gen_ai.response.model |
Modelo que respondió realmente |
gen_ai.usage.input_tokens / gen_ai.usage.output_tokens |
Recuento de tokens |
gen_ai.response.finish_reasons |
Por qué se detuvo la generación |
gen_ai.conversation.id |
Agrupa los turnos de una misma conversación |
Instrumenta una vez con estos atributos y podrás enviar las mismas trazas a Langfuse, Arize Phoenix, Datadog, Logfire, Grafana Tempo o cualquier otro backend compatible con OTLP. La propagación de contexto entre servicios sigue el estándar W3C Trace Context.
Comparativa de plataformas de observabilidad de IA
| Plataforma | Despliegue | Puntos fuertes | Precio de entrada publicado (oct. 2026) |
|---|---|---|---|
| Langfuse | Código abierto (autoalojado) o nube | Trazas, gestión de prompts, evaluaciones; núcleo con licencia MIT | Hobby gratis (50k unidades/mes); Core 29 $/mes; Pro 199 $/mes |
| LangSmith | Nube, híbrido o autoalojado en Enterprise | Integración profunda con LangChain y LangGraph, evaluaciones | Developer 0 $/asiento (5k trazas base); Plus 39 $/asiento |
| Arize Phoenix y AX | Phoenix de código abierto; AX en la nube | Trazas nativas OTel, evaluaciones, análisis de deriva | Phoenix gratis autoalojado; AX Pro 50 $/mes (50k spans) |
| Datadog LLM Observability | Nube (parte de Datadog) | Une trazas LLM con APM, logs e infraestructura | Por uso; presupuesto a través de Datadog |
| Helicone | Nube o autoalojado | Logging basado en proxy con una línea de configuración, caché | Hobby gratis (10k solicitudes); Pro 79 $/mes; Team 799 $/mes |
| Braintrust | Nube | Flujo centrado en evaluación, experimentos, puntuación | Starter 0 $ (1 GB procesado, 10k puntuaciones); Pro 249 $/mes |
| Pydantic Logfire | Nube | Observabilidad OTel general con muy buen soporte de Python y agentes | Personal gratis (10M registros/mes); Team 49 $/mes |
Cómo leer esta tabla:
- ¿Necesitas mantener los datos en tu propio entorno? Empieza por Langfuse o Arize Phoenix; ambos se pueden autoalojar.
- ¿Ya pagas Datadog? Su producto LLM Observability mantiene las trazas de IA junto a tu APM y tus logs.
- ¿Trabajas con LangChain o LangGraph? LangSmith requiere la configuración mínima.
- ¿La evaluación es la prioridad? Braintrust y LangSmith lideran en experimentos y flujos de puntuación.
- ¿Quieres cero cambios de código? Las herramientas tipo proxy como Helicone, o los logs de tu gateway de IA, capturan el tráfico en la capa de red.
Qué buscar en una plataforma de observabilidad de IA
Usa esta checklist durante la prueba:
- Soporte de OpenTelemetry. ¿Puede ingerir trazas OTLP con atributos
gen_ai.*y puedes volver a exportar tus datos? - Trazas de agentes y herramientas. ¿Muestra spans anidados para cada paso, llamada a herramienta y reintento, y no solo la llamada final al modelo?
- Seguimiento de costes. ¿Calcula el coste por solicitud a partir de los tokens y tus precios reales, incluidos tokens en caché y descuentos por lotes?
- Evaluaciones. ¿Puedes ejecutar verificaciones automáticas (LLM como juez, regex, respuestas de referencia) sobre trazas de producción y alertar si bajan las puntuaciones?
- Controles de privacidad. ¿Puedes ocultar o aplicar hash a los prompts, fijar periodos de retención y restringir quién ve el contenido en bruto?
- Unidad de facturación. Los proveedores cobran por traza, span, "unidad", GB o asiento. Estima tu volumen mensual en cada unidad antes de comparar.
- Autoalojamiento. Si hay datos regulados, comprueba que exista una opción autoalojada y cuánto cuesta operarla.
Instrumenta una llamada LLM en Python con OpenTelemetry
Este ejemplo registra una chat completion con los atributos GenAI estándar y la exporta a cualquier endpoint OTLP (Langfuse, Phoenix, Logfire o un collector local). Llama a los modelos a través de un endpoint compatible con OpenAI, así que el mismo código funciona con GPT, Claude, Gemini o DeepSeek.
pip install openai opentelemetry-sdk opentelemetry-exporter-otlp
export OTEL_EXPORTER_OTLP_ENDPOINT="http://localhost:4318"   # your collector or vendor endpoint
export FLATKEY_API_KEY="sk-..."
import os, time
from openai import OpenAI
from opentelemetry import trace
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporter

provider = TracerProvider()
provider.add_span_processor(BatchSpanProcessor(OTLPSpanExporter()))
trace.set_tracer_provider(provider)
tracer = trace.get_tracer("support-bot")

client = OpenAI(api_key=os.environ["FLATKEY_API_KEY"],
                base_url="https://router.flatkey.ai/v1")

def answer(question: str, model: str = "claude-sonnet-5-5") -> str:
    with tracer.start_as_current_span(f"chat {model}") as span:
        span.set_attribute("gen_ai.operation.name", "chat")
        span.set_attribute("gen_ai.provider.name", "flatkey")
        span.set_attribute("gen_ai.request.model", model)
        t0 = time.time()
        r = client.chat.completions.create(
            model=model, max_tokens=300,
            messages=[{"role": "user", "content": question}])
        span.set_attribute("gen_ai.response.model", r.model)
        span.set_attribute("gen_ai.usage.input_tokens", r.usage.prompt_tokens)
        span.set_attribute("gen_ai.usage.output_tokens", r.usage.completion_tokens)
        span.set_attribute("gen_ai.response.finish_reasons", [r.choices[0].finish_reason])
        span.set_attribute("app.latency_ms", int((time.time() - t0) * 1000))
        return r.choices[0].message.content

print(answer("How do I reset my password?"))
provider.shutdown()  # flush spans before exit
En Node.js el patrón es el mismo con @opentelemetry/sdk-node:
import OpenAI from "openai";
import { trace } from "@opentelemetry/api";

const tracer = trace.getTracer("support-bot");
const client = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

export async function answer(question, model = "gpt-6.1-sol") {
  return tracer.startActiveSpan(`chat ${model}`, async (span) => {
    span.setAttributes({ "gen_ai.operation.name": "chat", "gen_ai.request.model": model });
    const r = await client.chat.completions.create({ model, messages: [{ role: "user", content: question }] });
    span.setAttributes({
      "gen_ai.response.model": r.model,
      "gen_ai.usage.input_tokens": r.usage.prompt_tokens,
      "gen_ai.usage.output_tokens": r.usage.completion_tokens,
    });
    span.end();
    return r.choices[0].message.content;
  });
}
No incluyas el cuerpo de prompts y respuestas en los atributos de los spans salvo que tu política de privacidad lo permita; muchos equipos registran un hash o una copia anonimizada. Nuestra guía de logging de payloads cubre patrones de anonimización.
Tu gateway de IA también es una fuente de observabilidad
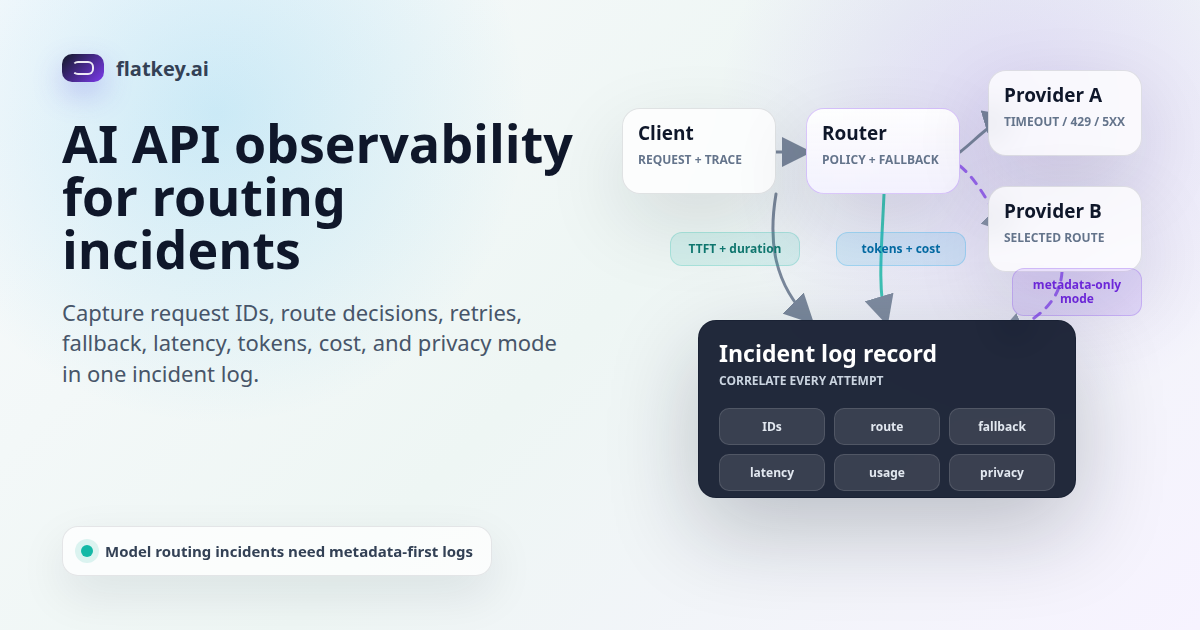
Si tu aplicación llama a los modelos a través de un gateway o router de IA, el gateway ya ve cada solicitud, por lo que es el punto de partida más barato. Captura datos incluso de servicios que aún no se han instrumentado. Los logs de uso de Flatkey, por ejemplo, registran la marca de tiempo, el modelo, los tokens de entrada y de salida, el coste, la API key enmascarada y el estado de cada llamada, se pueden exportar en CSV o JSON y admiten límites de gasto mensual y cuotas por grupo (documentación de uso de Flatkey, octubre de 2026).
Una configuración práctica combina ambas capas:
| Capa | Lo que mejor ve | Ejemplo de uso |
|---|---|---|
| Logs del gateway | Cada llamada al modelo, coste, estado, errores del proveedor, fallbacks | Gasto por key o equipo, tasas de 429 y 5xx, caídas de proveedores |
| Trazas de la aplicación | Contexto de negocio, pasos del agente, recuperación, llamadas a herramientas | Por qué la solicitud de un usuario falló o respondió mal |
| Evaluaciones | Calidad de las respuestas a lo largo del tiempo | Detectar regresiones tras cambiar un prompt o un modelo |
Une ambas con un ID de solicitud compartido: envía tu trace ID como cabecera o campo de metadatos en cada llamada al modelo para pasar de una fila del log del gateway a la traza completa de la aplicación. Consulta observabilidad de APIs LLM: métricas, trazas y costes para el conjunto de métricas que recomendamos, y el dashboard de KPI del gateway de IA para la disposición de los gráficos.
Las métricas que importan en producción
| Métrica | Por qué importa | Idea de alerta |
|---|---|---|
| Latencia p50 / p95 por modelo | Los usuarios notan la latencia de cola | p95 por encima de tu SLO durante 10 minutos |
| Tiempo hasta el primer token | Experiencia de streaming | TTFT en aumento en un solo proveedor |
| Tasa de errores por estado (429, 5xx, timeout) | Problemas del proveedor o de cuota | Tasa de 429 superior al 2 % |
| Tasa de fallback | Problemas de fiabilidad ocultos | Fallbacks que se duplican de un día a otro |
| Coste por solicitud y por usuario | Control del presupuesto | Gasto diario por encima de la previsión |
| Tokens por solicitud | Prompts inflados y agentes descontrolados | Ejecuciones de agentes por encima de un límite de tokens |
| Puntuación de evaluación | Regresiones de calidad | Caída de la puntuación tras un despliegue |
Atribuye los costes por equipo y entorno para que finanzas tenga respuestas; la guía de atribución de costes y el seguimiento de costes por entorno muestran esquemas de etiquetado. Para el plan de despliegue, sigue la checklist de implementación de observabilidad de IA.
Preguntas frecuentes
¿Qué es la observabilidad de IA?
La observabilidad de IA consiste en recopilar trazas, métricas, logs y puntuaciones de calidad de las aplicaciones de IA para ver qué hizo un modelo o un agente, si el resultado fue bueno y cuánto costó. Añade prompts, tokens, llamadas a herramientas y evaluaciones a la monitorización tradicional.
¿Cuál es la mejor plataforma de observabilidad de IA?
No hay una única mejor plataforma. Langfuse y Arize Phoenix encajan con equipos que quieren código abierto y autoalojamiento, LangSmith con usuarios de LangChain, Datadog con equipos que ya usan Datadog y Braintrust con flujos centrados en evaluación. Prueba dos opciones con tus propias trazas.
¿Existe una plataforma de observabilidad de IA gratuita?
Sí. En octubre de 2026, Langfuse Hobby (50k unidades al mes), LangSmith Developer (5k trazas base), Helicone Hobby (10k solicitudes), Braintrust Starter y Logfire Personal (10M registros) son gratuitos, y Langfuse y Arize Phoenix se pueden autoalojar sin coste de licencia.
¿Qué diferencia hay entre la monitorización de LLM y la observabilidad de IA?
La monitorización vigila umbrales predefinidos como la latencia y la tasa de errores. La observabilidad te permite investigar en detalle cualquier solicitud individual, incluidos prompts, llamadas a herramientas, uso de tokens y puntuaciones de calidad.
¿La observabilidad de IA funciona con OpenTelemetry?
Sí. Las convenciones semánticas GenAI de OpenTelemetry definen atributos estándar como gen_ai.request.model y gen_ai.usage.input_tokens, y la mayoría de las plataformas aceptan trazas OTLP. En octubre de 2026 las convenciones siguen en estado Development.
¿Qué es la observabilidad de IA generativa?
Es la misma práctica aplicada a modelos generativos: capturar prompts, salidas, costes de tokens, pasos de agentes y resultados de evaluación para que los equipos puedan depurar y mejorar las funciones de IA generativa en producción.
Fuentes
- Convenciones semánticas GenAI de OpenTelemetry (octubre de 2026)
- Precios de Langfuse, precios de LangSmith, precios de Arize, precios de Helicone, precios de Braintrust, precios de Logfire (todos consultados el 24 de octubre de 2026)
- Documentación de Datadog LLM Observability (octubre de 2026)
- Arize Phoenix en GitHub y Langfuse en GitHub
- Marco de Gestión de Riesgos de IA del NIST