AIオブザーバビリティプラットフォームとは?機能と選び方(2026年)
AIオブザーバビリティプラットフォームは、アプリケーション内のすべてのモデル呼び出し、エージェントのステップ、ツール呼び出し(プロンプト、レスポンス、トークン、コスト、レイテンシ、エラー)を記録し、本番環境でのデバッグ、評価、コスト管理を可能にします。 2026年10月時点の主な選択肢は Langfuse、LangSmith、Arize(Phoenix と AX)、Datadog LLM Observability、Helicone、Braintrust、Pydantic Logfire で、その多くが OpenTelemetry のトレースを受け付けます。データをどこに保存する必要があるか、品質をどう評価するか、トレースあたりいくら払うかを基準に選びましょう。
このガイドでは、AIオブザーバビリティとは何か、取得すべきシグナル、主要プラットフォームの機能と公開料金の比較、そして30行未満のコードでアプリを計装する方法を解説します。料金は2026年10月24日時点の各ベンダー公式料金ページから引用しています。
AIオブザーバビリティとは?
AIオブザーバビリティとは、AIシステムからトレース、メトリクス、ログ、品質スコアを収集し、いつでも次の3つの問いに答えられるようにする取り組みです。モデルは何をしたのか?回答は良かったのか?いくらかかったのか? 稼働状況やレイテンシを追う従来のアプリケーション監視に、言語モデルならではのシグナルを加えたものです。
- 入力と出力: プロンプト、検索で取得したコンテキスト、生成された回答。
- トークン使用量とコスト: リクエスト、ユーザー、機能ごとの入力・出力・キャッシュトークン。
- エージェントのトレース: マルチステップ実行における各推論ステップ、ツール呼び出し、リトライ。
- 品質: 評価器のスコア、ユーザーフィードバック、ハルシネーションやポリシー違反のフラグ。
- モデルとプロバイダーのメタデータ: どのモデルが、どのルートで、どのパラメータで回答したか。
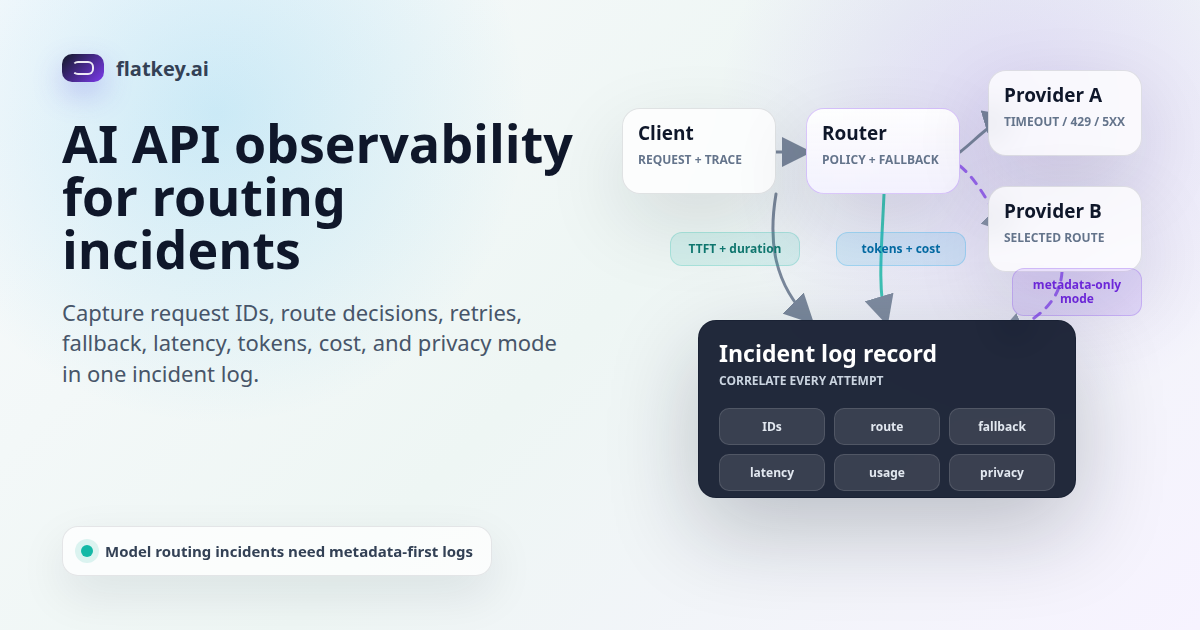
従来の監視では「リクエストに9秒かかった」ことしか分かりません。AIオブザーバビリティなら、エージェントが検索ツールを3回呼び出し、2回目のモデル呼び出しで429が返り、フォールバックモデルの回答がグラウンディングチェック(groundedness)に失敗したため9秒かかった、と分かります。
監視・オブザーバビリティ・評価の違い
| 取り組み | 答える問い | 典型的なアウトプット |
|---|---|---|
| 監視 | システムは稼働していて、しきい値内に収まっているか? | ダッシュボード、レイテンシやエラー率のアラート |
| オブザーバビリティ | この特定のリクエストはなぜこう動いたのか? | プロンプト、ツール呼び出し、トークン、メタデータを含むトレース |
| 評価 | 出力は正確・安全・有用か? | テスト、LLMジャッジ、人手レビューによるスコア |
最新のAIオブザーバビリティプラットフォームは、この3つを組み合わせています。NIST AIリスクマネジメントフレームワークも、導入済みAIシステムの継続的な測定と監視を重視しており、多くのガバナンスチームがこうした記録を求めるようになっています。
オープン標準:OpenTelemetry GenAI セマンティック規約
AIテレメトリの取得に、ベンダー固有のSDKはもう必要ありません。OpenTelemetry は、モデル呼び出しの標準属性名を定めた生成AI向けセマンティック規約を定義しています。2026年10月時点で、この規約は専用の semantic-conventions-genai リポジトリで管理されており、ステータスはまだ「Development」のため、一部の名前は変わる可能性があります。
| 属性 | 意味 |
|---|---|
gen_ai.operation.name |
操作の種類(chat、embeddings など、必須) |
gen_ai.provider.name |
プロバイダー(openai、anthropic など、必須) |
gen_ai.request.model |
コードがリクエストしたモデル |
gen_ai.response.model |
実際に回答したモデル |
gen_ai.usage.input_tokens / gen_ai.usage.output_tokens |
トークン数 |
gen_ai.response.finish_reasons |
生成が停止した理由 |
gen_ai.conversation.id |
1つの会話のターンをまとめる |
これらの属性で一度計装すれば、同じトレースを Langfuse、Arize Phoenix、Datadog、Logfire、Grafana Tempo など、OTLP対応のあらゆるバックエンドに送信できます。サービス間のコンテキスト伝播は W3C Trace Context 標準に従います。
AIオブザーバビリティプラットフォーム比較
| プラットフォーム | デプロイ形態 | 強み | 公開されているエントリー料金(2026年10月) |
|---|---|---|---|
| Langfuse | オープンソース(セルフホスト)またはクラウド | トレーシング、プロンプト管理、評価。コアはMITライセンス | Hobby 無料(月5万ユニット)、Core 月29ドル、Pro 月199ドル |
| LangSmith | クラウド、ハイブリッド、Enterprise ではセルフホスト | LangChain・LangGraph との深い統合、評価 | Developer 1シート0ドル(ベーストレース5千件)、Plus 1シート39ドル |
| Arize Phoenix と AX | Phoenix はオープンソース、AX はクラウド | OTelネイティブのトレーシング、評価、ドリフト分析 | Phoenix はセルフホスト無料、AX Pro 月50ドル(5万スパン) |
| Datadog LLM Observability | クラウド(Datadog の一部) | LLMトレースを APM、ログ、インフラと紐づけ | 従量課金。Datadog に見積もり依頼 |
| Helicone | クラウドまたはセルフホスト | 設定1行で使えるプロキシ型ロギング、キャッシュ | Hobby 無料(1万リクエスト)、Pro 月79ドル、Team 月799ドル |
| Braintrust | クラウド | 評価中心のワークフロー、実験、スコアリング | Starter 0ドル(処理量1 GB、スコア1万件)、Pro 月249ドル |
| Pydantic Logfire | クラウド | Python とエージェントのトレーシングに強い汎用OTelオブザーバビリティ | Personal 無料(月1,000万レコード)、Team 月49ドル |
この表の読み方:
- データを自社環境に置く必要がある場合: セルフホスト可能な Langfuse か Arize Phoenix から始めましょう。
- すでに Datadog を契約している場合: LLM Observability なら、AIトレースを既存の APM やログと並べて扱えます。
- LangChain や LangGraph で構築している場合: LangSmith が最も設定の手間が少なく済みます。
- 評価が最優先の場合: 実験とスコアリングのワークフローでは Braintrust と LangSmith がリードしています。
- コードを一切変更したくない場合: Helicone のようなプロキシ型ツールや、AIゲートウェイのログがネットワーク層でトラフィックを捕捉します。
AIオブザーバビリティプラットフォームの選定ポイント
トライアル時は次のチェックリストを使いましょう。
- OpenTelemetry 対応。
gen_ai.*属性付きの OTLP トレースを取り込めるか。データを再エクスポートできるか。 - エージェントとツールのトレーシング。 最終的なモデル呼び出しだけでなく、各ステップ、ツール呼び出し、リトライのネストしたスパンを表示できるか。
- コスト追跡。 キャッシュトークンやバッチ割引も含め、トークン数と実際の価格からリクエストごとのコストを算出できるか。
- 評価。 本番トレースに自動チェック(LLMジャッジ、正規表現、参照回答)を実行し、スコア低下時にアラートを出せるか。
- プライバシー管理。 プロンプトのマスキングやハッシュ化、保持期間の設定、生データの閲覧権限の制限ができるか。
- 課金単位。 ベンダーによってトレース、スパン、「ユニット」、GB、シート単位で課金されます。比較する前に、各単位で月間ボリュームを見積もりましょう。
- セルフホスト。 規制対象のデータを扱う場合は、セルフホストの選択肢があるか、その運用コストはいくらかを確認しましょう。
OpenTelemetry で Python の LLM 呼び出しを計装する
次の例は、標準の GenAI 属性で1回の chat completion を記録し、任意の OTLP エンドポイント(Langfuse、Phoenix、Logfire、またはローカルの collector)にエクスポートします。OpenAI 互換エンドポイント経由でモデルを呼び出すため、同じコードで GPT、Claude、Gemini、DeepSeek に対応できます。
pip install openai opentelemetry-sdk opentelemetry-exporter-otlp
export OTEL_EXPORTER_OTLP_ENDPOINT="http://localhost:4318"   # your collector or vendor endpoint
export FLATKEY_API_KEY="sk-..."
import os, time
from openai import OpenAI
from opentelemetry import trace
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporter

provider = TracerProvider()
provider.add_span_processor(BatchSpanProcessor(OTLPSpanExporter()))
trace.set_tracer_provider(provider)
tracer = trace.get_tracer("support-bot")

client = OpenAI(api_key=os.environ["FLATKEY_API_KEY"],
                base_url="https://router.flatkey.ai/v1")

def answer(question: str, model: str = "claude-sonnet-5-5") -> str:
    with tracer.start_as_current_span(f"chat {model}") as span:
        span.set_attribute("gen_ai.operation.name", "chat")
        span.set_attribute("gen_ai.provider.name", "flatkey")
        span.set_attribute("gen_ai.request.model", model)
        t0 = time.time()
        r = client.chat.completions.create(
            model=model, max_tokens=300,
            messages=[{"role": "user", "content": question}])
        span.set_attribute("gen_ai.response.model", r.model)
        span.set_attribute("gen_ai.usage.input_tokens", r.usage.prompt_tokens)
        span.set_attribute("gen_ai.usage.output_tokens", r.usage.completion_tokens)
        span.set_attribute("gen_ai.response.finish_reasons", [r.choices[0].finish_reason])
        span.set_attribute("app.latency_ms", int((time.time() - t0) * 1000))
        return r.choices[0].message.content

print(answer("How do I reset my password?"))
provider.shutdown()  # flush spans before exit
Node.js でも @opentelemetry/sdk-node を使って同じパターンで実装できます。
import OpenAI from "openai";
import { trace } from "@opentelemetry/api";

const tracer = trace.getTracer("support-bot");
const client = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

export async function answer(question, model = "gpt-6.1-sol") {
  return tracer.startActiveSpan(`chat ${model}`, async (span) => {
    span.setAttributes({ "gen_ai.operation.name": "chat", "gen_ai.request.model": model });
    const r = await client.chat.completions.create({ model, messages: [{ role: "user", content: question }] });
    span.setAttributes({
      "gen_ai.response.model": r.model,
      "gen_ai.usage.input_tokens": r.usage.prompt_tokens,
      "gen_ai.usage.output_tokens": r.usage.completion_tokens,
    });
    span.end();
    return r.choices[0].message.content;
  });
}
プライバシーポリシーで許可されていない限り、プロンプトやレスポンスの本文はスパン属性に含めないでください。多くのチームはハッシュ値やマスキング済みのコピーを記録しています。マスキングのパターンはペイロードロギングガイドで解説しています。
AIゲートウェイもオブザーバビリティのデータソースになる
アプリが AIゲートウェイやルーター経由でモデルを呼び出している場合、ゲートウェイはすでにすべてのリクエストを把握しているため、最も低コストな出発点になります。まだ計装されていないサービスのデータも取得できます。たとえば Flatkey の利用ログは、呼び出しごとのタイムスタンプ、モデル、入力トークン、出力トークン、コスト、マスクされた APIキー、ステータスを記録し、CSV または JSON でエクスポートでき、月間の支出上限やグループ別クォータにも対応しています(Flatkey 利用状況ドキュメント、2026年10月)。
実用的な構成は、2つのレイヤーを組み合わせることです。
| レイヤー | 最も得意とする観測対象 | 活用例 |
|---|---|---|
| ゲートウェイログ | すべてのモデル呼び出し、コスト、ステータス、プロバイダーエラー、フォールバック | キーやチーム別の支出、429・5xx の比率、プロバイダー障害 |
| アプリケーショントレース | ビジネスコンテキスト、エージェントのステップ、検索、ツール呼び出し | 特定ユーザーのリクエストが失敗した、または回答の質が低かった理由 |
| 評価 | 時系列での回答品質 | プロンプトやモデル変更後の品質低下の検知 |
共通のリクエストIDで両者を紐づけます。モデル呼び出しのたびにトレースIDをヘッダーまたはメタデータフィールドとして送信すれば、ゲートウェイログの1行からアプリケーションの完全なトレースへたどれます。推奨するメトリクスセットは LLM API オブザーバビリティ:メトリクス、トレース、コストを、グラフのレイアウトは AIゲートウェイ KPI ダッシュボードを参照してください。
本番環境で重要なメトリクス
| メトリクス | 重要な理由 | アラート例 |
|---|---|---|
| モデル別 p50 / p95 レイテンシ | ユーザーはテールレイテンシを体感する | p95 が10分間 SLO を超過 |
| 最初のトークンまでの時間 | ストリーミング体験 | 特定プロバイダーの TTFT が上昇 |
| ステータス別エラー率(429、5xx、タイムアウト) | プロバイダーやクォータの問題 | 429 の比率が2%超 |
| フォールバック率 | 隠れた信頼性の問題 | フォールバックが前日比で倍増 |
| リクエスト単価・ユーザー単価 | 予算管理 | 日次支出が予測を超過 |
| リクエストあたりのトークン数 | プロンプトの肥大化や暴走するエージェント | エージェント実行がトークン上限を超過 |
| 評価スコア | 品質の低下 | デプロイ後のスコア低下 |
財務部門の疑問に答えられるよう、コストはチームや環境ごとに配分しましょう。タグ付けの方法はコスト配分ガイドと環境別コスト追跡で紹介しています。導入計画は AIオブザーバビリティ導入チェックリストに沿って進めてください。
よくある質問
AIオブザーバビリティとは?
AIオブザーバビリティとは、AIアプリケーションからトレース、メトリクス、ログ、品質スコアを収集し、モデルやエージェントが何をしたか、結果は良かったか、いくらかかったかを把握することです。従来の監視にプロンプト、トークン、ツール呼び出し、評価を加えたものです。
最適なAIオブザーバビリティプラットフォームは?
唯一の正解はありません。オープンソースとセルフホストを求めるチームには Langfuse と Arize Phoenix、LangChain ユーザーには LangSmith、すでに Datadog を使っているチームには Datadog、評価中心のワークフローには Braintrust が向いています。自社のトレースで2つを試してみましょう。
無料のAIオブザーバビリティプラットフォームはありますか?
あります。2026年10月時点で、Langfuse Hobby(月5万ユニット)、LangSmith Developer(ベーストレース5千件)、Helicone Hobby(1万リクエスト)、Braintrust Starter、Logfire Personal(1,000万レコード)は無料で、Langfuse と Arize Phoenix はライセンス費用なしでセルフホストできます。
LLM監視とAIオブザーバビリティの違いは?
監視はレイテンシやエラー率など、あらかじめ定めたしきい値を見張るものです。オブザーバビリティでは、プロンプト、ツール呼び出し、トークン使用量、品質スコアを含め、個々のリクエストを詳細に調査できます。
AIオブザーバビリティは OpenTelemetry に対応していますか?
対応しています。OpenTelemetry の GenAI セマンティック規約は gen_ai.request.model や gen_ai.usage.input_tokens などの標準属性を定義しており、ほとんどのプラットフォームが OTLP トレースを受け付けます。2026年10月時点で、規約のステータスはまだ Development です。
生成AIオブザーバビリティとは?
同じ取り組みを生成モデルに適用したものです。プロンプト、出力、トークンコスト、エージェントのステップ、評価結果を取得し、本番環境で生成AI機能をデバッグ・改善できるようにします。
出典
- OpenTelemetry GenAI セマンティック規約(2026年10月)
- Langfuse 料金、LangSmith 料金、Arize 料金、Helicone 料金、Braintrust 料金、Logfire 料金(いずれも2026年10月24日確認)
- Datadog LLM Observability ドキュメント(2026年10月)
- GitHub の Arize Phoenix と GitHub の Langfuse
- NIST AIリスクマネジメントフレームワーク