AI 可观测性平台:作用与选型指南(2026)
AI 可观测性平台会记录应用中的每一次模型调用、智能体步骤和工具调用(提示词、响应、Token、成本、延迟和错误),帮助你在生产环境中排查问题、评估质量并控制支出。 截至 2026 年 10 月,主流选择包括 Langfuse、LangSmith、Arize(Phoenix 和 AX)、Datadog LLM Observability、Helicone、Braintrust 和 Pydantic Logfire,其中大多数都支持 OpenTelemetry 链路追踪。选型时主要看三点:数据必须存放在哪里、如何评估质量,以及每条 trace 要付多少钱。
本文介绍什么是 AI 可观测性、应采集哪些信号、主流平台在功能和公开价格上的对比,以及如何用不到 30 行代码为应用接入埋点。价格均取自各厂商官方定价页,查询日期为 2026 年 10 月 24 日。
什么是 AI 可观测性?
AI 可观测性是指从 AI 系统中采集 trace、指标、日志和质量评分,让你随时能回答三个问题:模型做了什么?答案好不好?花了多少钱? 它在传统应用监控(关注可用性和延迟)的基础上,加入了只对大语言模型有意义的信号:
- 输入与输出: 提示词、检索到的上下文以及生成的答案。
- Token 用量与成本: 按请求、用户和功能统计的输入、输出和缓存 Token。
- 智能体 trace: 多步骤运行中的每个推理步骤、工具调用和重试。
- 质量: 评估器评分、用户反馈,以及幻觉或策略违规标记。
- 模型与供应商元数据: 由哪个模型回答、走了哪条路由、使用了哪些参数。
传统监控只告诉你一个请求花了 9 秒。AI 可观测性则会告诉你:之所以花了 9 秒,是因为智能体调用了三次搜索工具,第二次模型调用遇到 429,而回退模型生成的答案没有通过你的事实依据(groundedness)检查。
监控、可观测性与评估的区别
| 实践 | 回答的问题 | 典型产出 |
|---|---|---|
| 监控 | 系统是否在线、是否在阈值内? | 仪表盘、延迟和错误率告警 |
| 可观测性 | 这个具体请求为什么会这样表现? | 包含提示词、工具调用、Token 和元数据的 trace |
| 评估 | 输出是否正确、安全、有用? | 来自测试、LLM 评审或人工审核的评分 |
现代 AI 可观测性平台会把这三者结合起来。NIST AI 风险管理框架也强调要对已部署的 AI 系统进行持续测量和监控,这也是越来越多治理团队要求保留这些记录的原因。
开放标准:OpenTelemetry GenAI 语义约定
采集 AI 遥测数据已不再需要绑定某个厂商的 SDK。OpenTelemetry 定义了生成式 AI 语义约定,为模型调用规定了标准属性名。截至 2026 年 10 月,这些约定由专门的 semantic-conventions-genai 仓库维护,状态仍为 "Development",因此部分名称可能还会变化。
| 属性 | 含义 |
|---|---|
gen_ai.operation.name |
操作类型,如 chat 或 embeddings(必填) |
gen_ai.provider.name |
供应商,如 openai 或 anthropic(必填) |
gen_ai.request.model |
代码中请求的模型 |
gen_ai.response.model |
实际作答的模型 |
gen_ai.usage.input_tokens / gen_ai.usage.output_tokens |
Token 数量 |
gen_ai.response.finish_reasons |
生成停止的原因 |
gen_ai.conversation.id |
将同一对话的多轮归为一组 |
用这些属性埋点一次,就能把同一份 trace 发送到 Langfuse、Arize Phoenix、Datadog、Logfire、Grafana Tempo 或任何兼容 OTLP 的后端。跨服务的上下文传播遵循 W3C Trace Context 标准。
AI 可观测性平台对比
| 平台 | 部署方式 | 优势 | 公开入门价格(2026 年 10 月) |
|---|---|---|---|
| Langfuse | 开源(自托管)或云服务 | 链路追踪、提示词管理、评估;核心代码 MIT 许可 | Hobby 免费(每月 5 万 units);Core 每月 29 美元;Pro 每月 199 美元 |
| LangSmith | 云、混合部署,Enterprise 可自托管 | 与 LangChain、LangGraph 深度集成,支持评估 | Developer 每席位 0 美元(5k 基础 trace);Plus 每席位 39 美元 |
| Arize Phoenix 与 AX | Phoenix 开源;AX 云服务 | 原生 OTel 追踪、评估、漂移分析 | Phoenix 自托管免费;AX Pro 每月 50 美元(5 万 span) |
| Datadog LLM Observability | 云(Datadog 的一部分) | 将 LLM trace 与 APM、日志和基础设施关联 | 按用量计费;需向 Datadog 询价 |
| Helicone | 云或自托管 | 基于代理的日志记录,一行配置即可接入,支持缓存 | Hobby 免费(1 万次请求);Pro 每月 79 美元;Team 每月 799 美元 |
| Braintrust | 云 | 以评估为先的工作流、实验和打分 | Starter 0 美元(处理 1 GB,1 万次评分);Pro 每月 249 美元 |
| Pydantic Logfire | 云 | 通用 OTel 可观测性,对 Python 和智能体追踪支持出色 | Personal 免费(每月 1000 万条记录);Team 每月 49 美元 |
如何解读这张表:
- 数据必须留在自己的环境中? 从 Langfuse 或 Arize Phoenix 开始,两者都可以自托管。
- 已经在付费使用 Datadog? 它的 LLM Observability 产品能让 AI trace 与现有 APM 和日志放在一起。
- 基于 LangChain 或 LangGraph 构建? LangSmith 的接入成本最低。
- 评估是首要任务? Braintrust 和 LangSmith 在实验和打分工作流上领先。
- 不想改代码? Helicone 这类代理式工具,或 AI 网关自带的日志,可以在网络层捕获流量。
选择 AI 可观测性平台时要看什么
试用时可以参考这份清单:
- OpenTelemetry 支持。 能否接收带
gen_ai.*属性的 OTLP trace?能否把数据再导出? - 智能体与工具追踪。 是否会为每个步骤、工具调用和重试展示嵌套 span,而不只是最终的模型调用?
- 成本追踪。 能否根据 Token 和你的真实价格计算每个请求的成本,包括缓存 Token 和批处理折扣?
- 评估。 能否对生产 trace 运行自动化检查(LLM 评审、正则、参考答案),并在分数下降时告警?
- 隐私控制。 能否对提示词脱敏或哈希、设置保留期限,并限制谁能看到原始内容?
- 计费单位。 厂商可能按 trace、span、"unit"、GB 或席位计费。比较之前,先按各单位估算你的月用量。
- 自托管。 如果涉及受监管数据,确认是否有自托管选项以及运行成本。
用 OpenTelemetry 为 Python 中的 LLM 调用埋点
下面的示例用标准 GenAI 属性记录一次 chat completion,并导出到任意 OTLP 端点(Langfuse、Phoenix、Logfire 或本地 collector)。它通过 OpenAI 兼容端点调用模型,因此同一段代码适用于 GPT、Claude、Gemini 或 DeepSeek。
pip install openai opentelemetry-sdk opentelemetry-exporter-otlp
export OTEL_EXPORTER_OTLP_ENDPOINT="http://localhost:4318"   # your collector or vendor endpoint
export FLATKEY_API_KEY="sk-..."
import os, time
from openai import OpenAI
from opentelemetry import trace
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporter

provider = TracerProvider()
provider.add_span_processor(BatchSpanProcessor(OTLPSpanExporter()))
trace.set_tracer_provider(provider)
tracer = trace.get_tracer("support-bot")

client = OpenAI(api_key=os.environ["FLATKEY_API_KEY"],
                base_url="https://router.flatkey.ai/v1")

def answer(question: str, model: str = "claude-sonnet-5-5") -> str:
    with tracer.start_as_current_span(f"chat {model}") as span:
        span.set_attribute("gen_ai.operation.name", "chat")
        span.set_attribute("gen_ai.provider.name", "flatkey")
        span.set_attribute("gen_ai.request.model", model)
        t0 = time.time()
        r = client.chat.completions.create(
            model=model, max_tokens=300,
            messages=[{"role": "user", "content": question}])
        span.set_attribute("gen_ai.response.model", r.model)
        span.set_attribute("gen_ai.usage.input_tokens", r.usage.prompt_tokens)
        span.set_attribute("gen_ai.usage.output_tokens", r.usage.completion_tokens)
        span.set_attribute("gen_ai.response.finish_reasons", [r.choices[0].finish_reason])
        span.set_attribute("app.latency_ms", int((time.time() - t0) * 1000))
        return r.choices[0].message.content

print(answer("How do I reset my password?"))
provider.shutdown()  # flush spans before exit
在 Node.js 中,用 @opentelemetry/sdk-node 的做法相同:
import OpenAI from "openai";
import { trace } from "@opentelemetry/api";

const tracer = trace.getTracer("support-bot");
const client = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

export async function answer(question, model = "gpt-6.1-sol") {
  return tracer.startActiveSpan(`chat ${model}`, async (span) => {
    span.setAttributes({ "gen_ai.operation.name": "chat", "gen_ai.request.model": model });
    const r = await client.chat.completions.create({ model, messages: [{ role: "user", content: question }] });
    span.setAttributes({
      "gen_ai.response.model": r.model,
      "gen_ai.usage.input_tokens": r.usage.prompt_tokens,
      "gen_ai.usage.output_tokens": r.usage.completion_tokens,
    });
    span.end();
    return r.choices[0].message.content;
  });
}
除非隐私政策允许,否则不要把提示词和响应正文放进 span 属性;很多团队改为记录哈希值或脱敏副本。我们的请求体日志指南介绍了常见的脱敏模式。
AI 网关本身也是可观测性数据源
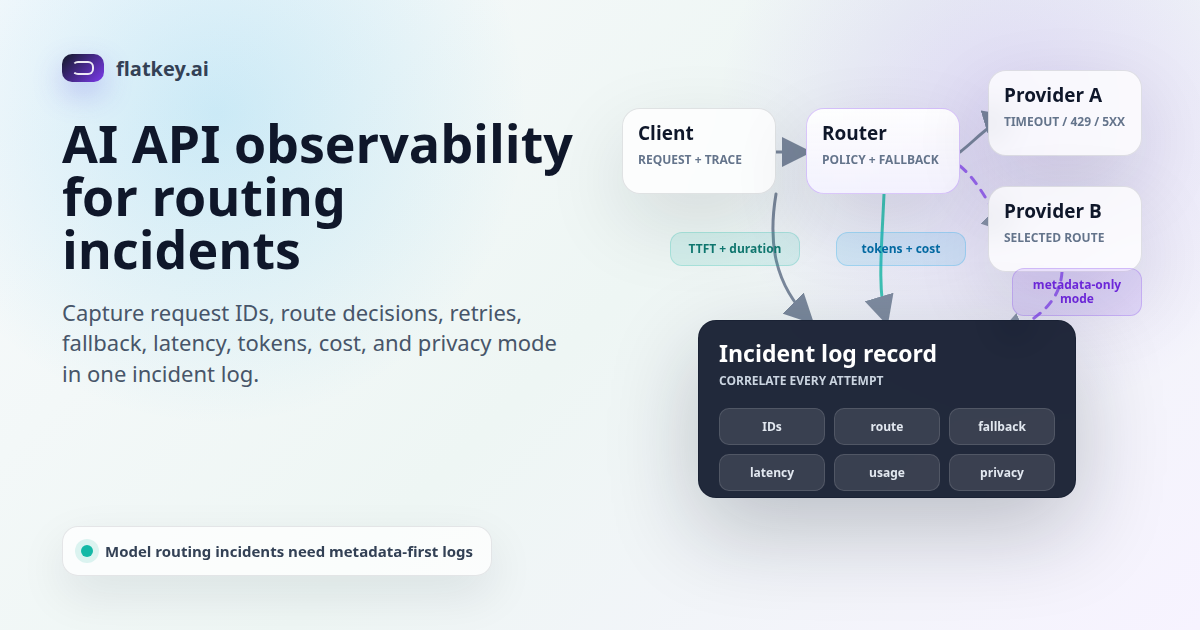
如果你的应用通过 AI 网关或路由器调用模型,网关本来就能看到每个请求,因此它是成本最低的起点。即使某些服务还没有埋点,网关也能采集到数据。以 Flatkey 为例,其用量日志会记录每次调用的时间戳、模型、输入 Token、输出 Token、成本、脱敏 API Key 和状态,可导出为 CSV 或 JSON,并支持月度支出上限和按分组配额(Flatkey 用量文档,2026 年 10 月)。
实用的方案是把两层结合起来:
| 层级 | 最擅长观察的内容 | 使用示例 |
|---|---|---|
| 网关日志 | 每次模型调用、成本、状态、供应商错误、回退 | 按 Key 或团队统计支出、429 和 5xx 比例、供应商故障 |
| 应用 trace | 业务上下文、智能体步骤、检索、工具调用 | 某个用户的请求为什么失败或回答不佳 |
| 评估 | 长期的答案质量 | 在修改提示词或更换模型后发现质量回退 |
用共享的请求 ID 把两者关联起来:在每次模型调用中把 trace ID 作为请求头或元数据字段发送,这样就能从网关日志的一行跳转到完整的应用 trace。我们推荐的指标集见 LLM API 可观测性:指标、trace 与成本,图表布局可参考 AI 网关 KPI 仪表盘。
生产环境中真正重要的指标
| 指标 | 为什么重要 | 告警思路 |
|---|---|---|
| 各模型 p50 / p95 延迟 | 用户能感受到长尾延迟 | p95 连续 10 分钟超过 SLO |
| 首 Token 时间(TTFT) | 流式输出体验 | 某个供应商的 TTFT 持续上升 |
| 按状态统计的错误率(429、5xx、超时) | 供应商或配额问题 | 429 比例超过 2% |
| 回退率 | 隐藏的可靠性问题 | 回退次数环比翻倍 |
| 每请求和每用户成本 | 预算控制 | 日支出超出预测 |
| 每请求 Token 数 | 提示词膨胀和失控的智能体 | 智能体运行超过 Token 上限 |
| 评估分数 | 质量回退 | 部署后分数下降 |
按团队和环境归因成本,财务问题才有答案;成本归因指南和按环境追踪成本介绍了打标签的方案。落地计划可参考 AI 可观测性实施清单。
常见问题
什么是 AI 可观测性?
AI 可观测性是从 AI 应用中采集 trace、指标、日志和质量评分,让你看清模型或智能体做了什么、结果好不好、花了多少钱。它在传统监控之上加入了提示词、Token、工具调用和评估。
最好的 AI 可观测性平台是哪个?
没有唯一最好的平台。Langfuse 和 Arize Phoenix 适合需要开源和自托管的团队,LangSmith 适合 LangChain 用户,Datadog 适合已经在用 Datadog 的团队,Braintrust 适合以评估为主的工作流。建议用你自己的 trace 试用两个方案。
有免费的 AI 可观测性平台吗?
有。截至 2026 年 10 月,Langfuse Hobby(每月 5 万 units)、LangSmith Developer(5k 基础 trace)、Helicone Hobby(1 万次请求)、Braintrust Starter 和 Logfire Personal(1000 万条记录)都是免费的,Langfuse 和 Arize Phoenix 还可以零许可费自托管。
LLM 监控和 AI 可观测性有什么区别?
监控关注预先设定的阈值,比如延迟和错误率。可观测性则让你能深入调查任何单个请求,包括提示词、工具调用、Token 用量和质量评分。
AI 可观测性支持 OpenTelemetry 吗?
支持。OpenTelemetry 的 GenAI 语义约定定义了 gen_ai.request.model、gen_ai.usage.input_tokens 等标准属性,大多数平台都接受 OTLP trace。截至 2026 年 10 月,这些约定仍处于 Development 状态。
什么是生成式 AI 可观测性?
它是同一套实践在生成式模型上的应用:采集提示词、输出、Token 成本、智能体步骤和评估结果,帮助团队在生产环境中调试和改进生成式 AI 功能。
资料来源
- OpenTelemetry GenAI 语义约定(2026 年 10 月)
- Langfuse 定价、LangSmith 定价、Arize 定价、Helicone 定价、Braintrust 定价、Logfire 定价(均于 2026 年 10 月 24 日查询)
- Datadog LLM Observability 文档(2026 年 10 月)
- GitHub 上的 Arize Phoenix 和 GitHub 上的 Langfuse
- NIST AI 风险管理框架