
Perbandingan Harga API AI: Biaya Model, Cache, Batch, dan Gateway
Perbandingan harga API AI hanya berguna jika sesuai dengan cara produk Anda benar-benar mengirim permintaan. Tabel harga token input dan output adalah titik awal, bukan anggaran. Pengeluaran nyata berubah dengan input yang di-cache, token penalaran, retry, diskon batch, panggilan tool, pembuatan media, biaya gateway, dan persentase output yang diterima pengguna Anda.
Panduan ini memberi pengembang, tim produk, dan tim pengadaan lembar kerja praktis untuk membandingkan harga API AI di OpenAI, Anthropic Claude, Google Gemini, DeepSeek, Alibaba Model Studio/Qwen, dan API multi-provider seperti Flatkey.
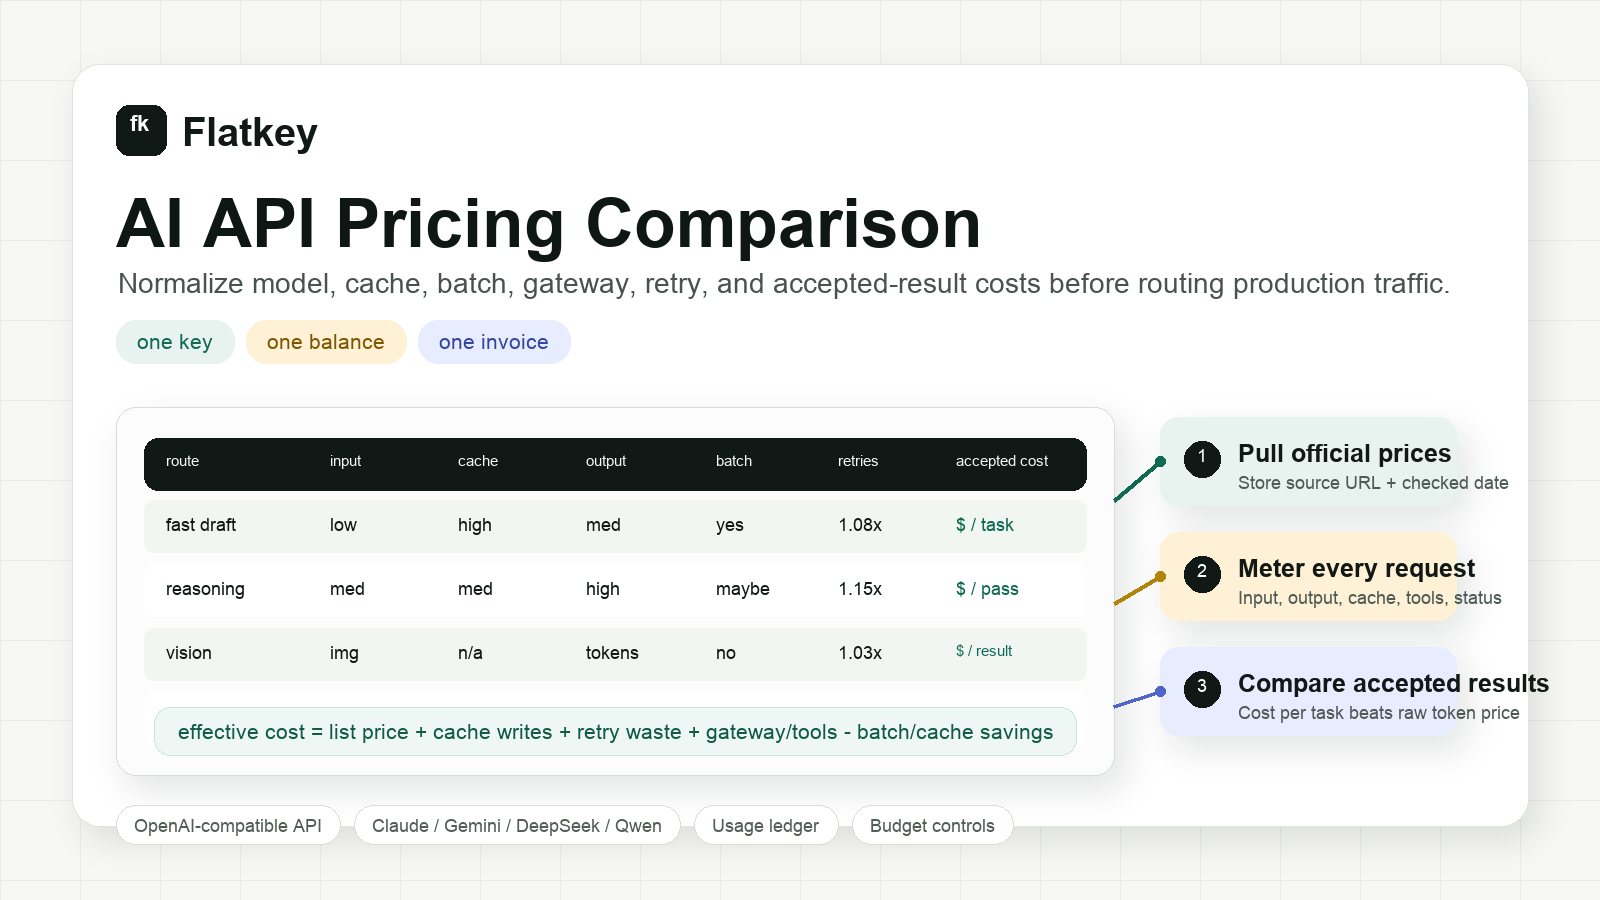
Versi singkatnya: bandingkan biaya per hasil yang diterima, bukan hanya harga daftar per satu juta token.
Kerangka cepat perbandingan harga API AI
Gunakan perbandingan yang dinormalisasi ini sebelum Anda beralih penyedia, menyetujui anggaran yang lebih besar, atau memasukkan alur kerja agent ke produksi.
| Lapisan | Apa yang dibandingkan | Mengapa ini mengubah tagihan Anda |
|---|---|---|
| Harga daftar model | Input, input cache, output, gambar, audio, video, dan tarif panggilan tool | Tarif yang terlihat dapat menguntungkan satu penyedia untuk prompt dan penyedia lain untuk completion. |
| Bentuk beban kerja | Rata-rata token input, token output, prefiks yang bisa di-cache, ukuran media, dan panggilan tool | Model output yang murah bisa menjadi mahal jika memerlukan prompt panjang atau retry berulang. |
| Diskon dan mode | Batch API, tingkatan flex/priority, cache hit, jendela di luar jam sibuk, committed use, atau syarat volume | Model yang sama dapat memiliki ekonomi berbeda tergantung penjadwalan dan toleransi latensi. |
| Biaya keandalan | Tingkat retry, tingkat fallback, tingkat timeout, dan kebijakan panggilan gagal | Pemborosan retry dapat menghapus keunggulan harga daftar yang lebih rendah. |
| Biaya operasional | API key, invoice, ekspor penggunaan, kontrol anggaran, retensi data, dan overhead pengadaan | Tim keuangan dan platform membutuhkan tata kelola, bukan hanya token yang lebih murah. |
| Hasil yang diterima | Tingkat penerimaan, tingkat edit manusia, tingkat lolos evaluator, atau tingkat keberhasilan tugas | Permintaan termurah bukan hasil termurah jika kualitas menurun. |
Untuk setiap perbandingan harga API AI, mulai dengan rumus ini:
biaya efektif per hasil yang diterima =
  (biaya input + biaya input cache + biaya output + biaya media/tool + biaya gateway + pemborosan retry)
  / jumlah hasil yang diterima
Jika Anda hanya membandingkan harga daftar token input dan output, Anda akan melewatkan biaya yang biasanya muncul setelah peluncuran: perilaku cache, retry, panggilan tool, dan rekonsiliasi keuangan.
Tabel sumber harga saat ini
Harga penyedia sering berubah. Alih-alih menyalin kartu tarif besar yang sudah usang ke dokumen perencanaan Anda, simpan tabel sumber langsung dengan URL resmi, tanggal pengecekan, dan dimensi harga yang harus Anda normalisasi.
| Penyedia atau rute | Sumber harga resmi yang perlu dicek | Dimensi harga yang harus dicatat | Catatan untuk perbandingan |
|---|---|---|---|
| OpenAI API | Harga API OpenAI | Input, input cache, output, mode batch, fine-tuning, media, pemrosesan regional | Berguna untuk produk yang sudah dibangun di sekitar pola permintaan yang kompatibel dengan OpenAI. Konfirmasi ID model dan apakah Anda menggunakan harga standar atau batch. |
| Anthropic Claude API | Harga Claude | Input, output, prompt caching, harga batch, keluarga model, jendela konteks | Kuat untuk coding, penalaran, dan tugas agent; perilaku cache-write dan cache-hit penting untuk prompt berulang. |
| Google Gemini API | Harga Gemini API | Tingkat gratis/berbayar, input, output, caching, mode batch, opsi priority/flex, grounding pencarian | Harga Gemini dapat bervariasi حسب keluarga model dan mode penyajian. Catat apakah biaya pencarian atau grounding berlaku. |
| DeepSeek API | Harga API DeepSeek | Cache miss input, cache hit input, output, waktu puncak/off-peak, alias model | Harga cache-hit dan jendela waktu ala DeepSeek memerlukan log permintaan dengan cap waktu dan status cache. |
| Alibaba Model Studio / Qwen | Model Alibaba Model Studio | Keluarga model, modalitas, region, unit token atau media, ID model konsol | Berguna untuk Qwen dan akses model wilayah China. Periksa halaman detail model yang tepat untuk unit yang dikenakan biaya. |
| Flatkey multi-provider API | Harga Flatkey dan Model Flatkey | Rute model terpadu, satu saldo, buku besar per permintaan, panggilan tool, invoice, anggaran sub-key | Berguna ketika Anda memerlukan satu kunci, satu saldo, dan satu buku besar penggunaan di banyak model dan tool resmi. |
Tambahkan tiga kolom wajib ke setiap baris: tanggal pengecekan, ID model, dan unit. “$ per 1M token” tidak dapat dibandingkan dengan “$ per gambar,” “$ per detik video,” “$ per panggilan tool,” atau “tingkat priority.”
Bangun lembar kerja sebelum Anda bernegosiasi
Lembar kerja perbandingan harga API AI yang tahan lama membutuhkan kolom yang mencerminkan trafik produksi.
| Kolom | Contoh nilai | Mengapa ini penting |
|---|---|---|
| Penyedia | Anthropic, OpenAI, Google, DeepSeek, Alibaba, rute Flatkey | Memisahkan rute penyedia langsung dan rute gateway. |
| ID model atau rute | claude-*, gpt-*, gemini-*, deepseek-*, qwen-* |
Mencegah perbandingan diam-diam antara tingkat model yang berbeda. |
| URL sumber harga | Halaman resmi penyedia atau halaman model Flatkey | Membuat tinjauan pengadaan dapat dilacak. |
| Tanggal pengecekan | 2026-10-12 |
Harga dapat berubah lebih cepat daripada tinjauan kontrak. |
| Token input per tugas | 8,000 |
Prompt yang panjang mengubah ekonomi biaya dengan cepat. |
| Porsi input yang dapat di-cache | 65% |
System prompt yang stabil dan prefix retrieval mungkin menjadi lebih murah. |
| Token output per tugas | 1,200 |
Penalaran dan jawaban yang panjang menaikkan biaya output. |
| Layak batch | ya/tidak | Pekerjaan offline mungkin memenuhi syarat untuk tarif batch yang lebih rendah. |
| Panggilan alat/media | search, browser, image, video, enrichment | Alur kerja agen tidak hanya berupa teks. |
| Pengali retry | 1.08x |
Timeout dan percobaan fallback menambah pengeluaran tersembunyi. |
| Tingkat penerimaan | 82% |
Output berkualitas rendah menaikkan biaya per hasil yang diterima. |
| Biaya tata kelola | invoice, batas anggaran, ekspor, kebutuhan audit | Biaya pengadaan tetap nyata meskipun tarif token rendah. |
Jangan merata-ratakan setiap model ke dalam satu baris. Pisahkan berdasarkan beban kerja: chat, RAG, coding agent, ekstraksi data, klasifikasi batch, generasi gambar, generasi video, dan eksekusi agen yang banyak memakai tool.
Bandingkan harga penyedia langsung dengan API multi-penyedia
Akun penyedia langsung paling sederhana ketika satu keluarga model menangani sebagian besar pekerjaan Anda dan tim keuangan Anda nyaman dengan vendor terpisah. API multi-penyedia menjadi lebih berguna ketika Anda perlu membandingkan model secara berkelanjutan, merutekan berdasarkan beban kerja, atau mengelola banyak kunci dan invoice.
| Titik keputusan | Akun penyedia langsung mungkin sudah cukup ketika... | API multi-penyedia membantu ketika... |
|---|---|---|
| Pilihan model | Satu penyedia menang di sebagian besar tugas. | Beban kerja yang berbeda membutuhkan rute OpenAI, Claude, Gemini, DeepSeek, Qwen, image, video, dan tool. |
| Upaya engineering | Kode Anda sudah memanggil satu penyedia dan jarang berubah. | Anda menginginkan routing yang kompatibel dengan OpenAI dan lebih sedikit penulisan ulang integrasi. |
| Kontrol biaya | Satu invoice dan satu dashboard dapat diterima. | Anda memerlukan anggaran sub-key, allowlist model, dan ekspor penggunaan per permintaan. |
| Pengadaan | Kontrak terpisah masih dapat dikelola. | Kontrak duplikat, kursi yang menganggur, dan kunci penyedia yang tersebar memperlambat tim. |
| Keandalan | Gangguan sesekali dari penyedia masih dapat diterima. | Anda memerlukan kebijakan fallback dan buku besar bersama untuk biaya retry/fallback. |
| Alur kerja agen | Aplikasi hanya memanggil model teks. | Agen memanggil model, pencarian web, aksi browser, alat enrichment, gambar, dan video. |
Flatkey dibangun untuk kolom kedua: satu API key, satu saldo, satu invoice, dan buku besar permintaan di seluruh 300+ model resmi dan 1.000+ alat bayar per panggilan. Itu tidak menghilangkan kebutuhan untuk memeriksa harga model resmi. Itu memberi tim Anda satu tempat untuk merutekan, mengukur, dan merekonsiliasi biaya tersebut. Untuk rincian biaya gateway terkait, lihat harga gateway AI.
Lima contoh beban kerja
1. Chat dukungan
Chat dukungan biasanya memiliki input sedang, output pendek, dan volume tinggi. Bandingkan:
- Tingkat keberhasilan cache prompt untuk system prompt dan teks kebijakan.
- Anggaran token output berdasarkan jenis jawaban.
- Tingkat eskalasi ke model yang lebih kuat.
- Biaya per percakapan yang terselesaikan, bukan hanya biaya per pesan.
Untuk beban kerja ini, model cepat yang lebih murah bisa menang jika tetap menjaga kualitas penyelesaian tinggi. Jika model yang lebih murah meningkatkan tingkat handoff atau edit, penghematan token yang tampak akan hilang.
2. Agen coding
Agen coding sering memiliki konteks besar, panggilan tool, output panjang, dan beberapa retry. Bandingkan:
- Ukuran konteks setelah pencarian repositori atau pembacaan file.
- Instruksi proyek yang dapat di-cache.
- Jumlah panggilan tool per tugas yang diterima.
- Pemborosan retry dari rute yang kelebihan beban.
- Biaya per perubahan yang digabung atau patch yang diterima.
Di sinilah perbandingan harga API AI membutuhkan buku besar. Satu kali eksekusi agen dapat mencakup panggilan model, panggilan tool, panggilan fallback, dan percobaan yang gagal.
3. Generasi jawaban RAG
Beban kerja RAG didominasi oleh konteks hasil retrieval dan panjang jawaban. Bandingkan:
- Rata-rata jumlah token yang diambil kembali.
- Porsi prefix prompt yang stabil.
- Perilaku cache untuk dokumen yang berulang.
- Biaya sitasi dan grounding.
- Tingkat lolos evaluator untuk faktualitas.
Jangan memilih model hanya karena token input-nya murah. Jika model tersebut membutuhkan konteks dua kali lebih besar atau menghasilkan jawaban yang gagal evaluasi, biaya untuk jawaban yang diterima bisa lebih tinggi. Jika ini adalah pertanyaan migrasi utama, gunakan lembar kerja yang lebih mendalam di cara membandingkan harga model AI.
4. Klasifikasi batch
Klasifikasi batch sering kali dapat mentoleransi hasil yang tertunda. Bandingkan:
- Apakah penyedia memiliki tier batch atau flex.
- Ukuran batch maksimum dan jendela penyelesaian.
- Biaya pemutaran ulang error.
- Tingkat lolos validasi skema output.
- Total biaya per baris yang diterima.
Jika sebuah penyedia memberikan harga batch yang lebih rendah, penghematannya hanya berlaku ketika alur kerja Anda bisa menunggu dan proses retry Anda bersih.
5. Generasi gambar dan video
API gambar dan video jarang cocok untuk spreadsheet berbasis token saja. Bandingkan:
- Satuan output: gambar, detik, klip, resolusi, atau kredit.
- Aturan penagihan untuk generasi yang gagal.
- Tingkat edit/regenerasi.
- Tingkat persetujuan manusia.
- Biaya per aset kreatif yang diterima.
Untuk pipeline media, letakkan model token dan model generasi di tab worksheet yang terpisah. Ekonomi unitnya terlalu berbeda untuk satu baris gabungan.
Alur kerja perbandingan harga API AI tujuh langkah
- Kunci beban kerja. Pilih satu keluarga tugas nyata, seperti jawaban dukungan, patch agen coding, jawaban RAG, klasifikasi batch, generasi gambar, atau generasi video.
- Kumpulkan harga resmi terkini. Gunakan halaman harga penyedia, halaman model Flatkey, dan tanggal yang sudah dicek. Hindari kartu tarif yang disalin tanpa URL sumber.
- Putar ulang traffic representatif. Gunakan prompt, input, batas output, kebijakan tool, dan validator yang sama di seluruh rute.
- Catat setiap unit yang dapat ditagih. Tangkap token input, token cache, token output, unit media, panggilan tool, percobaan retry, error, dan status.
- Nilai hasil yang diterima. Gunakan tinjauan manusia, validator otomatis, atau pemeriksaan lulus/gagal spesifik tugas.
- Hitung biaya efektif. Bagi total biaya rute dengan hasil yang diterima, bukan total permintaan.
- Tambahkan kontrol operasional. Tentukan apakah rute pemenang juga memenuhi batas anggaran, kebutuhan invoice, tata kelola kunci, retensi data, dan fallback insiden.
Hasilnya adalah keputusan harga yang dapat Anda pertanggungjawabkan kepada engineering dan finance.
Di mana Flatkey cocok
Flatkey bukan tabel harga statis. Ini adalah lapisan routing dan penagihan untuk tim yang perlu menjalankan perbandingan harga API AI nyata di produksi. Untuk pandangan model yang lebih luas di seluruh biaya token, gambar, dan video, mulailah dengan perbandingan harga model AI.
Gunakan Flatkey ketika Anda ingin:
- Memanggil banyak model resmi melalui satu API key.
- Menjaga penggunaan model dan tool pada satu saldo.
- Membandingkan rute tanpa menyebarkan key penyedia di seluruh agen dan repositori.
- Melacak input, output, token cache, panggilan tool, status, dan biaya dalam satu buku besar.
- Memberi tim anggaran sub-key dan allowlist model.
- Mencocokkan satu invoice alih-alih banyak dashboard penyedia.
Mulailah dengan Flatkey ketika perbandingan itu sendiri sudah menjadi masalah operasional. Jika tim Anda sudah tahu persis penyedia mana yang menang dan tidak memerlukan routing lintas penyedia, akun langsung mungkin sudah cukup. Ketika finance membutuhkan akuntabilitas owner, key, dan anggaran, pasangkan lembar kerja ini dengan manajemen pengeluaran API AI dan kontrol kuota API AI.
Kesalahan umum dalam perbandingan harga API AI
| Kesalahan | Apa yang harus dilakukan sebagai gantinya |
|---|---|
| Membandingkan hanya tarif token input | Bandingkan input, input yang di-cache, output, retry, dan hasil yang diterima. |
| Mencampur teks, gambar, video, dan tool dalam satu unit | Normalisasi setiap modalitas secara terpisah, lalu gabungkan biaya alur kerja yang diterima. |
| Mengabaikan prompt caching | Ukur prefix prompt yang stabil dan tingkat cache hit. |
| Mengabaikan kelayakan batch | Pisahkan pekerjaan yang sensitif terhadap latensi dan pekerjaan offline. |
| Mempercayai tabel harga salinan yang sudah usang | Simpan URL sumber resmi dan tanggal pengecekan. |
| Menganggap gateway hanya sebagai markup | Masukkan tata kelola, failover, ekspor penggunaan, invoice, dan waktu engineering. |
| Memilih permintaan termurah | Pilih hasil yang diterima termurah yang memenuhi kebutuhan kualitas dan keandalan. |
Pertanyaan yang sering diajukan
Apa cara terbaik untuk membandingkan harga API AI?
Cara terbaik untuk membandingkan harga API AI adalah menormalkan setiap rute ke biaya per hasil yang diterima. Sertakan token input, input yang di-cache, token output, unit media, panggilan tool, retry, biaya gateway, dan tingkat penerimaan untuk beban kerja tersebut.
Mengapa harga API AI sangat berbeda?
Harga API AI berbeda karena penyedia menggunakan arsitektur model, tier penyajian, window konteks, aturan cache, diskon batch, unit media, serta opsi regional atau prioritas yang berbeda. Harga input yang rendah tidak otomatis berarti rute tersebut lebih murah untuk beban kerja Anda.
Haruskah saya menggunakan satu penyedia atau API multi-penyedia?
Gunakan satu penyedia ketika satu keluarga model sudah mencakup beban kerja dan penagihan terpisah mudah dikelola. Gunakan API multi-penyedia ketika Anda perlu membandingkan rute secara berkelanjutan, mengelola banyak kunci, merutekan lintas model teks dan media, atau merekonsiliasi penggunaan dalam satu buku besar.
Seberapa sering harga harus diperiksa ulang?
Periksa ulang harga sebelum setiap perubahan rute besar, peninjauan kontrak, atau proyeksi anggaran. Untuk beban kerja produksi yang bergerak cepat, simpan sumber harga dan tanggal pemeriksaan di lembar biaya Anda agar keuangan dan engineering dapat melihat kapan angka-angka tersebut mungkin sudah usang.
Apakah harga token yang lebih rendah selalu menurunkan total pengeluaran AI?
Tidak. Harga token yang lebih rendah bisa kalah begitu Anda memasukkan prompt yang lebih panjang, output yang lebih panjang, tingkat penerimaan yang lebih rendah, percobaan ulang, panggilan fallback, penggunaan alat, dan overhead tata kelola tambahan. Metrik yang tahan lama adalah biaya efektif per hasil yang diterima.
Daftar periksa akhir
Sebelum Anda memilih rute, pastikan:
- ID model, sumber harga, dan tanggal pemeriksaan sudah dicatat.
- Input, cached input, output, media, dan unit alat dipisahkan.
- Mode batch atau prioritas ditandai secara eksplisit.
- Biaya retry dan fallback sudah disertakan.
- Tingkat penerimaan diukur dengan tugas nyata.
- Procurement dapat merekonsiliasi faktur dan mengekspor buku besar penggunaan.
- Keputusan akhir didasarkan pada biaya hasil yang diterima, bukan hanya harga daftar.
Itulah perbandingan praktis harga API AI: harga sumber terkini, lalu lintas yang dibentuk seperti produksi, dan buku besar yang dapat dipercaya oleh keuangan maupun engineering.


