
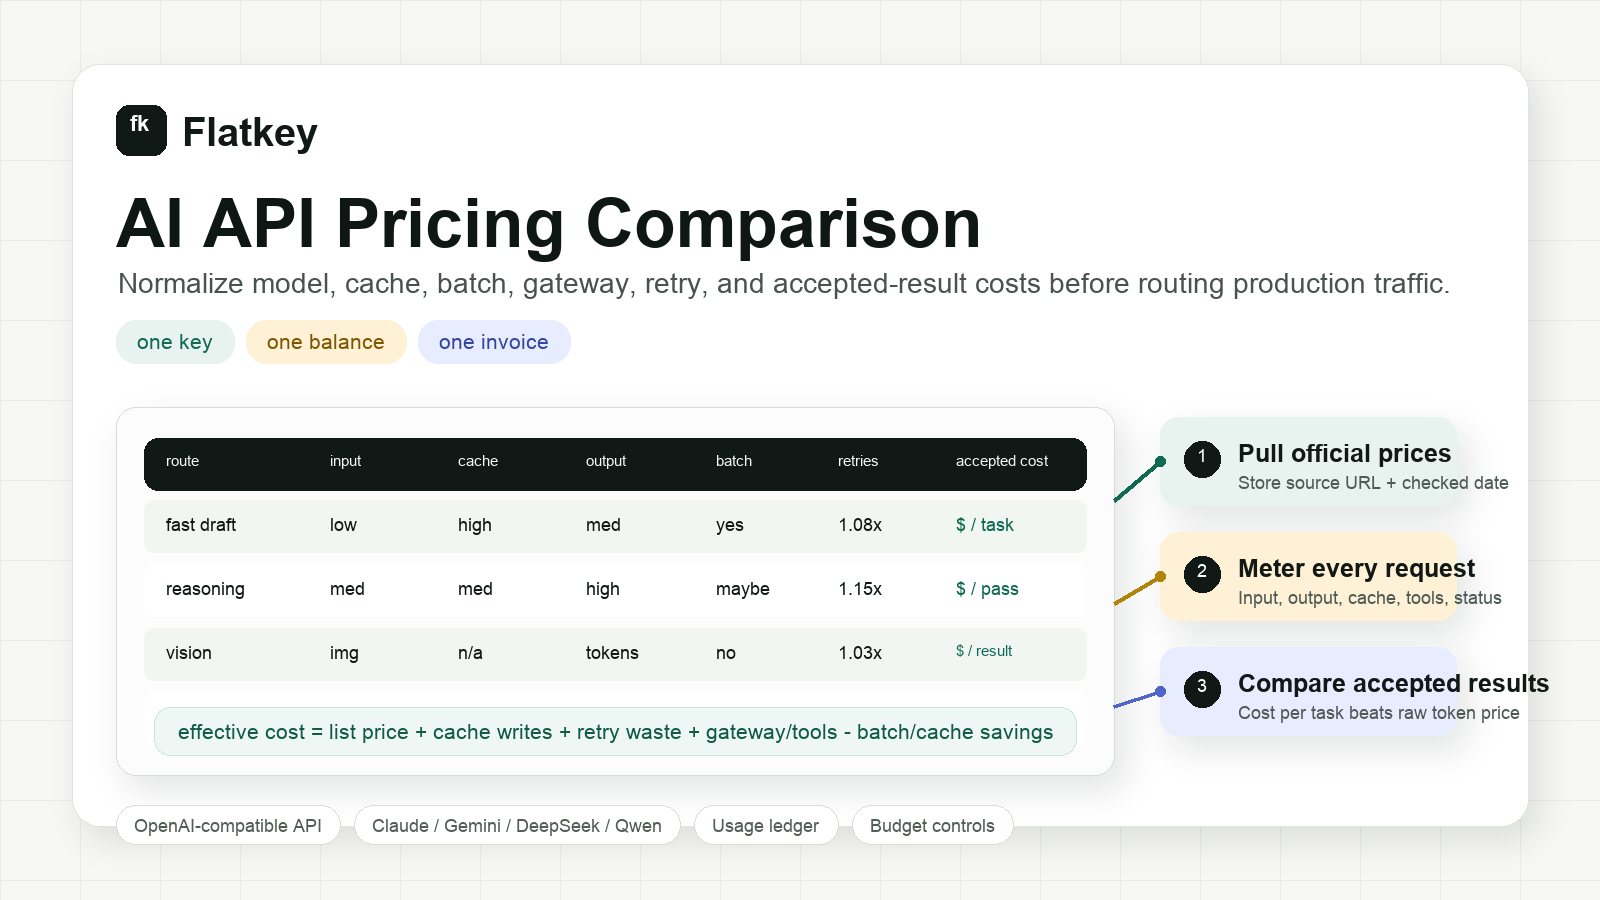
So sánh giá AI API: Chi phí model, cache, batch và gateway
So sánh giá AI API chỉ thực sự hữu ích khi nó khớp với cách sản phẩm của bạn thực sự gửi yêu cầu. Một bảng giá token đầu vào và đầu ra chỉ là điểm khởi đầu, không phải ngân sách. Chi tiêu thực tế thay đổi theo input đã được cache, reasoning tokens, retry, giảm giá theo batch, lệnh gọi công cụ, tạo media, phí gateway và tỷ lệ đầu ra mà người dùng chấp nhận.
Hướng dẫn này cung cấp cho lập trình viên, nhóm sản phẩm và nhóm mua sắm một bảng tính thực tiễn để so sánh giá AI API giữa OpenAI, Anthropic Claude, Google Gemini, DeepSeek, Alibaba Model Studio/Qwen và một API đa nhà cung cấp như Flatkey.
Tóm lại: hãy so sánh chi phí trên mỗi kết quả được chấp nhận, không chỉ là giá niêm yết trên mỗi triệu token.
Khung so sánh giá AI API nhanh
Hãy dùng phép so sánh chuẩn hóa này trước khi bạn đổi nhà cung cấp, phê duyệt ngân sách lớn hơn, hoặc đưa một quy trình agent vào sản xuất.
| Layer | Những gì cần so sánh | Vì sao nó làm thay đổi hóa đơn của bạn |
|---|---|---|
| Model list price | Input, cached input, output, image, audio, video và mức giá tool-call | Bảng giá hiển thị có thể có lợi cho một nhà cung cấp ở prompts và nhà cung cấp khác ở completions. |
| Workload shape | Số token đầu vào trung bình, token đầu ra, prefix có thể cache, kích thước media và số lần gọi công cụ | Một model đầu ra rẻ có thể trở nên đắt nếu cần prompt dài hoặc retry lặp lại. |
| Discounts and modes | Batch API, các bậc flex/priority, cache hit, khung giờ thấp điểm, cam kết sử dụng hoặc điều khoản theo khối lượng | Cùng một model có thể có kinh tế khác nhau tùy theo lịch chạy và mức chấp nhận độ trễ. |
| Reliability cost | Tỷ lệ retry, tỷ lệ fallback, tỷ lệ timeout và chính sách với các cuộc gọi thất bại | Chi phí do retry có thể xóa sạch lợi thế của giá niêm yết thấp hơn. |
| Operating cost | API key, hóa đơn, xuất dữ liệu sử dụng, kiểm soát ngân sách, lưu giữ dữ liệu và chi phí vận hành mua sắm | Các nhóm tài chính và nền tảng cần quản trị, không chỉ token rẻ hơn. |
| Accepted result | Tỷ lệ chấp nhận, tỷ lệ chỉnh sửa thủ công, tỷ lệ đạt của evaluator hoặc tỷ lệ hoàn thành tác vụ thành công | Yêu cầu rẻ nhất không phải là kết quả rẻ nhất nếu chất lượng giảm. |
Với bất kỳ so sánh giá AI API nào, hãy bắt đầu bằng công thức này:
effective cost per accepted result =
  (input cost + cached-input cost + output cost + media/tool cost + gateway cost + retry waste)
  / accepted-result count
Nếu bạn chỉ so sánh giá niêm yết của token đầu vào và đầu ra, bạn sẽ bỏ lỡ các chi phí thường xuất hiện sau khi ra mắt: hành vi cache, retry, lệnh gọi công cụ và đối soát tài chính.
Bảng nguồn giá hiện tại
Giá của nhà cung cấp thay đổi thường xuyên. Thay vì sao chép một bảng giá lớn nhưng đã lỗi thời vào tài liệu kế hoạch, hãy giữ một bảng nguồn trực tiếp với URL chính thức, ngày kiểm tra và các chiều giá mà bạn phải chuẩn hóa.
| Provider or route | Official pricing source to check | Pricing dimensions to capture | Notes for comparison |
|---|---|---|---|
| OpenAI API | OpenAI API pricing | Input, cached input, output, batch mode, fine-tuning, media, regional processing | Hữu ích cho các sản phẩm đã được xây dựng quanh các mẫu yêu cầu tương thích với OpenAI. Xác nhận model ID và liệu bạn đang dùng giá standard hay batch. |
| Anthropic Claude API | Claude pricing | Input, output, prompt caching, batch pricing, model family, context window | Mạnh cho các tác vụ coding, reasoning và agent; hành vi cache-write và cache-hit rất quan trọng với prompt lặp lại. |
| Google Gemini API | Gemini API pricing | Free/paid tier, input, output, caching, batch mode, priority/flex options, search grounding | Giá Gemini có thể khác nhau theo họ model và chế độ phục vụ. Ghi lại xem có áp dụng phí tìm kiếm hoặc grounding hay không. |
| DeepSeek API | DeepSeek API pricing | Input cache miss, input cache hit, output, peak/off-peak timing, model alias | Giá kiểu DeepSeek cho cache-hit và theo khung thời gian đòi hỏi log yêu cầu có timestamp và trạng thái cache. |
| Alibaba Model Studio / Qwen | Alibaba Model Studio models | Model family, modality, region, token or media unit, console model ID | Hữu ích cho Qwen và truy cập model ở khu vực Trung Quốc. Kiểm tra trang chi tiết model chính xác để biết đơn vị tính phí. |
| Flatkey multi-provider API | Flatkey pricing và Flatkey models | Unified model routes, one balance, per-request ledger, tool calls, invoices, sub-key budgets | Hữu ích khi bạn cần một key, một số dư và một sổ ghi sử dụng cho nhiều model và công cụ chính thức. |
Thêm ba trường bắt buộc vào mọi hàng: ngày kiểm tra, model ID và đơn vị. “$ mỗi 1M token” không thể so sánh với “$ mỗi ảnh”, “$ mỗi giây video”, “$ mỗi lệnh gọi công cụ” hoặc “priority tier.”
Xây dựng bảng tính trước khi bạn đàm phán
Một bảng tính so sánh giá AI API bền vững cần các cột phản ánh lưu lượng truy cập thực tế ở môi trường sản xuất.
| Cột | Giá trị ví dụ | Vì sao điều này quan trọng |
|---|---|---|
| Nhà cung cấp | Anthropic, OpenAI, Google, DeepSeek, Alibaba, Flatkey route | Giữ riêng các tuyến trực tiếp từ nhà cung cấp và các tuyến gateway. |
| ID model hoặc tuyến | claude-*, gpt-*, gemini-*, deepseek-*, qwen-* |
Ngăn việc so sánh ngầm giữa các tầng model khác nhau. |
| URL nguồn giá | Trang chính thức của nhà cung cấp hoặc trang model của Flatkey | Giúp việc rà soát mua sắm có thể truy vết. |
| Ngày kiểm tra | 2026-10-12 |
Giá có thể thay đổi nhanh hơn cả các đợt rà soát hợp đồng. |
| Token đầu vào mỗi tác vụ | 8,000 |
Prompt dài làm thay đổi kinh tế chi phí rất nhanh. |
| Tỷ lệ đầu vào có thể cache | 65% |
Các system prompt ổn định và tiền tố truy xuất có thể rẻ hơn. |
| Token đầu ra mỗi tác vụ | 1,200 |
Suy luận và câu trả lời dài làm tăng chi phí đầu ra. |
| Đủ điều kiện batch | yes/no | Các job ngoại tuyến có thể đủ điều kiện nhận mức giá batch thấp hơn. |
| Gọi công cụ/phương tiện | search, browser, image, video, enrichment | Quy trình agent không chỉ là văn bản. |
| Hệ số retry | 1.08x |
Timeout và các lần thử dự phòng làm phát sinh chi phí ẩn. |
| Tỷ lệ chấp nhận | 82% |
Đầu ra kém chất lượng làm tăng chi phí trên mỗi kết quả được chấp nhận. |
| Chi phí quản trị | hóa đơn, giới hạn ngân sách, xuất dữ liệu, nhu cầu kiểm toán | Chi phí mua sắm là có thật ngay cả khi giá token thấp. |
Đừng gộp mọi model vào một hàng. Hãy tách theo từng khối công việc: chat, RAG, coding agent, trích xuất dữ liệu, phân loại batch, tạo ảnh, tạo video và các lượt chạy agent dùng nhiều công cụ.
So sánh giá của nhà cung cấp trực tiếp với một API đa nhà cung cấp
Tài khoản trực tiếp từ nhà cung cấp là đơn giản nhất khi một họ model xử lý phần lớn công việc của bạn và đội tài chính thoải mái với việc có nhiều nhà cung cấp riêng lẻ. Một API đa nhà cung cấp trở nên hữu ích hơn khi bạn cần liên tục so sánh model, định tuyến theo khối công việc hoặc quản trị nhiều khóa và hóa đơn.
| Điểm quyết định | Tài khoản nhà cung cấp trực tiếp có thể đủ khi... | API đa nhà cung cấp hữu ích khi... |
|---|---|---|
| Lựa chọn model | Một nhà cung cấp thắng ở đa số tác vụ. | Các khối công việc khác nhau cần OpenAI, Claude, Gemini, DeepSeek, Qwen, ảnh, video và các tuyến công cụ. |
| Nỗ lực kỹ thuật | Mã của bạn đã gọi một nhà cung cấp và hiếm khi thay đổi. | Bạn muốn định tuyến tương thích với OpenAI và ít phải viết lại tích hợp hơn. |
| Kiểm soát chi phí | Một hóa đơn và một bảng điều khiển là chấp nhận được. | Bạn cần ngân sách theo sub-key, danh sách cho phép model và xuất mức sử dụng theo từng yêu cầu. |
| Mua sắm | Có thể quản lý các hợp đồng riêng biệt. | Các hợp đồng trùng lặp, seat nhàn rỗi và khóa nhà cung cấp rải rác làm chậm đội ngũ. |
| Độ tin cậy | Có thể chấp nhận các lần gián đoạn thỉnh thoảng từ nhà cung cấp. | Bạn cần chính sách dự phòng và sổ cái dùng chung cho chi phí retry/fallback. |
| Quy trình agent | Ứng dụng chỉ gọi các model văn bản. | Agent gọi model, tìm kiếm web, thao tác trình duyệt, công cụ bổ sung dữ liệu, ảnh và video. |
Flatkey được xây dựng cho cột thứ hai: một API key, một số dư, một hóa đơn và một sổ ghi yêu cầu trên 300+ model chính thức cùng 1.000+ công cụ trả theo lượt gọi. Điều đó không loại bỏ nhu cầu kiểm tra giá model chính thức. Nó cung cấp cho đội của bạn một nơi duy nhất để định tuyến, đo lường và đối soát các chi phí đó. Để xem phân tích tách riêng phí gateway liên quan, hãy xem giá AI gateway.
Năm ví dụ khối công việc
1. Chat hỗ trợ
Chat hỗ trợ thường có đầu vào vừa phải, đầu ra ngắn và khối lượng lớn. Hãy so sánh:
- Tỷ lệ trúng cache prompt cho system prompt và văn bản chính sách.
- Ngân sách token đầu ra theo từng loại câu trả lời.
- Tỷ lệ chuyển lên model mạnh hơn.
- Chi phí trên mỗi cuộc hội thoại được giải quyết, không chỉ chi phí trên mỗi tin nhắn.
Với khối công việc này, một model nhanh rẻ hơn có thể thắng nếu vẫn giữ chất lượng xử lý cao. Nếu model rẻ hơn làm tăng tỷ lệ chuyển giao hoặc chỉnh sửa, phần tiết kiệm token bề ngoài sẽ biến mất.
2. Agent lập trình
Agent lập trình thường có ngữ cảnh lớn, các lệnh gọi công cụ, đầu ra dài và nhiều lần retry. Hãy so sánh:
- Kích thước ngữ cảnh sau khi tìm kiếm repository hoặc đọc file.
- Hướng dẫn dự án có thể cache.
- Số lần gọi công cụ trên mỗi tác vụ được chấp nhận.
- Lãng phí retry từ các tuyến quá tải.
- Chi phí trên mỗi thay đổi được merge hoặc mỗi bản vá được chấp nhận.
Đây là lúc một bản so sánh giá AI API cần có sổ ghi. Một lần chạy agent đơn lẻ có thể bao gồm các lần gọi model, gọi công cụ, gọi dự phòng và các lần thử thất bại.
3. Tạo câu trả lời RAG
Khối công việc RAG bị chi phối bởi ngữ cảnh được truy xuất và độ dài câu trả lời. Hãy so sánh:
- Số token truy xuất trung bình.
- Tỷ lệ tiền tố prompt ổn định.
- Hành vi cache đối với tài liệu lặp lại.
- Chi phí trích dẫn và grounding.
- Tỷ lệ qua của evaluator đối với tính chính xác thực tế.
Đừng chọn một model chỉ vì token đầu vào của nó rẻ. Nếu nó cần gấp đôi ngữ cảnh hoặc tạo ra câu trả lời không đạt đánh giá, chi phí theo câu trả lời được chấp nhận có thể cao hơn. Nếu đây là câu hỏi di chuyển chính, hãy dùng bảng tính chi tiết hơn trong cách so sánh giá model AI.
4. Phân loại batch
Phân loại batch thường có thể chấp nhận kết quả bị trễ. Hãy so sánh:
- Nhà cung cấp có tier batch hoặc flex hay không.
- Kích thước batch tối đa và cửa sổ hoàn tất.
- Chi phí phát lại lỗi.
- Tỷ lệ vượt qua xác thực lược đồ đầu ra.
- Tổng chi phí trên mỗi hàng được chấp nhận.
Nếu một nhà cung cấp đưa ra giá batch thấp hơn, khoản tiết kiệm chỉ áp dụng khi quy trình của bạn có thể chờ và quy trình thử lại của bạn gọn gàng.
5. Tạo ảnh và video
API ảnh và video hiếm khi phù hợp với bảng tính chỉ dựa trên token. Hãy so sánh:
- Đơn vị đầu ra: ảnh, giây, clip, độ phân giải hoặc credit.
- Quy tắc tính phí khi tạo thất bại.
- Tỷ lệ chỉnh sửa/tạo lại.
- Tỷ lệ phê duyệt của con người.
- Chi phí trên mỗi tài sản sáng tạo được chấp nhận.
Đối với các pipeline media, hãy đặt các model token và model tạo nội dung vào các tab bảng tính riêng. Kinh tế theo đơn vị của chúng quá khác nhau để gộp vào một hàng.
Quy trình so sánh giá AI API gồm bảy bước
- Cố định khối lượng công việc. Chọn một nhóm tác vụ thực tế, chẳng hạn như trả lời hỗ trợ, bản vá của coding-agent, câu trả lời RAG, phân loại batch, tạo ảnh hoặc tạo video.
- Thu thập giá chính thức hiện tại. Sử dụng trang giá của nhà cung cấp, các trang model của Flatkey và một ngày đã được kiểm tra. Tránh các bảng giá sao chép không có URL nguồn.
- Phát lại lưu lượng đại diện. Dùng cùng prompt, đầu vào, giới hạn đầu ra, chính sách công cụ và bộ xác thực trên tất cả các tuyến.
- Ghi lại mọi đơn vị tính phí. Thu thập token đầu vào, token đã cache, token đầu ra, đơn vị media, lệnh gọi công cụ, số lần thử lại, lỗi và trạng thái.
- Chấm điểm các kết quả được chấp nhận. Dùng đánh giá của con người, bộ xác thực tự động hoặc các kiểm tra đạt/không đạt theo tác vụ.
- Tính chi phí hiệu dụng. Chia tổng chi phí của tuyến cho số kết quả được chấp nhận, không phải tổng số yêu cầu.
- Thêm các kiểm soát vận hành. Quyết định xem tuyến thắng cuộc có đồng thời đáp ứng hạn mức ngân sách, nhu cầu hóa đơn, quản trị khóa, lưu giữ dữ liệu và phương án dự phòng sự cố hay không.
Kết quả là một quyết định giá bạn có thể bảo vệ trước kỹ thuật và tài chính.
Flatkey phù hợp ở đâu
Flatkey không phải là một bảng giá tĩnh. Nó là lớp định tuyến và tính phí cho các đội cần chạy một so sánh giá AI API thực tế trong môi trường production. Để có cái nhìn rộng hơn ở cấp độ model trên chi phí token, ảnh và video, hãy bắt đầu với so sánh giá model AI.
Hãy dùng Flatkey khi bạn muốn:
- Gọi nhiều model chính thức qua một API key.
- Giữ việc sử dụng model và công cụ trên cùng một số dư.
- So sánh các tuyến mà không phân tán khóa nhà cung cấp khắp các agent và repository.
- Theo dõi token đầu vào, đầu ra, token đã cache, lệnh gọi công cụ, trạng thái và chi phí trong một sổ cái.
- Cấp cho các đội ngân sách sub-key và danh sách allowlist model.
- Đối soát một hóa đơn thay vì nhiều dashboard của nhà cung cấp.
Hãy bắt đầu với Flatkey khi bản thân việc so sánh đã trở thành một vấn đề vận hành. Nếu đội của bạn đã biết chính xác nhà cung cấp nào thắng và không cần định tuyến đa nhà cung cấp, một tài khoản trực tiếp có thể là đủ. Khi tài chính cần truy vết theo chủ sở hữu, khóa và ngân sách, hãy kết hợp bảng tính này với quản lý chi tiêu AI API và kiểm soát hạn ngạch AI API.
Các sai lầm phổ biến trong so sánh giá AI API
| Sai lầm | Nên làm gì thay vào đó |
|---|---|
| Chỉ so sánh giá token đầu vào | So sánh đầu vào, đầu vào đã cache, đầu ra, số lần thử lại và kết quả được chấp nhận. |
| Trộn văn bản, ảnh, video và công cụ trong một đơn vị | Chuẩn hóa từng phương thức riêng, rồi cộng gộp chi phí quy trình được chấp nhận. |
| Bỏ qua prompt caching | Đo các tiền tố prompt ổn định và tỷ lệ cache hit. |
| Bỏ qua điều kiện đủ cho batch | Tách các tác vụ nhạy cảm với độ trễ và các tác vụ offline. |
| Tin vào các bảng giá sao chép đã lỗi thời | Lưu URL nguồn chính thức và ngày đã kiểm tra. |
| Xem gateway chỉ là phần markup | Tính cả quản trị, failover, xuất usage, hóa đơn và thời gian kỹ thuật. |
| Chọn yêu cầu rẻ nhất | Chọn kết quả được chấp nhận rẻ nhất đáp ứng các yêu cầu về chất lượng và độ tin cậy. |
Câu hỏi thường gặp
Cách tốt nhất để so sánh giá AI API là gì?
Cách tốt nhất để so sánh giá AI API là chuẩn hóa mọi tuyến thành chi phí trên mỗi kết quả được chấp nhận. Bao gồm token đầu vào, đầu vào đã cache, token đầu ra, đơn vị media, lệnh gọi công cụ, số lần thử lại, phí gateway và tỷ lệ chấp nhận của khối lượng công việc.
Tại sao giá AI API lại khác nhau nhiều như vậy?
Giá AI API khác nhau vì các nhà cung cấp sử dụng kiến trúc model, tier phục vụ, cửa sổ ngữ cảnh, quy tắc cache, giảm giá batch, đơn vị media và các tùy chọn khu vực hoặc ưu tiên khác nhau. Một giá đầu vào thấp không tự động có nghĩa là tuyến đó rẻ hơn cho khối lượng công việc của bạn.
Tôi nên dùng một nhà cung cấp hay một API đa nhà cung cấp?
Sử dụng một nhà cung cấp khi một họ model duy nhất bao phủ được khối lượng công việc và việc tách riêng hóa đơn là dễ quản lý. Sử dụng API đa nhà cung cấp khi bạn cần liên tục so sánh các tuyến, quản lý nhiều khóa, định tuyến giữa các model văn bản và media, hoặc đối soát mức sử dụng trong một sổ cái duy nhất.
Bao lâu thì nên kiểm tra lại giá?
Kiểm tra lại giá trước mỗi thay đổi định tuyến lớn, đợt rà soát hợp đồng, hoặc dự báo ngân sách. Với các khối lượng công việc sản xuất thay đổi nhanh, hãy lưu nguồn giá và ngày kiểm tra trong bảng tính chi phí của bạn để bộ phận tài chính và kỹ thuật có thể thấy khi nào các con số có thể đã lỗi thời.
Giá token thấp hơn có luôn làm giảm tổng chi tiêu AI không?
Không. Giá token thấp hơn có thể thua khi bạn tính đến prompt dài hơn, đầu ra dài hơn, tỷ lệ chấp nhận thấp hơn, các lần thử lại, các cuộc gọi dự phòng, việc sử dụng công cụ và chi phí quản trị bổ sung. Chỉ số bền vững là chi phí thực tế trên mỗi kết quả được chấp nhận.
Danh sách kiểm tra cuối cùng
Trước khi chọn một tuyến, hãy xác nhận:
- ID model, nguồn giá và ngày kiểm tra đã được ghi lại.
- Đầu vào, đầu vào đã cache, đầu ra, media và đơn vị công cụ được tách riêng.
- Chế độ batch hoặc ưu tiên được đánh dấu rõ ràng.
- Chi phí thử lại và dự phòng đã được tính vào.
- Tỷ lệ chấp nhận được đo bằng các tác vụ thực tế.
- Bộ phận mua sắm có thể đối soát hóa đơn và xuất sổ cái mức sử dụng.
- Quyết định cuối cùng dựa trên chi phí trên kết quả được chấp nhận, không chỉ dựa trên giá niêm yết.
Đó là so sánh giá API AI theo cách thực tế: giá nguồn hiện tại, lưu lượng phản ánh môi trường sản xuất, và một sổ cái mà cả tài chính lẫn kỹ thuật đều có thể tin cậy.


