
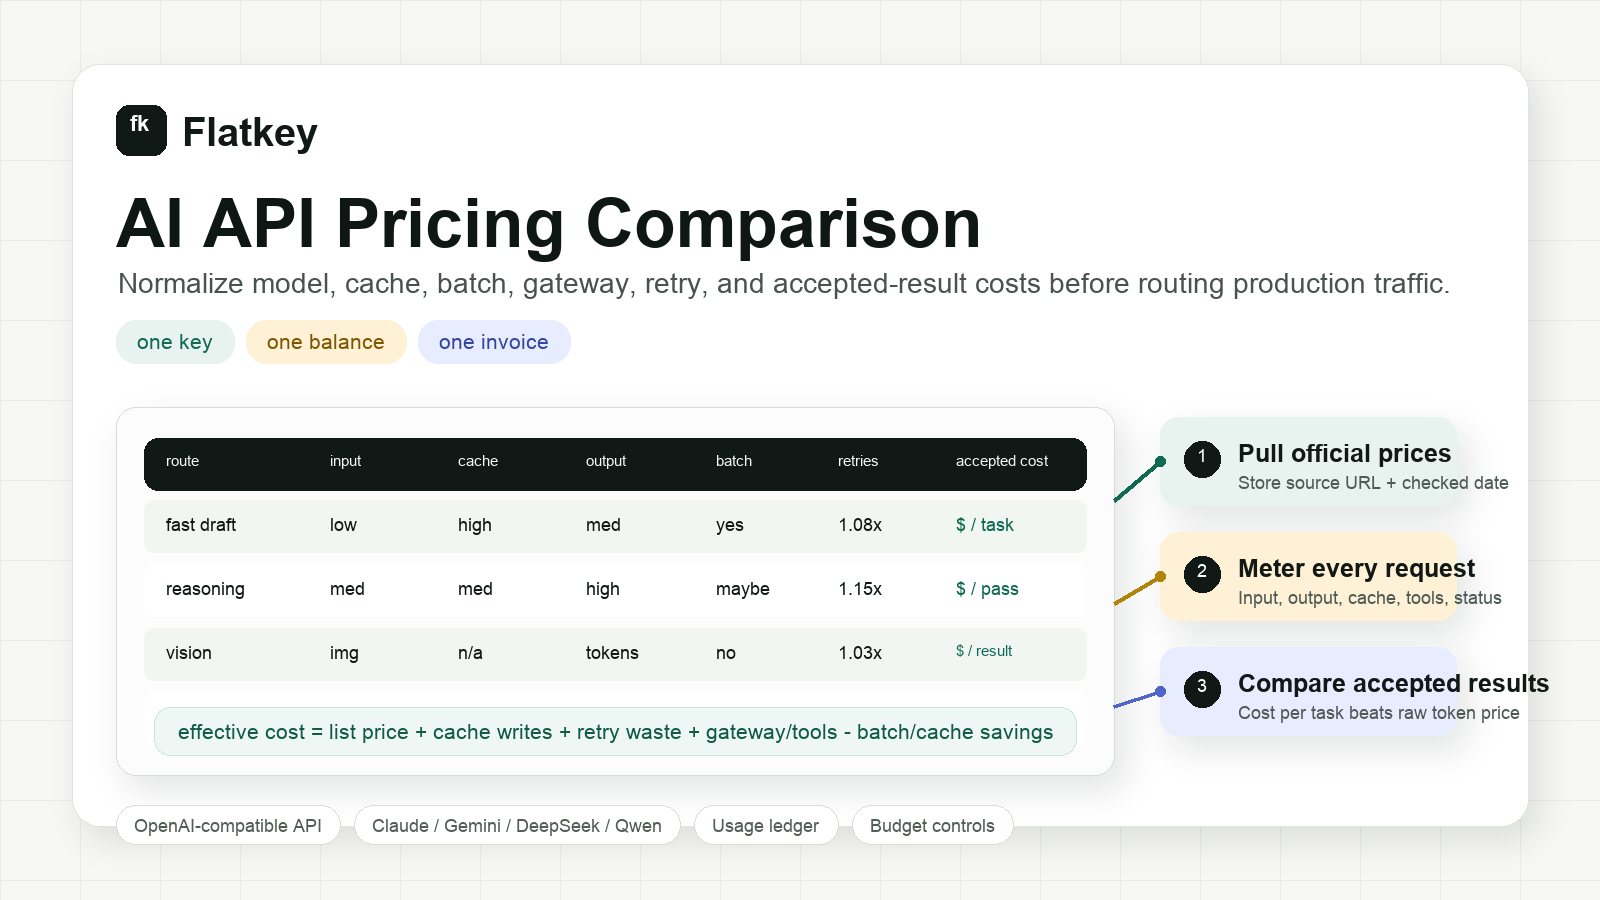
AI API 定价对比:模型、缓存、批处理和网关成本
只有当 AI API 定价对比与您的产品实际发送请求的方式一致时,它才真正有用。输入和输出 token 价格表只是起点,不是预算。真实支出会随着缓存输入、推理 token、重试、批处理折扣、工具调用、媒体生成、网关费用,以及用户接受的输出百分比而变化。
本指南为开发者、产品团队和采购团队提供一份实用工作表,用于比较 OpenAI、Anthropic Claude、Google Gemini、DeepSeek、阿里云 Model Studio/Qwen,以及像 Flatkey 这样的多供应商 API 的 AI API 定价。
简而言之:比较每个被接受结果的成本,而不只是每百万 token 的标价。
快速 AI API 定价对比框架
在切换供应商、批准更大预算或将 agent 工作流投入生产之前,请使用这套标准化对比方法。
| 层级 | 比较什么 | 为什么会改变账单 |
|---|---|---|
| 模型标价 | 输入、缓存输入、输出、图像、音频、视频和工具调用费率 | 可见的价目表可能让一家供应商在提示词上更有优势,而另一家在生成结果上更有优势。 |
| 工作负载形态 | 平均输入 token、输出 token、可缓存前缀、媒体大小和工具调用 | 如果需要长提示词或重复重试,便宜的输出模型也可能变得昂贵。 |
| 折扣和模式 | 批处理 API、灵活/优先级层级、缓存命中、非高峰时段、承诺使用或用量条款 | 同一模型的经济性会因调度和延迟容忍度而不同。 |
| 可靠性成本 | 重试率、回退率、超时率和失败调用策略 | 重试浪费可能抹去较低标价的优势。 |
| 运营成本 | API 密钥、发票、用量导出、预算控制、数据保留和采购开销 | 财务和平台团队需要治理能力,而不仅仅是更便宜的 token。 |
| 被接受结果 | 接受率、人工编辑率、评测通过率或任务成功率 | 如果质量下降,最便宜的请求并不等于最便宜的结果。 |
对于任何 AI API 定价对比,请从这个公式开始:
每个被接受结果的有效成本 =
  (输入成本 + 缓存输入成本 + 输出成本 + 媒体/工具成本 + 网关成本 + 重试浪费)
  / 被接受结果数量
如果您只比较输入和输出 token 的标价,就会遗漏通常在上线后才出现的成本:缓存行为、重试、工具调用和财务对账。
当前定价来源表
供应商定价会经常变化。与其把一大张过时的费率表复制到规划文档中,不如维护一张实时来源表,记录官方 URL、检查日期,以及您必须标准化的定价维度。
| 供应商或路由 | 需检查的官方定价来源 | 需要记录的定价维度 | 对比备注 |
|---|---|---|---|
| OpenAI API | OpenAI API pricing | 输入、缓存输入、输出、批处理模式、微调、媒体、区域处理 | 适用于已经围绕 OpenAI 兼容请求模式构建的产品。请确认模型 ID,以及您使用的是标准定价还是批处理定价。 |
| Anthropic Claude API | Claude pricing | 输入、输出、提示缓存、批处理定价、模型家族、上下文窗口 | 非常适合编码、推理和 agent 任务;对于重复提示词,cache-write 和 cache-hit 行为很重要。 |
| Google Gemini API | Gemini API pricing | 免费/付费层、输入、输出、缓存、批处理模式、优先级/灵活选项、搜索 grounding | Gemini 定价会因模型家族和服务模式而异。请记录是否会产生搜索或 grounding 费用。 |
| DeepSeek API | DeepSeek API pricing | 输入缓存未命中、输入缓存命中、输出、高峰/非高峰时段、模型别名 | 类似 DeepSeek 的 cache-hit 和时间窗口定价,需要带有时间戳和缓存状态的请求日志。 |
| 阿里云 Model Studio / Qwen | Alibaba Model Studio models | 模型家族、模态、区域、token 或媒体单位、控制台模型 ID | 适用于 Qwen 和中国区模型访问。请查看具体模型详情页以确认计费单位。 |
| Flatkey 多供应商 API | Flatkey pricing 和 Flatkey models | 统一模型路由、单一余额、按请求账本、工具调用、发票、子密钥预算 | 当您需要一个密钥、一个余额以及跨多个官方模型和工具的统一用量账本时非常有用。 |
为每一行添加三个必需字段:检查日期、模型 ID和单位。“每 100 万 token 的 $”无法与“每张图片的 $”、“每秒视频的 $”、“每次工具调用的 $”或“优先级层级”进行比较。
在谈判之前先建立工作表
一份经得起长期使用的 AI API 定价对比表,需要包含与生产流量相匹配的列。
| 列 | 示例值 | 重要原因 |
|---|---|---|
| 提供商 | Anthropic, OpenAI, Google, DeepSeek, Alibaba, Flatkey route | 将直连提供商和网关路由分开。 |
| 模型或路由 ID | claude-*, gpt-*, gemini-*, deepseek-*, qwen-* |
避免在不同模型层级之间进行无声比较。 |
| 定价来源 URL | 官方提供商页面或 Flatkey 模型页面 | 使采购审核可追溯。 |
| 检查日期 | 2026-10-12 |
定价变动速度可能比合同审查更快。 |
| 每个任务的输入 token 数 | 8,000 |
长提示词会迅速改变经济性。 |
| 可缓存输入占比 | 65% |
稳定的系统提示词和检索前缀可能更便宜。 |
| 每个任务的输出 token 数 | 1,200 |
推理和冗长回答会提高输出成本。 |
| 是否可批处理 | yes/no | 离线任务可能符合更低的批处理费率。 |
| 工具/媒体调用 | search, browser, image, video, enrichment | 智能体工作流不只是纯文本。 |
| 重试倍率 | 1.08x |
超时和回退尝试会增加隐藏支出。 |
| 接受率 | 82% |
低质量输出会抬高每个被接受结果的成本。 |
| 治理成本 | invoice, budget cap, export, audit need | 即使 token 费率很低,采购成本也是真实存在的。 |
不要把所有模型平均到一行里。应按工作负载拆分:聊天、RAG、编码智能体、数据提取、批处理分类、图像生成、视频生成,以及工具密集型智能体运行。
将直连提供商定价与多提供商 API 进行比较
当一个模型家族能处理你大部分工作,并且财务团队能接受多个供应商时,直连提供商账号最简单。当你需要持续比较模型、按工作负载路由,或管理大量密钥和发票时,多提供商 API 会更有用。
| 决策点 | 以下情况时,直连提供商账号可能就足够了... | 以下情况时,多提供商 API 更有帮助... |
|---|---|---|
| 模型选择 | 一个提供商能赢下大多数任务。 | 不同工作负载需要 OpenAI、Claude、Gemini、DeepSeek、Qwen、图像、视频和工具路由。 |
| 工程投入 | 你的代码已经在调用一个提供商,而且很少变动。 | 你希望使用兼容 OpenAI 的路由,并减少集成重写。 |
| 成本控制 | 一张发票和一个仪表盘就足够接受。 | 你需要子密钥预算、模型白名单以及按请求导出的用量数据。 |
| 采购 | 可以管理多个独立合同。 | 重复合同、闲置席位和分散的提供商密钥会拖慢团队。 |
| 可靠性 | 偶发的提供商中断可以接受。 | 你需要回退策略,以及用于重试/回退成本的共享账本。 |
| 智能体工作流 | 应用只调用文本模型。 | 智能体会调用模型、网页搜索、浏览器操作、丰富化工具、图像和视频。 |
Flatkey 正是为第二列而构建:一个 API 密钥、一个余额、一张发票,以及覆盖 300+ 官方模型和 1,000+ 按次付费工具的请求账本。这并不会消除检查官方模型价格的需要。它为你的团队提供了一个统一的位置来路由、计量并对账这些成本。有关相关的网关费用拆分,请参见 AI gateway pricing。
五个工作负载示例
1. 支持聊天
支持聊天通常具有中等输入、较短输出和高请求量。比较以下内容:
- 系统提示词和策略文本的提示缓存命中率。
- 按回答类型划分的输出 token 预算。
- 升级到更强模型的比例。
- 按已解决对话计算的成本,而不仅仅是按消息计算的成本。
对于这类工作负载,如果更便宜的快速模型能保持较高的解决质量,那么它可能胜出。如果便宜模型增加了转交率或编辑率,看似的 token 节省就会消失。
2. 编码智能体
编码智能体通常具有较大的上下文、工具调用、较长输出以及多次重试。比较以下内容:
- 仓库搜索或文件读取后的上下文大小。
- 可缓存的项目指令。
- 每个被接受任务的工具调用次数。
- 来自过载路由的重试浪费。
- 每个合并变更或被接受补丁的成本。
这正是 AI API 定价对比需要账本的地方。单次智能体运行可能包含模型调用、工具调用、回退调用和失败尝试。
3. RAG 答案生成
RAG 工作负载主要由检索上下文和答案长度决定。比较以下内容:
- 平均检索到的 token 数。
- 稳定提示前缀占比。
- 重复文档的缓存行为。
- 引用和 grounding 成本。
- 事实性评估通过率。
不要仅仅因为某个模型的输入 token 很便宜就选择它。如果它需要两倍上下文,或者生成的答案无法通过评估,那么被接受答案的成本可能更高。如果这就是主要迁移问题,请使用 如何在切换提供商之前比较 AI 模型价格 中更深入的工作表。
4. 批处理分类
批处理分类通常可以容忍延迟结果。比较:
- 提供商是否有批处理或 flex 分层。
- 最大批量大小和完成窗口。
- 错误重放成本。
- 输出 schema 验证通过率。
- 每条被接受记录的总成本。
如果某个提供商提供更低的批处理定价,只有当你的工作流可以等待且重试流程干净时,这些节省才会生效。
5. 图像和视频生成
图像和视频 API 很少适合只按 token 的电子表格。比较:
- 输出单位:图像、秒、片段、分辨率或 credit。
- 生成失败的计费规则。
- 编辑/重新生成率。
- 人工批准率。
- 每个被接受创意资产的成本。
对于媒体流水线,请将 token 模型和生成模型放在不同的工作表标签页中。它们的单位经济性差异太大,不能混在同一行里。
七步 AI API 定价对比工作流
- 冻结工作负载。 选择一个真实任务族,例如客服回复、编码代理补丁、RAG 答案、批处理分类、图像生成或视频生成。
- 收集当前官方价格。 使用提供商定价页、Flatkey 模型页面以及经过核对的日期。避免使用没有来源 URL 的复制费率表。
- 回放代表性流量。 在所有路线中使用相同的提示、输入、输出上限、工具策略和验证器。
- 记录每一个可计费单位。 捕获输入 token、缓存 token、输出 token、媒体单位、工具调用、重试尝试、错误和状态。
- 评分已接受结果。 使用人工审核、自动验证器或特定任务的通过/失败检查。
- 计算有效成本。 用总路线成本除以被接受结果,而不是总请求数。
- 加入运营控制。 确定获胜路线是否也满足预算上限、发票需求、密钥治理、数据保留和故障事件回退。
这样得到的是一个你可以向工程和财务部门证明的定价决策。
Flatkey 的作用
Flatkey 不是静态价格表。它是面向需要在生产环境中进行真实 AI API 定价对比的团队的路由和计费层。要查看 token、图像和视频成本的更广泛模型级视图,请从 AI 模型定价对比 开始。
当你希望:
- 通过一个 API key 调用多个官方模型。
- 将模型和工具使用统一到一个余额中。
- 在不把提供商密钥散落到各个 agent 和代码仓库中的情况下比较路由。
- 在一个账本中跟踪输入、输出、缓存 token、工具调用、状态和成本。
- 为团队提供子密钥预算和模型允许列表。
- 对一张发票而不是多个提供商控制台进行对账。
当比较本身已经变成一个运营问题时,就从 Flatkey 开始。如果你的团队已经明确知道哪个提供商获胜,并且不需要跨提供商路由,那么直接账户可能就足够了。当财务需要 owner、key 和预算责任时,请将此工作表与 AI API 支出管理 和 AI API 配额控制 配合使用。
AI API 定价对比中的常见错误
| 错误 | 替代做法 |
|---|---|
| 只比较输入 token 费率 | 比较输入、缓存输入、输出、重试和被接受结果。 |
| 把文本、图像、视频和工具混在一个单位里 | 分别标准化每种模态,然后汇总到被接受的工作流成本。 |
| 忽视提示缓存 | 测量稳定的提示前缀和缓存命中率。 |
| 忽视批处理资格 | 将低延迟敏感任务和离线任务分开。 |
| 相信过时的复制价格表 | 保存官方来源 URL 和核对日期。 |
| 把网关只当作加价 | 把治理、故障转移、使用导出、发票和工程时间都计算进去。 |
| 选择最便宜的请求 | 选择满足质量和可靠性要求的最便宜被接受结果。 |
常见问题
比较 AI API 定价的最佳方式是什么?
比较 AI API 定价的最佳方式是将每条路由标准化为每个被接受结果的成本。包括输入 token、缓存输入、输出 token、媒体单位、工具调用、重试、网关费用,以及该工作负载的接受率。
为什么 AI API 价格差异这么大?
AI API 价格差异很大,是因为提供商使用了不同的模型架构、服务层级、上下文窗口、缓存规则、批处理折扣、媒体单位以及区域或优先级选项。较低的输入价格并不自动意味着该路由对你的工作负载更便宜。
我应该使用单一提供商还是多提供商 API?
当单一模型家族能够覆盖工作负载且易于管理单独计费时,使用一个提供商。当您需要持续比较路由、管理多个密钥、在文本和媒体模型之间进行路由,或在一个总账中对使用情况进行核对时,使用多提供商 API。
应多久重新检查一次定价?
在每次重大的路由变更、合同审查或预算预测之前,都应重新检查定价。对于快速变化的生产工作负载,请在成本工作表中记录定价来源和检查日期,这样财务和工程团队就能看到这些数字何时可能已过时。
更低的 token 价格是否总能降低 AI 总支出?
不会。将更长的提示、更长的输出、更低的接受率、重试、回退调用、工具使用以及额外的治理开销都计入后,更低的 token 价格可能并不划算。更可靠的指标是每个已接受结果的有效成本。
最终检查清单
在选择路由之前,请确认:
- 已记录模型 ID、定价来源和检查日期。
- 输入、缓存输入、输出、媒体和工具单位已分开。
- 批处理或优先级模式已明确标记。
- 已包含重试和回退成本。
- 已使用真实任务测量接受率。
- 采购部门可以核对发票并导出使用总账。
- 最终决策基于已接受结果的成本,而不只是标价。
这就是实用的 AI API 定价对比:当前的来源价格、贴近生产的流量,以及一份财务和工程团队都能信任的总账。


