
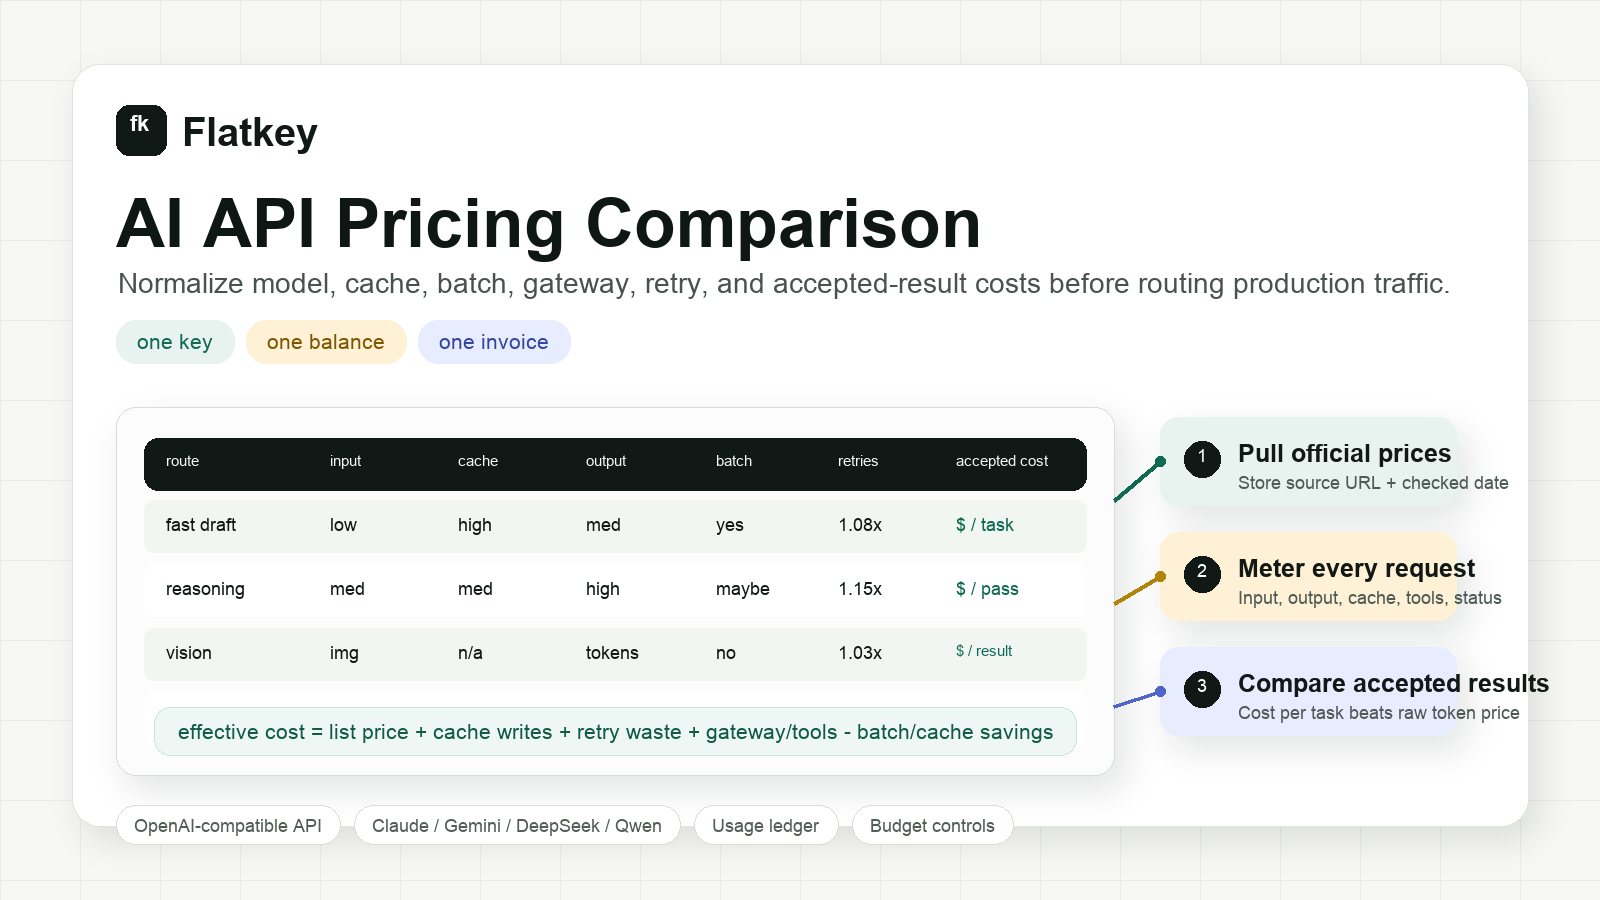
AI API料金比較: モデル、キャッシュ、バッチ、ゲートウェイのコスト
AI APIの料金比較は、実際にあなたの製品がどのようにリクエストを送るかに合っている場合にのみ有用です。入力および出力トークン単価の表は出発点であって、予算そのものではありません。実際の支出は、キャッシュされた入力、推論トークン、再試行、バッチ割引、ツール呼び出し、メディア生成、ゲートウェイ手数料、そしてユーザーが受け入れる出力の割合によって変わります。
このガイドでは、開発者、プロダクトチーム、調達チーム向けに、OpenAI、Anthropic Claude、Google Gemini、DeepSeek、Alibaba Model Studio/Qwen、そして Flatkey のようなマルチプロバイダーAPIにまたがるAI API料金を比較するための実用的なワークシートを提供します。
短く言えば、受け入れられた結果あたりのコストを比較し、1百万トークンあたりの表示価格だけを見ないことです。
AI API料金比較のクイックフレームワーク
プロバイダーを切り替える前、より大きな予算を承認する前、あるいはエージェントのワークフローを本番環境に投入する前に、この正規化された比較を使ってください。
| レイヤー | 比較する項目 | 請求額が変わる理由 |
|---|---|---|
| モデルの表示価格 | 入力、キャッシュされた入力、出力、画像、音声、動画、ツール呼び出しの料金 | 見える料金表では、あるプロバイダーがプロンプトに有利で、別のプロバイダーが応答生成に有利になることがあります。 |
| ワークロードの形状 | 平均入力トークン数、出力トークン数、キャッシュ可能なプレフィックス、メディアサイズ、ツール呼び出し | 出力単価が安いモデルでも、長いプロンプトや繰り返しの再試行が必要なら高くつくことがあります。 |
| 割引とモード | Batch API、flex/priority tier、キャッシュヒット、オフピーク枠、コミット利用、またはボリューム条件 | 同じモデルでも、スケジューリングとレイテンシ許容度によって経済性が変わります。 |
| 信頼性コスト | 再試行率、フォールバック率、タイムアウト率、失敗呼び出しポリシー | 再試行による無駄は、低い表示価格の優位性を打ち消すことがあります。 |
| 運用コスト | APIキー、請求書、利用エクスポート、予算管理、データ保持、調達オーバーヘッド | 財務チームとプラットフォームチームに必要なのは、安いトークンだけでなくガバナンスです。 |
| 受け入れられた結果 | 受け入れ率、手動編集率、評価者の合格率、または成功タスク率 | 品質が低下するなら、最も安いリクエストが最も安い結果とは限りません。 |
あらゆるAI API料金比較では、まず次の式から始めてください:
accepted result あたりの実効コスト =
  (input cost + cached-input cost + output cost + media/tool cost + gateway cost + retry waste)
  / accepted-result count
入力と出力のトークン表示価格だけを比較すると、通常はリリース後に現れるコスト、つまりキャッシュ挙動、再試行、ツール呼び出し、会計照合を見落とします。
現在の料金ソース表
プロバイダーの価格は頻繁に変わります。大きく古くなった料金表を計画書にコピーする代わりに、公式URL、確認日、そして正規化すべき価格の次元を含むライブのソース表を維持してください。
| プロバイダーまたはルート | 確認する公式価格ソース | 記録する価格の次元 | 比較のための注記 |
|---|---|---|---|
| OpenAI API | OpenAI API pricing | 入力、キャッシュされた入力、出力、バッチモード、ファインチューニング、メディア、リージョン処理 | OpenAI互換のリクエストパターンをすでに前提にした製品に有用です。モデルIDと、標準料金かバッチ料金かを確認してください。 |
| Anthropic Claude API | Claude pricing | 入力、出力、プロンプトキャッシュ、バッチ料金、モデルファミリー、コンテキストウィンドウ | コーディング、推論、エージェントタスクに強みがあります。繰り返しプロンプトではキャッシュ書き込みとキャッシュヒットの挙動が重要です。 |
| Google Gemini API | Gemini API pricing | 無料/有料ティア、入力、出力、キャッシュ、バッチモード、priority/flexオプション、search grounding | Geminiの価格はモデルファミリーと提供モードによって異なる場合があります。検索やgroundingの課金が適用されるかを記録してください。 |
| DeepSeek API | DeepSeek API pricing | 入力キャッシュミス、入力キャッシュヒット、出力、ピーク/オフピークの時間帯、モデルエイリアス | DeepSeek型のキャッシュヒットおよび時間帯料金には、タイムスタンプとキャッシュ状態を含むリクエストログが必要です。 |
| Alibaba Model Studio / Qwen | Alibaba Model Studio models | モデルファミリー、モダリティ、リージョン、トークンまたはメディア単位、コンソールのモデルID | Qwenおよび中国リージョンのモデル利用に有用です。課金単位は、正確なモデル詳細ページで確認してください。 |
| Flatkey multi-provider API | Flatkey pricing and Flatkey models | 統合されたモデルルート、1つの残高、リクエストごとの台帳、ツール呼び出し、請求書、サブキー予算 | 多くの公式モデルとツールにまたがって、1つのキー、1つの残高、1つの利用台帳が必要な場合に有用です。 |
各行に次の3項目を追加してください: 確認日、モデルID、単位。「$ per 1M tokens」は、「$ per image」、「$ per video second」、「$ per tool call」、または「priority tier」とは比較できません。
交渉前にワークシートを作成する
持続的な AI API 料金比較シートには、本番トラフィックを反映する列が必要です。
| 列 | 例の値 | 重要な理由 |
|---|---|---|
| プロバイダー | Anthropic、OpenAI、Google、DeepSeek、Alibaba、Flatkey route | 直接プロバイダーとゲートウェイ経由のルートを分けて管理できます。 |
| モデルまたはルートID | claude-*、gpt-*、gemini-*、deepseek-*、qwen-* |
異なるモデル階層同士の、気づきにくい比較を防ぎます。 |
| 料金ソースURL | 公式プロバイダーページまたは Flatkey のモデルページ | 調達レビューの追跡可能性が高まります。 |
| 確認日 | 2026-10-12 |
料金は契約レビューより速く変わることがあります。 |
| タスクあたりの入力トークン数 | 8,000 |
長いプロンプトは経済性をすぐに変えます。 |
| キャッシュ可能な入力の割合 | 65% |
安定したシステムプロンプトや検索プレフィックスは、より安くなる場合があります。 |
| タスクあたりの出力トークン数 | 1,200 |
推論や冗長な回答は出力コストを押し上げます。 |
| バッチ対象 | yes/no | オフラインジョブは、より低いバッチ料金の対象になる場合があります。 |
| ツール/メディア呼び出し | search、browser、image、video、enrichment | エージェントのワークフローはテキストだけではありません。 |
| リトライ倍率 | 1.08x |
タイムアウトやフォールバック試行は、見えにくい支出を追加します。 |
| 承認率 | 82% |
品質の低い出力は、承認済み結果あたりのコストを増やします。 |
| ガバナンスコスト | 請求書、予算上限、エクスポート、監査の必要性 | トークン単価が低くても、調達コストは現実に発生します。 |
すべてのモデルを1行に平均化しないでください。ワークロードごとに分けます: チャット、RAG、コーディングエージェント、データ抽出、バッチ分類、画像生成、動画生成、ツール多用型エージェント実行。
直接プロバイダー料金とマルチプロバイダーAPIを比較する
1つのモデルファミリーが作業の大半を担い、財務チームがベンダー分離に慣れているなら、直接プロバイダーのアカウントが最もシンプルです。モデルを継続的に比較したい、ワークロード別にルーティングしたい、多数のキーと請求書を統制したい場合は、マルチプロバイダーAPIのほうが有用になります。
| 判断ポイント | 次のような場合は直接プロバイダーのアカウントで十分なことがある... | 次のような場合はマルチプロバイダーAPIが役立つ... |
|---|---|---|
| モデル選択 | 1つのプロバイダーがほとんどのタスクで最適。 | 異なるワークロードごとに OpenAI、Claude、Gemini、DeepSeek、Qwen、画像、動画、ツールの各ルートが必要。 |
| エンジニアリング工数 | コードはすでに1つのプロバイダーを呼び出しており、変更もほとんどない。 | OpenAI互換のルーティングと、統合作業の書き換え削減を望んでいる。 |
| コスト管理 | 請求書が1つでダッシュボードも1つで問題ない。 | サブキーごとの予算、モデルの許可リスト、リクエストごとの利用エクスポートが必要。 |
| 調達 | 個別契約を管理できる。 | 重複契約、遊休席、分散したプロバイダーキーがチームの動きを鈍らせる。 |
| 信頼性 | たまのプロバイダー障害は許容できる。 | フォールバックポリシーと、リトライ/フォールバックコストを共有する台帳が必要。 |
| エージェントワークフロー | アプリがテキストモデルしか呼ばない。 | エージェントがモデル、Web検索、ブラウザー操作、エンリッチメントツール、画像、動画を呼び出す。 |
Flatkey は後者向けに構築されています: 1つの API キー、1つの残高、1つの請求書、そして300以上の公式モデルと1,000以上の従量課金ツールにまたがるリクエスト台帳です。これは公式モデル価格を確認する必要をなくすものではありません。チームがそれらのコストを1か所でルーティング、計測、照合できるようにします。関連するゲートウェイ料金の内訳については、AI gateway pricing を参照してください。
5つのワークロード例
1. サポートチャット
サポートチャットは通常、入力は中程度、出力は短め、かつ高頻度です。比較する項目は次のとおりです。
- システムプロンプトとポリシーテキストのプロンプトキャッシュヒット率。
- 回答タイプごとの出力トークン予算。
- より強力なモデルへのエスカレーション率。
- メッセージごとのコストではなく、解決済み会話あたりのコスト。
このワークロードでは、より安い高速モデルでも、解決品質を高く保てるなら有利です。安いモデルが引き継ぎや修正の回数を増やすなら、見かけのトークン節約は消えてしまいます。
2. コーディングエージェント
コーディングエージェントは、長いコンテキスト、ツール呼び出し、長文出力、複数回の再試行を伴うことがよくあります。比較する項目は次のとおりです。
- リポジトリ検索やファイル読み込み後のコンテキストサイズ。
- キャッシュ可能なプロジェクト指示。
- 承認済みタスクごとのツール呼び出し回数。
- 過負荷ルートによるリトライの無駄。
- マージ済み変更または承認済みパッチあたりのコスト。
ここでは、AI API の料金比較に台帳が必要になります。1回のエージェント実行に、モデル呼び出し、ツール呼び出し、フォールバック呼び出し、失敗試行が含まれる場合があるからです。
3. RAG回答生成
RAG ワークロードは、検索で取得したコンテキストと回答長によって支配されます。比較する項目は次のとおりです。
- 平均取得トークン数。
- 安定したプロンプトプレフィックスの割合。
- 繰り返し文書に対するキャッシュ挙動。
- 引用と根拠づけのコスト。
- 事実性に関する評価器の通過率。
入力トークンが安いという理由だけでモデルを選ばないでください。必要なコンテキストが2倍になったり、評価に失敗する回答を生成したりする場合、承認済み回答あたりのコストは高くなる可能性があります。これが主な移行検討事項であれば、AIモデル価格の比較方法の詳細なワークシートを使用してください。
4. バッチ分類
バッチ分類は、遅延した結果でも許容できることがよくあります。以下を比較してください:
- プロバイダーにバッチまたはフレックスタイアがあるか。
- 最大バッチサイズと完了ウィンドウ。
- エラー再実行コスト。
- 出力スキーマ検証の合格率。
- 承認済み行あたりの総コスト。
プロバイダーがより低いバッチ価格を提供していても、その節約はワークフローが待機でき、再試行プロセスが適切に整備されている場合にのみ適用されます。
5. 画像と動画の生成
画像と動画のAPIは、トークンのみのスプレッドシートに収まりにくいです。以下を比較してください:
- 出力単位: 画像、秒、クリップ、解像度、またはクレジット。
- 生成失敗時の課金ルール。
- 編集/再生成率。
- 人間による承認率。
- 承認済みクリエイティブ資産あたりのコスト。
メディアパイプラインでは、トークンモデルと生成モデルを別々のワークシートタブに分けてください。単位経済が大きく異なるため、1つの混在行には適していません。
7ステップのAI API料金比較ワークフロー
- ワークロードを固定する。 サポート回答、コーディングエージェントのパッチ、RAG回答、バッチ分類、画像生成、動画生成など、1つの実際のタスクファミリーを選びます。
- 現在の公式価格を収集する。 プロバイダーの料金ページ、Flatkeyのモデルページ、確認済みの日付を使用します。出典URLのない転載された料金表は避けてください。
- 代表的なトラフィックを再実行する。 ルート全体で同じプロンプト、入力、出力上限、ツールポリシー、バリデーターを使用します。
- 課金対象のすべての単位を記録する。 入力トークン、キャッシュ済みトークン、出力トークン、メディア単位、ツール呼び出し、再試行回数、エラー、ステータスを取得します。
- 承認済み結果を採点する。 人手レビュー、自動バリデーター、またはタスク固有の合否チェックを使用します。
- 実効コストを計算する。 総ルートコストを総リクエスト数ではなく承認済み結果数で割ります。
- 運用上の制御を追加する。 勝利したルートが、予算上限、請求書要件、キーガバナンス、データ保持、インシデント時のフォールバックも満たすかを決定します。
その結果、エンジニアリングと財務の両方に対して説明可能な価格判断が得られます。
Flatkeyの位置づけ
Flatkeyは静的な価格表ではありません。実運用で本当のAI API料金比較を行う必要があるチーム向けのルーティングおよび請求レイヤーです。トークン、画像、動画コストをまたぐ、より広いモデルレベルの見方については、AIモデル料金比較から始めてください。
以下の目的がある場合はFlatkeyを使用してください:
- 1つのAPIキーで多数の公式モデルを呼び出す。
- モデルとツールの使用量を1つの残高で管理する。
- プロバイダーのキーをエージェントやリポジトリ全体に分散させずにルートを比較する。
- 入力、出力、キャッシュ済みトークン、ツール呼び出し、ステータス、コストを1つの台帳で追跡する。
- チームにサブキー予算とモデル許可リストを付与する。
- 複数のプロバイダーダッシュボードではなく、1つの請求書を照合する。
比較作業そのものが運用上の問題になったら、Flatkeyから始めてください。チームがどのプロバイダーが勝つかをすでに正確に把握しており、プロバイダー横断ルーティングを必要としないなら、直接アカウントで十分かもしれません。財務が所有者、キー、予算の責任を求める場合は、このワークシートをAI API支出管理およびAI APIクォータ制御と組み合わせてください。
AI API料金比較でよくあるミス
| ミス | 代わりに行うこと |
|---|---|
| 入力トークンレートだけを比較する | 入力、キャッシュ済み入力、出力、再試行、承認済み結果を比較する。 |
| テキスト、画像、動画、ツールを1つの単位で混在させる | 各モダリティを個別に正規化し、その後で承認済みワークフローコストを集計する。 |
| プロンプトキャッシュを無視する | 安定したプロンプト接頭辞とキャッシュヒット率を測定する。 |
| バッチ適格性を無視する | レイテンシー重視のジョブとオフラインジョブを分ける。 |
| 古いコピー済み価格表を信頼する | 公式の出典URLと確認日を保存する。 |
| ゲートウェイを単なる上乗せ料金とみなす | ガバナンス、フェイルオーバー、利用量のエクスポート、請求書、エンジニアリング時間を含める。 |
| 最安リクエストを選ぶ | 品質と信頼性要件を満たす、最も安い承認済み結果を選ぶ。 |
よくある質問
AI API料金を比較する最善の方法は何ですか?
AI API料金を比較する最善の方法は、すべてのルートを承認済み結果あたりのコストに正規化することです。入力トークン、キャッシュ済み入力、出力トークン、メディア単位、ツール呼び出し、再試行、ゲートウェイ料金、そしてワークロードの承認率を含めてください。
なぜAI APIの価格は এতも大きく異なるのですか?
AI APIの価格が異なるのは、プロバイダーごとにモデルアーキテクチャ、提供ティア、コンテキストウィンドウ、キャッシュルール、バッチ割引、メディア単位、地域または優先オプションが異なるためです。入力価格が低いからといって、そのルートが必ずしもあなたのワークロードで安いとは限りません。
1つのプロバイダーを使うべきですか、それともマルチプロバイダーAPIを使うべきですか?
単一のモデルファミリーでワークロードをカバーでき、個別請求の管理が容易な場合は、1つのプロバイダーを使ってください。ルートを継続的に比較する必要がある、複数のキーを管理する必要がある、テキストモデルとメディアモデルをまたいでルーティングする必要がある、または1つの台帳で使用状況を突き合わせる必要がある場合は、マルチプロバイダーAPIを使ってください。
価格はどのくらいの頻度で再確認すべきですか?
主要なルーティング変更、契約レビュー、または予算予測の前には、必ず価格を再確認してください。変化の速い本番ワークロードでは、財務とエンジニアリングの双方が数値の鮮度切れを把握できるよう、コストシートに価格の出典と確認日を記録しておきます。
トークン単価が低ければ、必ず総AI支出も下がりますか?
いいえ。長いプロンプト、長い出力、低い採用率、再試行、フォールバック呼び出し、ツール利用、追加のガバナンスオーバーヘッドを含めると、より低いトークン単価が不利になることがあります。長期的に有効な指標は、承認済み結果1件あたりの実効コストです。
最終チェックリスト
ルートを選ぶ前に、次を確認してください:
- モデルID、価格の出典、確認日が記録されている。
- 入力、キャッシュ済み入力、出力、メディア、およびツールの単位が分けられている。
- バッチモードまたは優先度モードが明示的に示されている。
- 再試行とフォールバックのコストが含まれている。
- 実際のタスクで採用率が測定されている。
- 調達部門が請求書を照合し、使用実績台帳をエクスポートできる。
- 最終判断が、定価だけでなく承認済み結果のコストに基づいている。
これが実践的なAI API価格比較です。最新のソース価格、本番に即したトラフィック、そして財務とエンジニアリングの双方が信頼できる台帳。


