
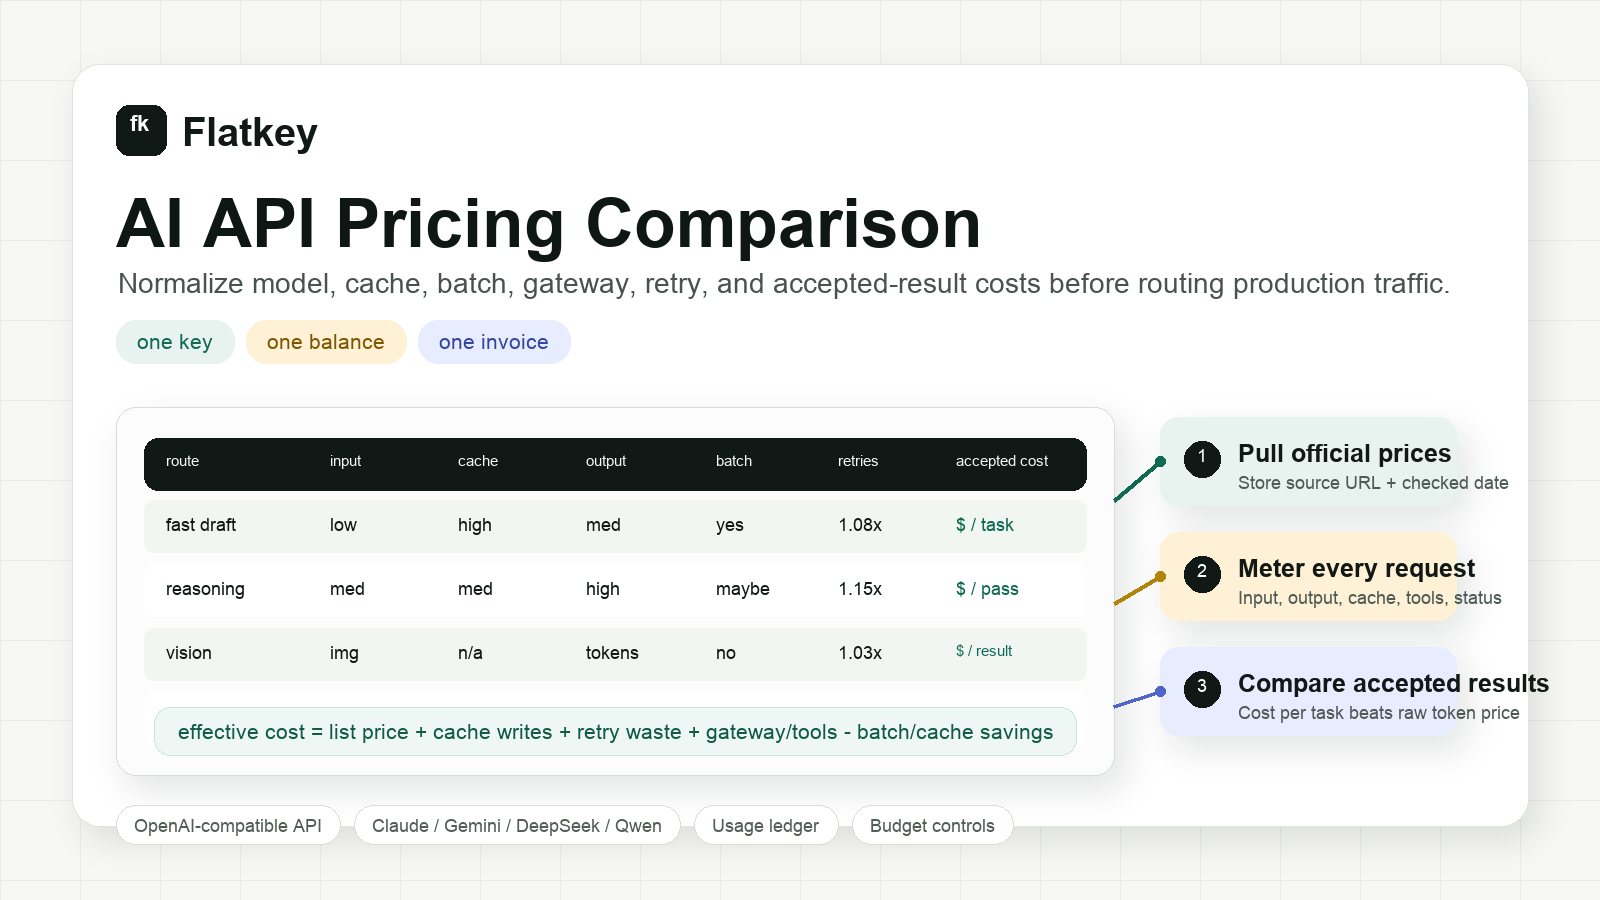
Comparación de precios de API de IA: costos de modelo, caché, lote y gateway
Una comparación de precios de API de IA solo es útil cuando coincide con la forma en que tu producto realmente envía solicitudes. Una tabla de precios de tokens de entrada y salida es un punto de partida, no un presupuesto. El gasto real cambia con la entrada en caché, los tokens de razonamiento, los reintentos, los descuentos por lote, las llamadas a herramientas, la generación de medios, las tarifas de gateway y el porcentaje de resultados que aceptan tus usuarios.
Esta guía ofrece a desarrolladores, equipos de producto y equipos de compras una hoja de trabajo práctica para comparar precios de API de IA entre OpenAI, Anthropic Claude, Google Gemini, DeepSeek, Alibaba Model Studio/Qwen y una API multproveedor como Flatkey.
La versión breve: compara el coste por resultado aceptado, no solo el precio de lista por millón de tokens.
El marco rápido de comparación de precios de API de IA
Usa esta comparación normalizada antes de cambiar de proveedor, aprobar un presupuesto mayor o poner en producción un flujo de trabajo con agentes.
| Capa | Qué comparar | Por qué cambia tu factura |
|---|---|---|
| Precio de lista del modelo | Tarifas de entrada, entrada en caché, salida, imagen, audio, video y llamadas a herramientas | La tarifa visible puede favorecer a un proveedor para prompts y a otro para completions. |
| Forma de la carga de trabajo | Tokens promedio de entrada, tokens de salida, prefijo que se puede cachear, tamaño de medios y llamadas a herramientas | Un modelo de salida barato puede volverse caro si necesita prompts largos o reintentos repetidos. |
| Descuentos y modos | API de lote, niveles flex/prioridad, aciertos de caché, ventanas fuera de hora pico, uso comprometido o términos por volumen | El mismo modelo puede tener una economía distinta según la programación y la tolerancia a la latencia. |
| Costo de fiabilidad | Tasa de reintentos, tasa de fallback, tasa de timeout y política de llamadas fallidas | El desperdicio por reintentos puede anular la ventaja de un precio de lista más bajo. |
| Costo operativo | Claves de API, facturas, exportaciones de uso, controles de presupuesto, retención de datos y sobrecarga de compras | Los equipos de finanzas y de plataforma necesitan gobernanza, no solo tokens más baratos. |
| Resultado aceptado | Tasa de aceptación, tasa de edición humana, tasa de aprobación del evaluador o tasa de tareas exitosas | La solicitud más barata no es el resultado más barato si la calidad baja. |
Para cualquier comparación de precios de API de IA, empieza con esta fórmula:
coste efectivo por resultado aceptado =
  (coste de entrada + coste de entrada en caché + coste de salida + coste de medios/herramientas + coste de gateway + desperdicio por reintentos)
  / número de resultados aceptados
Si solo comparas los precios de lista de tokens de entrada y salida, te perderás los costos que suelen aparecer después del lanzamiento: comportamiento de caché, reintentos, llamadas a herramientas y conciliación financiera.
Tabla actual de fuentes de precios
Los precios de los proveedores cambian con frecuencia. En lugar de copiar una gran tabla de tarifas desactualizada en tu documento de planificación, mantén una tabla de fuentes en vivo con la URL oficial, la fecha de comprobación y las dimensiones de precio que debes normalizar.
| Proveedor o ruta | Fuente oficial de precios a consultar | Dimensiones de precio a capturar | Notas para la comparación |
|---|---|---|---|
| OpenAI API | Precios de la API de OpenAI | Entrada, entrada en caché, salida, modo lote, ajuste fino, medios, procesamiento regional | Útil para productos ya construidos en torno a patrones de solicitud compatibles con OpenAI. Confirma los ID de modelo y si estás usando precios estándar o por lote. |
| Anthropic Claude API | Precios de Claude | Entrada, salida, caché de prompts, precios por lote, familia de modelos, ventana de contexto | Fuerte para programación, razonamiento y tareas de agentes; el comportamiento de escritura y lectura de caché importa para prompts repetidos. |
| Google Gemini API | Precios de la API de Gemini | Nivel gratuito/de pago, entrada, salida, caché, modo lote, opciones priority/flex, grounding de búsqueda | Los precios de Gemini pueden variar según la familia de modelos y el modo de servicio. Captura si se aplican cargos por búsqueda o grounding. |
| DeepSeek API | Precios de la API de DeepSeek | Fallo de caché de entrada, acierto de caché de entrada, salida, temporización pico/fuera de pico, alias del modelo | El precio por acierto de caché y por ventana temporal al estilo DeepSeek requiere registros de solicitudes con marca de tiempo y estado de caché. |
| Alibaba Model Studio / Qwen | Modelos de Alibaba Model Studio | Familia de modelos, modalidad, región, token o unidad de medios, ID de modelo en consola | Útil para Qwen y acceso a modelos en la región de China. Consulta la página exacta de detalles del modelo para ver la unidad facturable. |
| Flatkey multi-provider API | Precios de Flatkey y Modelos de Flatkey | Rutas unificadas de modelos, un saldo, libro mayor por solicitud, llamadas a herramientas, facturas, presupuestos de subclaves | Útil cuando necesitas una clave, un saldo y un libro mayor de uso en muchos modelos y herramientas oficiales. |
Añade tres campos obligatorios a cada fila: fecha de comprobación, ID de modelo y unidad. “$ por 1M tokens” no es comparable con “$ por imagen”, “$ por segundo de video”, “$ por llamada a herramienta” o “nivel priority”.
Construye la hoja de trabajo antes de negociar
Una hoja de cálculo duradera para comparar precios de API de IA necesita columnas que reflejen el tráfico de producción.
| Columna | Valor de ejemplo | Por qué importa |
|---|---|---|
| Proveedor | Anthropic, OpenAI, Google, DeepSeek, Alibaba, ruta Flatkey | Mantiene separadas las rutas de proveedor directo y de gateway. |
| ID de modelo o ruta | claude-*, gpt-*, gemini-*, deepseek-*, qwen-* |
Evita comparaciones silenciosas entre distintos niveles de modelo. |
| URL de la fuente de precios | Página oficial del proveedor o página del modelo de Flatkey | Hace trazable la revisión de compras. |
| Fecha de verificación | 2026-10-12 |
Los precios pueden cambiar más rápido que las revisiones de contratos. |
| Tokens de entrada por tarea | 8,000 |
Los prompts largos cambian la economía rápidamente. |
| Proporción de entrada que se puede cachear | 65% |
Los prompts del sistema estables y los prefijos de recuperación pueden resultar más baratos. |
| Tokens de salida por tarea | 1,200 |
El razonamiento y las respuestas extensas aumentan el costo de salida. |
| Apto para lote | sí/no | Los trabajos sin conexión pueden calificar para tarifas de lote más bajas. |
| Llamadas de herramientas/medios | search, browser, image, video, enrichment | Los flujos de trabajo de agentes no son solo de texto. |
| Multiplicador de reintento | 1.08x |
Los timeouts y los intentos de respaldo añaden gasto oculto. |
| Tasa de aceptación | 82% |
La salida de baja calidad aumenta el costo por resultado aceptado. |
| Costo de gobernanza | factura, límite de presupuesto, exportación, necesidad de auditoría | El costo de compras es real incluso cuando las tarifas por token son bajas. |
No promedies todos los modelos en una sola fila. Sepáralos por carga de trabajo: chat, RAG, agente de código, extracción de datos, clasificación por lote, generación de imágenes, generación de video y ejecuciones de agentes con muchas herramientas.
Compara los precios de proveedor directo con una API multi-proveedor
Las cuentas de proveedor directo son más simples cuando una familia de modelos maneja la mayor parte de tu trabajo y tu equipo financiero se siente cómodo con proveedores separados. Una API multi-proveedor se vuelve más útil cuando necesitas comparar modelos de forma continua, enrutar por carga de trabajo o gobernar muchas claves y facturas.
| Punto de decisión | Las cuentas de proveedor directo pueden ser suficientes cuando... | Una API multi-proveedor ayuda cuando... |
|---|---|---|
| Elección de modelo | Un proveedor gana en la mayoría de las tareas. | Distintas cargas de trabajo necesitan rutas de OpenAI, Claude, Gemini, DeepSeek, Qwen, imágenes, video y herramientas. |
| Esfuerzo de ingeniería | Tu código ya llama a un proveedor y rara vez cambia. | Quieres enrutamiento compatible con OpenAI y menos reescrituras de integración. |
| Control de costos | Una factura y un panel son aceptables. | Necesitas presupuestos por subclave, listas permitidas de modelos y exportaciones de uso por solicitud. |
| Compras | Los contratos separados son manejables. | Los contratos duplicados, las plazas inactivas y las claves de proveedor dispersas ralentizan al equipo. |
| Fiabilidad | Las caídas ocasionales del proveedor son aceptables. | Necesitas políticas de respaldo y un libro mayor compartido para el costo de reintentos/respaldo. |
| Flujos de trabajo de agentes | La app solo llama a modelos de texto. | Los agentes llaman a modelos, búsqueda web, acciones del navegador, herramientas de enriquecimiento, imágenes y video. |
Flatkey está diseñado para la segunda columna: una clave de API, un saldo, una factura y un libro mayor de solicitudes en más de 300 modelos oficiales y más de 1,000 herramientas de pago por uso. Eso no elimina la necesidad de revisar los precios oficiales de los modelos. Le da a tu equipo un solo lugar para enrutar, medir y conciliar esos costos. Para un desglose relacionado de tarifas de gateway, consulta precios de gateway de IA.
Cinco ejemplos de cargas de trabajo
1. Chat de soporte
El chat de soporte suele tener entrada moderada, salida corta y alto volumen. Compara:
- Tasa de aciertos de caché del prompt para el prompt del sistema y el texto de políticas.
- Presupuesto de tokens de salida por tipo de respuesta.
- Tasa de escalado a un modelo más potente.
- Costo por conversación resuelta, no solo costo por mensaje.
Para esta carga de trabajo, un modelo rápido y más barato puede ganar si mantiene alta la calidad de resolución. Si el modelo más barato aumenta la tasa de derivación o de edición, el ahorro aparente de tokens desaparece.
2. Agente de código
Los agentes de código suelen tener mucho contexto, llamadas a herramientas, salida extensa y varios reintentos. Compara:
- Tamaño del contexto después de la búsqueda en el repositorio o de la lectura de archivos.
- Instrucciones del proyecto que se pueden cachear.
- Número de llamadas a herramientas por tarea aceptada.
- Desperdicio por reintentos debido a rutas sobrecargadas.
- Costo por cambio fusionado o parche aceptado.
Aquí es donde una comparación de precios de API de IA necesita un libro mayor. Una sola ejecución de agente puede incluir llamadas al modelo, llamadas a herramientas, llamadas de respaldo e intentos fallidos.
3. Generación de respuestas RAG
Las cargas de trabajo RAG están dominadas por el contexto recuperado y la longitud de la respuesta. Compara:
- Cantidad promedio de tokens recuperados.
- Proporción de prefijo de prompt estable.
- Comportamiento de caché para documentos repetidos.
- Costos de citación y fundamentación.
- Tasa de aprobación del evaluador para la factualidad.
No elija un modelo solo porque sus tokens de entrada sean baratos. Si necesita el doble de contexto o produce respuestas que no superan la evaluación, el costo por respuesta aceptada puede ser mayor. Si esta es la principal pregunta de migración, use la hoja de trabajo más detallada en cómo comparar precios de modelos de IA.
4. Clasificación por lotes
La clasificación por lotes a menudo puede tolerar resultados demorados. Compare:
- Si el proveedor tiene un nivel de batch o flex.
- Tamaño máximo del lote y ventana de finalización.
- Costo de repetición de errores.
- Tasa de aprobación de validación del esquema de salida.
- Costo total por fila aceptada.
Si un proveedor ofrece precios más bajos por lotes, el ahorro solo se aplica cuando su flujo de trabajo puede esperar y su proceso de reintento es limpio.
5. Generación de imágenes y video
Las APIs de imágenes y video rara vez encajan en una hoja de cálculo basada solo en tokens. Compare:
- Unidad de salida: imagen, segundo, clip, resolución o crédito.
- Reglas de facturación por generación fallida.
- Tasa de edición/regeneración.
- Tasa de aprobación humana.
- Costo por activo creativo aceptado.
Para los flujos de medios, coloque los modelos de tokens y los modelos de generación en pestañas separadas de la hoja de cálculo. La economía unitaria es demasiado diferente para una sola fila combinada.
Un flujo de trabajo de comparación de precios de API de IA en siete pasos
- Congele la carga de trabajo. Elija una familia de tareas real, como respuestas de soporte, parches de agentes de código, respuestas RAG, clasificación por lotes, generación de imágenes o generación de video.
- Recoja los precios oficiales actuales. Use las páginas de precios del proveedor, las páginas de modelos de Flatkey y una fecha verificada. Evite tablas de tarifas copiadas sin URLs de origen.
- Reproduzca el tráfico representativo. Use los mismos prompts, entradas, límites de salida, política de herramientas y validadores en todas las rutas.
- Registre cada unidad facturable. Capture tokens de entrada, tokens en caché, tokens de salida, unidades de medios, llamadas a herramientas, intentos de reintento, errores y estado.
- Califique los resultados aceptados. Use revisión humana, validadores automáticos o comprobaciones de aprobado/reprobado específicas de la tarea.
- Calcule el costo efectivo. Divida el costo total de la ruta por los resultados aceptados, no por el total de solicitudes.
- Añada controles operativos. Decida si la ruta ganadora también cumple con los límites de presupuesto, necesidades de facturación, gobernanza de claves, retención de datos y respaldo ante incidentes.
El resultado es una decisión de precios que puede defender ante ingeniería y finanzas.
Dónde encaja Flatkey
Flatkey no es una tabla de precios estática. Es la capa de enrutamiento y facturación para equipos que necesitan ejecutar una comparación real de precios de API de IA en producción. Para una visión más amplia a nivel de modelo sobre costos de tokens, imágenes y video, comience con la comparación de precios de modelos de IA.
Use Flatkey cuando quiera:
- Llamar a muchos modelos oficiales mediante una sola clave API.
- Mantener el uso del modelo y de las herramientas en un solo saldo.
- Comparar rutas sin dispersar claves de proveedores entre agentes y repositorios.
- Rastrear tokens de entrada, salida y en caché, llamadas a herramientas, estado y costo en un solo libro mayor.
- Dar a los equipos presupuestos por subclave y listas permitidas de modelos.
- Conciliar una sola factura en lugar de muchos paneles de proveedores.
Comience con Flatkey cuando la comparación en sí misma se haya convertido en un problema operativo. Si su equipo ya sabe exactamente qué proveedor gana y no necesita enrutamiento entre proveedores, una cuenta directa puede ser suficiente. Cuando finanzas necesite responsabilidad por propietario, clave y presupuesto, combine esta hoja de trabajo con gestión del gasto en API de IA y controles de cuota de API de IA.
Errores comunes en la comparación de precios de API de IA
| Error | Qué hacer en su lugar |
|---|---|
| Comparar solo las tarifas de tokens de entrada | Compare entrada, entrada en caché, salida, reintentos y resultados aceptados. |
| Mezclar texto, imagen, video y herramientas en una sola unidad | Normalice cada modalidad por separado y luego agregue el costo del flujo de trabajo aceptado. |
| Ignorar el almacenamiento en caché de prompts | Mida los prefijos estables del prompt y las tasas de acierto de caché. |
| Ignorar la elegibilidad para lotes | Separe los trabajos sensibles a la latencia de los trabajos fuera de línea. |
| Confiar en tablas de precios copiadas y obsoletas | Guarde URLs oficiales de origen y fechas verificadas. |
| Tratar los gateways solo como recargo | Incluya gobernanza, failover, exportaciones de uso, facturas y tiempo de ingeniería. |
| Elegir la solicitud más barata | Elija el resultado aceptado más barato que cumpla con los requisitos de calidad y confiabilidad. |
Preguntas frecuentes
¿Cuál es la mejor manera de comparar los precios de API de IA?
La mejor manera de comparar los precios de API de IA es normalizar cada ruta al costo por resultado aceptado. Incluya tokens de entrada, entrada en caché, tokens de salida, unidades de medios, llamadas a herramientas, reintentos, tarifas de gateway y la tasa de aceptación de la carga de trabajo.
¿Por qué los precios de las API de IA difieren tanto?
Los precios de las API de IA difieren porque los proveedores usan diferentes arquitecturas de modelos, niveles de servicio, ventanas de contexto, reglas de caché, descuentos por lote, unidades de medios y opciones regionales o prioritarias. Un precio de entrada bajo no significa automáticamente que la ruta sea más barata para su carga de trabajo.
¿Debería usar un solo proveedor o una API mult proveedor?
Use un proveedor cuando una sola familia de modelos cubre la carga de trabajo y la facturación separada es fácil de gestionar. Use una API de múltiples proveedores cuando necesite comparar rutas de forma continua, gestionar muchas claves, enrutar entre modelos de texto y de medios, o conciliar el uso en un único libro mayor.
¿Con qué frecuencia debe volver a revisarse el precio?
Vuelva a revisar el precio antes de cada cambio importante de enrutamiento, revisión de contrato o previsión de presupuesto. Para cargas de trabajo de producción que cambian rápidamente, guarde la fuente del precio y la fecha de verificación en su hoja de cálculo de costos para que finanzas e ingeniería puedan ver cuándo los números podrían estar desactualizados.
¿Un precio de token más bajo siempre reduce el gasto total en IA?
No. Un precio de token más bajo puede perder cuando incluye prompts más largos, salidas más largas, menor tasa de aceptación, reintentos, llamadas de respaldo, uso de herramientas y sobrecarga adicional de gobernanza. La métrica duradera es el costo efectivo por resultado aceptado.
Lista de verificación final
Antes de elegir una ruta, confirme:
- Se registran el ID del modelo, la fuente de precios y la fecha de verificación.
- Se separan las unidades de entrada, entrada en caché, salida, medios y herramientas.
- El modo por lote o de prioridad está marcado explícitamente.
- Se incluye el costo de reintento y de respaldo.
- La tasa de aceptación se mide con tareas reales.
- Compras puede conciliar la factura y exportar el libro mayor de uso.
- La decisión final se basa en el costo por resultado aceptado, no solo en el precio de lista.
Esta es la comparación práctica de precios de API de IA: precios fuente actuales, tráfico modelado sobre producción y un libro mayor en el que finanzas e ingeniería puedan confiar.


