
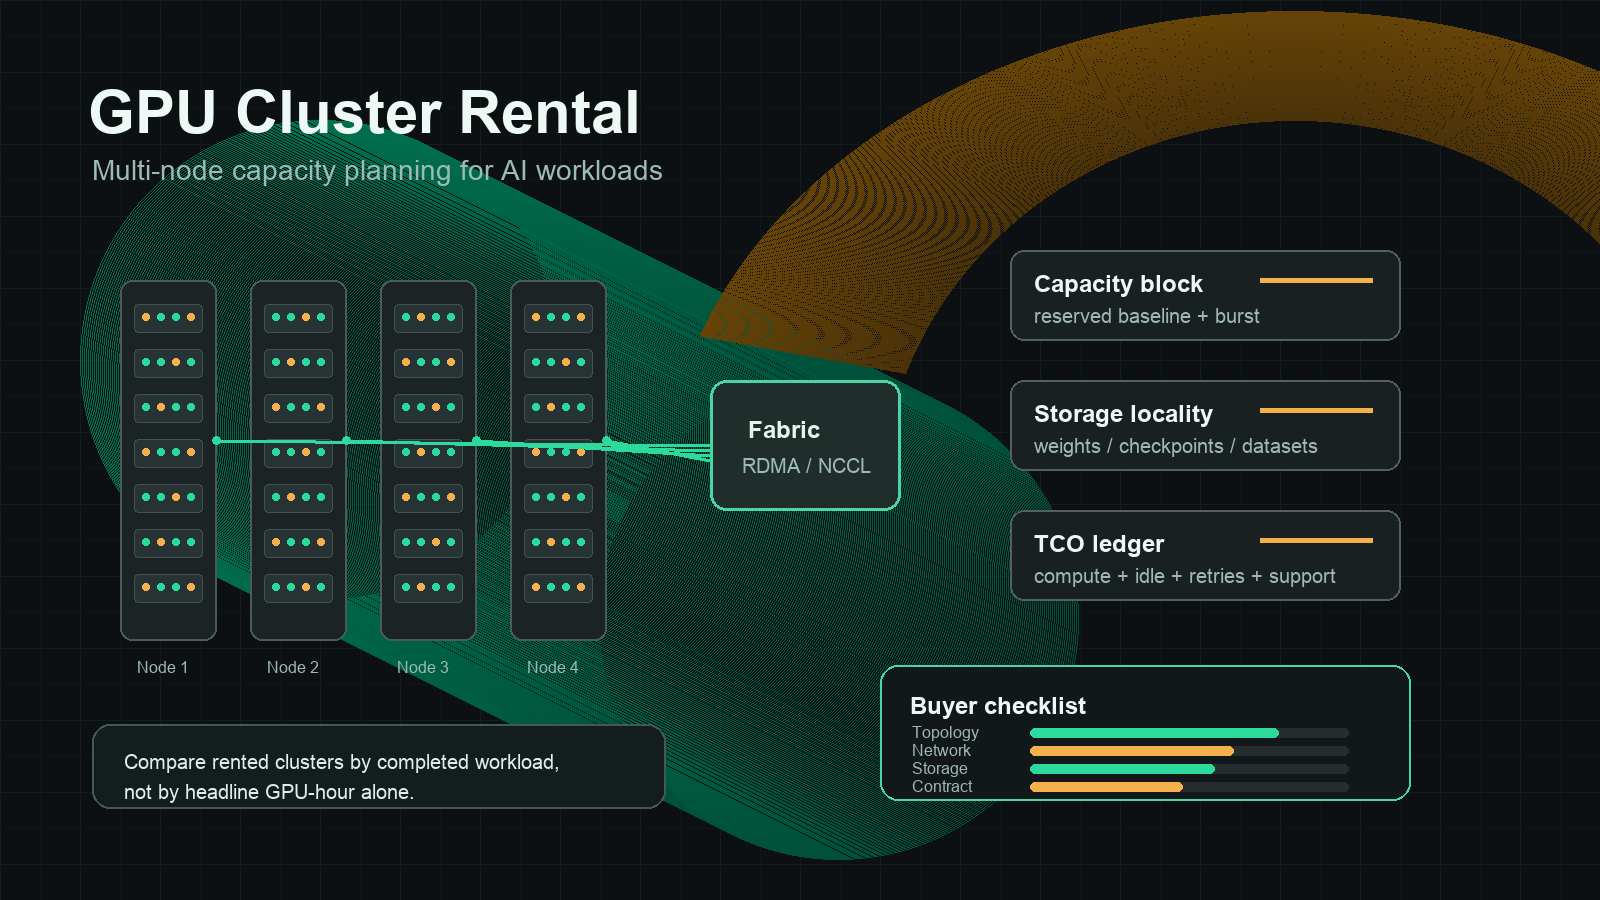
Location de cluster GPU : guide d’achat pour la capacité IA multi-nœuds
La location de cluster GPU devient intéressante lorsqu’un seul GPU, un seul nœud ou un seul compte fournisseur ne suffit plus. Peut-être qu’un entraînement nécessite huit à soixante-quatre GPU connectés avec un réseau à faible latence. Peut-être que le trafic d’inférence a une base stable et un pic marqué pendant la semaine de lancement. Peut-être que les achats veulent une capacité H100, H200, B200 ou L40S garantie sans acheter de matériel, recruter une équipe de datacenter et attendre les délais d’approvisionnement de la chaîne logistique.
La difficulté, c’est qu’un « cluster GPU » n’est pas un produit unique. Un devis peut désigner une réservation chez un hyperscaler, une allocation auprès d’un fournisseur spécialisé de cloud GPU, un cluster bare metal, une flotte de marketplace, une configuration Kubernetes gérée ou un bloc de capacité privée. Le tarif horaire du GPU n’est que la première ligne du devis.
Ce guide donne aux équipes IA d’entreprise une méthode pratique pour évaluer les options de location de cluster GPU, comparer les fournisseurs cloud de location de cluster GPU et décider quand louer, réserver, acheter ou utiliser plutôt une API de modèle.
La réponse rapide
Utilisez la location de cluster GPU lorsque votre charge de travail présente au moins l’un de ces besoins :
| Besoins | Pourquoi cela indique un cluster |
|---|---|
| Entraînement multi-GPU | Le modèle, la taille de lot ou la méthode de fine-tuning exige plus de mémoire ou de débit qu’un seul nœud ne peut fournir. |
| Inférence multi-nœuds | Vous avez besoin d’une capacité de base élevée, d’une isolation des locataires ou d’un temps de file d’attente prévisible pour le trafic de production. |
| Utilisation stable | La même classe de GPU restera suffisamment occupée pour justifier une capacité réservée ou dédiée. |
| Tâches sensibles au réseau | L’entraînement distribué, le service sharded ou les grands workloads d’embeddings/indexation nécessitent un placement connu et un comportement de fabric prévisible. |
| Contrôle des achats | La finance a besoin d’un budget engagé, de conditions de support, d’une région, d’un périmètre de conformité et d’une date de renouvellement. |
Ne choisissez pas la location de cluster GPU simplement parce qu’un gros GPU semble moins cher à l’heure. Choisissez-la lorsque le workload terminé est moins coûteux ou plus sûr une fois pris en compte le réseau, le stockage, l’utilisation, le risque de redémarrage, le support, les opérations et les conditions contractuelles.
coût réel du cluster par sortie utile =
  (calcul + stockage + réseau + temps d'inactivité + reprises + support + surcharge d'ingénierie)
  / entraînements acceptés, jetons d'inférence, jobs, images ou requêtes client
Qu’est-ce qui compte comme location de cluster GPU ?
La location de cluster GPU peut désigner plusieurs modes d’achat. Gardez-les séparés pendant l’évaluation.
| Modèle de location | Cas d’usage idéal | Risque principal |
|---|---|---|
| Serveur multi-GPU à nœud unique | Entraînement précoce, fine-tuning, tâches batch, expérimentations d’une équipe | Il est facile de le dépasser ; les hypothèses réseau ne se transfèrent pas aux exécutions multi-nœuds. |
| Cluster multi-nœuds à la demande | Projets courts, fenêtres de benchmark, capacité de pointe | La disponibilité peut varier selon la région et la famille de GPU. |
| Cluster réservé ou dédié | Inférence de production, calendrier d’entraînement planifié, fenêtres de lancement | Risque d’utilisation si la demande change ou si une nouvelle classe de GPU modifie l’économie. |
| Flotte GPU sur marketplace | Expérimentations, tâches batch flexibles, capacité opportuniste à moindre coût | La fiabilité de l’hôte, les transferts de données, les interruptions et le support peuvent varier. |
| Cluster Kubernetes géré ou Slurm | Équipes plateforme qui ont besoin d’une planification et d’une gouvernance reproductibles | Vous restez responsable du packaging des workloads, de l’observabilité, du contrôle des coûts et de la réponse aux incidents. |
| API de modèle ou inférence serverless | Équipes qui ont besoin des résultats, pas du contrôle matériel | Moins de contrôle sur les poids, les kernels, le placement et la pile de service bas niveau. |
C’est pourquoi la requête « gpu cluster rental or cloud gpu cluster » présente généralement une séparation d’intention d’achat. Certaines équipes ont besoin d’une capacité physique qu’elles peuvent planifier. D’autres ont besoin de sorties IA fiables et ne devraient pas faire fonctionner les GPU directement.
Commencez par le workload, pas par le fournisseur
Avant de comparer les fournisseurs cloud de location de cluster GPU, rédigez une fiche de capacité d’une page. Un devis fournisseur n’a de sens que si chaque vendeur voit la même forme de workload.
| Champ bref | À renseigner |
|---|---|
| Type de charge de travail | Pré-entraînement, fine-tuning, embeddings pour la recherche, inférence par lots, inférence en ligne, génération d’images/vidéos, simulation ou notebooks de recherche. |
| Modèle et framework | Famille de modèles, nombre de paramètres, précision, quantization, PyTorch/JAX, vLLM, SGLang, TensorRT-LLM, Ray, Kubernetes, Slurm ou un autre ordonnanceur. |
| GPU cible | H100 SXM, H100 PCIe, H200, B200, A100, L40S, RTX 4090, RTX PRO 6000 ou une plage de substituts acceptables. |
| Configuration du cluster | GPU par nœud, nombre de nœuds, mémoire par GPU, ratio CPU/RAM, NVMe local, et si les jobs ont besoin d’un seul groupe de placement. |
| Besoins réseau | NVLink/NVSwitch intra-nœud, InfiniBand ou RoCE inter-nœuds, bande passante cible pour tout-réduction et jitter acceptable. |
| Chemin de stockage | Taille du jeu de données, taille des checkpoints, cache des poids du modèle, emplacement du stockage objet, scratch local, politique de snapshots et période de rétention. |
| Cible d’utilisation | Utilisation de base attendue, heures de pic, tolérance à l’inactivité, fenêtres de maintenance et temps d’attente en file attendu. |
| Politique de fiabilité | Fréquence des checkpoints, budget de nouvelles tentatives, risque d’éviction toléré, SLA de support et voie d’escalade des incidents. |
| Données et conformité | Région, résidence des données, confidentialité, audit, export et exigences d’isolation client. |
| Périmètre contractuel | Durée du contrat, dépense minimale, garantie de capacité, voie de mise à niveau, périmètre du support et conditions de résiliation. |
Si vous ne pouvez pas remplir ce tableau, ne réservez pas encore de cluster. Louez d’abord une capacité courte à la demande, mesurez la charge de travail, puis transformez le benchmark en brief d’achat.
Catégories de fournisseurs à comparer
Il existe trois catégories utiles de fournisseurs pour la location de cluster GPU.
| Catégorie | Exemples à évaluer | Ce qu’ils font généralement bien | Ce qu’il faut vérifier |
|---|---|---|---|
| Clouds hyperscale | AWS, Google Cloud, Microsoft Azure | Identité, régions, conformité, produits réseau, support, contrôles de facturation matures | Disponibilité des GPU, quotas, mécanismes de réservation, facture cloud totale, coût du transfert de données et complexité opérationnelle. |
| Clouds GPU spécialisés | Lambda, CoreWeave, Crusoe, Runpod Enterprise, clouds IA régionaux | Conversations d’approvisionnement GPU plus rapides, support natif IA, tarification GPU plus simple, conditions de cluster dédié | Infrastructure réseau, stockage, observabilité, contrôles d’entreprise, SLA de support et conditions de renouvellement/mise à niveau. |
| Places de marché et flottes flexibles | Vast.ai, capacité de style communautaire de Runpod, capacité GPU négociée | Coût d’entrée plus faible et expériences rapides | Fiabilité de l’hôte, risque d’interruption, mouvement des données, profondeur du support, conformité et adéquation au trafic de production. |
Utilisez les pages sources officielles comme points de contrôle actuels, et non comme grilles tarifaires permanentes. Pour cet article, les affirmations ont été vérifiées le 12 octobre 2026.
| Source | Pourquoi c’est important dans une revue d’achat |
|---|---|
| Instances AWS EC2 P5 et EC2 Capacity Blocks | Vérifiez la forme de l’instance du cluster H100, le langage EFA/réseau, les mécanismes de réservation, les quotas et la disponibilité régionale. |
| Machines accélérées Google Cloud et Tarification GPU | Vérifiez les familles de machines A3/A4, la structure de tarification GPU, le stockage, les remises d’engagement et les notes régionales. |
| Série Azure ND H100 v5 | Vérifiez la forme du cluster H100 d’Azure, le cadrage InfiniBand, le dimensionnement des VM et la disponibilité régionale. |
| Lambda GPU Cloud | Vérifiez les tarifs publiés du cloud GPU, les types d’instances, les conditions du cloud réservé et les notes de disponibilité. |
| Tarification Runpod et Documentation Runpod | Distinguez les pods, le serverless, la capacité sécurisée/de communauté, le stockage et les hypothèses de volume réseau. |
| Tarification Vast.ai et Documentation Vast.ai | Traitez chaque annonce comme une offre de place de marché avec son propre hôte, sa fiabilité, son stockage, son emplacement et son profil d’interruption. |
| Tests NVIDIA NCCL | Utilisez des benchmarks pratiques d’entraînement distribué au lieu d’accepter un langage générique de type « réseau haut débit ». |
| NVIDIA GPU Operator et Slurm GRES | Confirmez si votre équipe ou le fournisseur gère l’ordonnancement GPU, les pilotes, la télémétrie et la politique d’allocation. |
Les vérifications multi-nœuds qui comptent
La location d’un seul GPU est surtout une décision de prix, de mémoire, d’image et de disponibilité. La location d’un cluster GPU multi-nœuds ajoute des risques de topologie et d’exploitation.
1. Topologie GPU
Demandez la forme exacte du nœud et si le cluster est homogène.
- Modèle de GPU et taille de la mémoire.
- PCIe versus SXM, le cas échéant.
- Nombre de GPU par nœud.
- Topologie NVLink ou NVSwitch intra-nœud.
- Modèle de CPU, RAM et NVMe local par nœud.
- Politique d’allocation MIG, vGPU ou GPU complet.
- Si tous les nœuds se trouvent dans un seul domaine de placement.
N’acceptez pas « 8x H100 » comme spécification complète. Un serveur 8x H100 SXM, un serveur 8x H100 PCIe et huit nœuds H100 distincts peuvent se comporter très différemment.
2. Réseau d’interconnexion
Pour l’entraînement distribué, le réseau peut décider si le cluster est utile. Demandez :
- Des détails sur InfiniBand, RoCE, EFA, GPUDirect ou toute autre interconnexion.
- Le nombre de NIC et le débit par nœud.
- Le ratio de sursouscription.
- La garantie de placement pour les nœuds cités dans le devis.
- Si le fournisseur a exécuté des tests NCCL all-reduce sur ce pool exact.
- La politique de maintenance et d’isolation des pannes.
Intégrez la validation réseau dans le test d’acceptation :
test d’acceptation du cluster :
  exécuter nccl-tests all_reduce sur chaque nœud loué
  comparer la bande passante et la latence au devis du fournisseur
  répéter après l’installation de l’image de conteneur, du pilote et du framework
  enregistrer les journaux avec la date, les IDs des nœuds, le modèle de GPU et la région
Si le fournisseur ne peut pas prendre en charge un benchmark distribué de base avant la signature du contrat, considérez cela comme un signal de risque.
3. Stockage et chemin des données
Les équipes GPU sous-estiment souvent le stockage, car le devis GPU semble important et la ligne de stockage paraît ordinaire. Pour les clusters multi-nœuds, le stockage détermine le temps de démarrage, le temps de checkpoint et la récupération après panne.
Demandez :
- NVMe local par nœud.
- Options de système de fichiers partagé.
- Région du stockage objet et chemin de sortie des données.
- Temps de préparation du dataset.
- Stratégie de cache des poids du modèle.
- Débit d’écriture/lecture des checkpoints.
- Tarification des snapshots et des sauvegardes.
- Politique de nettoyage après la fin de la location.
Exécutez ensuite un test réel : récupérez le conteneur de production, préparez le dataset, chargez les poids, écrivez un checkpoint, restaurez depuis le checkpoint et mesurez le temps facturable.
4. Ordonnanceur et modèle d’accès
La meilleure offre GPU peut tout de même échouer si votre équipe ne peut pas planifier les jobs de manière fiable. Déterminez qui prend en charge :
- La configuration de Kubernetes ou Slurm.
- La gestion des versions des pilotes et de CUDA.
- Le registre de conteneurs et l’analyse des images.
- L’accès utilisateur, la politique SSH, les secrets et les journaux d’audit.
- Les quotas par équipe ou par projet.
- L’extinction en cas d’inactivité.
- Les balises de coût et les exports d’utilisation.
- L’escalade des incidents.
Un cluster géré par le fournisseur peut réduire le temps de configuration, mais vous avez tout de même besoin d’un runbook clair pour les mauvaises images, les jobs en échec, les litiges de quota et les changements urgents de capacité.
Feuille de calcul des prix de location de cluster GPU dans le cloud
Pour chaque fournisseur, normalisez le devis dans la même feuille de calcul.
| Élément | Question à poser | Pourquoi cela modifie le TCO |
|---|---|---|
| Calcul GPU | Quelle est l’unité facturable : seconde, minute, heure, mois ou bloc de capacité ? | Les jobs courts et le temps d’inactivité sont sensibles à la granularité de facturation. |
| Engagement minimum | Y a-t-il une durée, un minimum de dépenses ou une réservation non annulable ? | Un tarif annoncé bas peut devenir coûteux si l’utilisation baisse. |
| Stockage | Quels niveaux de stockage sont inclus et lesquels sont facturés séparément ? | Les datasets, checkpoints, poids de modèle et snapshots peuvent persister après la fin des jobs. |
| Réseau | Le cross-region, l’egress public, le lien privé ou l’interconnexion dédiée sont-ils facturés séparément ? | Les grands datasets et les médias générés peuvent transférer plus de données que prévu. |
| Support | Quel est le délai de réponse, le chemin d’escalade et l’assistance technique incluse ? | Les incidents de cluster coûtent cher pendant les fenêtres d’entraînement. |
| Fiabilité | Que se passe-t-il si un nœud tombe en panne pendant un job multi-nœuds ? | Le redémarrage et le temps d’attente en file doivent être inclus dans le modèle de coût. |
| Chemin de mise à niveau | Pouvez-vous passer de capacités de classe H100 à H200/B200 pendant la durée du contrat ? | Les générations de GPU modifient les performances par dollar. |
| Observabilité | Disposez-vous de l’utilisation par nœud, des logs de jobs, des exports de facturation et des codes de raison des échecs ? | Sans données d’utilisation, la finance ne peut pas expliquer la facture. |
| Sécurité | L’isolation des locataires, les journaux d’audit, les secrets et les conditions de suppression des données sont-ils documentés ? | Les acheteurs entreprises ont besoin de preuves, pas d’assurances verbales. |
Utilisez cette formule dans le tableur :
TCO mensuel du cluster =
  calcul engagé
  + calcul burst
  + stockage persistant
  + snapshots
  + egress réseau
  + support
  + gaspillage d’inactivité
  + gaspillage de relance
  + surcharge d’ingénierie
Calculez ensuite l’unité utile :
coût par unité utile =
  TCO mensuel du cluster / unités de charge de travail acceptées
L’unité utile doit correspondre au résultat métier : fine-tunes terminés, tokens d’entraînement traités, lots d’images acceptés, tokens d’inférence, requêtes clients ou expériences livrées.
Louer, réserver ou acheter en 2026
Le mot-clé « gpu cluster rental or cloud or buy 2026 » renvoie à la vraie question d’approvisionnement. Utilisez le tableau de décision ci-dessous avant tout engagement important.
| Option | À privilégier lorsque | À éviter lorsque |
|---|---|---|
| Louer à la demande | La charge de travail est nouvelle, le calendrier est incertain ou les benchmarks évoluent encore. | Vous disposez déjà d’une utilisation de base stable et d’exigences urgentes de disponibilité. |
| Réserver ou dédier de la capacité | L’utilisation est prévisible, les dates de lancement sont importantes et la même classe de GPU sera occupée pendant des mois. | L’architecture du modèle, le moteur de service ou la cible GPU sont susceptibles de changer bientôt. |
| Acheter ou colocaliser | Vous avez une utilisation très élevée, des besoins matériels stables, une expertise en datacenter et une approbation budgétaire. | Vous avez besoin d’une montée en charge rapide, de flexibilité sur la génération de GPU, d’un support géré ou de régions mondiales. |
| Utiliser des API de modèles | Vous avez davantage besoin des sorties du modèle que du contrôle matériel, et la surcharge opérationnelle l’emporterait sur les économies GPU. | Vous avez besoin de poids personnalisés, d’un contrôle au niveau noyau, d’une pile de service privée ou d’un placement matériel fixe. |
Pour de nombreuses équipes produit IA, la voie pratique est progressive :
- Louez des GPU à la demande pour les benchmarks.
- Transférez les tâches stables vers une location de cluster GPU réservée ou dédiée.
- Conservez le trafic de pointe et d’expérimentation sur une capacité flexible.
- Utilisez des API de modèles pour les charges de travail où le contrôle de l’infrastructure n’améliore pas le produit.
- Réévaluez l’achat ou la colocalisation uniquement une fois l’utilisation et la forme de la charge de travail stabilisées.
Location de cluster GPU en Inde
L’expression « location de cluster gpu en inde » ne doit pas être traitée comme un article distinct, sauf si l’acheteur a des exigences spécifiques à l’Inde en matière d’approvisionnement, de résidence des données ou de latence. Utilisez la même grille, puis ajoutez des vérifications régionales :
- Le cluster est-il physiquement en Inde, dans des régions asiatiques proches, ou seulement vendu à des entreprises basées en Inde ?
- Où résideront les données d’entraînement, les checkpoints et les journaux ?
- Quelles sont les exigences en matière de transfert transfrontalier, de fiscalité, de facturation et d’horaires de support ?
- Un support local est-il nécessaire pendant les heures ouvrables indiennes ?
- La latence compte-t-elle pour l’inférence, ou s’agit-il d’une charge de travail d’entraînement hors ligne ?
- Existe-t-il des contraintes d’importation, d’achat ou de conformité si vous achetez du matériel au lieu de le louer ?
Pour l’entraînement hors ligne, une région proche peut être acceptable si le transfert de données et la conformité sont propres. Pour l’inférence sensible à la latence ou les données réglementées, la région et les conditions contractuelles peuvent compter davantage que le tarif GPU affiché.
Signaux d’alerte dans les devis de location de cluster GPU
Mettez le dossier en pause si vous voyez l’un de ces éléments :
- Le devis indique « cluster H100 » sans préciser PCIe/SXM, la forme du nœud, la mémoire ou le réseau.
- Le fournisseur ne peut pas décrire la gestion d’une panne sur un nœud défectueux dans un travail distribué.
- Le stockage et l’egress sont absents du devis.
- Les conditions de support sont floues pendant votre fenêtre d’entraînement la plus coûteuse.
- « Dédié » est utilisé sans clarifier l’isolation des locataires, le placement et le risque de voisin bruyant.
- Le devis affiche un tarif mensuel bas mais aucune condition d’utilisation ou d’annulation.
- Il n’y a pas de fenêtre de benchmark avant l’engagement.
- Le fournisseur refuse de partager les champs d’export de facturation ou les données d’utilisation.
- Vous ne pouvez pas vérifier les versions du driver/CUDA/framework avant la première charge de travail.
- Le dossier commercial mentionne la conformité, mais le contrat ne définit pas le traitement ni la suppression des données.
Ce qu’il faut benchmarker avant de signer
Exécutez une petite suite d’acceptation avant de réserver ou de faire évoluer un cluster GPU loué.
| Test | Condition de réussite |
|---|---|
| Téléchargement et démarrage du conteneur | L’image de production démarre rapidement et de manière reproductible sur chaque nœud. |
| Santé GPU | Tous les GPU signalent le modèle, la mémoire, le driver et la compatibilité CUDA attendus. |
| NCCL all-reduce | La bande passante inter-nœuds et la latence correspondent à la classe de cluster annoncée par le fournisseur. |
| Phase de stockage | Le jeu de données et les poids du modèle peuvent être mis en place dans la fenêtre de configuration prévue. |
| Écriture/lecture de checkpoint | Les checkpoints se terminent sans laisser le temps GPU inactif trop longtemps. |
| Test de panne | Arrêtez un worker et confirmez le redémarrage, le checkpoint et le comportement de facturation. |
| Arrêt en inactivité | Les nœuds inutilisés s’arrêtent ou déclenchent une alerte avant que le gaspillage ne s’accumule. |
| Export de facturation | L’utilisation peut être attribuée par équipe, charge de travail, environnement et tâche. |
| Revue de sécurité | L’accès, les secrets, les journaux, la suppression des données et les enregistrements d’audit correspondent à la politique. |
Conservez la sortie du benchmark avec la date, le fournisseur, la région, le modèle de GPU, la version de l’image, la version du framework et les identifiants des nœuds. Cela transforme le choix du fournisseur d’un débat sur les tarifs en une revue d’ingénierie reproductible.
Où Flatkey s’inscrit
Flatkey ne remplace pas tous les clusters GPU loués. Si vous avez besoin de poids personnalisés, de noyaux privés, d’un entraînement multi-nœuds ou d’un contrôle direct du matériel, vous avez toujours besoin de capacité GPU.
Flatkey prend de l’importance lorsque la question est de savoir si vous avez besoin d’exploiter des GPU du tout pour une charge de travail donnée. Flatkey donne aux équipes une seule clé, un seul solde et une seule facture pour plus de 300 modèles officiels et plus de 1 000 outils facturés à l’appel, avec une visibilité de l’utilisation au niveau des requêtes. Cela le rend utile comme voie de comparaison pour :
- Les charges de travail de prototype avant que vous ne vous engagiez sur un cluster.
- Le trafic des agents et des applications pouvant s’exécuter sur des API de modèles officielles.
- Les revues financières qui doivent comparer le coût d’un GPU auto-hébergé avec celui d’une API de modèle.
- Les équipes qui veulent un registre partagé de l’utilisation de l’IA avant de décider ce qui mérite du matériel dédié.
Si une charge de travail ne nécessite pas de contrôle matériel, comparez la location de cluster GPU à une approche via API sur le coût par résultat accepté, et non sur les heures GPU brutes. Les guides connexes sur les prix de location de GPU, la comparaison des prix des modèles d’IA, comment comparer les prix des modèles d’IA, la tarification des passerelles d’IA, la gestion des dépenses d’API d’IA et la gestion des quotas d’API d’IA sont les prochains points à vérifier.
Liste de contrôle de l’acheteur
Utilisez cette liste de contrôle avant d’approuver la location de cluster GPU :
- Définissez la charge de travail et l’unité de sortie utile.
- Évaluez la capacité à la demande avant de réserver.
- Précisez le modèle de GPU, la mémoire, la configuration du nœud, le stockage local et le tissu réseau.
- Exigez un benchmark distribué pour l’entraînement multi-nœuds.
- Incluez le stockage, l’egress, le support, le temps d’inactivité et le gaspillage dû aux reprises dans le TCO.
- Confirmez la région, la conformité, la suppression des données et les exigences d’audit.
- Demandez comment un nœud défaillant affecte une tâche en cours d’exécution.
- Exigez des exportations d’utilisation et de facturation par équipe, environnement et tâche.
- Séparez la capacité réservée de base de la capacité de pointe.
- Comparez à nouveau aux API de modèle lorsque le contrôle matériel n’est pas nécessaire.
La meilleure décision de location de cluster GPU est celle qui termine la charge de travail de manière fiable avec le moins de surprises opérationnelles. L’heure GPU la moins chère n’est utile que si le cluster, le stockage, le réseau et le contrat permettent à votre équipe de transformer cette heure en travail accepté.
Questions que se posent les acheteurs
Qu’est-ce que la location de cluster GPU ?
La location de cluster GPU consiste à louer plusieurs GPU, souvent sur un ou plusieurs nœuds connectés, pour l’entraînement IA, l’inférence, le traitement par lots ou la recherche. Elle peut être à la demande, réservée, dédiée, basée sur une marketplace ou gérée par un fournisseur cloud.
La location de cluster GPU est-elle moins chère que l’achat de GPU ?
Cela dépend du taux d’utilisation, de la durée d’engagement, des compétences opérationnelles, du financement, de l’électricité, de l’accès au datacenter, du support et de la fréquence à laquelle votre classe de GPU cible change. La location l’emporte généralement en cas d’incertitude et de besoin de rapidité. L’achat ne peut l’emporter que lorsque l’utilisation et les besoins matériels sont suffisamment stables pour absorber les coûts en capital et d’exploitation.
Que dois-je demander aux fournisseurs cloud de location de cluster GPU ?
Demandez le modèle de GPU, la configuration du nœud, le tissu réseau, le stockage, la région, le quota, le SLA de support, les hypothèses d’utilisation, les exports de facturation, les conditions de suppression des données, l’accès aux benchmarks et ce qui se passe lorsqu’un nœud tombe en panne pendant une tâche distribuée.
Ai-je besoin d’InfiniBand ou de RoCE pour un cluster GPU loué ?
Vous avez besoin d’un réseau de cluster haute performance lorsque les tâches communiquent intensivement entre les nœuds, en particulier pour l’entraînement distribué et le service shardé. Vous n’en avez peut-être pas besoin pour de l’inférence batch massivement parallèle ou des tâches indépendantes. Faites un benchmark avec votre propre charge de travail avant de payer pour un tissu premium.
Comment dois-je comparer la location de cluster GPU en Inde ?
Utilisez la même feuille de calcul de location, puis ajoutez des questions spécifiques à l’Inde concernant la région, la résidence des données, la fiscalité, les exigences de facturation, les heures de support, la latence et le transfert de données transfrontalier. Ne comparez pas uniquement le tarif horaire du GPU.


