
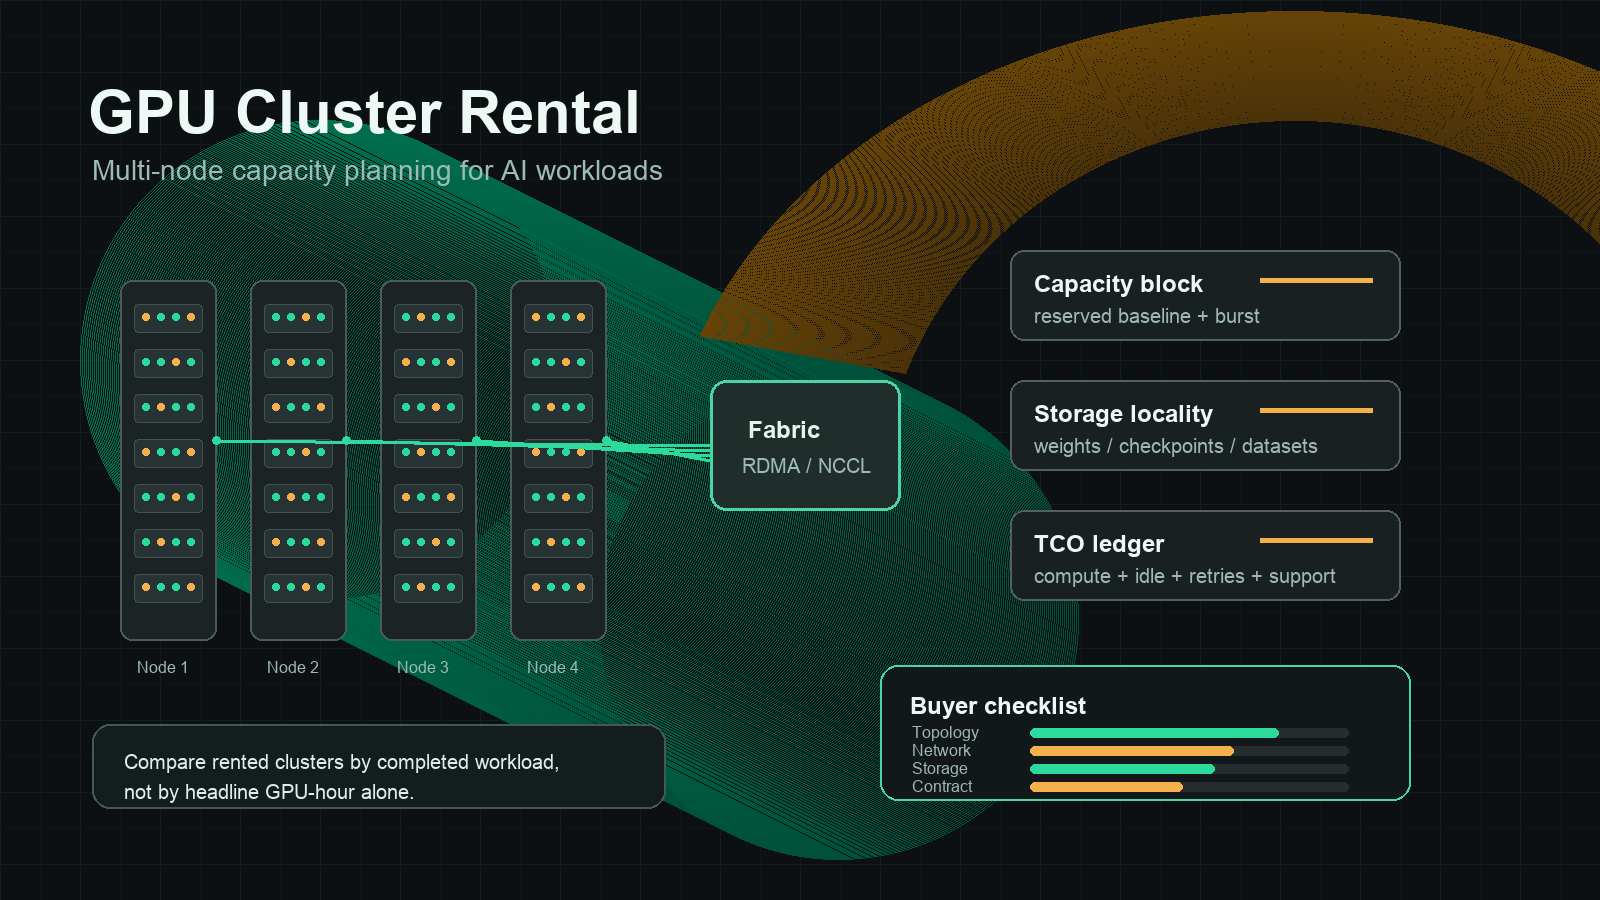
GPUクラスターのレンタル:マルチノードAI容量のための購入者向けガイド
GPUクラスターのレンタルは、1つのGPU、1つのノード、または1つのプロバイダーアカウントではもはや不十分になったときに魅力的になります。たとえば、学習ジョブに低レイテンシのネットワークで接続された8〜64枚のGPUが必要になることがあります。推論トラフィックに安定したベースラインと、ローンチ週の急増があることもあります。あるいは、調達部門がハードウェアを購入したり、データセンターチームを雇ったり、サプライチェーンのリードタイムを待ったりせずに、H100、H200、B200、またはL40Sの容量を確保したい場合もあります。
難しいのは、「GPUクラスター」が単一の製品ではないことです。見積もりは、ハイパースケーラーの予約、特化型GPUクラウドの割り当て、ベアメタルクラスター、マーケットプレイスのフリート、マネージドKubernetesのセットアップ、またはプライベートな容量ブロックを意味する場合があります。時間あたりのGPU料金は、最初の項目にすぎません。
このガイドでは、エンタープライズAIチームがgpu cluster rentalの選択肢を実践的に評価し、gpu cluster rental cloud providersを比較し、いつレンタルするか、予約するか、購入するか、あるいは代わりにモデルAPIを使うべきかを判断する方法を示します。
簡単な答え
ワークロードに次のいずれかのニーズがある場合は、GPUクラスターのレンタルを使ってください。
| ニーズ | クラスターが必要になる理由 |
|---|---|
| マルチGPU学習 | モデル、バッチサイズ、またはファインチューニング手法に、1つのノードでは提供できないメモリ量やスループットが必要。 |
| マルチノード推論 | 本番トラフィック向けに、高いベースライン容量、テナント分離、または予測可能なキュー待ち時間が必要。 |
| 安定した利用率 | 同じGPUクラスが、予約済みまたは専有容量を正当化できるだけの時間、十分に稼働し続ける。 |
| ネットワーク感度の高いジョブ | 分散学習、シャーディングされたサービング、または大規模な埋め込み/インデックスワークロードには、既知の配置とファブリックの挙動が必要。 |
| 調達管理 | 財務部門が、コミット済み予算、サポート条件、リージョン、コンプライアンス範囲、更新日を必要とする。 |
大きなGPUが時間単価で安く見えるという理由だけでgpu cluster rentalを選ばないでください。ネットワーク、ストレージ、利用率、再起動リスク、サポート、運用、契約条件を含めたあとに、完成したワークロードの方が安い、または安全である場合に選んでください。
実際のクラスターコストを有用な出力あたりで表すと =
  (計算 + ストレージ + ネットワーク + アイドル時間 + 再試行 + サポート + エンジニアリングオーバーヘッド)
  / 受け入れられた学習ジョブ、推論トークン、ジョブ、画像、または顧客リクエスト
何がGPUクラスターのレンタルに該当するのか?
GPUクラスターのレンタルは、いくつかの購入形態を指す場合があります。評価時にはそれらを分けて考えてください。
| レンタルモデル | 最適な用途 | 主なリスク |
|---|---|---|
| 単一ノードのマルチGPUサーバー | 初期学習、ファインチューニング、バッチジョブ、1チームの実験 | 簡単に手狭になる。ネットワークの前提条件はマルチノード実行に引き継がれない。 |
| マルチノードのオンデマンドクラスター | 短期プロジェクト、ベンチマーク期間、バースト容量 | 利用可能性はリージョンやGPUファミリーによって変わる可能性がある。 |
| 予約済みまたは専有クラスター | 本番推論、計画された学習スケジュール、ローンチ期間 | 需要が変化したり、新しいGPUクラスが経済性を変えたりすると、利用率リスクがある。 |
| マーケットプレイスのGPUフリート | 実験、柔軟なバッチジョブ、低コストの機会的な容量 | ホストの信頼性、データ移動、中断、サポートは変動する場合がある。 |
| マネージドKubernetesまたはSlurmクラスター | 繰り返し可能なスケジューリングとガバナンスが必要なプラットフォームチーム | ワークロードのパッケージ化、可観測性、コスト管理、インシデント対応は依然として自分たちで担う必要がある。 |
| モデルAPIまたはサーバーレス推論 | ハードウェア制御ではなく、出力が必要なチーム | 重み、カーネル、配置、低レベルのサービングスタックに対する制御は少なくなる。 |
そのため、「gpu cluster rental or cloud gpu cluster」という検索語には、通常、購買意図の分岐があります。物理的な容量をスケジュールしたいチームもあれば、信頼できるAI出力だけが必要で、GPUを直接運用すべきではないチームもあります。
プロバイダーではなく、ワークロードから始める
gpu cluster rental cloud providersを比較する前に、1ページの容量ブリーフを作成してください。各ベンダーが同じワークロード形状を把握していなければ、プロバイダーの見積もりは意味を持ちません。
| 簡潔な項目 | 記入内容 |
|---|---|
| ワークロードの種類 | 事前学習、ファインチューニング、検索埋め込み、バッチ推論、オンライン推論、画像/動画生成、シミュレーション、または研究用ノートブック。 |
| モデルとフレームワーク | モデルファミリー、パラメータ数、精度、量子化、PyTorch/JAX、vLLM、SGLang、TensorRT-LLM、Ray、Kubernetes、Slurm、またはその他のスケジューラ。 |
| GPUの対象 | H100 SXM、H100 PCIe、H200、B200、A100、L40S、RTX 4090、RTX PRO 6000、または許容可能な代替品の範囲。 |
| クラスター構成 | ノードあたりのGPU数、ノード数、GPUあたりのメモリ、CPU/RAM比、ローカルNVMe、およびジョブに単一の配置グループが必要かどうか。 |
| ネットワーク要件 | ノード内のNVLink/NVSwitch、ノード間のInfiniBandまたはRoCE、目標とするall-reduce帯域幅、許容可能なジッター。 |
| ストレージの経路 | データセットサイズ、チェックポイントサイズ、モデル重みキャッシュ、オブジェクトストレージの場所、ローカルスクラッチ、スナップショットポリシー、保持期間。 |
| 利用率の目標 | 期待されるベースライン利用率、バースト時間、アイドル許容度、メンテナンスウィンドウ、期待されるキュー待ち時間。 |
| 信頼性ポリシー | チェックポイント頻度、再試行予算、許容される退避リスク、サポートSLA、インシデントのエスカレーション経路。 |
| データとコンプライアンス | リージョン、データ居住要件、プライバシー、監査、エクスポート、顧客分離の要件。 |
| 契約の境界 | 契約期間、最低利用額、容量保証、アップグレードパス、サポート範囲、解約条件。 |
この表を埋められないなら、まだクラスターを予約しないでください。まずは短期のオンデマンド容量を借りてワークロードをベンチマークし、そのベンチマークを調達要件書に落とし込みましょう。
比較すべきプロバイダーカテゴリ
gpuクラスターのレンタルでは、3つの有用なプロバイダーカテゴリがあります。
| カテゴリ | 評価する例 | 得意なこと | 確認すべきこと |
|---|---|---|---|
| ハイパースケールクラウド | AWS、Google Cloud、Microsoft Azure | 成熟したID、リージョン、コンプライアンス、ネットワーキング製品、サポート、請求管理 | GPUの可用性、クォータ、予約の仕組み、クラウド全体の請求額、データ転送料金、運用の複雑さ。 |
| 専門GPUクラウド | Lambda、CoreWeave、Crusoe、Runpod Enterprise、地域系AIクラウド | より迅速なGPU調達の相談、AIネイティブなサポート、シンプルなGPU価格、専用クラスター契約 | ネットワークファブリック、ストレージ、可観測性、エンタープライズ制御、サポートSLA、更新/アップグレード条件。 |
| マーケットプレイスと柔軟なフリート | Vast.ai、Runpodのコミュニティ型容量、仲介されたGPU容量 | 低い導入コストと迅速な実験 | ホストの信頼性、中断リスク、データ移動、サポートの深さ、コンプライアンス、本番トラフィックに適しているかどうか。 |
公式のソースページは、恒久的な料金表ではなく、現在の確認ポイントとして使ってください。本記事では、2026年10月12日時点で記載内容を確認しました。
| ソース | 購買レビューで重要な理由 |
|---|---|
| AWS EC2 P5 instances と EC2 Capacity Blocks | H100クラスターのインスタンス形状、EFA/ネットワーキングの表現、予約の仕組み、クォータ、リージョンの可用性を確認します。 |
| Google Cloud accelerator-optimized machines と GPU pricing | A3/A4マシンファミリー、GPU料金体系、ストレージ、確約利用割引、リージョンに関する注記を確認します。 |
| Azure ND H100 v5 series | AzureのH100クラスター形状、InfiniBandの説明、VMサイズ、リージョンの可用性を確認します。 |
| Lambda GPU Cloud | 公開されているGPUクラウド料金、インスタンスタイプ、予約クラウド条件、可用性の注記を確認します。 |
| Runpod pricing と Runpod docs | Pods、serverless、安全/コミュニティ容量、ストレージ、ネットワーク量の前提を分けて確認します。 |
| Vast.ai pricing と Vast.ai docs | 各リスティングを、独自のホスト、信頼性、ストレージ、ロケーション、中断特性を持つマーケットプレイスのオファーとして扱います。 |
| NVIDIA NCCL tests | 一般的な「高速ネットワーク」という表現を受け入れるのではなく、実用的な分散学習ベンチマークを使います。 |
| NVIDIA GPU Operator と Slurm GRES | GPUスケジューリング、ドライバー、テレメトリ、割り当てポリシーをチームが所有するのか、プロバイダーが所有するのかを確認します。 |
重要なマルチノード確認項目
単一GPUのレンタルは、主に価格、メモリ、イメージ、可用性の判断です。マルチノードのgpuクラスターレンタルでは、トポロジーと運用リスクが追加されます。
1. GPUトポロジー
正確なノード形状と、クラスターが均質かどうかを確認してください。
- GPUモデルとメモリ容量。
- 該当する場合はPCIeかSXMか。
- ノードあたりのGPU数。
- ノード内のNVLinkまたはNVSwitchのトポロジー。
- ノードあたりのCPUモデル、RAM、およびローカルNVMe。
- MIG、vGPU、またはフルGPU割り当てポリシー。
- すべてのノードが1つの配置ドメイン内にあるかどうか。
"8x H100" を完全な仕様として受け入れてはいけません。8x H100 SXMサーバー、8x H100 PCIeサーバー、そして8台の個別のH100ノードでは、挙動が大きく異なる場合があります。
2. ネットワークファブリック
分散学習では、ネットワークがクラスターの有用性を左右します。次の点を確認してください:
- InfiniBand、RoCE、EFA、GPUDirect、またはその他のファブリックの詳細。
- ノードごとのNIC数と速度。
- オーバーサブスクリプション比率。
- 見積もり対象ノードの配置保証。
- プロバイダーがその正確なプールでNCCL all-reduceテストを実施済みかどうか。
- メンテナンスおよび障害分離ポリシー。
ネットワーク検証を受入テストに組み込んでください:
cluster acceptance test:
  run nccl-tests all_reduce across every rented node
  compare bandwidth and latency to provider quote
  repeat after container image, driver, and framework install
  save logs with date, node IDs, GPU model, and region
プロバイダーが契約締結前に基本的な分散ベンチマークをサポートできない場合は、それをリスクのシグナルとみなしてください。
3. ストレージとデータパス
GPUチームは、GPUの見積もりが大きく見え、ストレージの項目が普通に見えるため、ストレージを過小評価しがちです。マルチノードクラスターでは、ストレージが起動時間、チェックポイント時間、障害復旧を左右します。
次の点を確認してください:
- ノードあたりのローカルNVMe。
- 共有ファイルシステムのオプション。
- オブジェクトストレージのリージョンとegress経路。
- データセットのステージング時間。
- モデル重みのキャッシュ戦略。
- チェックポイントの書き込み/読み出しスループット。
- スナップショットとバックアップの料金。
- レンタル終了後のクリーンアップポリシー。
次に実際のテストを実施します。製品版コンテナを取得し、データセットをステージし、重みを読み込み、チェックポイントを書き込み、チェックポイントから復元し、課金対象時間を測定します。
4. スケジューラとアクセスモデル
チームがジョブを確実にスケジュールできなければ、どんなに良いGPU契約でも失敗する可能性があります。次の責任の所在を決めてください:
- KubernetesまたはSlurmのセットアップ。
- ドライバーとCUDAバージョンの管理。
- コンテナレジストリとイメージスキャン。
- ユーザーアクセス、SSHポリシー、シークレット、監査ログ。
- チームまたはプロジェクトごとのクォータ。
- アイドル時のシャットダウン。
- コストタグと使用量エクスポート。
- インシデントのエスカレーション。
プロバイダー管理のクラスターはセットアップ時間を短縮できますが、悪いイメージ、失敗したジョブ、クォータの争議、緊急の容量変更に対する明確なランブックは依然として必要です。
GPUクラスターのレンタル用クラウド料金シート
各プロバイダーについて、見積もりを同じワークシートに標準化してください。
| 項目 | 確認する質問 | TCOを変える理由 |
|---|---|---|
| GPUコンピュート | 課金単位は秒、分、時間、月、または容量ブロックのどれですか? | 短いジョブとアイドル時間は課金粒度の影響を強く受けます。 |
| 最低利用コミット | 期間契約、最低支出、またはキャンセル不可の予約はありますか? | 見積もり単価が安くても、利用率が下がると高くつくことがあります。 |
| ストレージ | どのストレージ階層が含まれ、どれが別料金ですか? | データセット、チェックポイント、モデル重み、スナップショットはジョブ終了後も残る可能性があります。 |
| ネットワーク | クロスリージョン、パブリックegress、プライベートリンク、専用ファブリックは別料金ですか? | 大規模データセットや生成メディアは、予想以上のデータ移動を発生させることがあります。 |
| サポート | 応答時間、エスカレーション経路、含まれるエンジニア支援は何ですか? | クラスター障害は学習時間中に高くつきます。 |
| 信頼性 | マルチノードジョブ中に1台のノードが故障したらどうなりますか? | 再実行とキュー待ち時間もコストモデルに含める必要があります。 |
| アップグレードパス | 期間中にH100からH200/B200クラスの容量へ切り替えられますか? | GPU世代は性能対コストを変化させます。 |
| 可観測性 | ノードごとの使用率、ジョブログ、課金エクスポート、障害理由コードは取得できますか? | 使用データがなければ、経理は請求内容を説明できません。 |
| セキュリティ | テナント分離、監査ログ、シークレット、データ削除条件は文書化されていますか? | エンタープライズ購入者には、口頭の保証ではなく証拠が必要です。 |
スプレッドシートでは次の式を使ってください:
monthly cluster TCO =
  committed compute
  + burst compute
  + persistent storage
  + snapshots
  + network egress
  + support
  + idle waste
  + retry waste
  + engineering overhead
次に、有用単位を計算します:
cost per useful unit =
  monthly cluster TCO / accepted workload units
有用単位は、完了したファインチューニング、処理した学習トークン、受理された画像バッチ、推論トークン、顧客リクエスト、または出荷された実験など、ビジネス成果に一致している必要があります。
2026年に借りる、予約する、または購入する
キーワード「gpu cluster rental or cloud or buy 2026」は、実際の調達上の問いにたどり着きます。大きなコミットメントを行う前に、以下の判断表を使用してください。
| オプション | こういう場合に推奨 | こういう場合は避ける |
|---|---|---|
| オンデマンドでレンタルする | ワークロードが新しく、スケジュールが不確実、またはベンチマークがまだ変化している。 | すでに安定したベースラインの使用率があり、早急な利用可能性が求められる。 |
| 容量を予約する、または専有する | 使用率が予測可能で、リリース時期が重要であり、同じGPUクラスが数か月にわたって使用される。 | モデルアーキテクチャ、サービングエンジン、またはGPUの対象が近いうちに変わる可能性が高い。 |
| 購入する、またはコロケーションする | 非常に高い使用率、安定したハードウェア要件、データセンターの専門知識、資本承認がある。 | 迅速なスケールアップ、GPU世代の柔軟性、マネージドサポート、またはグローバルリージョンが必要。 |
| モデルAPIを使う | ハードウェアの制御よりもモデル出力が重要で、運用オーバーヘッドがGPU節約を上回る。 | カスタム重み、低レベルのカーネル制御、プライベートなサービングスタック、または固定されたハードウェア配置が必要。 |
多くのAI製品チームにとって、実用的な進め方は段階的です:
- ベンチマーク用にオンデマンドGPUをレンタルする。
- 安定したジョブを予約済みまたは専有のgpu cluster rentalに移す。
- バーストや実験トラフィックは柔軟な容量に残す。
- インフラ制御が製品改善につながらないワークロードではモデルAPIを使う。
- 購入またはコロケーションは、使用率とワークロードの形が安定してから再評価する。
インドでのGPUクラスターのレンタル
「gpu cluster rental in india」という表現は、買い手にインド特有の調達、データ所在地、またはレイテンシ要件がない限り、別記事として扱うべきではありません。同じワークシートを使い、そのうえで地域チェックを追加します:
- クラスターは物理的にインドにあるのか、近隣のアジア地域にあるのか、それともインド拠点の企業にのみ販売されているのか?
- トレーニングデータ、チェックポイント、ログはどこに保管されるのか?
- 国境をまたぐ転送、税金、請求書、サポート時間帯の要件は何か?
- インドの営業時間中にローカルサポートが必要か?
- 推論でレイテンシは重要か、それともオフラインのトレーニングワークロードなのか?
- ハードウェアを購入する代わりにレンタルする場合、輸入、調達、またはコンプライアンスの制約はあるか?
オフライントレーニングでは、データ転送とコンプライアンスが明確であれば、近隣リージョンでも許容できる場合があります。レイテンシに敏感な推論や規制対象データでは、リージョンと契約条件のほうが見出し上のGPU料金より重要になることがあります。
GPUクラスターのレンタル見積もりにおける警戒サイン
次のいずれかがあれば、取引を一旦止めてください:
- 見積もりに「H100 cluster」とあるのに、PCIe/SXM、ノード形状、メモリ、ネットワークの記載がない。
- 提供事業者が、分散ジョブで1台の不良ノードが出た場合の障害処理を説明できない。
- ストレージとegressが見積もりに含まれていない。
- 最も費用がかかるトレーニング期間中のサポート条件が曖昧である。
- 「専有」と言っているが、テナント分離、配置、noisy-neighborリスクが明確でない。
- 低い月額料金を提示しているが、使用率や解約条件がない。
- 契約前のベンチマーク期間がない。
- 提供事業者が請求エクスポート項目や使用データの共有を拒否する。
- 最初のワークロードの前にドライバー/CUDA/フレームワークのバージョンを確認できない。
- 営業資料にはコンプライアンスの記載があるが、契約書でデータ処理と削除が定義されていない。
契約前にベンチマークすべき項目
GPUクラスターを予約または拡張する前に、小規模な受け入れテストを実施してください。
| テスト | 合格条件 |
|---|---|
| コンテナの取得と起動 | 本番イメージが各ノードで迅速かつ再現性高く起動する。 |
| GPUヘルス | すべてのGPUが、期待どおりのモデル、メモリ、ドライバー、CUDA互換性を報告する。 |
| NCCL all-reduce | ノード間帯域幅とレイテンシが、提供事業者が示すクラスタークラスと一致する。 |
| ストレージ配置 | データセットとモデル重みを、計画したセットアップ時間内に配置できる。 |
| チェックポイントの書き込み/読み込み | GPU時間を長くアイドルにせずにチェックポイントが完了する。 |
| 障害訓練 | ワーカーを1台停止させ、再起動、チェックポイント、課金の挙動を確認する。 |
| アイドル時の停止 | 未使用ノードが、無駄が膨らむ前に停止するか、アラートを出す。 |
| 請求エクスポート | 使用状況をチーム、ワークロード、環境、ジョブごとに帰属できる。 |
| セキュリティレビュー | アクセス、シークレット、ログ、データ削除、監査記録がポリシーに一致する。 |
ベンチマーク結果は、日付、提供事業者、リージョン、GPUモデル、イメージバージョン、フレームワークバージョン、ノードIDとともに保存してください。これにより、ベンダー選定はレートカードの議論から再現可能なエンジニアリングレビューへと変わります。
Flatkeyの位置づけ
Flatkeyは、あらゆるレンタルGPUクラスターの代替ではありません。カスタム重み、プライベートカーネル、マルチノードトレーニング、または直接的なハードウェア制御が必要なら、依然としてGPU容量が必要です。
Flatkeyが重要になるのは、特定のワークロードに対してそもそもGPUを運用する必要があるかどうか、という問いに関してです。Flatkeyは、300以上の公式モデルと1,000以上の従量課金ツールに対して、1つのキー、1つの残高、1つの請求書、そしてリクエストレベルの使用可視化をチームに提供します。そのため、次の比較パスとして有用です:
- クラスターにコミットする前の試作ワークロード。
- 公式モデルAPIで実行できるエージェントやアプリケーショントラフィック。
- 自社運用GPUコストとモデルAPIコストを比較する必要がある財務レビュー。
- 専用ハードウェアに値するものを判断する前に、AI利用の共有台帳を持ちたいチーム。
ワークロードにハードウェア制御が不要な場合は、gpu クラスターのレンタルをAPI経由と比較する際、GPU時間そのものではなく、採用された結果1件あたりのコストで比較してください。関連ガイドとしては、GPUレンタル価格、AIモデルの価格比較、AIモデルの価格を比較する方法、AIゲートウェイの価格設定、AI API支出管理、およびAI APIクォータ管理が、次に確認すべき適切な項目です。
購入者向けチェックリスト
gpu クラスターのレンタルを承認する前に、このチェックリストを使用してください:
- ワークロードと有用な出力単位を定義する。
- 予約する前にオンデマンド容量をベンチマークする。
- GPUモデル、メモリ、ノード構成、ローカルストレージ、およびネットワークファブリックを指定する。
- マルチノード学習には分散ベンチマークを要求する。
- TCOにストレージ、エグレス、サポート、アイドル時間、および再試行の無駄を含める。
- リージョン、コンプライアンス、データ削除、および監査要件を確認する。
- 1台のノード障害が稼働中のジョブにどう影響するかを確認する。
- チーム、環境、ジョブごとの使用状況と請求のエクスポートを要求する。
- ベースラインの予約容量とバースト容量を分ける。
- ハードウェア制御が不要な場合は、モデルAPIと再比較する。
最適な gpu クラスターのレンタル判断とは、最小限の運用上の予想外でワークロードを確実に完了できるものです。最も安いGPU時間は、クラスター、ストレージ、ネットワーク、契約によって、その時間を受け入れられる作業に変えられる場合にのみ有用です。
購入者が尋ねる質問
gpu クラスターのレンタルとは何ですか?
GPUクラスターのレンタルとは、AI学習、推論、バッチ処理、または研究のために、通常は1つ以上の接続されたノードにまたがる複数のGPUをレンタルすることです。オンデマンド、予約、専用、マーケットプレイスベース、またはクラウドプロバイダーによる管理のいずれかになります。
gpu クラスターのレンタルはGPUを購入するより安いですか?
利用率、契約期間、運用スキル、資金調達、電力、データセンターへのアクセス、サポート、そして対象GPUクラスがどれだけ頻繁に変わるかによります。レンタルは通常、不確実性とスピードで有利です。購入が有利になるのは、利用率とハードウェア要件が安定しており、資本コストと運用コストを吸収できる場合だけです。
gpu クラスターのレンタルを提供するクラウドプロバイダーには何を尋ねるべきですか?
GPUモデル、ノード構成、ネットワークファブリック、ストレージ、リージョン、クォータ、サポートSLA、利用率の前提、請求エクスポート、データ削除条件、ベンチマークアクセス、そして分散ジョブ中に1台のノードが故障した場合に何が起こるかを尋ねてください。
レンタルしたGPUクラスターにInfiniBandまたはRoCEは必要ですか?
ノード間で頻繁に通信するジョブ、特に分散学習やシャーディングされたサービングでは、高性能なクラスター・ネットワークが必要です。並列度の高いバッチ推論や独立したジョブでは不要な場合があります。プレミアムなファブリックに料金を払う前に、自分のワークロードでベンチマークしてください。
インドでgpu クラスターのレンタルをどう比較すべきですか?
同じレンタル用ワークシートを使い、そこにリージョン、データ所在地、税金、請求書要件、サポート時間、レイテンシー、国境を越えるデータ転送に関するインド固有の質問を追加してください。GPUの時間単価だけで比較してはいけません。


