
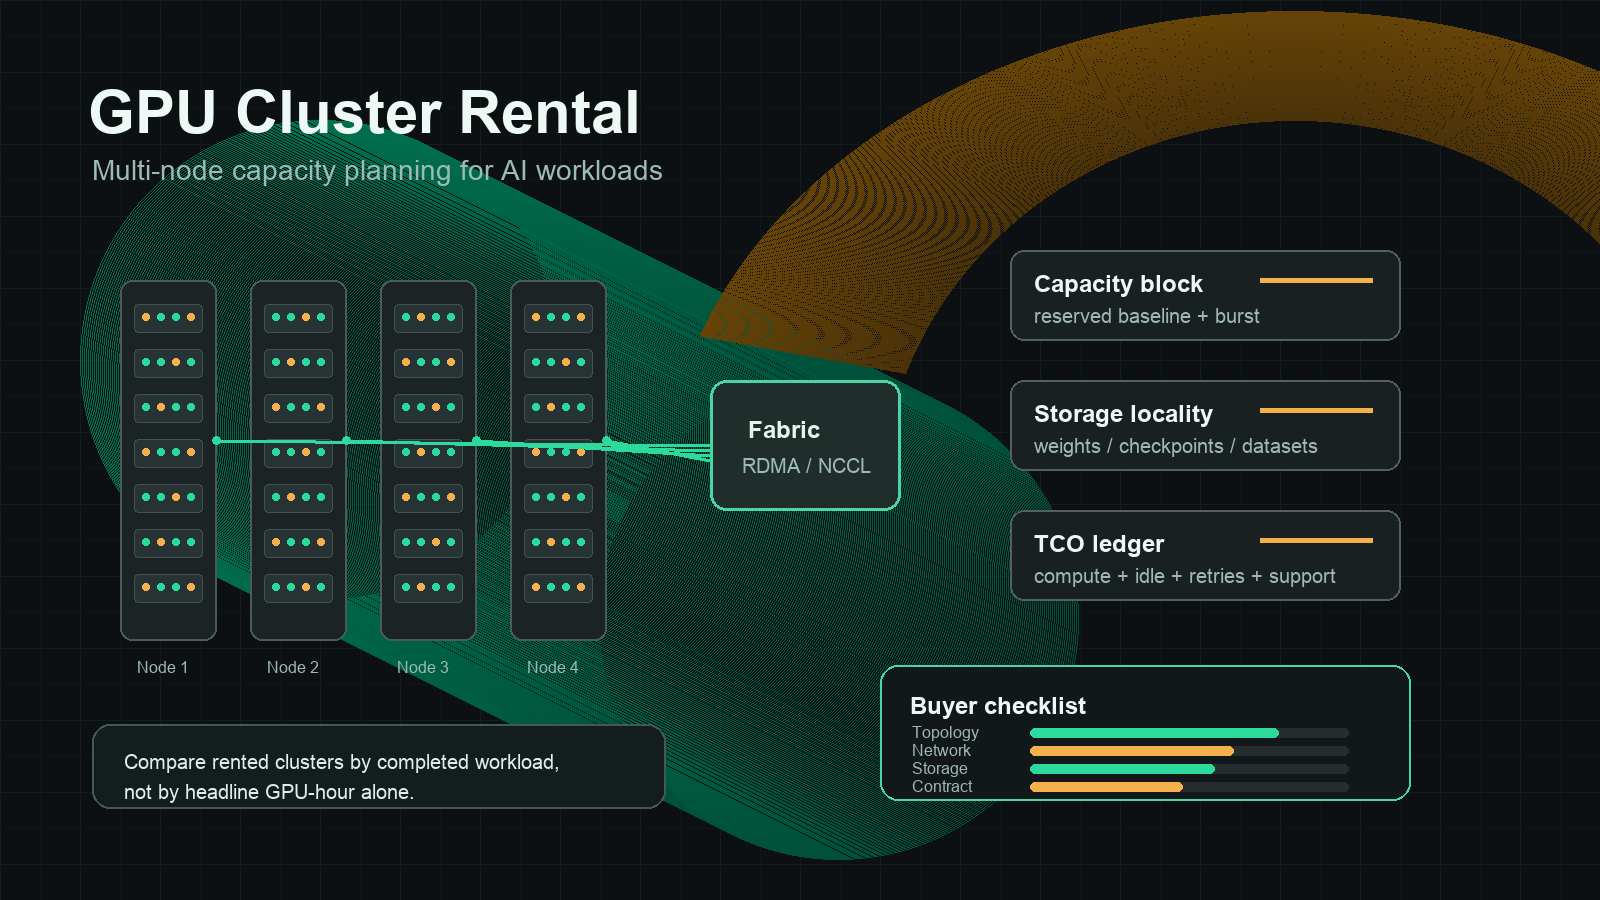
Aluguel de Cluster de GPU: Um Guia do Comprador para Capacidade de IA Multi-Nó
O aluguel de cluster de GPU torna-se atraente quando uma GPU, um nó ou uma conta de provedor já não é suficiente. Talvez um treinamento precise de oito a sessenta e quatro GPUs conectadas com rede de baixa latência. Talvez o tráfego de inferência tenha uma linha de base estável e um pico acentuado na semana de lançamento. Talvez a área de compras queira capacidade garantida de H100, H200, B200 ou L40S sem comprar hardware, contratar uma equipe de datacenter e esperar pelos prazos da cadeia de suprimentos.
A parte difícil é que um "cluster de GPU" não é um produto único. Uma cotação pode significar uma reserva de hyperscaler, uma alocação de cloud GPU especializada, um cluster bare-metal, uma frota de marketplace, uma configuração Kubernetes gerenciada ou um bloco de capacidade privada. A taxa horária da GPU é apenas o primeiro item da conta.
Este guia oferece às equipes corporativas de IA uma forma prática de avaliar opções de gpu cluster rental, comparar gpu cluster rental cloud providers e decidir quando alugar, reservar, comprar ou usar uma API de modelo em vez disso.
A resposta rápida
Use o aluguel de cluster de GPU quando sua carga de trabalho tiver pelo menos uma destas necessidades:
| Necessidade | Por que isso aponta para um cluster |
|---|---|
| Treinamento com várias GPUs | O modelo, o tamanho do batch ou o método de fine-tuning precisa de mais memória ou throughput do que um único nó pode fornecer. |
| Inferência em vários nós | Você precisa de alta capacidade de base, isolamento entre locatários ou tempo de fila previsível para tráfego de produção. |
| Utilização estável | A mesma classe de GPU permanecerá ocupada o suficiente para justificar capacidade reservada ou dedicada. |
| Jobs sensíveis à rede | Treinamento distribuído, serving particionado ou grandes cargas de trabalho de embeddings/índices precisam de posicionamento e comportamento de fabric conhecidos. |
| Controle de compras | Finanças precisa de um orçamento comprometido, termos de suporte, região, escopo de conformidade e data de renovação. |
Não escolha gpu cluster rental apenas porque uma GPU grande parece mais barata por hora. Escolha-o quando a carga de trabalho concluída for mais barata ou mais segura depois de incluir rede, armazenamento, utilização, risco de reinicialização, suporte, operações e termos contratuais.
custo real do cluster por saída útil =
  (computação + armazenamento + rede + tempo ocioso + tentativas + suporte + sobrecarga de engenharia)
  / execuções de treinamento aceitas, tokens de inferência, jobs, imagens ou solicitações de clientes
O que conta como aluguel de cluster de GPU?
O aluguel de cluster de GPU pode descrever vários movimentos de compra. Mantenha-os separados durante a avaliação.
| Modelo de aluguel | Melhor ajuste | Risco principal |
|---|---|---|
| Servidor multi-GPU de nó único | Treinamento inicial, fine-tuning, jobs em lote, experimentos de uma equipe | É fácil crescer além; as suposições de rede não se transferem para execuções em vários nós. |
| Cluster sob demanda em vários nós | Projetos curtos, janelas de benchmark, capacidade em pico | A disponibilidade pode mudar por região e família de GPU. |
| Cluster reservado ou dedicado | Inferência em produção, calendário de treinamento planejado, janelas de lançamento | Risco de utilização se a demanda mudar ou uma classe de GPU mais nova alterar a economia. |
| Frota de GPU de marketplace | Experimentos, jobs em lote flexíveis, capacidade oportunista de menor custo | Confiabilidade do host, movimentação de dados, interrupções e suporte podem variar. |
| Cluster Kubernetes gerenciado ou Slurm | Equipes de plataforma que precisam de agendamento e governança repetíveis | Você ainda é responsável pelo empacotamento da carga de trabalho, observabilidade, controle de custos e resposta a incidentes. |
| API de modelo ou inferência serverless | Equipes que precisam de resultados, não de controle de hardware | Menos controle sobre pesos, kernels, posicionamento e a stack de serving de baixo nível. |
É por isso que a consulta "gpu cluster rental or cloud gpu cluster" geralmente tem uma divisão de intenção de compra. Algumas equipes precisam de capacidade física que possam agendar. Outras precisam de saídas de IA confiáveis e não devem operar GPUs diretamente.
Comece pela carga de trabalho, não pelo provedor
Antes de comparar gpu cluster rental cloud providers, escreva um resumo de capacidade de uma página. Uma cotação de provedor só é significativa se todos os fornecedores enxergarem a mesma forma de carga de trabalho.
| Campo resumido | O que escrever |
|---|---|
| Tipo de workload | Pré-treinamento, fine-tuning, embeddings para recuperação, inferência em lote, inferência online, geração de imagem/vídeo, simulação ou notebooks de pesquisa. |
| Modelo e framework | Família do modelo, contagem de parâmetros, precisão, quantização, PyTorch/JAX, vLLM, SGLang, TensorRT-LLM, Ray, Kubernetes, Slurm ou outro escalonador. |
| GPU alvo | H100 SXM, H100 PCIe, H200, B200, A100, L40S, RTX 4090, RTX PRO 6000 ou uma faixa de substitutos aceitáveis. |
| Formato do cluster | GPUs por nó, número de nós, memória por GPU, proporção CPU/RAM, NVMe local e se os jobs precisam de um único grupo de posicionamento. |
| Necessidade de rede | NVLink/NVSwitch intra-nó, InfiniBand ou RoCE entre nós, largura de banda alvo para all-reduce e jitter aceitável. |
| Caminho de armazenamento | Tamanho do dataset, tamanho do checkpoint, cache de pesos do modelo, localização do armazenamento de objetos, scratch local, política de snapshots e período de retenção. |
| Meta de utilização | Utilização de base esperada, horas de pico, tolerância à ociosidade, janelas de manutenção e tempo de fila esperado. |
| Política de confiabilidade | Frequência de checkpoint, orçamento de tentativas, risco de evacuação tolerado, SLA de suporte e caminho de escalonamento de incidentes. |
| Dados e conformidade | Região, residência de dados, privacidade, auditoria, exportação e requisitos de isolamento do cliente. |
| Limite contratual | Duração do contrato, gasto mínimo, garantia de capacidade, caminho de upgrade, escopo de suporte e termos de rescisão. |
Se você não conseguir preencher esta tabela, ainda não reserve um cluster. Alugue primeiro capacidade sob demanda de curto prazo, faça benchmark do workload e transforme o benchmark em um briefing de aquisição.
Categorias de provedores para comparar
Há três categorias de provedores úteis para aluguel de cluster de GPU.
| Categoria | Exemplos para avaliar | Em que costumam se sair bem | O que verificar |
|---|---|---|---|
| Nuvens hyperscale | AWS, Google Cloud, Microsoft Azure | Identidade madura, regiões, conformidade, produtos de rede, suporte, controles de faturamento | Disponibilidade de GPU, cota, mecânica de reserva, conta total da nuvem, custo de transferência de dados e complexidade operacional. |
| Nuvens especializadas em GPU | Lambda, CoreWeave, Crusoe, Runpod Enterprise, nuvens regionais de IA | Conversas mais rápidas sobre aquisição de GPU, suporte nativo para IA, preços de GPU mais simples, termos de cluster dedicado | Tecido de rede, armazenamento, observabilidade, controles corporativos, SLA de suporte e termos de renovação/upgrade. |
| Marketplaces e frotas flexíveis | Vast.ai, capacidade no estilo comunidade da Runpod, capacidade de GPU intermediada | Menor custo de entrada e experimentos rápidos | Confiabilidade do host, risco de interrupção, movimentação de dados, profundidade do suporte, conformidade e se o tráfego de produção é apropriado. |
Use as páginas oficiais de origem como checkpoints atuais, e não como tabelas permanentes de preços. Para este artigo, as afirmações foram verificadas em 12 de outubro de 2026.
| Fonte | Por que isso importa em uma avaliação de compra |
|---|---|
| Instâncias AWS EC2 P5 e EC2 Capacity Blocks | Verifique a forma da instância do cluster H100, a linguagem de EFA/rede, a mecânica de reserva, a cota e a disponibilidade regional. |
| Máquinas otimizadas para acelerador do Google Cloud e Preços de GPU | Verifique as famílias de máquinas A3/A4, a estrutura de preços de GPU, o armazenamento, os descontos por uso comprometido e as observações de região. |
| Série Azure ND H100 v5 | Verifique a forma do cluster H100 da Azure, a estrutura de InfiniBand, o dimensionamento da VM e a disponibilidade regional. |
| Lambda GPU Cloud | Verifique as tarifas publicadas da nuvem GPU, os tipos de instância, os termos de nuvem reservada e as notas de disponibilidade. |
| Preços da Runpod e Documentação da Runpod | Separe pods, serverless, capacidade segura/comunitária, armazenamento e pressupostos de volume de rede. |
| Preços da Vast.ai e Documentação da Vast.ai | Trate cada anúncio como uma oferta de marketplace com seu próprio host, confiabilidade, armazenamento, localização e perfil de interrupção. |
| Testes NVIDIA NCCL | Use benchmarks práticos de treinamento distribuído em vez de aceitar linguagem genérica de "rede de alta velocidade". |
| NVIDIA GPU Operator e Slurm GRES | Confirme se sua equipe ou o provedor é responsável pelo agendamento de GPU, drivers, telemetria e política de alocação. |
As verificações multi-nó que importam
O aluguel de uma única GPU é, em grande parte, uma decisão de preço, memória, imagem e disponibilidade. O aluguel de cluster de GPU multi-nó adiciona risco de topologia e de operações.
1. Topologia de GPU
Peça a forma exata do nó e se o cluster é homogêneo.
- Modelo da GPU e tamanho da memória.
- PCIe versus SXM, quando relevante.
- GPUs por nó.
- Topologia NVLink ou NVSwitch intra-nó.
- Modelo de CPU, RAM e NVMe local por nó.
- Política de alocação MIG, vGPU ou GPU completa.
- Se todos os nós estão em um único domínio de posicionamento.
Não aceite "8x H100" como uma especificação completa. Um servidor 8x H100 SXM, um servidor 8x H100 PCIe e oito nós H100 separados podem se comportar de forma muito diferente.
2. Fabric de rede
Para treinamento distribuído, a rede pode decidir se o cluster é útil. Peça por:
- Detalhes de InfiniBand, RoCE, EFA, GPUDirect ou outra fabric.
- Quantidade e velocidade de NIC por nó.
- Razão de oversubscription.
- Garantia de posicionamento para os nós cotados.
- Se o provedor executou testes de all-reduce do NCCL nesse pool exato.
- Política de manutenção e isolamento de falhas.
Coloque a validação de rede no teste de aceitação:
teste de aceitação do cluster:
  execute nccl-tests all_reduce em todos os nós alugados
  compare a largura de banda e a latência com a cotação do provedor
  repita após a instalação da imagem do contêiner, do driver e do framework
  salve os logs com data, IDs dos nós, modelo da GPU e região
Se o provedor não puder suportar um benchmark distribuído básico antes da assinatura do contrato, trate isso como um sinal de risco.
3. Armazenamento e caminho de dados
As equipes de GPU frequentemente subestimam o armazenamento porque a cotação da GPU parece alta e a linha de armazenamento parece comum. Para clusters multinó, o armazenamento decide o tempo de inicialização, o tempo de checkpoint e a recuperação de falhas.
Peça por:
- NVMe local por nó.
- Opções de sistema de arquivos compartilhado.
- Região do armazenamento de objetos e caminho de saída.
- Tempo de preparação do conjunto de dados.
- Estratégia de cache dos pesos do modelo.
- Taxa de transferência de gravação/leitura de checkpoints.
- Preço de snapshots e backups.
- Política de limpeza após o término do aluguel.
Depois execute um teste real: baixe o contêiner de produção, prepare o conjunto de dados, carregue os pesos, grave um checkpoint, restaure a partir do checkpoint e meça o tempo faturável.
4. Agendador e modelo de acesso
O melhor negócio de GPU ainda pode falhar se sua equipe não conseguir agendar jobs de forma confiável. Decida quem é responsável por:
- Configuração do Kubernetes ou Slurm.
- Gerenciamento da versão do driver e do CUDA.
- Registro de contêineres e varredura de imagens.
- Acesso de usuários, política de SSH, segredos e logs de auditoria.
- Cotas por equipe ou projeto.
- Desligamento por inatividade.
- Tags de custo e exportações de uso.
- Escalonamento de incidentes.
Um cluster gerenciado pelo provedor pode reduzir o tempo de configuração, mas você ainda precisa de um runbook claro para imagens ruins, jobs com falha, disputas de cota e mudanças urgentes de capacidade.
Planilha de precificação de aluguel de cluster de GPU na nuvem
Para cada provedor, normalize a cotação na mesma planilha.
| Item | Pergunta a fazer | Por que isso altera o TCO |
|---|---|---|
| Computação de GPU | Qual é a unidade faturável: segundo, minuto, hora, mês ou bloco de capacidade? | Jobs curtos e tempo ocioso são sensíveis à granularidade da cobrança. |
| Compromisso mínimo | Existe prazo, gasto mínimo ou reserva não cancelável? | Uma taxa cotada baixa pode ficar cara se a utilização cair. |
| Armazenamento | Quais camadas de armazenamento estão incluídas e quais são cobradas separadamente? | Conjuntos de dados, checkpoints, pesos do modelo e snapshots podem persistir após o fim dos jobs. |
| Rede | Cross-region, saída pública, link privado ou fabric dedicada são cobrados separadamente? | Conjuntos de dados grandes e mídia gerada podem mover mais dados do que o esperado. |
| Suporte | Qual é o tempo de resposta, caminho de escalonamento e ajuda de engenharia incluída? | Incidentes no cluster são caros durante janelas de treinamento. |
| Confiabilidade | O que acontece se um nó falhar durante um job multinó? | Tempo de reinício e fila fazem parte do modelo de custo. |
| Caminho de upgrade | É possível migrar de capacidade H100 para H200/B200 durante o prazo? | As gerações de GPU mudam o desempenho por dólar. |
| Observabilidade | Você recebe utilização por nó, logs de jobs, exportações de faturamento e códigos de motivo de falha? | Sem dados de uso, o financeiro não consegue explicar a fatura. |
| Segurança | Isolamento de locatário, logs de auditoria, segredos e termos de exclusão de dados estão documentados? | Compradores corporativos precisam de prova, não de garantias verbais. |
Use esta fórmula na planilha:
TCO mensal do cluster =
  computação comprometida
  + computação burst
  + armazenamento persistente
  + snapshots
  + saída de rede
  + suporte
  + desperdício por ociosidade
  + desperdício por tentativas
  + overhead de engenharia
Depois calcule a unidade útil:
custo por unidade útil =
  TCO mensal do cluster / unidades de carga de trabalho aceitas
A unidade útil deve corresponder ao resultado de negócio: fine-tunes concluídos, tokens de treinamento processados, lotes de imagens aceitos, tokens de inferência, solicitações de clientes ou experimentos entregues.
Alugar, reservar ou comprar em 2026
A palavra-chave "gpu cluster rental or cloud or buy 2026" chega à verdadeira questão de procurement. Use a tabela de decisão abaixo antes de um grande compromisso.
| Opção | Prefira quando | Evite quando |
|---|---|---|
| Alugar sob demanda | A carga de trabalho é nova, o cronograma é incerto ou os benchmarks ainda estão mudando. | Você já tem utilização de base estável e requisitos urgentes de disponibilidade. |
| Reservar ou dedicar capacidade | A utilização é previsível, as datas de lançamento importam e a mesma classe de GPU ficará ocupada por meses. | A arquitetura do modelo, o mecanismo de serving ou o alvo de GPU provavelmente mudará em breve. |
| Comprar ou usar colocation | Você tem utilização muito alta, necessidades estáveis de hardware, expertise em datacenter e aprovação de capital. | Você precisa de escalonamento rápido, flexibilidade de geração de GPU, suporte gerenciado ou regiões globais. |
| Usar APIs de modelo | Você precisa mais dos resultados do modelo do que do controle de hardware, e a sobrecarga operacional dominaria a economia em GPUs. | Você precisa de pesos personalizados, controle de kernel de baixo nível, stack de serving privada ou posicionamento fixo de hardware. |
Para muitas equipes de produto de IA, o caminho prático é em etapas:
- Alugue GPUs sob demanda para benchmarks.
- Migre trabalhos estáveis para aluguel de cluster de GPU reservado ou dedicado.
- Mantenha o tráfego de picos e de experimentação em capacidade flexível.
- Use APIs de modelo para cargas de trabalho em que o controle da infraestrutura não melhora o produto.
- Reavalie comprar ou usar colocation apenas depois que a utilização e a forma da carga de trabalho estiverem estáveis.
Aluguel de cluster de GPU na Índia
A expressão "gpu cluster rental in india" não deve ser tratada como um artigo separado, a menos que o comprador tenha requisitos específicos da Índia para sourcing, residência de dados ou latência. Use a mesma planilha e, em seguida, adicione verificações regionais:
- O cluster está fisicamente na Índia, em regiões asiáticas próximas ou é vendido apenas para empresas baseadas na Índia?
- Onde os dados de treinamento, checkpoints e logs будут residir?
- Quais são os requisitos de transferência transfronteiriça, impostos, fatura e horário de suporte?
- É necessário suporte local durante o horário comercial indiano?
- A latência importa para inference, ou esta é uma carga de trabalho de treinamento offline?
- Há restrições de importação, aquisição ou conformidade se comprar hardware em vez de alugar?
Para treinamento offline, uma região próxima pode ser aceitável se a transferência de dados e a conformidade estiverem limpas. Para inference sensível à latência ou dados regulados, a região e os termos contratuais podem importar mais do que a taxa de GPU destacada.
Sinais de alerta em cotações de aluguel de cluster de GPU
Pare o negócio se você vir qualquer um destes:
- A cotação diz "H100 cluster" mas não PCIe/SXM, formato do nó, memória ou rede.
- O provedor não consegue descrever o tratamento de falhas para um nó com problema em um trabalho distribuído.
- Storage e egress estão ausentes da cotação.
- Os termos de suporte são vagos durante sua janela de treinamento mais cara.
- "Dedicado" é usado sem esclarecer isolamento de locatário, posicionamento e risco de noisy neighbor.
- A cotação apresenta uma tarifa mensal baixa, mas nenhum termo de utilização ou cancelamento.
- Não há janela de benchmark antes do compromisso.
- O provedor se recusa a compartilhar campos de exportação de cobrança ou dados de uso.
- Você não consegue verificar as versões de driver/CUDA/framework antes da primeira carga de trabalho.
- O material de vendas menciona conformidade, mas o contrato não define tratamento e exclusão de dados.
O que benchmarkar antes de assinar
Execute um pequeno conjunto de aceitação antes de reservar ou ampliar um cluster de GPU alugado.
| Teste | Condição de aprovação |
|---|---|
| Download e inicialização do contêiner | A imagem de produção inicia rapidamente e de forma reproduzível em cada nó. |
| Saúde da GPU | Todas as GPUs informam o modelo, a memória, o driver e a compatibilidade com CUDA esperados. |
| NCCL all-reduce | A largura de banda e a latência entre nós correspondem à classe de cluster declarada pelo provedor. |
| Faseamento de storage | O conjunto de dados e os pesos do modelo podem ser preparados dentro da janela de configuração planejada. |
| Gravação/leitura de checkpoint | Os checkpoints são concluídos sem deixar o tempo de GPU ocioso por tempo demais. |
| Teste de falha | Mate um worker e confirme o comportamento de reinício, checkpoint e cobrança. |
| Desligamento por inatividade | Nós não utilizados param ou disparam alerta antes que o desperdício se acumule. |
| Exportação de cobrança | O uso pode ser atribuído por equipe, carga de trabalho, ambiente e job. |
| Revisão de segurança | Acesso, segredos, logs, exclusão de dados e registros de auditoria correspondem à política. |
Salve a saída do benchmark com a data, provedor, região, modelo de GPU, versão da imagem, versão do framework e IDs dos nós. Isso transforma a seleção de fornecedor de um debate sobre tabela de preços em uma revisão de engenharia reproduzível.
Onde o Flatkey se encaixa
O Flatkey não é um substituto para todo cluster de GPU alugado. Se você precisa de pesos personalizados, kernels privados, treinamento multi-nó ou controle direto do hardware, ainda precisa de capacidade de GPU.
O Flatkey é relevante quando a questão é se você precisa operar GPUs em absoluto para uma determinada carga de trabalho. O Flatkey dá às equipes uma única chave, um único saldo e uma única fatura em mais de 300 modelos oficiais e mais de 1.000 ferramentas pay-per-call, com visibilidade de uso no nível de requisição. Isso o torna útil como caminho de comparação para:
- Cargas de trabalho de protótipo antes de você se comprometer com um cluster.
- Tráfego de agentes e aplicações que pode rodar em APIs de modelo oficiais.
- Revisões financeiras que precisam comparar o custo de GPUs auto-hospedadas com o custo de APIs de modelo.
- Equipes que desejam um ledger compartilhado para uso de IA antes de decidir o que merece hardware dedicado.
Se uma carga de trabalho não exigir controle de hardware, compare o aluguel de cluster de GPU com uma rota de API com base no custo por resultado aceito, e não em horas brutas de GPU. Os guias relacionados sobre preços de aluguel de GPU, comparação de preços de modelos de IA, como comparar preços de modelos de IA, preços de gateways de IA, gestão de gastos com API de IA e gestão de cotas de API de IA são as próximas verificações corretas.
Checklist do comprador
Use esta lista antes de aprovar o aluguel de cluster de GPU:
- Defina a carga de trabalho e a unidade de saída útil.
- Faça benchmark da capacidade sob demanda antes de reservar.
- Especifique o modelo de GPU, a memória, a forma do nó, o armazenamento local e a malha de rede.
- Exija um benchmark distribuído para treinamento multi-nó.
- Inclua armazenamento, egress, suporte, tempo ocioso e desperdício por tentativas no TCO.
- Confirme região, conformidade, exclusão de dados e requisitos de auditoria.
- Pergunte como um nó com falha afeta um job em execução.
- Exija exportações de uso e faturamento por equipe, ambiente e job.
- Separe a capacidade reservada de base da capacidade de pico.
- Recompare com APIs de modelo quando o controle de hardware não for necessário.
A melhor decisão de aluguel de cluster de GPU é aquela que conclui a carga de trabalho de forma confiável com o menor surpreso operacional. A hora de GPU mais barata só é útil se o cluster, o armazenamento, a rede e o contrato permitirem que sua equipe transforme essa hora em trabalho aceito.
Perguntas que os compradores fazem
O que é aluguel de cluster de GPU?
Aluguel de cluster de GPU é a prática de alugar várias GPUs, frequentemente em um ou mais nós conectados, para treinamento de IA, inferência, processamento em lote ou pesquisa. Pode ser sob demanda, reservado, dedicado, baseado em marketplace ou gerenciado por um provedor de nuvem.
O aluguel de cluster de GPU é mais barato do que comprar GPUs?
Depende da utilização, do prazo, da capacidade operacional, do financiamento, da energia, do acesso ao datacenter, do suporte e da frequência com que a classe de GPU desejada muda. Alugar geralmente vence em cenários de incerteza e rapidez. Comprar só pode vencer quando a utilização e as necessidades de hardware são estáveis o suficiente para absorver os custos de capital e operação.
O que devo perguntar aos provedores de nuvem de aluguel de cluster de GPU?
Pergunte pelo modelo de GPU, forma do nó, malha de rede, armazenamento, região, cota, SLA de suporte, premissas de utilização, exportações de faturamento, termos de exclusão de dados, acesso a benchmark e o que acontece quando um nó falha durante um job distribuído.
Preciso de InfiniBand ou RoCE para um cluster de GPU alugado?
Você precisa de rede de cluster de alto desempenho quando os jobs se comunicam intensamente entre nós, especialmente em treinamento distribuído e serving fragmentado. Talvez não precise disso para inferência em lote altamente paralela ou jobs independentes. Faça benchmark com sua própria carga de trabalho antes de pagar por uma malha premium.
Como devo comparar o aluguel de cluster de GPU na Índia?
Use a mesma planilha de aluguel e, em seguida, adicione perguntas específicas da Índia sobre região, residência de dados, impostos, requisitos de faturamento, horário de suporte, latência e transferência de dados transfronteiriça. Não compare apenas a taxa horária da GPU.


