
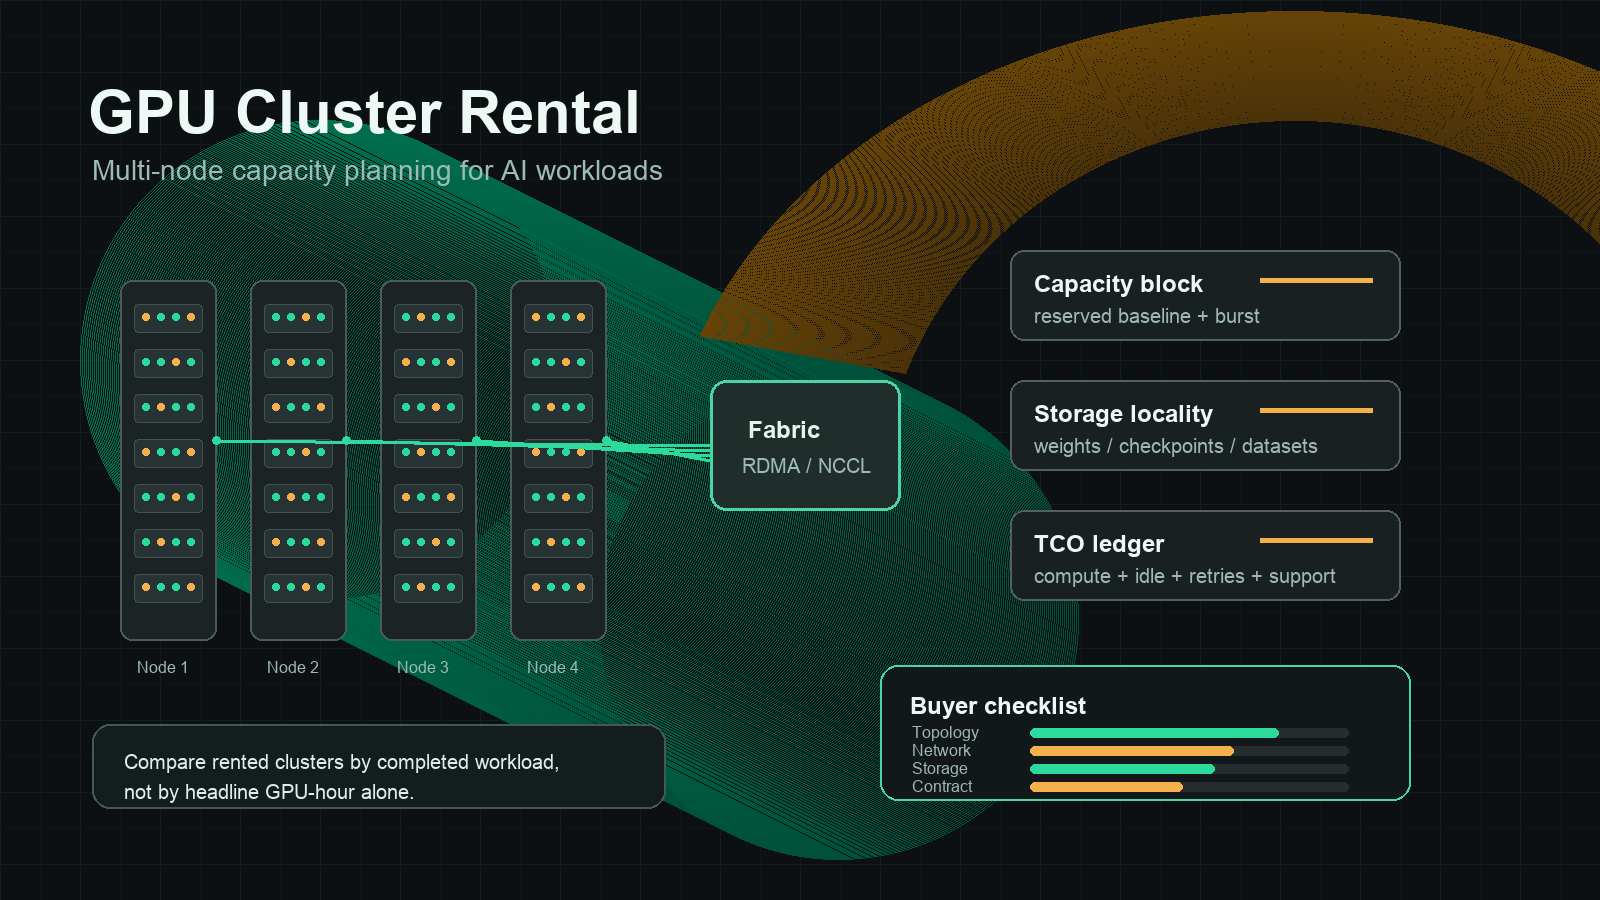
Thuê Cụm GPU: Hướng Dẫn Cho Người Mua Về Năng Lực AI Đa Nút
Thuê cụm GPU trở nên hấp dẫn khi một GPU, một node, hoặc một tài khoản của nhà cung cấp không còn đủ nữa. Có thể một lần huấn luyện cần từ tám đến sáu mươi bốn GPU được kết nối bằng mạng có độ trễ thấp. Có thể lưu lượng suy luận có mức nền ổn định và bùng nổ mạnh vào tuần ra mắt. Có thể bộ phận mua sắm muốn năng lực H100, H200, B200, hoặc L40S được đảm bảo mà không cần mua phần cứng, thuê đội ngũ trung tâm dữ liệu, và chờ thời gian cung ứng của chuỗi cung ứng.
Phần khó là một “cụm GPU” không phải là một sản phẩm đơn lẻ. Một báo giá có thể là một đặt chỗ của hyperscaler, một phân bổ trên đám mây GPU chuyên biệt, một cụm bare-metal, một đội máy trên marketplace, một thiết lập Kubernetes được quản lý, hoặc một khối năng lực riêng. Mức giá GPU theo giờ chỉ là dòng mục đầu tiên.
Hướng dẫn này cung cấp cho các đội AI doanh nghiệp một cách thực tế để đánh giá các lựa chọn thuê cụm gpu, so sánh các nhà cung cấp cloud thuê cụm gpu, và quyết định khi nào nên thuê, đặt chỗ, mua, hoặc dùng API mô hình thay thế.
Câu trả lời nhanh
Hãy dùng thuê cụm GPU khi khối lượng công việc của bạn có ít nhất một trong những nhu cầu sau:
| Nhu cầu | Vì sao điều đó cho thấy cần một cụm |
|---|---|
| Huấn luyện đa GPU | Mô hình, kích thước batch, hoặc phương pháp fine-tuning cần nhiều bộ nhớ hay thông lượng hơn một node có thể cung cấp. |
| Suy luận đa nút | Bạn cần năng lực nền cao, cô lập tenant, hoặc thời gian xếp hàng có thể dự đoán cho lưu lượng sản xuất. |
| Sử dụng ổn định | Cùng một lớp GPU sẽ bận đủ nhiều để biện minh cho năng lực được đặt chỗ hoặc dành riêng. |
| Các tác vụ nhạy cảm với mạng | Huấn luyện phân tán, phục vụ phân mảnh, hoặc các khối lượng embedding/index lớn cần vị trí triển khai và hành vi fabric đã biết trước. |
| Kiểm soát mua sắm | Bộ phận tài chính cần ngân sách cam kết, điều khoản hỗ trợ, khu vực, phạm vi tuân thủ, và ngày gia hạn. |
Đừng chọn thuê cụm gpu chỉ vì một GPU lớn có vẻ rẻ hơn theo giờ. Hãy chọn nó khi khối lượng công việc hoàn thành rẻ hơn hoặc an toàn hơn sau khi bạn tính cả mạng, lưu trữ, mức sử dụng, rủi ro khởi động lại, hỗ trợ, vận hành, và các điều khoản hợp đồng.
chi phí thực của cụm trên mỗi đầu ra hữu ích =
  (compute + lưu trữ + mạng + thời gian nhàn rỗi + thử lại + hỗ trợ + chi phí vận hành kỹ thuật)
  / các lần huấn luyện được chấp nhận, token suy luận, job, hình ảnh, hoặc yêu cầu khách hàng
Điều gì được tính là thuê cụm GPU?
Thuê cụm GPU có thể mô tả một số hình thức mua sắm khác nhau. Hãy tách chúng ra trong quá trình đánh giá.
| Mô hình thuê | Phù hợp nhất với | Rủi ro chính |
|---|---|---|
| Máy chủ đa GPU một node | Huấn luyện giai đoạn đầu, fine-tuning, tác vụ batch, thử nghiệm của một nhóm | Dễ trở nên không đủ; các giả định về mạng không chuyển sang các lần chạy đa nút. |
| Cụm on-demand đa nút | Dự án ngắn, cửa sổ benchmark, năng lực tăng đột biến | Tính sẵn có có thể thay đổi theo khu vực và dòng GPU. |
| Cụm được đặt chỗ hoặc dành riêng | Suy luận sản xuất, lịch huấn luyện đã lên kế hoạch, các cửa sổ ra mắt | Rủi ro sử dụng nếu nhu cầu thay đổi hoặc một lớp GPU mới làm dịch chuyển hiệu quả kinh tế. |
| Đội máy GPU trên marketplace | Thử nghiệm, tác vụ batch linh hoạt, năng lực cơ hội chi phí thấp hơn | Độ tin cậy của host, di chuyển dữ liệu, gián đoạn, và hỗ trợ có thể khác nhau. |
| Cụm Kubernetes hoặc Slurm được quản lý | Các đội nền tảng cần lập lịch và quản trị có thể lặp lại | Bạn vẫn phải tự chịu trách nhiệm đóng gói workload, quan sát hệ thống, kiểm soát chi phí, và phản ứng sự cố. |
| API mô hình hoặc suy luận serverless | Các đội cần kết quả đầu ra, không cần kiểm soát phần cứng | Ít kiểm soát hơn đối với trọng số, kernel, vị trí triển khai, và ngăn xếp phục vụ ở mức thấp. |
Đó là lý do truy vấn "gpu cluster rental or cloud gpu cluster" thường có sự tách biệt về ý định mua hàng. Một số đội cần năng lực vật lý mà họ có thể lập lịch. Những đội khác cần đầu ra AI đáng tin cậy và không nên vận hành GPU trực tiếp.
Hãy bắt đầu từ workload, không phải nhà cung cấp
Trước khi so sánh các nhà cung cấp cloud thuê cụm gpu, hãy viết một bản tóm tắt năng lực dài một trang. Một báo giá từ nhà cung cấp chỉ có ý nghĩa nếu mọi nhà cung cấp đều nhìn thấy cùng một hình dạng workload.
| Trường ngắn | Nên viết gì |
|---|---|
| Loại workload | Pretraining, fine-tuning, retrieval embedding, batch inference, online inference, tạo ảnh/video, mô phỏng, hoặc notebook nghiên cứu. |
| Mô hình và framework | Họ mô hình, số lượng tham số, độ chính xác, lượng tử hóa, PyTorch/JAX, vLLM, SGLang, TensorRT-LLM, Ray, Kubernetes, Slurm, hoặc một bộ lập lịch khác. |
| GPU mục tiêu | H100 SXM, H100 PCIe, H200, B200, A100, L40S, RTX 4090, RTX PRO 6000, hoặc một dải GPU thay thế chấp nhận được. |
| Hình dạng cụm | Số GPU mỗi node, số node, bộ nhớ mỗi GPU, tỷ lệ CPU/RAM, NVMe cục bộ, và liệu công việc có cần một placement group hay không. |
| Nhu cầu mạng | NVLink/NVSwitch trong node, InfiniBand hoặc RoCE giữa các node, băng thông all-reduce mục tiêu, và mức jitter chấp nhận được. |
| Đường dẫn lưu trữ | Kích thước bộ dữ liệu, kích thước checkpoint, bộ đệm trọng số mô hình, vị trí lưu trữ object, scratch cục bộ, chính sách snapshot, và thời gian lưu giữ. |
| Mục tiêu sử dụng | Mức sử dụng nền kỳ vọng, số giờ burst, ngưỡng chịu được khi nhàn rỗi, cửa sổ bảo trì, và thời gian xếp hàng kỳ vọng. |
| Chính sách độ tin cậy | Tần suất checkpoint, ngân sách retry, rủi ro eviction có thể chấp nhận, SLA hỗ trợ, và đường leo thang sự cố. |
| Dữ liệu và tuân thủ | Khu vực, nơi cư trú dữ liệu, quyền riêng tư, kiểm toán, xuất khẩu, và yêu cầu cô lập khách hàng. |
| Ranh giới hợp đồng | Thời hạn, mức chi tối thiểu, cam kết năng lực, đường nâng cấp, phạm vi hỗ trợ, và điều khoản chấm dứt. |
Nếu bạn không thể điền bảng này, thì chưa nên đặt trước một cụm. Hãy thuê năng lực on-demand ngắn hạn trước, benchmark workload, rồi biến benchmark đó thành một bản brief mua sắm.
Các nhóm nhà cung cấp cần so sánh
Có ba nhóm nhà cung cấp hữu ích cho thuê cụm gpu cluster rental.
| Nhóm | Ví dụ để đánh giá | Điểm mạnh thường có | Cần xác minh |
|---|---|---|---|
| Đám mây hyperscale | AWS, Google Cloud, Microsoft Azure | Identity, vùng, tuân thủ, sản phẩm mạng, hỗ trợ, và kiểm soát thanh toán trưởng thành | Tính sẵn có GPU, quota, cơ chế reservation, tổng hóa đơn cloud, chi phí truyền dữ liệu, và độ phức tạp vận hành. |
| Đám mây GPU chuyên biệt | Lambda, CoreWeave, Crusoe, Runpod Enterprise, các đám mây AI theo khu vực | Trao đổi mua sắm GPU nhanh hơn, hỗ trợ native cho AI, giá GPU đơn giản hơn, điều khoản cụm dành riêng | Hạ tầng mạng, lưu trữ, khả năng quan sát, kiểm soát cho doanh nghiệp, SLA hỗ trợ, và điều khoản gia hạn/nâng cấp. |
| Marketplace và đội xe linh hoạt | Vast.ai, năng lực kiểu cộng đồng của Runpod, năng lực GPU qua trung gian | Chi phí đầu vào thấp hơn và thử nghiệm nhanh | Độ tin cậy của host, rủi ro gián đoạn, di chuyển dữ liệu, độ sâu hỗ trợ, tuân thủ, và liệu lưu lượng sản xuất có phù hợp hay không. |
Hãy dùng các trang nguồn chính thức như những điểm kiểm tra hiện tại, không phải bảng giá cố định. Với bài viết này, các khẳng định đã được kiểm tra vào ngày 12 tháng 10 năm 2026.
| Nguồn | Vì sao nó quan trọng trong quá trình đánh giá của người mua |
|---|---|
| AWS EC2 P5 instances và EC2 Capacity Blocks | Kiểm tra hình dạng instance của cụm H100, ngôn ngữ EFA/networking, cơ chế reservation, quota, và tính sẵn có theo vùng. |
| Google Cloud accelerator-optimized machines và GPU pricing | Kiểm tra các họ máy A3/A4, cấu trúc giá GPU, lưu trữ, chiết khấu committed use, và ghi chú theo vùng. |
| Azure ND H100 v5 series | Kiểm tra hình dạng cụm H100 của Azure, cách mô tả InfiniBand, kích cỡ VM, và tính sẵn có theo khu vực. |
| Lambda GPU Cloud | Kiểm tra giá GPU cloud được công bố, các loại instance, điều khoản cloud dành riêng, và ghi chú về khả dụng. |
| Runpod pricing và Runpod docs | Tách riêng các giả định về pods, serverless, capacity secure/community, lưu trữ, và volume mạng. |
| Vast.ai pricing và Vast.ai docs | Hãy xem mỗi listing như một đề nghị marketplace với host, độ tin cậy, lưu trữ, vị trí, và hồ sơ gián đoạn riêng. |
| NVIDIA NCCL tests | Sử dụng benchmark training phân tán thực tế thay vì chấp nhận cách nói chung chung "mạng tốc độ cao". |
| NVIDIA GPU Operator và Slurm GRES | Xác nhận liệu nhóm của bạn hay nhà cung cấp sở hữu việc lập lịch GPU, driver, telemetry, và chính sách phân bổ. |
Những kiểm tra đa nút quan trọng
Thuê một GPU đơn chủ yếu là quyết định về giá, bộ nhớ, image, và tính sẵn có. Thuê cụm gpu cluster rental đa nút còn thêm rủi ro về topology và vận hành.
1. Topology GPU
Hãy hỏi về chính xác hình dạng node và liệu cụm có đồng nhất hay không.
- Model GPU và dung lượng bộ nhớ.
- PCIe so với SXM khi liên quan.
- Số GPU trên mỗi node.
- Topology NVLink hoặc NVSwitch giữa các GPU trong node.
- Model CPU, RAM, và NVMe cục bộ trên mỗi node.
- Chính sách cấp phát MIG, vGPU, hoặc full-GPU.
- Liệu tất cả các node có nằm trong cùng một miền đặt chỗ hay không.
Đừng chấp nhận "8x H100" như một thông số hoàn chỉnh. Một máy chủ 8x H100 SXM, một máy chủ 8x H100 PCIe, và tám node H100 riêng lẻ có thể hoạt động rất khác nhau.
2. Hạ tầng mạng
Với huấn luyện phân tán, mạng có thể quyết định cụm có thực sự hữu ích hay không. Hãy hỏi về:
- Chi tiết về InfiniBand, RoCE, EFA, GPUDirect, hoặc các hạ tầng khác.
- Số lượng NIC và tốc độ trên mỗi node.
- Tỷ lệ oversubscription.
- Cam kết về placement cho các node được báo giá.
- Nhà cung cấp đã chạy các bài kiểm tra NCCL all-reduce trên đúng pool đó hay chưa.
- Chính sách bảo trì và cô lập sự cố.
Đưa việc xác thực mạng vào bài kiểm thử chấp nhận:
cluster acceptance test:
  run nccl-tests all_reduce across every rented node
  compare bandwidth and latency to provider quote
  repeat after container image, driver, and framework install
  save logs with date, node IDs, GPU model, and region
Nếu nhà cung cấp không thể hỗ trợ một benchmark phân tán cơ bản trước khi ký hợp đồng, hãy xem đó là một tín hiệu rủi ro.
3. Lưu trữ và đường dẫn dữ liệu
Các nhóm GPU thường đánh giá thấp lưu trữ vì báo giá GPU trông lớn còn dòng lưu trữ thì có vẻ bình thường. Với các cụm đa node, lưu trữ quyết định thời gian khởi động, thời gian checkpoint và khả năng khôi phục sau sự cố.
Hãy hỏi về:
- NVMe cục bộ trên mỗi node.
- Các tùy chọn hệ thống tệp dùng chung.
- Khu vực object storage và đường egress.
- Thời gian staging dataset.
- Chiến lược cache trọng số mô hình.
- Thông lượng ghi/đọc checkpoint.
- Giá snapshot và sao lưu.
- Chính sách dọn dẹp sau khi thuê kết thúc.
Sau đó chạy một bài kiểm tra thực tế: kéo container production, stage dataset, nạp trọng số, ghi checkpoint, khôi phục từ checkpoint, và đo thời gian tính phí.
4. Scheduler và mô hình truy cập
Thỏa thuận GPU tốt nhất vẫn có thể thất bại nếu đội của bạn không thể lên lịch job một cách tin cậy. Hãy xác định bên nào chịu trách nhiệm:
- Cấu hình Kubernetes hoặc Slurm.
- Quản lý phiên bản driver và CUDA.
- Container registry và quét image.
- Quyền truy cập người dùng, chính sách SSH, secrets, và audit logs.
- Hạn mức theo team hoặc dự án.
- Tắt khi không hoạt động.
- Thẻ chi phí và xuất dữ liệu sử dụng.
- Leo thang xử lý sự cố.
Một cụm do nhà cung cấp quản lý có thể giảm thời gian thiết lập, nhưng bạn vẫn cần một runbook rõ ràng cho image lỗi, job thất bại, tranh chấp hạn mức, và thay đổi dung lượng khẩn cấp.
Bảng tính giá thuê cụm GPU trên cloud
Với mỗi nhà cung cấp, hãy chuẩn hóa báo giá vào cùng một bảng tính.
| Hạng mục | Câu hỏi cần hỏi | Vì sao nó làm thay đổi TCO |
|---|---|---|
| Tính toán GPU | Đơn vị tính phí là gì: giây, phút, giờ, tháng, hay khối dung lượng? | Job ngắn và thời gian nhàn rỗi rất nhạy với độ chi tiết của cách tính phí. |
| Cam kết tối thiểu | Có thời hạn, mức chi tiêu tối thiểu, hoặc đặt chỗ không thể hủy hay không? | Mức giá báo rẻ có thể trở nên đắt nếu mức sử dụng giảm. |
| Lưu trữ | Các tầng lưu trữ nào được bao gồm, và tầng nào bị tính phí riêng? | Dataset, checkpoint, trọng số mô hình và snapshot có thể tồn tại sau khi job kết thúc. |
| Mạng | Cross-region, public egress, private link, hay dedicated fabric có bị tính phí riêng không? | Dataset lớn và nội dung được tạo ra có thể truyền nhiều dữ liệu hơn dự kiến. |
| Hỗ trợ | Thời gian phản hồi, đường leo thang, và hỗ trợ kỹ thuật đi kèm là gì? | Sự cố cụm rất tốn kém trong các cửa sổ huấn luyện. |
| Độ tin cậy | Điều gì xảy ra nếu một node bị lỗi trong một job đa node? | Thời gian khởi động lại và chờ hàng đợi phải được tính vào mô hình chi phí. |
| Lộ trình nâng cấp | Có thể chuyển từ năng lực H100 sang H200/B200-class trong thời hạn hay không? | Các thế hệ GPU làm thay đổi hiệu năng trên mỗi đô la. |
| Khả năng quan sát | Bạn có nhận được mức sử dụng theo node, log job, xuất billing, và mã lý do lỗi không? | Không có dữ liệu sử dụng, bộ phận tài chính sẽ không thể giải thích hóa đơn. |
| Bảo mật | Các điều khoản về cô lập tenant, audit logs, secrets, và xóa dữ liệu có được tài liệu hóa không? | Người mua doanh nghiệp cần bằng chứng, không phải lời cam kết bằng miệng. |
Hãy dùng công thức này trong bảng tính:
monthly cluster TCO =
  committed compute
  + burst compute
  + persistent storage
  + snapshots
  + network egress
  + support
  + idle waste
  + retry waste
  + engineering overhead
Sau đó tính đơn vị hữu ích:
cost per useful unit =
  monthly cluster TCO / accepted workload units
Đơn vị hữu ích nên khớp với kết quả kinh doanh: số fine-tune hoàn thành, số token huấn luyện đã xử lý, số lô ảnh được chấp nhận, token inference, yêu cầu của khách hàng, hoặc các thí nghiệm đã được triển khai.
Thuê, đặt chỗ hay mua trong năm 2026
Từ khóa "gpu cluster rental or cloud or buy 2026" đi thẳng vào câu hỏi mua sắm thực sự. Hãy dùng bảng quyết định dưới đây trước khi cam kết quy mô lớn.
| Tùy chọn | Nên chọn khi | Nên tránh khi |
|---|---|---|
| Thuê theo nhu cầu | Khối lượng công việc còn mới, lịch trình chưa chắc chắn, hoặc các benchmark vẫn đang thay đổi. | Bạn đã có mức sử dụng nền ổn định và yêu cầu sẵn sàng tức thời. |
| Đặt trước hoặc dành riêng năng lực | Mức sử dụng có thể dự đoán, ngày ra mắt quan trọng, và cùng một dòng GPU sẽ bận trong nhiều tháng. | Kiến trúc mô hình, engine phục vụ, hoặc mục tiêu GPU có khả năng sớm thay đổi. |
| Mua hoặc colocate | Bạn có mức sử dụng rất cao, nhu cầu phần cứng ổn định, chuyên môn trung tâm dữ liệu, và được phê duyệt vốn đầu tư. | Bạn cần mở rộng nhanh, linh hoạt thế hệ GPU, hỗ trợ được quản lý, hoặc các khu vực toàn cầu. |
| Dùng API mô hình | Bạn cần đầu ra mô hình hơn là kiểm soát phần cứng, và chi phí vận hành bổ sung sẽ lấn át phần tiết kiệm GPU. | Bạn cần trọng số tùy chỉnh, kiểm soát kernel ở mức thấp, ngăn xếp phục vụ riêng tư, hoặc vị trí phần cứng cố định. |
Với nhiều nhóm sản phẩm AI, lộ trình thực tế là theo giai đoạn:
- Thuê GPU theo nhu cầu cho các benchmark.
- Chuyển các job ổn định sang thuê cụm GPU dành riêng hoặc đặt trước.
- Giữ lưu lượng đột biến và thử nghiệm trên năng lực linh hoạt.
- Dùng API mô hình cho các khối lượng công việc mà việc kiểm soát hạ tầng không cải thiện sản phẩm.
- Chỉ đánh giá lại việc mua hoặc colocate sau khi mức sử dụng và hình dạng khối lượng công việc đã ổn định.
Thuê cụm GPU tại Ấn Độ
Cụm từ "gpu cluster rental in india" không nên được coi là một bài viết riêng trừ khi bên mua có yêu cầu riêng về nguồn cung tại Ấn Độ, cư trú dữ liệu, hoặc độ trễ. Hãy dùng cùng một bảng câu hỏi, rồi bổ sung các kiểm tra theo khu vực:
- Cụm có đặt vật lý tại Ấn Độ, các khu vực châu Á lân cận, hay chỉ bán cho công ty có trụ sở ở Ấn Độ?
- Dữ liệu huấn luyện, checkpoint và log sẽ được lưu ở đâu?
- Có yêu cầu về chuyển dữ liệu xuyên biên giới, thuế, hóa đơn và giờ hỗ trợ không?
- Có cần hỗ trợ tại chỗ trong giờ làm việc ở Ấn Độ không?
- Độ trễ có quan trọng với suy luận hay đây là khối lượng công việc huấn luyện ngoại tuyến?
- Có ràng buộc về nhập khẩu, mua sắm hay tuân thủ nếu mua phần cứng thay vì thuê không?
Với huấn luyện ngoại tuyến, một khu vực gần đó có thể chấp nhận được nếu việc truyền dữ liệu và tuân thủ đều rõ ràng. Với suy luận nhạy cảm độ trễ hoặc dữ liệu được quản lý, khu vực và điều khoản hợp đồng có thể quan trọng hơn mức giá GPU hiển thị.
Dấu hiệu cảnh báo trong báo giá thuê cụm GPU
Tạm dừng giao dịch nếu bạn thấy bất kỳ điều nào sau đây:
- Báo giá ghi "H100 cluster" nhưng không nêu PCIe/SXM, cấu hình nút, bộ nhớ, hoặc mạng.
- Nhà cung cấp không thể mô tả cách xử lý lỗi cho một nút hỏng trong job phân tán.
- Lưu trữ và egress bị thiếu trong báo giá.
- Điều khoản hỗ trợ mơ hồ trong cửa sổ huấn luyện tốn kém nhất của bạn.
- "Dedicated" được dùng mà không làm rõ cô lập tenant, vị trí đặt, và rủi ro hàng xóm ồn ào.
- Báo giá đưa ra mức giá hàng tháng thấp nhưng không có điều khoản sử dụng hoặc hủy.
- Không có cửa sổ benchmark trước khi cam kết.
- Nhà cung cấp từ chối chia sẻ các trường xuất hóa đơn hoặc dữ liệu sử dụng.
- Bạn không thể xác minh phiên bản driver/CUDA/framework trước workload đầu tiên.
- Bản trình bày bán hàng đề cập tuân thủ, nhưng hợp đồng không định nghĩa việc xử lý và xóa dữ liệu.
Cần benchmark gì trước khi ký
Chạy một bộ nghiệm thu nhỏ trước khi bạn đặt trước hoặc mở rộng một cụm GPU thuê.
| Kiểm thử | Điều kiện đạt |
|---|---|
| Kéo container và khởi động | Image sản xuất khởi động nhanh và lặp lại được trên mọi nút. |
| Tình trạng GPU | Tất cả GPU báo đúng model, bộ nhớ, driver và khả năng tương thích CUDA như mong đợi. |
| NCCL all-reduce | Băng thông và độ trễ liên nút khớp với loại cụm mà nhà cung cấp công bố. |
| Giai đoạn lưu trữ | Bộ dữ liệu và trọng số mô hình có thể được đưa vào trạng thái sẵn sàng trong cửa sổ thiết lập dự kiến. |
| Ghi/đọc checkpoint | Checkpoint hoàn tất mà không làm GPU nhàn rỗi quá lâu. |
| Diễn tập sự cố | Ngắt một worker và xác nhận hành vi khởi động lại, checkpoint, và tính phí. |
| Tự động tắt khi nhàn rỗi | Các nút không dùng được dừng lại hoặc cảnh báo trước khi lãng phí tích tụ. |
| Xuất hóa đơn | Có thể phân bổ mức sử dụng theo nhóm, khối lượng công việc, môi trường và job. |
| Rà soát bảo mật | Truy cập, secrets, log, xóa dữ liệu và hồ sơ kiểm toán khớp với chính sách. |
Lưu đầu ra benchmark cùng ngày tháng, nhà cung cấp, khu vực, model GPU, phiên bản image, phiên bản framework và ID nút. Điều này biến việc chọn nhà cung cấp từ một cuộc tranh luận về bảng giá thành một buổi rà soát kỹ thuật có thể lặp lại.
Flatkey phù hợp ở đâu
Flatkey không phải là sự thay thế cho mọi cụm GPU thuê. Nếu bạn cần trọng số tùy chỉnh, kernel riêng, huấn luyện đa nút, hoặc kiểm soát phần cứng trực tiếp, bạn vẫn cần năng lực GPU.
Flatkey trở nên quan trọng khi câu hỏi là liệu bạn có cần vận hành GPU cho một khối lượng công việc nhất định hay không. Flatkey cung cấp cho các nhóm một khóa, một số dư và một hóa đơn trên hơn 300 mô hình chính thức và hơn 1.000 công cụ trả phí theo lượt gọi, với khả năng hiển thị mức sử dụng ở cấp yêu cầu. Điều đó làm cho nó hữu ích như một lộ trình so sánh cho:
- Khối lượng công việc nguyên mẫu trước khi bạn cam kết với một cụm.
- Lưu lượng tác tử và ứng dụng có thể chạy trên API mô hình chính thức.
- Các buổi xem xét tài chính cần so sánh chi phí GPU tự vận hành với chi phí API mô hình.
- Các nhóm muốn có sổ cái chung cho mức sử dụng AI trước khi quyết định phần nào xứng đáng với phần cứng chuyên dụng.
Nếu một workload không yêu cầu quyền kiểm soát phần cứng, hãy so sánh thuê cụm GPU với phương án API dựa trên chi phí cho mỗi kết quả được chấp nhận, chứ không phải trên số giờ GPU thô. Các hướng dẫn liên quan về giá thuê GPU, so sánh giá mô hình AI, cách so sánh giá mô hình AI, giá AI gateway, quản lý chi tiêu AI API, và quản lý hạn mức AI API là những kiểm tra tiếp theo phù hợp.
Danh sách kiểm tra cho người mua
Hãy dùng danh sách kiểm tra này trước khi phê duyệt thuê cụm GPU:
- Xác định workload và đơn vị đầu ra hữu ích.
- Đánh giá năng lực theo nhu cầu trước khi đặt chỗ.
- Chỉ định model GPU, bộ nhớ, cấu hình node, lưu trữ cục bộ, và fabric mạng.
- Yêu cầu benchmark phân tán cho huấn luyện đa nút.
- Tính cả lưu trữ, egress, hỗ trợ, thời gian nhàn rỗi, và lãng phí do thử lại vào TCO.
- Xác nhận khu vực, tuân thủ, xóa dữ liệu, và yêu cầu kiểm toán.
- Hỏi một node bị lỗi sẽ ảnh hưởng thế nào đến một job đang chạy.
- Yêu cầu xuất dữ liệu sử dụng và thanh toán theo team, môi trường, và job.
- Tách riêng năng lực nền tảng đã đặt trước khỏi năng lực bùng nổ.
- Đánh giá lại so với các API mô hình khi không cần quyền kiểm soát phần cứng.
Quyết định thuê cụm GPU tốt nhất là quyết định giúp hoàn thành workload một cách đáng tin cậy với ít bất ngờ vận hành nhất. Giờ GPU rẻ nhất chỉ có ích nếu cụm, lưu trữ, mạng, và hợp đồng cho phép team của bạn biến giờ đó thành công việc được chấp nhận.
Những câu hỏi người mua thường hỏi
Thuê cụm GPU là gì?
Thuê cụm GPU là việc thuê nhiều GPU, thường trải dài trên một hoặc nhiều node được kết nối, cho AI training, inference, xử lý hàng loạt, hoặc nghiên cứu. Hình thức này có thể là theo nhu cầu, đặt trước, dedicated, dựa trên marketplace, hoặc được quản lý bởi nhà cung cấp cloud.
Thuê cụm GPU có rẻ hơn mua GPU không?
Điều này phụ thuộc vào mức độ sử dụng, thời hạn, năng lực vận hành, tài chính, điện năng, khả năng tiếp cận datacenter, hỗ trợ, và tần suất class GPU mục tiêu của bạn thay đổi. Thuê thường thắng khi có sự bất định và cần tốc độ. Mua chỉ có thể thắng khi mức sử dụng và nhu cầu phần cứng đủ ổn định để hấp thụ chi phí vốn và vận hành.
Tôi nên hỏi gì các nhà cung cấp cloud thuê cụm GPU?
Hãy hỏi về model GPU, cấu hình node, fabric mạng, lưu trữ, khu vực, quota, SLA hỗ trợ, giả định về mức sử dụng, xuất dữ liệu thanh toán, điều khoản xóa dữ liệu, quyền truy cập benchmark, và chuyện gì xảy ra khi một node bị lỗi trong một job phân tán.
Tôi có cần InfiniBand hoặc RoCE cho một cụm GPU thuê không?
Bạn cần mạng cụm hiệu năng cao khi các job giao tiếp nhiều giữa các node, đặc biệt là huấn luyện phân tán và phục vụ được phân mảnh. Có thể bạn không cần nó cho suy luận batch song song độc lập hoặc các job độc lập. Hãy benchmark với workload của riêng bạn trước khi trả tiền cho fabric cao cấp.
Tôi nên so sánh thuê cụm GPU ở Ấn Độ như thế nào?
Hãy dùng cùng một bảng tính thuê, rồi thêm các câu hỏi đặc thù cho Ấn Độ về khu vực, nơi lưu trú dữ liệu, thuế, yêu cầu hóa đơn, giờ hỗ trợ, độ trễ, và chuyển dữ liệu xuyên biên giới. Đừng chỉ so sánh giá theo giờ GPU.


